Akamai Bot Manager : données du capteur et vie privée
Distinguez les déclarations sur le capteur Akamai, les observations du navigateur et les données en périphérie. Comprenez la collecte, les rôles et les limites des contrôles.
BotBrowser Team
Vous voulez la documentation structurée pour Empreinte ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
Akamai Bot Manager combine les informations disponibles en périphérie du réseau avec les observations d’un script présent dans les pages surveillées. Akamai mentionne publiquement l’analyse du comportement et l’empreinte du navigateur, mais ces déclarations n’établissent pas une liste universelle de lectures JavaScript. Pour comprendre l’exposition de la vie privée, il faut distinguer la collecte dans le navigateur, la transmission et le traitement ultérieur.
BotBrowser permet des vérifications répétables des surfaces du moteur du navigateur à partir de paramètres de profil déclarés. Il ne détermine pas la finalité de collecte d’Akamai, la conservation, l’historique des comptes ou la classification, et ne garantit ni l’anonymat ni l’accès.
Résumé
- Akamai décrit à la fois un composant de script de page et une évaluation des requêtes en périphérie du réseau. Un paramètre de confidentialité du navigateur ne touche qu’une partie de ce système.
- Un événement V8 attribué à sa source peut établir une opération du navigateur lors d’une exécution donnée. Une capture de requêtes, le téléchargement d’un script ou un score inexpliqué ne peuvent pas établir le même fait.
- La déclaration de confidentialité d’Akamai distingue les rôles de traitement et les contextes de service. Ses exemples généraux de journaux de service ne précisent pas chaque message du capteur.
- Pour un déploiement que vous gérez, choisissez les règles de collecte et de conservation selon la finalité et la configuration réelles. Vérifiez séparément l’exposition du navigateur et le traitement côté serveur.
Sommaire
- Le capteur de page et la périphérie du réseau
- Ce que les éléments disponibles établissent
- Surfaces du navigateur et exposition de la vie privée
- Transmission, journaux et rôles de traitement
- Ce que les contrôles du moteur du navigateur peuvent changer
- Décisions pour un déploiement que vous gérez
- Conclusion pratique
Le capteur de page et la périphérie du réseau
Un site n’a pas besoin d’un script de page pour observer toutes les propriétés pertinentes d’une requête. Un service en périphérie du réseau reçoit le trafic avant que le document n’atteigne le navigateur. La requête et la connexion fournissent déjà des informations sur le point d’arrivée du trafic, la ressource demandée et le moment de l’échange. Cette visibilité relève d’un autre responsable qu’une valeur produite par JavaScript après le chargement de la page.
La description du produit Bot Manager d’Akamai inclut explicitement les deux volets. La description de sa configuration indique que la détection des anomalies comportementales utilise un script injecté dans les pages surveillées. La description de sa surveillance indique que le service voit le trafic en périphérie et attribue un Bot Score aux requêtes. Ces affirmations établissent une architecture déclarée. Elles ne révèlent ni l’opération du navigateur à l’origine d’un score donné, ni les observations activées par un client particulier.
La distinction compte lorsqu’une page semble fonctionner différemment après la modification d’un paramètre du navigateur. Une différence côté navigateur peut coexister avec un historique serveur inchangé. Une modification de route réseau peut coexister avec le même comportement de rendu. Une réponse différente peut résulter de la configuration de l’application sans prouver la collecte d’un nouveau signal du navigateur. Chaque explication renvoie à une partie différente du système.
La présentation des empreintes du navigateur distingue pour la même raison les couches des requêtes, de navigator, du rendu et de l’application. La description du produit d’Akamai ajoute une déclaration propre au fournisseur sur la participation de la surveillance des pages et de l’évaluation en périphérie. Elle ne ramène pas ces couches à une seule propriété du navigateur qu’un paramètre pourrait activer ou désactiver.
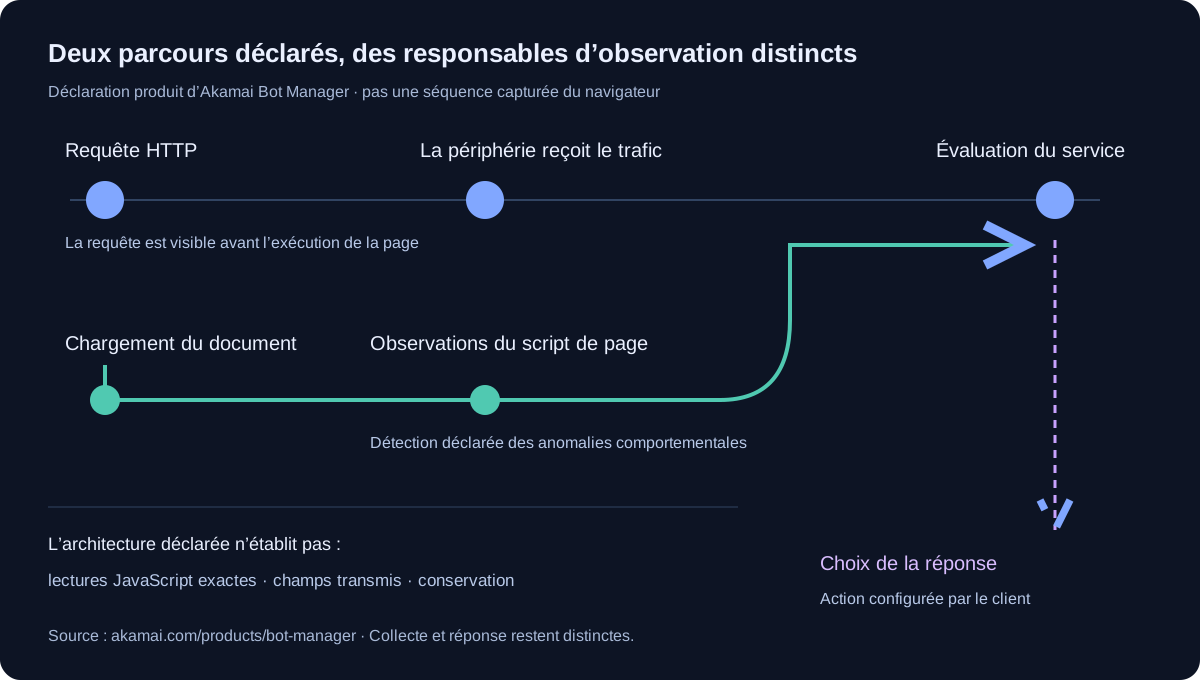
Un capteur n’est qu’un contexte de collecte
Le mot capteur évoque souvent un questionnaire unique et fixe. Un composant de navigateur déployé s’exécute pourtant dans une page ayant une origine, un ordre de chargement, un cycle de vie et un ensemble de ressources disponibles particuliers. Ce qui est disponible avant une interaction peut différer de ce qui l’est après une navigation ou une décision d’autorisation. Cela n’établit pas quelles possibilités le composant utilise réellement.
Le guide des réponses de Cloudflare et DataDome traite d’une autre limite observable : ce que reçoit un client. Une classification de réponse peut décrire un document, une redirection ou un défi. Elle ne reconstitue pas ce qu’un autre fournisseur a collecté auparavant et ne révèle pas comment un client a configuré sa politique de réponse. Appliquer ces limites de manière cohérente évite de transformer un résultat visible en historique de collecte inventé.
La collecte et la réponse ont des finalités différentes
L’exploitant d’une application peut utiliser la gestion des bots pour protéger la disponibilité, enquêter sur une automatisation indésirable ou distinguer des catégories de requêtes automatisées. Ces finalités peuvent conduire à des choix de déploiement différents. Une page publique de produit décrit des capacités disponibles pour plusieurs clients. Chaque déploiement a sa propre configuration, son parcours applicatif et ses responsabilités opérationnelles.
Pour évaluer la confidentialité, la question utile est de savoir ce dont le déploiement réel a besoin pour sa finalité déclarée. L’existence d’une capacité facultative ne prouve pas que chaque visiteur y est exposé. Inversement, une console de navigateur silencieuse ne prouve pas que la périphérie du réseau n’a reçu aucune information. Les observations réseau et applicatives restent pertinentes même lorsqu’un script ne produit aucune interface visible évidente.
Les recommandations du W3C sur les empreintes distinguent les caractéristiques passives disponibles dans les requêtes des observations actives obtenues par du contenu exécutable. Ces catégories aident à situer la collecte. Elles n’attribuent pas de base juridique, ne prouvent pas la proportionnalité et ne déterminent pas comment une entreprise donnée utilise le résultat. Ces décisions nécessitent des informations sur le déploiement et le traitement provenant des organisations responsables.
Un Bot Score est une évaluation suivie d’un choix de réponse
La FAQ produit d’Akamai décrit un score allant de 0, étiqueté humain, à 100, étiqueté bot. Elle indique que l’évaluation commence dès la première requête et que le score peut augmenter à mesure que les requêtes d’un même bot s’accumulent. Ce sont les descriptions du service par le fournisseur, pas des mesures d’une session du navigateur. Les extrémités de l’échelle sont des étiquettes, pas des probabilités publiées d’identité humaine ou d’intention malveillante.
Cette précision sur l’historique des requêtes concerne la confidentialité. Un service évaluant une séquence a besoin d’un fondement pour considérer les requêtes comme liées. La FAQ ne précise ni le mécanisme exact de liaison ni la durée de chaque association. Elle justifie une question sur les relations entre requêtes, sans établir d’identifiant précis, de méthode de stockage ou de relation entre sites. Une lecture du navigateur attribuée à sa source ne répondrait toujours pas à la question de la combinaison de l’historique par le serveur.
La déclaration sur la stratégie de réponse nomme trois segments configurables : Cautious Response, Strict Response et Aggressive Response. Elle décrit la surveillance, les défis et l’atténuation du trafic, tout en permettant aux clients d’ajuster les actions et les seuils du score. Ces choix interviennent après l’évaluation. Un défi visible reflète donc à la fois l’évaluation du service et la réponse choisie dans le déploiement ; ce n’est pas l’affichage direct d’une observation particulière du navigateur.
Pour l’exploitant d’une application, cette séparation influe sur les responsabilités. Le fournisseur apporte une capacité d’évaluation, tandis que le client choisit sa participation au parcours applicatif. Un visiteur subissant une interruption inattendue a besoin d’un examen de la décision déployée et de son contexte, notamment des différences ordinaires d’accessibilité ou de navigation. Modifier une règle de réponse ne prouve pas que la collecte sous-jacente a changé, et collecter une valeur supplémentaire du navigateur n’explique pas à lui seul pourquoi une règle de réponse s’est appliquée.
L’explication de la couche périphérique décrit pourquoi une page ne peut pas inspecter toutes les conditions côté service. La FAQ d’Akamai en fournit un exemple concret : l’évaluation par requête et la réponse configurable sont des opérations liées, mais leurs responsables et leurs éléments de preuve diffèrent. Aucun score ni aucune action particulière n’ont été mesurés pour les contrôles du navigateur abordés plus bas.
Ce que les éléments disponibles établissent
Trois types d’éléments répondent à des questions différentes : une déclaration du fournisseur décrit une capacité proposée, une trace du navigateur enregistre des opérations pendant une exécution et un relevé réseau décrit un échange. Aucun ne contient automatiquement les informations fournies par les deux autres. Une affirmation de collecte devient trompeuse lorsqu’un rapport franchit ces limites sans éléments supplémentaires.
Les recherches locales inspectées contiennent une configuration de capture des requêtes et un utilitaire d’attribution à la source, mais n’établissent pas de mesure V8 actuelle attribuée à sa source. Les lectures précises du navigateur restent donc non vérifiées. La capture des requêtes peut situer un échange ; le code d’analyse existant ne prouve pas que l’événement attendu a été émis.
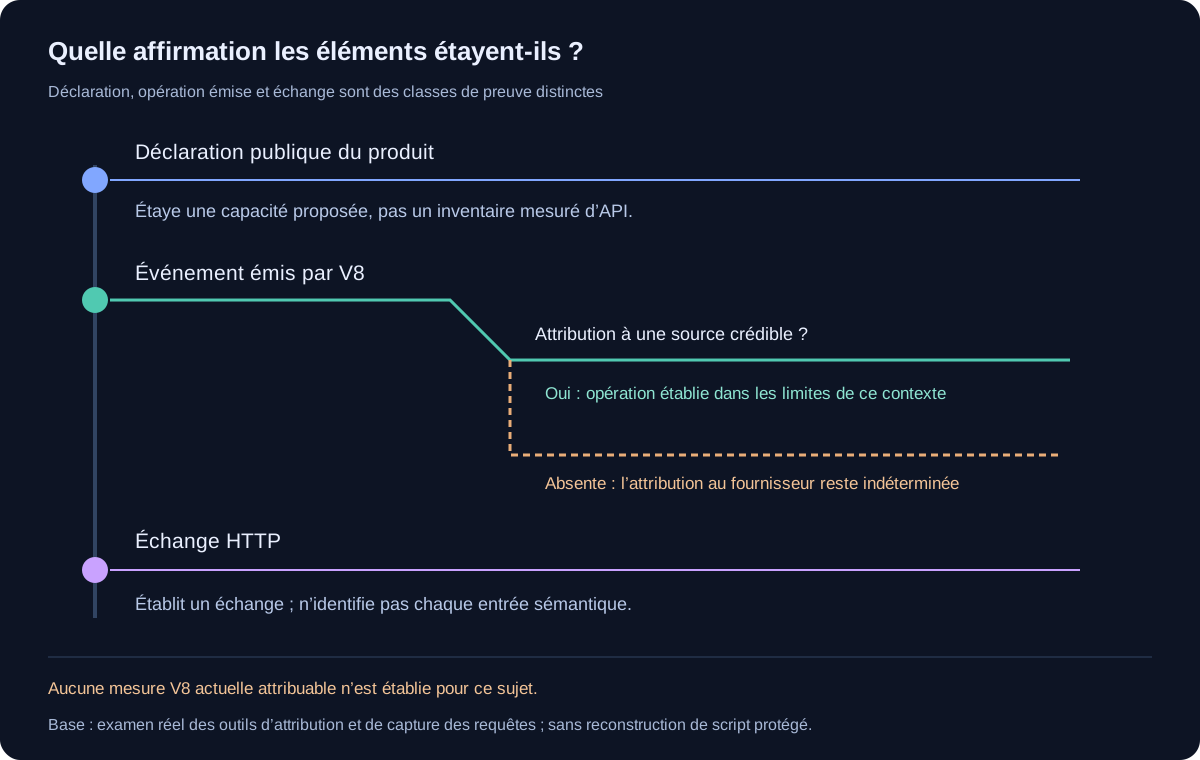
Pourquoi l’attribution à la source change la conclusion
Une page moderne exécute des scripts applicatifs, des outils d’analyse, des contenus intégrés et des outils de diagnostic. Un appel d’API enregistré pendant son chargement pourrait appartenir à n’importe lequel. La présence d’une solution de gestion des bots n’attribue pas chaque opération du navigateur à son capteur. L’attribution exige un lien entre l’événement et le code qui en est responsable.
Un journal V8 est un outil d’observation de l’activité des interfaces du navigateur. Un événement identifiant l’opération et une source de script crédible peut étayer une affirmation sur cette exécution. Une source manquante, un contexte limité au document ou une étiquette de blob de la même exécution n’attribuent pas indépendamment l’opération à Akamai. Les scripts applicatifs et les outils de diagnostic peuvent produire leurs propres événements pendant la même visite.
L’analyse de la confidentialité entre surfaces explique pourquoi le contexte importe dans les pages et les workers. Une mesure doit préserver le contexte réellement observé. Déplacer un événement non attribué dans une colonne de fournisseur fait perdre ce contexte et peut exagérer à la fois la collecte et l’effet d’un contrôle du navigateur.
Lire, envoyer et conserver sont des faits distincts
Un événement émis par le navigateur peut établir qu’une opération a eu lieu. Il n’établit pas nécessairement que le résultat a été inclus dans une requête. Un échange réseau peut établir que des données ont franchi une limite, mais un corps opaque ne révèle pas indépendamment ses entrées sémantiques. Aucun des deux ne prouve une durée de conservation ni la finalité du traitement ultérieur côté serveur.
Ces limites comptent pour les constats positifs comme négatifs. Un événement manquant peut refléter un enregistrement incomplet, une phase d’exécution différente ou une instrumentation indisponible. Ce n’est pas la preuve qu’aucune lecture n’a eu lieu. Une valeur correspondante du navigateur ne prouve pas non plus que le site l’a ignorée. Les observations du navigateur décrivent des valeurs renvoyées ; leur utilisation par le service exige d’autres éléments.
| Éléments disponibles | Conclusion étayée | Éléments supplémentaires encore nécessaires |
|---|---|---|
| Déclaration de produit du fournisseur | Le fournisseur propose la capacité de traitement nommée | Configuration et collecte du déploiement réel |
| Événement émis avec une source crédible | Cette source a effectué l’opération du navigateur enregistrée dans ce contexte | Transmission ou conservation éventuelle du résultat |
| Requête sortante | Un échange réseau a eu lieu | Sens du contenu et finalité du traitement responsable |
| Registre de traitement du client | Finalité et règles de gestion documentées | Respect de ces règles par l’implémentation déployée |
Le tableau donne à l’équipe d’un site qu’elle gère une règle de choix : utiliser la ligne correspondant aux éléments réellement disponibles. Si la question relève de la colonne suivante, il faut obtenir l’information auprès du responsable du système concerné plutôt que transformer l’incertitude en affirmation assurée. Les recommandations du W3C fournissent le modèle général de collecte ; le déploiement réel fournit les détails manquants.
Surfaces du navigateur et exposition de la vie privée
L’exposition aux empreintes comprend la manière dont les observations peuvent être reliées, la durée pendant laquelle ce lien reste utile et l’organisation qui contrôle leur combinaison. Un nom n’est pas nécessaire à la reconnaissance.
Les recommandations du W3C décrivent comment les caractéristiques actives et passives contribuent aux empreintes. Les informations de compatibilité du navigateur, les différences de rendu et les propriétés des requêtes peuvent avoir des stabilités et des coûts de collecte différents. Une famille partagée par de nombreux utilisateurs peut néanmoins réduire une population lorsqu’elle est combinée à une autre. La page produit d’Akamai mentionne explicitement l’« empreinte du navigateur » ; cela justifie l’examen de cette catégorie sans inventer son implémentation.
La présentation générale des empreintes distingue un motif reconnaissable d’une preuve d’identité. La même distinction s’applique à Akamai. Une classification du navigateur n’établit ni une identité juridique, ni le propriétaire d’un appareil, ni l’intention d’une personne. La traiter ainsi ajoute des conclusions que l’observation sous-jacente ne permet pas forcément d’étayer.
Les informations de compatibilité peuvent servir à la corrélation
Les applications web utilisent les informations du navigateur pour choisir un contenu compatible, mettre en forme le texte ou adapter la disposition. Leur collecte à ces fins ne constitue pas en soi une affirmation de prise d’empreinte. L’exposition de la vie privée change lorsqu’une application combine les réponses à des fins de reconnaissance ou les associe à une activité continue. La finalité et la combinaison comptent autant que chaque surface du navigateur.
Par exemple, navigator.language peut servir à la localisation. Une ressource installée peut influer sur le rendu. Une fenêtre d’affichage décrit la zone de présentation actuelle. Ces exemples illustrent l’exposition normale du navigateur et n’affirment pas qu’Akamai lit chaque valeur. L’analyse de la langue et de la localisation explique qu’une préférence fonctionnelle et une déduction de suivi sont des usages différents d’informations liées.
L’évaluation d’un site que l’on gère devrait distinguer la décision minimale de compatibilité d’un enregistrement plus durable. Si une page doit seulement choisir une disposition adaptée, conserver un historique à long terme des observations utilisées nécessite une justification propre. Le navigateur ne peut pas déterminer cette finalité métier. Les responsables de l’application et du service doivent pouvoir l’expliquer.
Le rendu expose des différences d’implémentation
Le rendu graphique et textuel peut varier selon les polices, l’implémentation du navigateur et l’environnement de rendu. La sortie rendue est donc pertinente pour l’analyse générale des empreintes. Cela signifie aussi que des changements peuvent survenir pour des raisons ordinaires de maintenance. Une sortie différente ne signifie pas automatiquement une personne différente, une session suspecte ou une preuve de manipulation délibérée.
L’analyse de WebGL et l’analyse de canvas expliquent ces surfaces séparément.
Les données de rendu peuvent créer une exposition même sans nom lisible par un humain. Leur intérêt peut être de distinguer une configuration ou de corréler des visites. Les questions pertinentes pour leur gestion sont la nécessité de la sortie brute, la possibilité qu’une catégorie plus grossière réponde à la question opérationnelle et l’association éventuelle du résultat à d’autres activités. Une trace du navigateur seule ne peut pas répondre à cette dernière question d’association.
L’interaction et les temps nécessitent une limite temporelle
Akamai décrit explicitement l’analyse du comportement des utilisateurs.
Les observations comportementales décrivent une activité sur un intervalle. Leur sens dépend de la page, des possibilités d’interaction et du contexte d’accessibilité. Un visiteur naviguant au clavier peut produire un schéma d’interaction différent de celui d’un visiteur utilisant le tactile. Un onglet en arrière-plan peut présenter des temps différents d’un onglet au premier plan. Ces différences nécessitent le contexte du déploiement avant de pouvoir expliquer une classification.
L’analyse des temps de performance montre pourquoi une mesure transitoire ne doit pas être traitée comme une propriété permanente. La même rigueur s’applique à l’examen d’une déclaration du fournisseur sur le comportement. La déclaration, l’intervalle enregistré et la décision de service qui en résulte restent des éléments distincts.
Transmission, journaux et rôles de traitement
Une explication de la confidentialité du navigateur reste incomplète si elle s’arrête au renvoi d’une valeur par un script. L’information peut passer dans une application, un service en périphérie ou un journal opérationnel conservé. L’organisation qui contrôle le traitement ultérieur peut avoir des finalités et des responsabilités différentes de celles du composant de page à l’origine de l’observation.
La déclaration de confidentialité d’Akamai, mise à jour le 18 août 2026, introduit dès le début une distinction importante de périmètre. Elle couvre les traitements d’Akamai en qualité de responsable du traitement ou dans un rôle équivalent. Elle indique que les traitements réalisés pour le compte de clients en qualité de sous-traitant relèvent de l’accord de traitement des données disponible sur son Trust Center. Ces deux contextes ne doivent pas être fusionnés en une notice universelle.
La déclaration aborde aussi les circonstances dans lesquelles Akamai traite les journaux de service en qualité de responsable du traitement ou d’entreprise. Dire simplement que le fournisseur est toujours sous-traitant serait donc trop général. Le rôle dépend de l’activité de traitement et des accords applicables. Le nom du produit ne résout pas à lui seul cette question pour chaque jeu de données.
Les finalités des journaux de service dépassent une seule réponse
La déclaration sur les journaux de service énumère l’analyse du trafic et de la sécurité, la facturation des clients, l’amélioration du service, la planification des capacités et des déploiements, le dépannage et les rapports agrégés comme finalités des traitements propres d’Akamai. Elle cite l’amélioration du renseignement sur les menaces comme exemple d’amélioration du service. Ces finalités décrivent ce qui peut se passer après la livraison de la page ; ce ne sont pas simplement d’autres noms pour la décision de renvoyer un défi.
La distinction change ce qu’un site doit expliquer. Un enregistrement servant à calculer des frais de service répond à une autre question qu’un enregistrement servant à enquêter sur un incident de sécurité. Un rapport agrégé de trafic diffère d’une observation du navigateur associée à une requête individuelle. Identifier la finalité aide à déterminer le détail nécessaire et qui peut justifier l’accès, plutôt que supposer que chaque élément conservé reste nécessaire parce que la requête initiale exigeait une évaluation.
La déclaration mentionne aussi des partenariats avec des tiers pour l’analyse du trafic et de la sécurité des journaux de service, certains incluant l’analyse des données de trafic et de sécurité du partenaire. Il s’agit d’une relation de traitement déclarée, pas de la preuve que chaque observation de Bot Manager est partagée avec chaque partenaire. Pour un déploiement que l’on gère, la description du service et les accords applicables doivent identifier la relation concernée. La seule présence d’un script de navigateur ne peut pas répondre à cette question.
Dans la même section, Akamai décrit des analyses de sécurité pouvant confronter les identifiants d’authentification présents dans les journaux de service à des listes d’identifiants volés afin de reconnaître les accès malveillants et les tentatives de prise de contrôle de comptes. Cet exemple couvrant plusieurs services dépend du service acheté et des données pertinentes. Il ne doit pas devenir une affirmation selon laquelle chaque script de page Bot Manager lit des identifiants ou chaque visite ordinaire les transmet. L’analyse de DataDome rattache de même les déclarations de traitement d’un fournisseur au composant et à la finalité qu’elles décrivent.
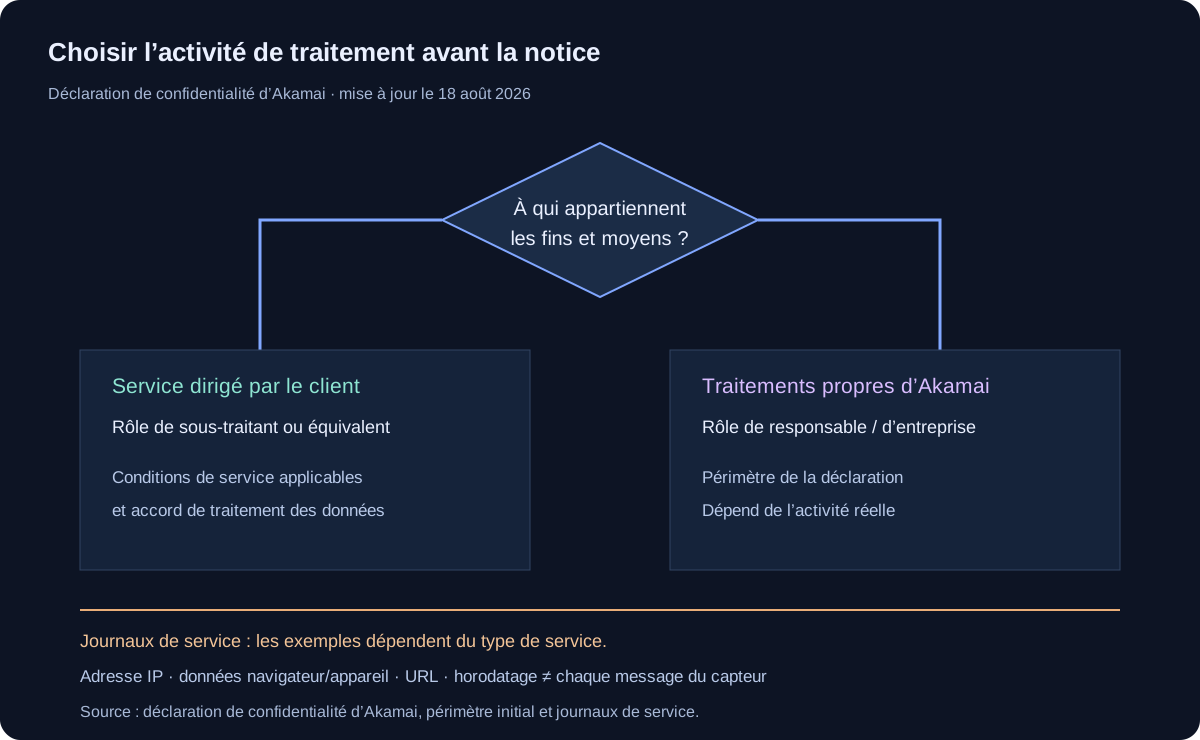
Les exemples de journaux de service sont conditionnels
La section sur les journaux de service cite notamment l’adresse IP d’un utilisateur final, les données du navigateur et de l’appareil, les URL visitées et les horodatages. Elle énumère aussi d’autres catégories susceptibles de s’appliquer selon le service utilisé. Son périmètre est le fonctionnement des services Akamai en général. Ces exemples ne doivent pas être présentés comme des champs présents dans chaque message du capteur de Bot Manager.
Cette distinction a une conséquence concrète pour l’inventaire d’un déploiement. Une équipe devrait identifier le service acheté, les chemins de données activés et ce que les documents applicables disent de ces chemins. Copier toutes les catégories d’une déclaration couvrant l’ensemble des services exagérerait la collecte observée. Retirer des catégories au seul motif qu’elles n’apparaissent pas dans le JavaScript du navigateur sous-estimerait la visibilité indépendante de la périphérie du réseau.
L’explication réseau et navigateur fournit un point de départ utile. Un serveur peut observer une adresse de requête sans la demander à une API de page. Une page peut obtenir un résultat de rendu que le serveur ne peut pas lire directement avant la transmission d’une représentation. Les questions de localisation des données nécessitent donc les volets navigateur et service.
Les visites directes à Akamai constituent un autre contexte
La déclaration de confidentialité traite séparément les données d’appareil et d’utilisation collectées lors d’interactions avec les propres sites d’Akamai. Les exemples comprennent les informations sur le navigateur et le système d’exploitation, les pages consultées et les informations d’utilisation. Ce contexte est distinct de celui d’un client utilisant Bot Manager sur une autre application.
Une personne lisant une page produit d’Akamai ne rencontre pas automatiquement la même configuration qu’un visiteur du parcours de paiement d’un client. Les outils d’analyse, les technologies promotionnelles et les parcours de compte d’un site peuvent avoir leurs propres notices et finalités. Séparer ces contextes évite de présenter une déclaration générale de confidentialité d’un site comme une spécification précise du capteur.
Pour un déploiement que l’on gère, la notice du client et les conditions contractuelles du service doivent décrire la relation réelle. La déclaration du fournisseur apporte des informations sur ses propres traitements. Une mesure du navigateur apporte des informations sur le comportement observable. Aucune ne remplace la responsabilité du client de comprendre ce qu’il a activé et comment cela correspond à sa finalité déclarée.
Le calendrier de conservation publié a plusieurs périmètres
Le tableau de conservation d’Akamai donne des durées concrètes pour les journaux de service concernant les personnes accédant aux sites web, applications ou systèmes d’entreprise de ses clients, hors services de Cloud Computing. Pour les analyses de sécurité, il indique que les données sont conservées jusqu’à 90 jours dans la plupart des cas. Lorsque des événements de sécurité précis nécessitent de mettre à jour un algorithme existant, il précise jusqu’à 180 jours. Pour l’analyse du trafic et les données forensiques agrégées, il précise jusqu’à 3 ans.
| Contexte publié des journaux de service | Durée déclarée | Limite de la déclaration |
|---|---|---|
| Analyses de sécurité dans la plupart des cas | Jusqu’à 90 jours | Le contexte indiqué des journaux de service des sites clients |
| Événements de sécurité précis nécessitant des mises à jour d’algorithmes | Jusqu’à 180 jours | Une exception déclarée, pas chaque requête |
| Analyse du trafic et données forensiques agrégées | Jusqu’à 3 ans | Les finalités spécifiées d’analyse et de données agrégées |
Ce sont des déclarations relevant du périmètre de responsable du traitement ou d’entreprise de la déclaration. Elles ne constituent pas une promesse universelle de conservation pour chaque message du capteur de Bot Manager, chaque jeu de données traité en sous-traitance sur instruction du client ou tous les services proposés sous le nom Akamai. La ligne distincte sur le Cloud Computing a une formulation différente. L’équipe d’un site qu’elle gère doit relier l’activité réelle de traitement à la ligne et à l’accord contractuel applicables avant d’utiliser une de ces durées dans la notice aux visiteurs.
L’expression jusqu’à compte également. Elle décrit une durée maximale dans le contexte indiqué, sans prouver qu’un enregistrement particulier reste stocké pendant tout l’intervalle. Inversement, un cookie de courte durée ne prouve pas que les enregistrements associés du service disparaissent à son expiration. L’état local du navigateur, les analyses de sécurité et un jeu de données forensiques agrégées sont des objets différents, avec des questions de gestion différentes.
Pour évaluer la confidentialité, la différence pratique se situe entre le détail par requête et un enregistrement agrégé ultérieur. La déclaration nomme les deux finalités, mais une réponse du navigateur ne peut pas vérifier leur implémentation ni la transformation exacte entre elles. Une équipe demandant une suppression, un examen des accès ou une explication de conservation a besoin du responsable du traitement et du jeu de données pertinent, pas seulement de la durée du cookie visible dans les outils du navigateur.
L’analyse de confidentialité de DataDome distingue aussi la durée de l’état du navigateur du traitement serveur. Ici, les durées publiées par Akamai fournissent un point de départ concret. Les conditions contractuelles propres au déploiement et la gestion réelle des données déterminent toujours la réponse applicable à une application que l’on gère.
Ce que les contrôles du moteur du navigateur peuvent changer
La couche du moteur du navigateur intervient là où le navigateur produit un comportement visible par le contenu web. La documentation des empreintes de BotBrowser décrit les contrôles de surfaces comme les graphismes, les polices et les temps. Un contexte déclaré peut faciliter l’interprétation de comparaisons autorisées répétées, car les entrées pertinentes du profil peuvent être enregistrées.
Cette capacité possède une limite de responsabilité définie. Elle ne réécrit pas les requêtes déjà reçues par un service en périphérie, ne supprime pas l’historique des comptes de l’application et ne modifie pas la finalité de traitement du fournisseur. Elle n’établit pas non plus qu’un système distant classera une session d’une manière particulière. Ces résultats dépendent d’informations et de règles extérieures à la couche du navigateur.
La comparaison entre moteur et correctif distingue la portée d’un correctif de bibliothèque de l’environnement de navigateur sous-jacent. La comparaison utile concerne la couche responsable d’une valeur et la cohérence de son comportement entre contextes. Un taux d’acceptation par un fournisseur est une autre question que cette distinction architecturale n’établit pas.
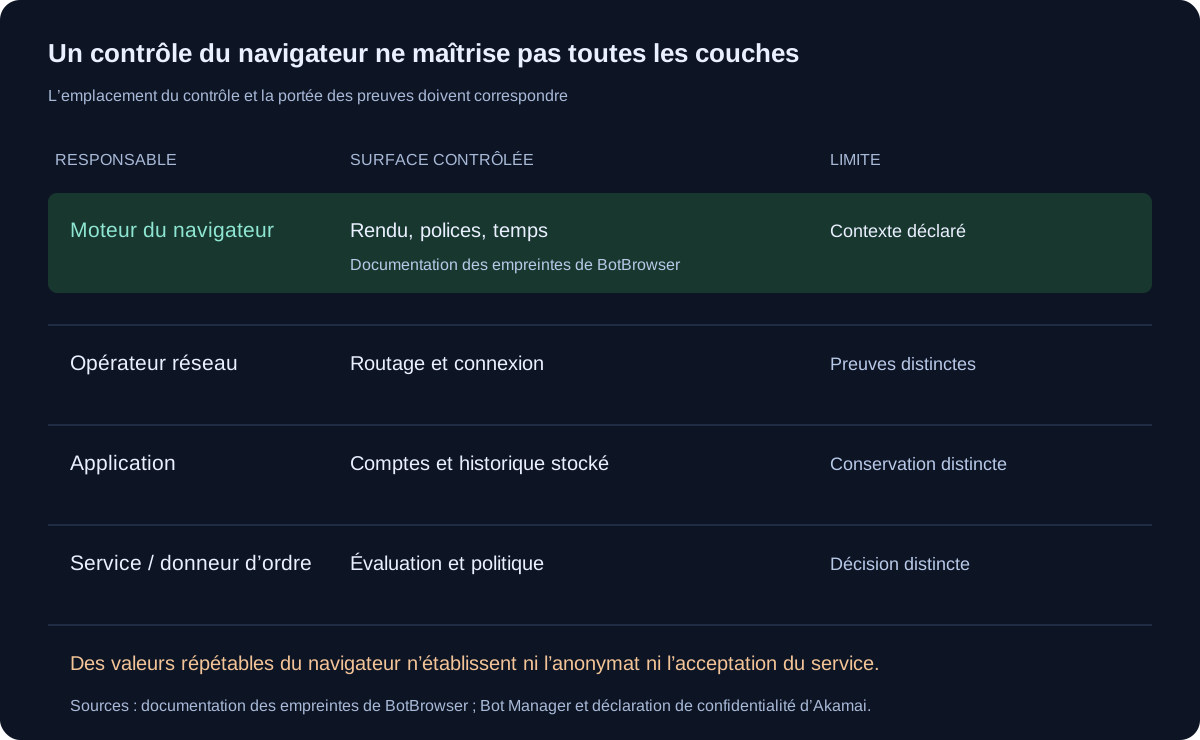
Un correctif d’API modifie le comportement à la limite corrigée ; un contrôle du moteur a un emplacement d’implémentation différent. Aucune de ces étiquettes ne prouve la couverture de tous les contextes de document, de cadre ou de worker. L’analyse de la confidentialité entre surfaces explique pourquoi ces contextes exigent leurs propres vérifications. Des valeurs répétables peuvent étayer une comparaison sans démontrer l’impossibilité de liaison ni un changement mesuré du Bot Score.
Décisions pour un déploiement que vous gérez
L’équipe d’un site qu’elle gère peut examiner la collecte sans constituer un dossier complet sur l’appareil. Le point de départ est une question opérationnelle précise : quel problème nécessite cette observation, où le résultat est-il utilisé et quelle solution moins détaillée répondrait à la même question ? Une étiquette générale comme sécurité n’explique pas à elle seule chaque champ ou durée de conservation.
Utilisez la configuration du service déployé et les conditions applicables pour identifier l’activité de traitement responsable. Utilisez les éléments du navigateur pour établir ce que fait réellement le client. Utilisez les éléments réseau et serveur pour établir quels résultats quittent la page et ce qui se passe ensuite. Les recommandations du W3C préconisent de minimiser l’exposition aux empreintes ; elles ne remplacent pas un inventaire du déploiement.
| Décision | Éléments à obtenir | Action résultante |
|---|---|---|
| Une lecture supposée du navigateur est-elle réellement attribuable ? | Événement émis et contexte de source crédible | Laisser l’attribution indéterminée si l’un des deux manque |
| Une lecture devient-elle une donnée transmise ? | Comparaison autorisée avec l’échange pertinent et le relevé d’implémentation | Ne pas déduire la transmission de la seule disponibilité |
| Quel rôle de confidentialité s’applique ? | Finalité, configuration du service et conditions contractuelles applicables | Utiliser la notice régissant cette activité de traitement |
| La sortie brute est-elle nécessaire ? | Besoin opérationnel et solution moins détaillée | Préférer le niveau minimal de détail répondant à la question |
| Combien de temps le résultat est-il nécessaire ? | Règle de conservation propre à la finalité et responsable de suppression | Aligner l’accès et la suppression sur cette règle |
Garder une collecte de diagnostic plus petite que le problème
Un relevé de diagnostic peut créer sa propre exposition de la vie privée. Les journaux bruts du navigateur peuvent inclure des emplacements de ressources, des identifiants ou des valeurs inutiles à une explication publique. Ne conservez les détails sensibles que lorsqu’une enquête autorisée l’exige, avec un accès restreint et une règle de conservation. Un rapport public peut souvent décrire la catégorie et la limite sans reproduire le relevé.
Pour les observations du navigateur, consignez la compilation, le contexte, la date des éléments et la configuration pertinente. Ces conditions rendent une comparaison interprétable sans exposer de scripts protégés ni de messages bruts. La présentation des empreintes montre comment une petite comparaison aux entrées déclarées peut rester utile sans prétendre identifier le propriétaire d’un appareil.
Les cookies du service se distinguent du bandeau de cookies d’un site propre
La section Cookies dans les services Akamai décrit des cookies de session et persistants utilisés par certains services rencontrés via les applications des clients. Ses exemples incluent déterminer si une interaction provient d’un humain ou d’un bot et reconnaître les appareils déjà authentifiés. Ce sont des déclarations sur les fonctionnalités du service, pas un inventaire de cookies vérifiés sur un déploiement particulier de Bot Manager.
Akamai affirme également que ces cookies suivent les principes de protection de la vie privée dès la conception et n’identifient ni ne suivent les personnes. C’est la caractérisation du fournisseur. La déclaration seule n’est pas une mesure indépendante de la possibilité de liaison, et reconnaître un appareil authentifié est un concept plus restreint qu’identifier juridiquement une personne. Une explication de confidentialité devrait conserver les deux descriptions plutôt qu’interpréter l’absence du nom d’une personne comme l’absence de tout lien entre requêtes.
Le même paragraphe comporte des exemples de performance web et d’analyse des médias. Ils décrivent d’autres fonctions de service et ne doivent pas être transférés à Bot Manager comme preuves de sa collecte. En particulier, une déclaration sur un service nommé d’analyse des performances n’établit ni ce qu’envoie un capteur de sécurité ni ce que conserve la périphérie d’un service. L’exemple propre au service et la description générale des cookies ont des périmètres différents.
Pour les cookies des services de sécurité, la déclaration d’Akamai indique les classer comme strictement nécessaires au service demandé et ne pas avoir à proposer de mécanisme de refus. C’est une position attribuée au fournisseur, pas un constat selon lequel chaque cookie serait juridiquement nécessaire dans chaque juridiction ou chaque implémentation cliente. La déclaration aborde séparément les paramètres du navigateur et les outils de gestion des cookies du client, notamment la possibilité que leur refus affecte les fonctionnalités du service.
Cette distinction importe lorsqu’un visiteur voit un bandeau de cookies sur l’application du client. Une préférence concernant des technologies facultatives du site ne documente pas à elle seule le comportement de stockage du service de sécurité et n’empêche pas les requêtes en périphérie d’atteindre le fournisseur. Pour un déploiement que vous gérez, vérifiez ensemble la classification réelle des cookies, le comportement de l’application et la notice applicable. Aucun nom de cookie, contenu de jeton ou paramètre destiné à modifier une évaluation distante n’est nécessaire pour expliquer cette responsabilité.
Questions fréquentes
Bot Manager classe-t-il aussi les bots connus ?
La liste des fonctionnalités décrit la mise à jour continue d’un annuaire de bots connus, en plus des autres méthodes d’évaluation. Une catégorie connue diffère d’une mesure du navigateur ou d’un jugement sur une personne. Cette déclaration ne révèle pas l’appartenance à l’annuaire pour une requête précise et n’établit pas que tous les clients automatisés ont le même effet opérationnel.
Effacer un cookie supprime-t-il les informations collectées ?
Effacer l’état local modifie les données stockées par le navigateur. Cela ne rappelle pas les requêtes déjà reçues en périphérie et ne supprime pas les enregistrements conservés par une application. Le lien éventuel entre des requêtes ultérieures et une activité précédente dépend des observations restantes et du traitement du service. Une action sur le stockage local n’est pas une demande de suppression au serveur.
Le trafic d’un robot utile peut-il affecter les performances ?
Oui. Les cas d’usage des bots utiles et des performances d’Akamai distinguent l’activité souhaitable de son effet sur les ressources. Un robot utile peut ajouter de la charge à un moment inadapté, et la page décrit la planification ou une livraison de contenu différente comme choix de gestion. Il s’agit d’une finalité de disponibilité, pas d’une preuve d’intention malveillante ni d’une raison de collecter un historique illimité de l’appareil.
La couverture mobile implique-t-elle une collecte JavaScript identique ?
Non. Les fonctionnalités du produit étendent la couverture aux applications mobiles, mais cette déclaration ne précise pas des API de navigateur ou des contextes d’exécution identiques. Une application native et un document web nécessitent des inventaires de collecte séparés. Une trace d’une plateforme n’établit pas les accès, les permissions ou la configuration de traitement de l’autre.
Sources
- Description du produit Akamai Bot Manager, déclaration publique consultée.
- Déclaration de confidentialité d’Akamai, mise à jour le 18 août 2026 ; périmètre du responsable du traitement, journaux de service et sections sur les données des sites propres.
- W3C : atténuer les empreintes du navigateur dans les spécifications web.
- Documentation des empreintes de BotBrowser.
Conclusion pratique
Akamai déclare une analyse du comportement par script de page, une prise d’empreinte du navigateur et une évaluation des requêtes en périphérie. L’exposition de la vie privée traverse ces limites ; un inventaire précis d’API, une affirmation de transmission ou une règle de conservation nécessitent leurs propres éléments de preuve. Pour un déploiement que vous gérez, identifiez d’abord la finalité et le rôle de traitement, puis vérifiez l’observation minimale pertinente du navigateur. Utilisez les contrôles du moteur du navigateur pour les surfaces dont ils sont responsables sans les assimiler à un contrôle de la politique du service ou de l’identité.
Cet article fait partie du guide : Qu'est-ce qu'une empreinte de navigateur ?
Articles Connexes
Kasada : signaux des défis et confidentialité
EmpreintePerimeterX : groupes de signaux et confidentialité
EmpreinteDataDome : signaux et exposition de la vie privée
EmpreinteVie privée reCAPTCHA : signaux et limites des preuves
EmpreinteVie privée hCaptcha : signaux et limites des preuves
EmpreinteFunCaptcha : signaux, sessions et vie privée
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.