Vie privée reCAPTCHA : signaux et limites des preuves
Distinguez les observations à la création du jeton, les entrées du serveur, les fonctions conditionnelles et les responsabilités concernant Customer Data.
BotBrowser Team
Vous voulez la documentation structurée pour Empreinte ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
La confidentialité de reCAPTCHA concerne à la fois l’intégration cliente qui génère un jeton et le serveur du client du service qui soumet une évaluation. La documentation Cloud actuelle décrit des champs facultatifs fournis par le client du service, des observations en sortie uniquement associées à la génération du jeton et des responsabilités de traitement de Customer Data assorties de conditions. Ce sont des sources d’information différentes, pas un inventaire unique du navigateur. BotBrowser documente des contrôles natifs du navigateur fondés sur des profils pour les surfaces d’empreinte exposées par le navigateur, mais ne peut pas contrôler les soumissions d’évaluations du client du service, les enregistrements du fournisseur, les décisions du serveur ou les contrats de traitement. Comprendre cette frontière exige d’identifier qui a fourni une valeur, quand elle a été observée et quelles conditions régissent son traitement.
Résumé
- Une évaluation de site web combine le traitement du jeton client avec une soumission distincte depuis le serveur. Des preuves limitées au navigateur ne peuvent pas décrire tout ce que le client du service envoie.
- Les champs facultatifs
Event.userIpAddressetEvent.userAgentsont des entrées de l’appelant. L’objetclientProperties, en sortie uniquement, décrit séparément les observations correspondantes lors de la génération du jeton. - Universal, Express et les autres fonctions ont des conditions précises. Une étiquette de schéma
Optionalne constitue ni un contrat complet d’intégration ni une autorisation de soumettre des données sans rapport. - Depuis le 2 avril 2026, la répartition publiée pour Customer Data attribue au client la responsabilité du traitement et à Google le rôle de sous-traitant, dans le cadre des conditions Cloud citées.
- Le cookie demeure. Le changement de rôles n’établit ni une durée de conservation ni une suppression ou une conformité juridique vérifiées indépendamment.
Sommaire
- Une évaluation comporte deux chemins de données distincts
- Les mêmes noms de champs peuvent avoir des origines différentes
- Les conditions des fonctions changent le sens du schéma
- Les rôles concernant Customer Data ont changé sans supprimer le cookie
- Le contexte des comptes et transactions ne constitue pas un inventaire des appareils
- Les contrôles du navigateur précèdent les décisions du serveur et des contrats
- Conclusion pratique
Une évaluation comporte deux chemins de données distincts
La documentation des évaluations pour sites web décrit une intégration cliente produisant un jeton de réponse lorsqu’un utilisateur final déclenche une action. L’application soumet ensuite ce jeton depuis son serveur pour évaluation. Google traite le jeton soumis et rapporte sa validité ainsi que l’analyse de risque. Cette organisation crée deux chemins pertinents pour la confidentialité : les interactions impliquant l’intégration cliente et les informations que le client du service inclut indépendamment dans la requête du serveur. Examiner uniquement le comportement visible de la page laisse de côté le second chemin.
La documentation indique que les évaluations doivent être créées uniquement sur le serveur pour la sécurité de l’application. Cette recommandation identifie aussi une frontière importante pour les preuves. Un enregistrement réseau du navigateur peut montrer que l’application reçoit la soumission d’un formulaire sans montrer l’évaluation ultérieure entre serveurs. Inversement, un journal des évaluations du serveur peut décrire les champs soumis sans établir quelles interfaces du navigateur l’intégration cliente a lues. Les deux enregistrements peuvent être exacts tout en répondant à des questions différentes. Aucun ne doit devenir silencieusement une description complète de l’autre chemin de traitement.
Le jeton est un résultat intermédiaire, pas un inventaire lisible de chaque signal utilisé pour le générer. La documentation le décrit comme une réponse chiffrée et présente plusieurs moyens pour l’application de le recevoir, notamment le résultat de grecaptcha.enterprise.execute() ou une fonction de rappel cliente. Recevoir ce résultat établit la remise du jeton à l’application. Cela n’établit pas quelles valeurs du navigateur ont été lues, quelles valeurs le serveur a ajoutées ni combien de temps chaque participant a conservé les informations associées. Ces questions exigent leurs propres preuves.
La durée du jeton a également un sens précis. La documentation pour sites web indique qu’un jeton ne peut être utilisé qu’une fois et expire après deux minutes. Ces limites régissent l’utilisation du jeton pour l’évaluation. Elles ne constituent pas une promesse de conservation de deux minutes pour les enregistrements du fournisseur, les journaux de l’application ou les informations de compte associées à l’évaluation. Un jeton rejeté après expiration peut tout de même avoir traversé l’infrastructure de l’application. De même, le fait qu’une application décide de ne pas soumettre un jeton n’établit pas que l’interaction cliente précédente n’a laissé aucun enregistrement.
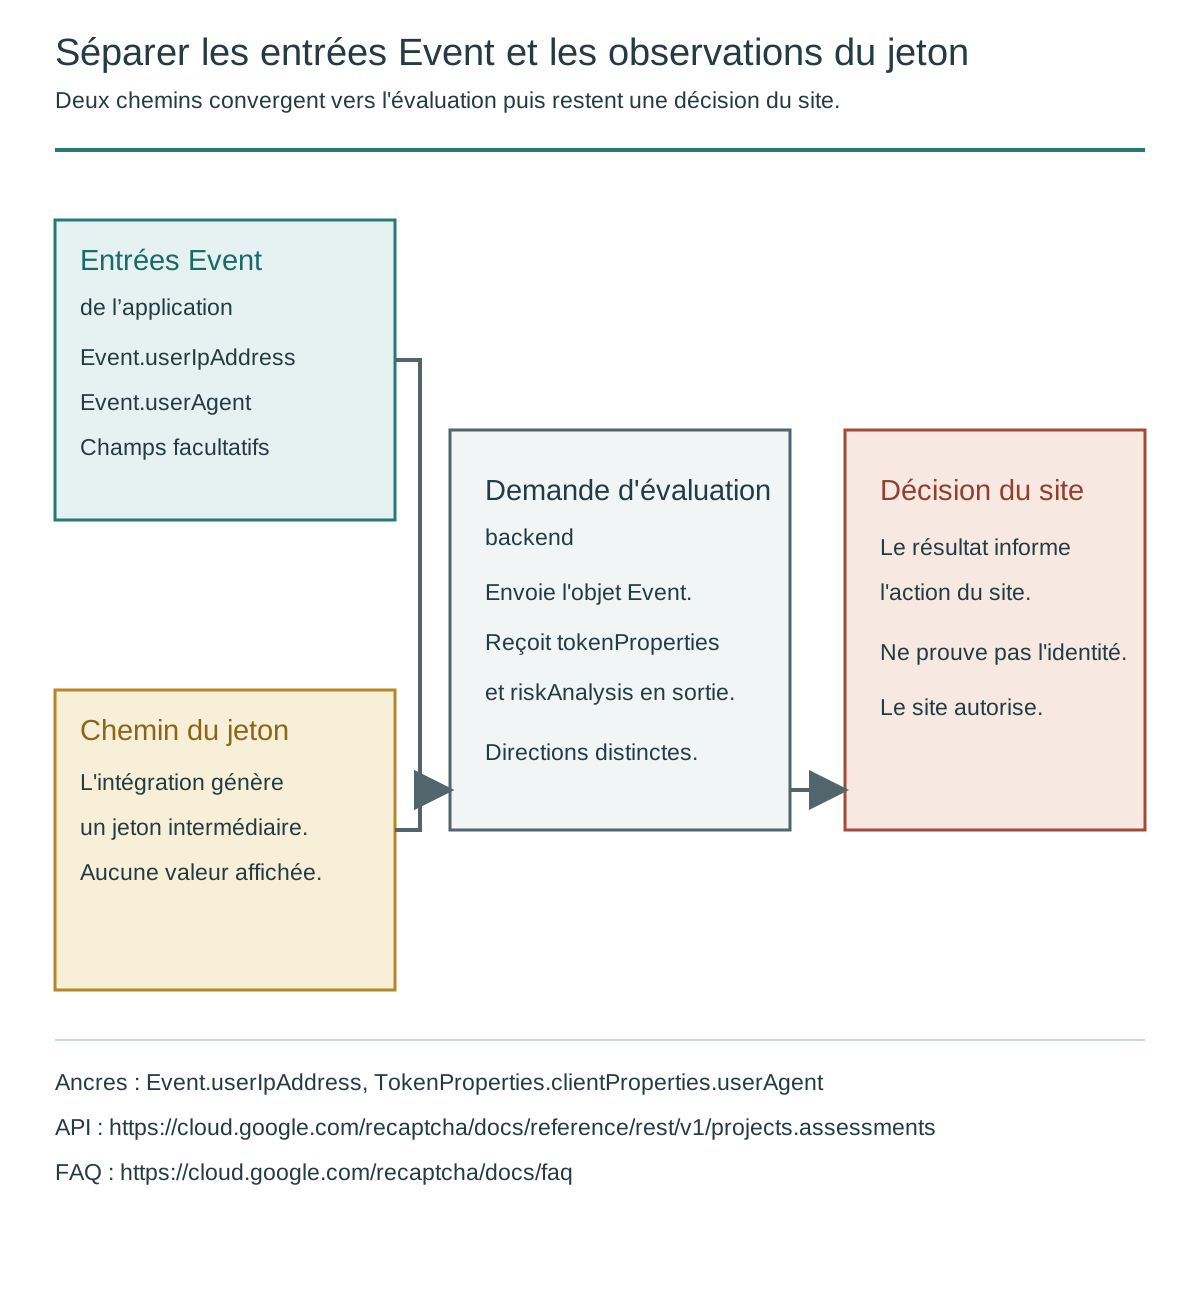
Pour une application de rendez-vous dont vous êtes propriétaire, une distinction utile serait de savoir si le serveur a soumis uniquement le contexte requis pour l’évaluation ou a aussi ajouté certaines informations de requête. Il s’agit d’une question hypothétique de conception, pas d’un test rapporté. Le composant du navigateur pourrait produire un jeton alors que le serveur dispose indépendamment d’un en-tête de requête entrante et d’informations de connexion. Établir que ces valeurs étaient disponibles reste différent d’établir que l’application les a incluses dans son évaluation. La construction des requêtes déployée détermine ce second point.
La référence de la ressource d’évaluation renforce cette distinction en désignant event comme l’événement évalué, et riskAnalysis et tokenProperties comme des résultats en sortie uniquement. Une réponse peut contenir des informations sur l’événement soumis ainsi que de nouvelles propriétés renvoyées. Un champ apparaissant dans le JSON de réponse doit donc rester associé à son objet contenant et à sa direction. Sans ces éléments, une valeur copiée de la requête peut sembler être une nouvelle observation du fournisseur, ou une véritable sortie peut être prise pour une information fournie par le client du service.
L’explication de ce que reçoit un site lors d’une évaluation de risque traite la frontière voisine de la décision applicative. Un jeton, sa validation et la décision d’autorisation du site sont des étapes distinctes. Pour la confidentialité, la question supplémentaire concerne la provenance : quelles informations accompagnaient chaque étape ? Une évaluation réussie ne prouve pas que le site a accompli l’opération métier demandée, et aucun de ces résultats ne décrit les pratiques de stockage du fournisseur. Maintenir ces étapes distinctes rend le chemin de données compréhensible sans faire des résultats d’évaluation une description non étayée de la collecte.
Les mêmes noms de champs peuvent avoir des origines différentes
Dans le schéma de la ressource REST, Event.userAgent et Event.userIpAddress sont des champs facultatifs de l’appelant. Ils décrivent des informations de requête liées à l’événement évalué. La documentation des évaluations pour sites web recommande de les fournir comme valeurs supplémentaires d’évaluation. Il s’agit d’un chemin documenté de soumission par le client du service, pas d’une preuve que chaque application les envoie. Une évaluation de confidentialité exige le comportement effectif du serveur plutôt que de traiter une requête d’exemple ou un champ disponible du schéma comme un enregistrement du trafic de production.
Le côté sortie doit lui aussi rester visible. TokenProperties.clientProperties est une information en sortie uniquement, collectée par l’intégration cliente lors de la génération du jeton. Son champ userIpAddress décrit l’adresse de l’utilisateur à la génération du jeton, tandis que userAgent décrit la chaîne d’en-tête User-Agent observée par reCAPTCHA à ce moment. Décrire uniquement les entrées facultatives effacerait cette seconde provenance. Omettre un champ de l’appelant n’établit pas que le fournisseur ne peut pas observer des informations correspondantes par sa propre interaction avec le client.
La référence donne des limites concrètes de représentation pour ces sorties. L’adresse peut être une IPv4 ou une IPv6 canonique, les adresses IPv6 avec IPv4 incorporée étant canonisées en IPv4 standard. La chaîne User-Agent renvoyée est tronquée à une longueur maximale de 1000 caractères. Ces conditions décrivent la représentation de la sortie, pas un profil exhaustif du navigateur. Elles signifient aussi qu’une simple comparaison textuelle peut refléter le format ou la troncature plutôt qu’un changement significatif de personne ou d’appareil. La sémantique documentée du champ doit accompagner toute comparaison.
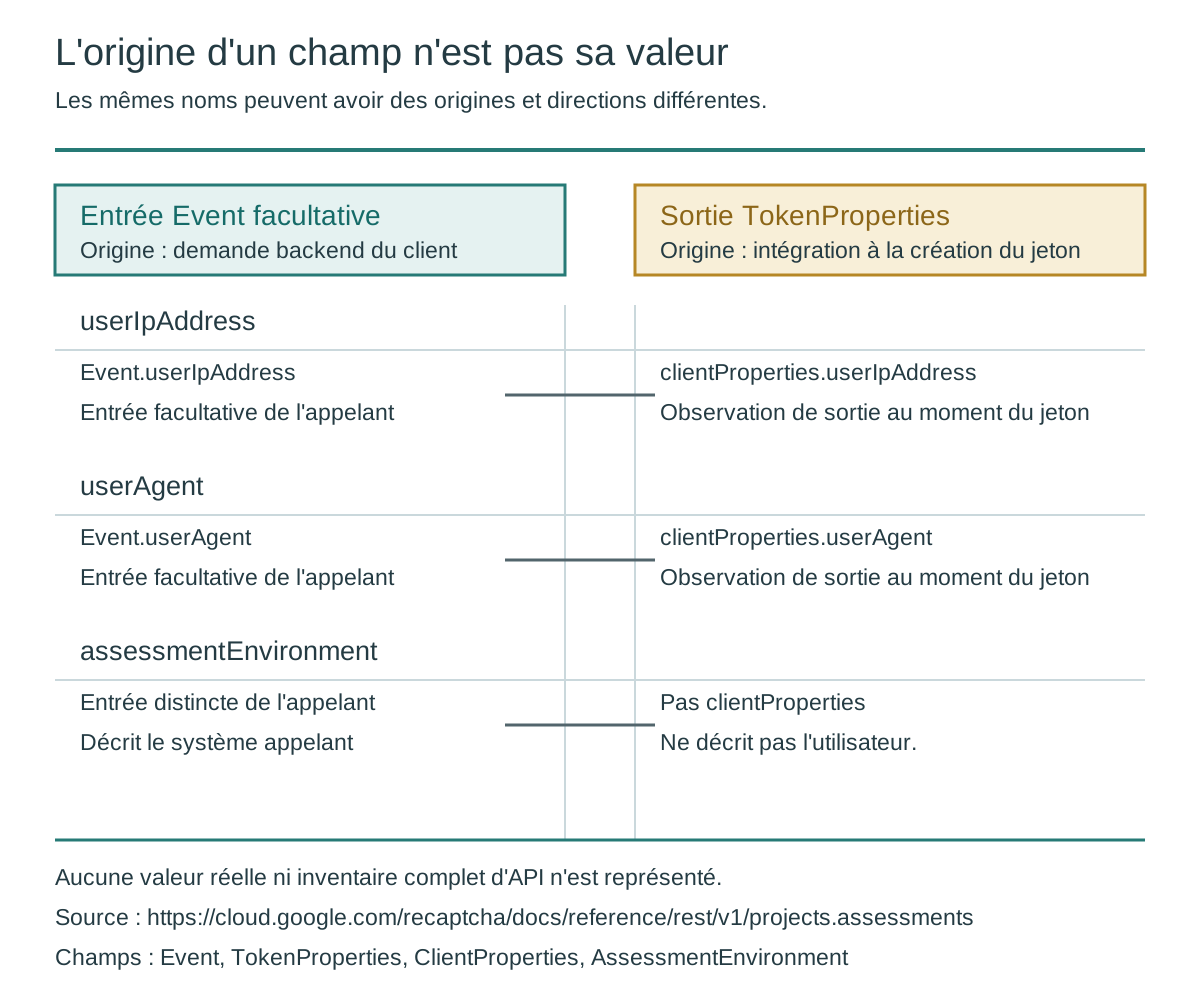
Une évaluation peut donc contenir deux descriptions de contextes de requête liés sans que l’une ou l’autre soit une preuve redondante d’une mesure unique. Le serveur du client du service reçoit une requête à un point du flux applicatif ; les propriétés du client concernent la génération du jeton. La concordance des valeurs dépend de l’interaction et de l’infrastructure réelles, qu’il faut établir plutôt que supposer. Une différence ne prouve pas à elle seule une faute, et une concordance ne prouve pas que les valeurs proviennent de la même observation. Préservez à la fois la provenance et le moment avant de leur attribuer un sens.
| Emplacement documenté | Origine et condition | Décision attendue pour la confidentialité | Source |
|---|---|---|---|
event.userAgent | Informations facultatives de requête fournies par l’appelant | Vérifier si le serveur les soumet effectivement et dans quel but | Schéma d’évaluation |
event.userIpAddress | Adresse facultative liée à l’événement et fournie par l’appelant | Identifier la source de confiance du serveur et le périmètre soumis | Évaluation pour sites web |
tokenProperties.clientProperties.userAgent | Observation d’en-tête en sortie uniquement à la génération du jeton | Prendre en compte les données renvoyées indépendamment des entrées omises par l’appelant | Schéma d’évaluation |
tokenProperties.clientProperties.userIpAddress | Adresse en sortie uniquement à la génération du jeton | Préserver la provenance au moment du jeton et le format documenté de l’adresse | Schéma d’évaluation |
event.ja3, event.ja4, event.headers | Contexte facultatif de l’appelant | Vérifier la soumission réelle ; ne pas qualifier ces champs de lectures d’API du navigateur | Schéma d’évaluation |
La provenance des en-têtes HTTP est particulièrement importante. La documentation pour sites web identifie l’entrée d’agent utilisateur comme une information présente dans la requête HTTP entrante. Fournir cette chaîne d’en-tête ne prouve pas que JavaScript a lu navigator.userAgent. De même, une adresse disponible pour le serveur ne prouve pas qu’une API du navigateur l’a renvoyée. L’infrastructure et la confiance accordée aux en-têtes restent importantes lorsque l’application choisit son entrée. L’explication des adresses transférées dans la documentation identifie une source possible ; elle n’établit pas quel intermédiaire ou quelle adresse est fiable dans chaque déploiement.
Les champs ja3 et ja4 concernent des empreintes de clients TLS, tandis que headers concerne des informations de requête HTTP. Ce sont des entrées du schéma de contexte de requête, pas des API JavaScript. Leur présence établit une catégorie d’entrée prise en charge, pas que l’intégration cliente les a calculées ou que le client du service les a soumises. Aucun enregistrement V8 JSONL actuel attribué au fournisseur n’est disponible dans l’ensemble de preuves examiné. Les lignes historiques disponibles de graphiques génériques identifient une page intégratrice plutôt qu’un site d’appel V8 du fournisseur. Elles n’étayent ni un inventaire actuel des API de reCAPTCHA ni l’affirmation qu’une lecture particulière du navigateur était absente.
Les conditions des fonctions changent le sens du schéma
La référence d’évaluation emploie largement Optional parce qu’une ressource prend en charge plusieurs configurations. Cette étiquette ne constitue pas tout le contrat d’une intégration sélectionnée. Un champ peut être facultatif à l’échelle de la ressource mais obligatoire pour une fonction donnée. De même, la disponibilité d’un champ n’est pas une autorisation universelle d’envoyer des données sans rapport avec la finalité choisie. Lisez sa description avec les conditions de la clé et des fonctions déployées, plutôt que de décider à partir d’une liste de noms sans contexte.
expectedAction en est un exemple clair. Le schéma le qualifie de facultatif, mais indique explicitement qu’il est obligatoire pour les clés Universal. Il décrit l’action attendue pour l’événement et doit correspondre à l’action fournie lors de la génération du jeton. Une description de confidentialité doit distinguer cette attente déclarée par l’appelant de tokenProperties.action, en sortie uniquement, qui décrit le nom d’action fourni à la génération du jeton. Ces valeurs relient une évaluation à une interaction applicative ; elles n’établissent pas l’identité de la personne qui l’effectue et ne remplacent pas les règles d’autorisation propres à l’application.
Express introduit une autre condition modifiant le chemin de données. L’indicateur express décrit une évaluation sans jeton, et son activation exige que siteKey fasse référence à une clé de site Express. Sans jeton signifie donc une configuration particulière prise en charge, pas que toute évaluation de site web peut simplement omettre son jeton. La documentation des évaluations pour sites web décrit la soumission de jetons pour les intégrations web énumérées. Les deux affirmations peuvent être vraies parce que leurs conditions diffèrent. Une cartographie des données doit identifier la configuration réelle avant de décider quelles observations liées aux jetons s’appliquent.
D’autres indicateurs ont également des prérequis et des conséquences. Un wafTokenAssessment exige un jeton spécifié créé par une clé compatible WAF. Activer firewallPolicyEvaluation demande une évaluation de la configuration des politiques de pare-feu du projet et une action suggérée dans la réponse. Ce sont des choix de fonctions, pas des descriptions de chaque évaluation. Leur présence dans le schéma commun ne montre pas qu’un site web les a activés, a reçu leurs sorties ou a utilisé ces sorties dans une décision applicative. Les preuves de configuration doivent accompagner toute affirmation sur le déploiement.
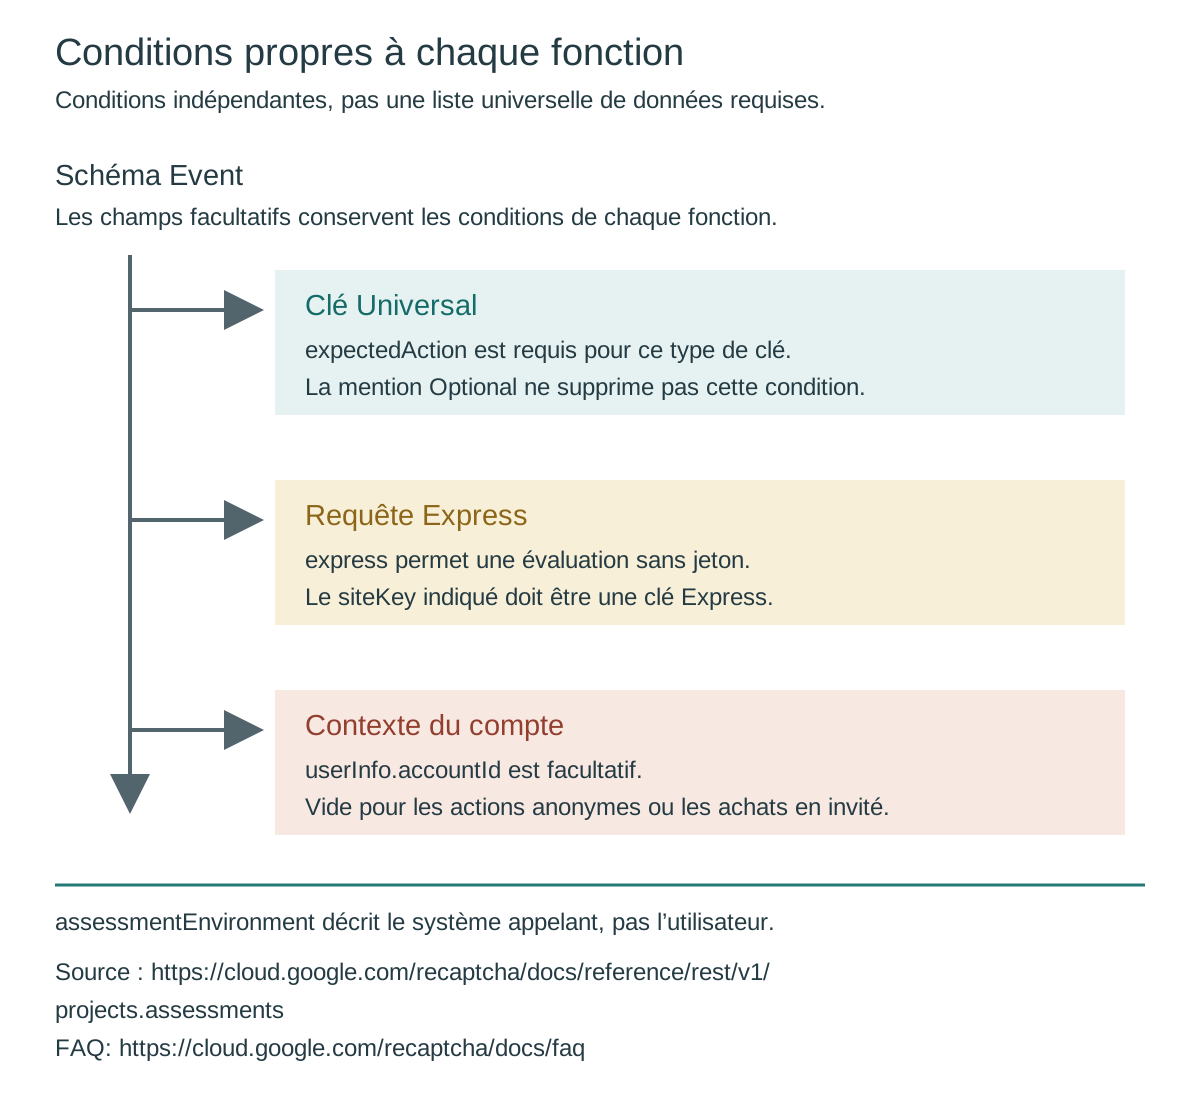
| Condition du schéma ou de la fonction | Ce que la documentation établit | Décision attendue |
|---|---|---|
| Clé Universal | expectedAction est obligatoire | Conserver la relation de l’action dans la description des données de l’intégration |
express activé | L’évaluation est sans jeton et nécessite une clé de site Express | Ne pas appliquer à ce chemin les hypothèses fondées sur les jetons |
wafTokenAssessment activé | Le jeton doit exister et provenir d’une clé compatible WAF | Établir la fonction configurée avant de décrire ses données |
transactionData et Fraud Prevention | Le contexte transactionnel intervient selon les paramètres de la fonction | Examiner séparément la finalité transactionnelle et les champs inclus |
assessmentEnvironment | Décrit le système invoquant assessments.create | Classer les informations de module et de version comme environnement de l’appelant |
assessmentEnvironment mérite une attention particulière, car son nom peut inviter à une mauvaise interprétation. La référence indique explicitement qu’il décrit l’environnement créant l’évaluation, pas celui de l’utilisateur. Ses champs client et version peuvent identifier le module initiateur et sa version. Un identifiant d’intégration dans cet objet n’est donc pas une version de navigateur découverte sur l’appareil du visiteur. Le mal classer gonflerait le prétendu inventaire des appareils tout en masquant des informations opérationnelles que le client du service ou son intégration fournit volontairement.
Les sorties conditionnelles exigent le même traitement que les entrées. La ressource décrit des résultats de défense des comptes lorsqu’un identifiant de compte est fourni, des évaluations transactionnelles lorsque des données de transaction interviennent et des conditions d’évaluation de fraude téléphonique impliquant l’activation de la défense SMS et les entrées requises. Ces sorties n’établissent pas un profilage universel de chaque visiteur. Elles documentent des relations entre fonctions, contexte fourni et évaluations renvoyées. Pour un service dont vous êtes propriétaire, la décision utile est de déterminer quelles relations s’appliquent réellement, pas si chaque objet de la référence peut être copié dans un inventaire unique de confidentialité.
Cela affecte également les preuves négatives. Un champ absent peut refléter une fonction inutilisée, une condition non remplie ou une réponse qui ne l’incluait simplement pas. Son absence ne doit pas devenir automatiquement une déclaration sur tous les traitements internes. Inversement, une fonction facultative documentée ne doit pas être attribuée au site sans preuve du déploiement. La référence fournit une sémantique conditionnelle ; l’application fournit sa configuration effective et la requête soumise. Combiner soigneusement ces sources produit une description plus limitée, mais défendable, du service réellement utilisé.
Les rôles concernant Customer Data ont changé sans supprimer le cookie
La FAQ Cloud actuelle date le changement de rôles concernant Customer Data du 2 avril 2026. Elle indique que les clients du service sont les seuls responsables du traitement de Customer Data et que Google traite ces données conformément aux conditions de service Google Cloud et à l’avenant relatif au traitement des données Cloud. La catégorie de données nommée, la relation de service et les accords comptent. Ce n’est pas une déclaration selon laquelle chaque produit Google ou chaque activité de traitement possède la même répartition des rôles, ni un audit indépendant d’un déploiement particulier.
La FAQ explique la relation antérieure comme une situation où les clients du service contrôlaient déjà les données de leurs utilisateurs finaux, tandis que Google maintenait une position de responsable indépendant concernant la prestation du service. Son explication du changement indique que Google renonce à déterminer les finalités et les moyens du traitement de Customer Data dans son rôle de sous-traitant. Cette explication concerne la responsabilité du traitement défini. Elle n’implique pas que l’intégration sous-jacente du navigateur cesse de fonctionner, que les informations existantes disparaissent ou que les responsabilités propres au client du service commencent seulement à la date du changement.
Les modifications du badge et des déclarations découlent de cette explication des rôles. La FAQ indique que les références à la politique de confidentialité et aux conditions d’utilisation de Google sont retirées du badge à partir du 2 avril 2026 et recommande de retirer ces références des sites des clients du service afin de représenter correctement la situation. Elle indique également que les clients doivent revoir leurs informations destinées aux utilisateurs finaux afin de couvrir la sécurité et la prévention de la fraude et des abus. Retirer un lien obsolète n’équivaut donc pas à supprimer l’explication du traitement du site web. L’information du client du service doit toujours décrire la relation réellement applicable.
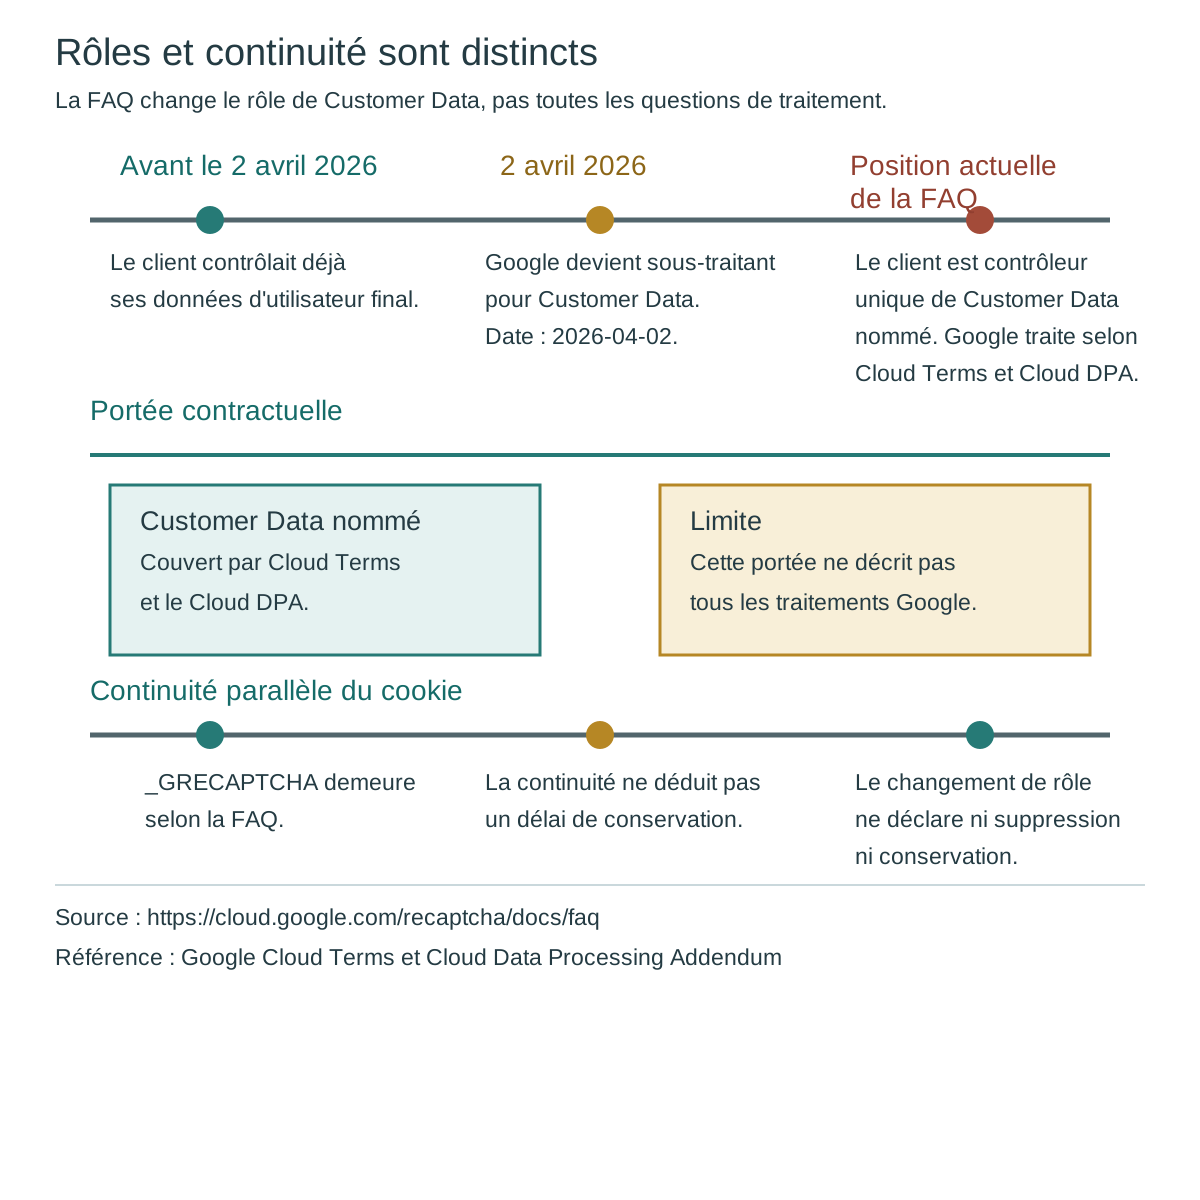
La continuité du cookie est explicite. La FAQ indique que le cookie nécessaire _GRECAPTCHA est défini lorsque le service s’exécute pour l’analyse de risque. Dans son explication du passage au rôle de sous-traitant, elle précise que le cookie reCAPTCHA n’est pas affecté. Une répartition différente des rôles n’élimine pas le stockage du navigateur. La FAQ évoque également l’utilisation de www.recaptcha.net à la place de www.google.com lorsque l’on préfère éviter les autres cookies de ce domaine. Cette distinction de domaine ne doit pas être réécrite comme une affirmation que le cookie nécessaire au service ou tous les traitements du fournisseur disparaissent.
La limitation des finalités est plus précise qu’une affirmation générale selon laquelle les données ne servent qu’à un verdict ponctuel. La FAQ s’engage à traiter Customer Data uniquement dans la mesure nécessaire pour fournir et maintenir le service et préserver l’efficacité de ses capacités de sécurité, de détection des menaces, de protection et de réponse face aux menaces évolutives. Elle relie cette déclaration aux conditions propres au service et à l’avenant de traitement. Une explication de confidentialité doit conserver ces finalités déclarées plutôt que de les réduire à la seule validation du jeton ou de les étendre à des usages non précisés que la source n’établit pas.
Aucune durée de conservation ne découle de ces passages. Un rôle de sous-traitant, un cookie nécessaire et un jeton de courte durée répondent chacun à une question différente. Aucun ne fournit une durée générale pour le stockage du fournisseur, les journaux du client du service ou la suppression ultérieure. La FAQ oriente les lecteurs qui s’interrogent sur les données de session et les protections vers l’avenant de traitement et les conditions propres au service. Ces références identifient où examiner les obligations applicables ; elles ne prouvent pas qu’un enregistrement individuel a été supprimé. La durée de stockage et la suppression réelle restent des questions distinctes exigeant les conditions pertinentes et des preuves opérationnelles.
La FAQ formule aussi une déclaration du fournisseur sur ses engagements relatifs au RGPD par l’avenant de traitement Cloud. Cette déclaration doit rester attribuée à Google et à ses obligations définies. Elle n’établit pas indépendamment que l’information, la configuration, la base juridique ou le traitement des demandes des utilisateurs d’un site particulier sont conformes. La revue des politiques de confidentialité pour les lancements de produits explique la tâche plus large consistant à aligner les affirmations produit sur les sources qui les étayent. Ici, la décision propre au service est concrète : maintenir les rôles concernant Customer Data, les finalités déclarées, le comportement du cookie et les résultats de conservation non vérifiés dans des parties distinctes de l’explication.
Le contexte des comptes et transactions ne constitue pas un inventaire des appareils
Le schéma d’évaluation inclut les objets facultatifs userInfo et transactionData parce que le service prend en charge des fonctions liées aux comptes et aux paiements. Ces objets décrivent du contexte applicatif, pas une liste universelle de propriétés lues automatiquement dans chaque navigateur. Un client du service peut détenir des informations par son système de comptes ou son processus de paiement indépendamment de l’intégration cliente. S’il soumet ce contexte pour évaluation, l’enjeu de confidentialité provient du chemin supplémentaire de données et de sa finalité, pas du fait de rebaptiser chaque champ en empreinte d’appareil.
UserInfo.accountId est facultatif. Sa description concerne les requêtes avec session ouverte et les requêtes de connexion ou d’inscription, et demande aux appelants de le laisser vide pour les actions sans session ouverte ou les paiements en tant qu’invité. createAccountTime décrit de même l’heure de création du compte associé et doit rester vide lorsqu’aucun compte n’est associé à l’utilisateur actuel, notamment dans les cas d’invité indiqués. Ces instructions étayent un choix concret de minimisation : ne pas fabriquer de contexte persistant de compte pour une opération anonyme simplement afin de remplir les champs disponibles du schéma.
La distinction entre identité de compte et autres identifiants compte aussi. userInfo.userIds peut contenir des identifiants tels qu’une adresse électronique, un numéro de téléphone ou un nom d’utilisateur selon la structure documentée. La prise en charge d’identifiants liés aux invités ailleurs dans le schéma n’annule pas l’instruction précise de laisser accountId vide pour les paiements en tant qu’invité. Une liste facultative ne crée pas non plus l’obligation d’envoyer chaque identifiant déjà connu de l’entreprise. Chaque catégorie soumise exige une finalité pertinente pour la fonction et une description exacte de sa source.
L’ancien champ hashedAccountId est explicitement obsolète, la référence orientant les appelants vers l’identifiant de compte de userInfo. Sa présence historique ne doit pas devenir une nouvelle recommandation d’ajouter une identité hachée à chaque requête. Un identifiant haché peut toujours fournir une association stable dans un système ; le mot haché n’établit pas à lui seul l’anonymat et ne supprime pas la nécessité d’expliquer les liens. La décision actuelle de conception doit suivre le champ pris en charge et les conditions de compte applicables, plutôt que de reproduire un exemple obsolète comme conseil général de confidentialité.
Les données transactionnelles élargissent le contexte dans une autre direction. Le schéma décrit le moyen de paiement, la devise, la valeur de la transaction, les informations de livraison et de facturation, les articles achetés, les informations sur les parties au paiement et les détails de réponse de la passerelle. Ces champs peuvent révéler les caractéristiques d’une interaction commerciale plutôt que les capacités du navigateur. La FAQ indique séparément que l’installation du service sur une page de transaction implique l’examen de certains signaux transactionnels et que des informations plus complètes peuvent être fournies par l’intégration liée à la fraude. Ces déclarations ne prouvent pas que chaque site soumet chaque objet transactionnel.
Les paramètres des fonctions conditionnent l’évaluation obtenue. La référence relie transactionData à Fraud Prevention et documente l’interaction de fraudPrevention avec la configuration Cloud de cette fonction. Cela signifie que l’inclusion de données, l’activation de la fonction et l’évaluation renvoyée sont des faits liés mais distincts. Une requête peut être conçue pour une finalité alors qu’un autre déploiement active des fonctions supplémentaires. Un inventaire fidèle identifie donc la relation déployée plutôt que de considérer toutes les sorties transactionnelles possibles comme présentes sur chaque page de paiement.
Certaines descriptions transactionnelles comportent des distinctions précises à préserver. cardLastFour décrit les quatre derniers chiffres, pas un numéro complet de carte de paiement. Les codes de réponse de vérification de la passerelle décrivent des résultats du traitement du paiement, pas une demande de soumission du secret de vérification sous-jacent. transactionId est un identifiant personnalisé servant à référencer une transaction, les tentatives répétées de la même transaction utilisant le même identifiant selon la référence. Ce sont des catégories contextuelles aux implications différentes en matière de rapprochement et de sensibilité. Les regrouper sous une étiquette indifférenciée de « signal technique » masquerait des informations que le propriétaire du site partage volontairement.
Pour un paiement hypothétique en tant qu’invité dans une application dont vous êtes propriétaire, la décision attendue pourrait être de laisser vides les champs propres au compte, de n’inclure que le contexte transactionnel requis par la fonction choisie et d’éviter de dupliquer des identifiants inutiles. Il s’agit d’un scénario de conception, pas d’une évaluation exécutée ni d’une garantie qu’une configuration donnée suffit. Le responsable du serveur peut établir les catégories réellement soumises sans exposer les valeurs des clients, tandis que le responsable de la confidentialité détermine comment décrire leurs finalités et destinataires. La minimisation relève de la frontière de construction des requêtes ; elle ne peut pas être déléguée à un paramètre de navigateur après que l’application a fourni les données.
Les contrôles du navigateur précèdent les décisions du serveur et des contrats
La présentation des empreintes du navigateur de BotBrowser documente des contrôles fondés sur des profils sur les surfaces exposées par le navigateur, notamment les propriétés de Navigator, les graphiques, l’audio, les polices, les dimensions d’écran et la mesure du temps. Elle décrit un fonctionnement natif du navigateur plutôt qu’une injection de JavaScript dans la page. Cela étaye une affirmation de capacité du produit sur la configuration documentée du navigateur. Cela n’établit pas lesquelles de ces surfaces le code actuel de reCAPTCHA lit, si une configuration choisie change une décision du fournisseur ou si chaque résultat de rendu est identique selon les environnements.
Une modification de propriété au niveau de la page se situe ailleurs. Elle agit dans l’environnement JavaScript et les chemins qui rencontrent effectivement cette modification. Sa seule présence ne peut pas établir l’état de chaque autre contexte d’exécution ou opération native. Les contrôles natifs du navigateur ont leur propre configuration documentée et leurs propres limites de prise en charge, plutôt que de reposer sur le remplacement d’une propriété d’une page. La comparaison utile concerne l’endroit où le contrôle agit et ce qu’il prend en charge, pas un classement d’efficacité face à un service tiers. Aucun de ces emplacements ne prouve un appel non observé du fournisseur.
La limite des preuves locales est décisive pour toute affirmation propre au fournisseur. Les documents examinés ne contiennent aucune capture V8 JSONL actuelle attribuée au fournisseur. Les lignes historiques génériques de Canvas et WebGL utilisent un emplacement d’exécution de page intégratrice et n’apportent aucune attribution à un site d’appel du fournisseur. Les exigences de validation de la surveillance peuvent décrire comment vérifier une observation réussie, mais ne prouvent pas qu’une telle capture a eu lieu. Aucun inventaire actuel des API du navigateur ne découle de ces documents, et aucune nouvelle capture réelle n’en établit un. Une connaissance générale d’une surface du navigateur ne peut pas combler ce manque d’attribution.
Des affirmations différentes exigent des preuves différentes. Un événement attribuable du navigateur pourrait établir une lecture pendant une phase définie. Une requête du serveur expurgée pourrait établir une soumission du client du service. Une réponse d’évaluation pourrait établir les propriétés du jeton renvoyées. Un accord de traitement pourrait établir les responsabilités déclarées, tandis qu’un audit opérationnel serait nécessaire pour le comportement réel de conservation ou de suppression. Passer d’une affirmation à une autre exige des preuves supplémentaires, pas seulement une description plus forte du même artefact. Un champ de réponse peut être bien documenté sans révéler son exécution sous-jacente dans le navigateur.
| Question de confidentialité | Preuves et responsable appropriés | Décision attendue |
|---|---|---|
| Le code du fournisseur a-t-il lu une interface du navigateur ? | Événement actuel d’exécution attribuable provenant d’une observation autorisée | Laisser l’affirmation non résolue sans attribution à la source |
| Le client du service a-t-il soumis du contexte de compte ou de requête ? | Preuves expurgées de construction et de soumission des requêtes fournies par le responsable du serveur | Minimiser les champs inutiles à cette frontière |
| Qu’a renvoyé l’évaluation ? | Preuves de réponse au périmètre défini interprétées selon la référence REST | Séparer le contexte de l’appelant des propriétés en sortie uniquement |
| Quelles finalités de Customer Data s’appliquent ? | Conditions applicables et explication de confidentialité du responsable contractuel | Préserver la relation de service assortie de conditions décrite par la FAQ |
| Un enregistrement a-t-il été supprimé ? | Obligation applicable et preuves opérationnelles de son dépositaire | Ne pas leur substituer l’expiration du jeton ou les journaux du navigateur |
Les contrôles du navigateur ne peuvent pas supprimer des informations que le serveur du client du service possède déjà et choisit de soumettre. Modifier une propriété visible de la page ne modifie pas userInfo, ne supprime pas un objet transactionData du serveur et ne réécrit pas un journal applicatif. Un profil de navigateur ne modifie pas non plus l’accord de traitement Cloud et ne supprime pas les enregistrements conservés par une autre partie. Les observations réseau restent également une relation distincte. Un paramètre documenté de surface du navigateur ne constitue donc pas une promesse de fonctionnement anonyme, d’acceptation universelle ou de contrôle des informations de chaque destinataire.
Une intégration dont vous êtes propriétaire peut rendre ces frontières examinables sans collecter de valeurs privées. Identifiez les catégories réellement soumises, les catégories de sortie réellement utilisées, les conditions des fonctions activées et la relation contractuelle responsable. Lorsque des preuves manquent, conservez la question précise sans réponse plutôt que de remplir un inventaire imaginaire des appareils. Cela produit une explication propre à reCAPTCHA : les observations du jeton client, les ajouts du client du service et les obligations relatives à Customer Data sont attribués séparément. Le prochain changement utile relève du composant responsable des données, qu’il s’agisse de la configuration du navigateur, de la construction des requêtes du serveur ou de l’explication du traitement du site.
Questions fréquentes
Omettre Event.userIpAddress signifie-t-il que reCAPTCHA ne peut pas observer une adresse ?
Non. Ce champ est une entrée facultative de l’appelant. La référence REST documente séparément clientProperties.userIpAddress, en sortie uniquement, lors de la génération du jeton. Omettre un champ de soumission n’établit pas l’absence d’observations propres au fournisseur sur le réseau ou au moment du jeton.
clientProperties.userAgent prouve-t-il une lecture de Navigator par JavaScript ?
Non. La référence décrit une chaîne d’en-tête User-Agent observée pendant la génération du jeton. Cette sortie n’identifie pas un site d’appel JavaScript et n’établit pas un inventaire actuel des API du navigateur. La provenance des en-têtes et l’exécution des interfaces du navigateur constituent des affirmations différentes.
Le changement de rôles du 2 avril 2026 a-t-il supprimé le cookie ?
Non. La FAQ actuelle indique explicitement que le cookie n’est pas affecté. Son explication des rôles de responsable et de sous-traitant pour Customer Data concerne le service nommé et les conditions Cloud ; elle n’affirme pas que le stockage ou le traitement du navigateur a cessé.
Chaque champ facultatif d’évaluation convient-il à chaque visiteur ?
Non. Les conditions des fonctions et les instructions propres à chaque champ s’appliquent toujours. Universal exige expectedAction, les évaluations Express sans jeton nécessitent une clé Express, et les champs de compte comprennent des instructions demandant de les laisser vides pour certaines actions anonymes ou en tant qu’invité.
L’expiration du jeton peut-elle établir une échéance de suppression chez le fournisseur ?
Non. La durée documentée de deux minutes du jeton concerne son utilisation pour l’évaluation. Elle n’établit pas combien de temps les enregistrements du fournisseur, les soumissions du client du service ou les journaux applicatifs sont stockés, et ne prouve pas qu’un enregistrement particulier a été supprimé.
Sources
- Google Cloud : FAQ reCAPTCHA et Fraud Defense
- Google Cloud : Ressource REST projects.assessments
- Google Cloud : Créer des évaluations pour les sites web
- BotBrowser : Présentation des empreintes du navigateur
Conclusion pratique
Cartographiez les informations de reCAPTCHA par origine avant de décider ce qu’un contrôle du navigateur peut changer. Séparez les champs Event soumis par le client du service de clientProperties au moment du jeton, appliquez les conditions de la fonction choisie et utilisez les conditions actuelles de Customer Data pour les responsabilités de traitement. Les preuves disponibles n’établissent ni un inventaire actuel des API du navigateur attribué au fournisseur ni un résultat de suppression. Pour une intégration dont vous êtes propriétaire, vérifiez les catégories réellement soumises, retirez le contexte inutile de compte et de requête, et alignez l’explication du site sur la relation de service utilisée.
Cet article fait partie du guide : Qu'est-ce qu'une empreinte de navigateur ?
Articles Connexes
reCAPTCHA v3 vs v2 : responsabilités du site
ComparaisonRevoir la confidentialité du navigateur avant la mise en production
EmpreinteVie privée hCaptcha : signaux et limites des preuves
EmpreinteFunCaptcha : signaux, sessions et vie privée
EmpreinteAkamai Bot Manager : données du capteur et vie privée
EmpreintePerimeterX : groupes de signaux et confidentialité
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.