Cloudflare et DataDome : réponses au scraping
Distinguez les challenges Cloudflare, décisions DataDome et erreurs du serveur d’origine sans déduire de score interne depuis une réponse.
BotBrowser Team
Vous voulez la documentation structurée pour Réseau ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
Une réponse Cloudflare ou DataDome pendant le scraping révèle une décision d’accès, pas tous les signaux qui l’ont produite. Il faut d’abord distinguer un challenge du contenu demandé, d’une erreur du serveur d’origine ou d’un défaut d’intégration. BotBrowser documente des contrôles du navigateur et des en-têtes de requête ; il ne révèle pas les états de décision privés de ces fournisseurs et ne garantit pas l’acceptation. Une collecte autorisée doit classifier la réponse et transmettre les décisions non résolues au propriétaire du site par son canal d’assistance approuvé.
Regarder la vidéo
Cette vidéo en anglais explique comment classer une page de challenge Cloudflare, un HTTP 403 générique et un document HTML inattendu pendant le scraping, et pourquoi le score masqué ou la décision DataDome nécessitent le relevé corrélé de l’opérateur. L’audio est en anglais.
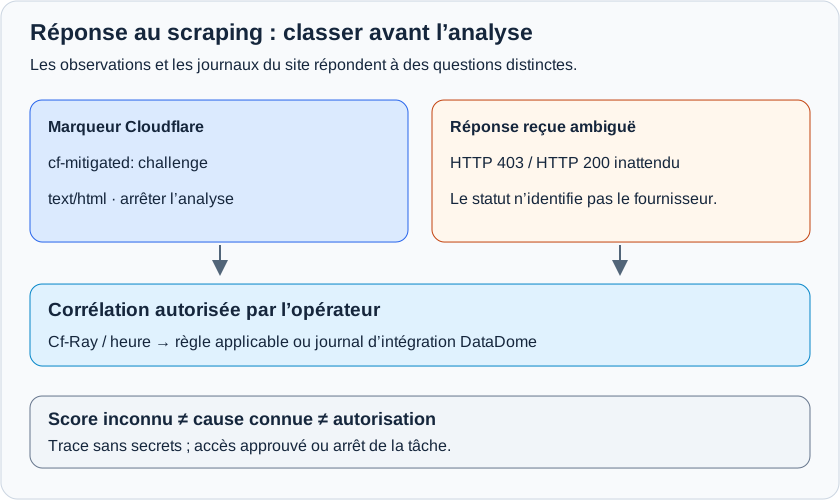
Résumé
- Cloudflare documente
cf-mitigated: challengecomme marqueur de page de challenge, avectext/htmlmême si un autre type de ressource était demandé. - Un HTTP
403générique n’identifie ni fournisseur, ni règle, ni signal du navigateur. - Les scores Cloudflare et les décisions de l’intégration DataDome se situent à une autre frontière d’observation que la réponse au navigateur.
- Séparez classification, permission, réussite applicative et cause d’un refus.
- Conservez une corrélation de requêtes expurgée des secrets et demandez à l’opérateur autorisé de consulter ses journaux.
Sommaire
- Regarder la vidéo
- Scores Cloudflare et actions configurées
- Une réponse de challenge dans une collecte
- Décisions DataDome derrière l’intégration
- Table de décision entre réponse et action
- Corréler la requête sans collecter de secrets
- Contrôles du navigateur et frontière d’accès
- Conclusion pratique
Scores Cloudflare et actions configurées
La documentation des scores Cloudflare définit des valeurs de 1 à 99. Avec 1, Cloudflare estime avec une forte certitude que la requête est automatisée ; avec 99, qu’elle vient d’un humain. Ce sont les extrémités d’une classification du fournisseur, pas une conversion publiée en pourcentage. Un score ne certifie pas durablement l’identité du client, et un client externe ne doit pas s’en attribuer un à partir de la page reçue.
La même référence indique que l’opérateur peut employer les scores dans des règles WAF personnalisées pour bloquer, soumettre à un challenge ou autoriser les requêtes, ainsi que dans Workers. Classification et action sont donc distinctes : la politique configurée transforme l’information disponible en réponse. Les scores détaillés nécessitent l’offre Enterprise Bot Management documentée. Un challenge ne prouve ni l’emploi de cette offre ni celui d’une règle particulière fondée sur un score.
Cloudflare décrit notamment des heuristiques, l’apprentissage automatique et des détections JavaScript. Cette description publique ne donne pas la contribution de chaque valeur du navigateur à un refus particulier. La présentation de la détection d’automatisation distingue les propriétés exposées par le navigateur du contexte global de la requête. Modifier une propriété ne démontre ni une nouvelle classification du fournisseur ni une permission du site.
Limitez les déductions lors des comparaisons. Un changement de réponse peut coïncider avec une autre route applicative, un autre état de session ou une règle du propriétaire. Sans trace corrélée de l’opérateur autorisé, il ne permet pas d’isoler une entrée du détecteur comme cause. Consignez d’abord la requête et son résultat visible ; un score indisponible doit rester indisponible.
L’analyse des scores et journaux Cloudflare détaille les preuves accessibles à l’opérateur. Associez une entrée de score à sa requête, sans l’emprunter à une autre navigation du même navigateur. La requête du document et celle des données qui suit peuvent recevoir des décisions différentes. Comparez la transaction identifiée à sa propre trace, pas à un supposé verdict couvrant tout l’onglet.
Une réponse de challenge dans une collecte
La référence des réponses de challenge Cloudflare donne un marqueur destiné au client : cf-mitigated avec la valeur challenge. Elle précise également que le type du contenu est text/html, quel que soit le type de ressource demandé. Un endpoint habituellement JSON peut donc renvoyer un challenge HTML au lieu des données. Examinez les métadonnées disponibles avant de fournir le corps à un analyseur JSON.
Un corps HTML inattendu ne suffit pas à attribuer la réponse. Une page de connexion, un modèle d’erreur du serveur d’origine ou une page intermédiaire peuvent aussi être en HTML. Privilégiez le marqueur documenté lorsqu’il est disponible et distinguez un en-tête observé dans les outils réseau d’un en-tête lisible par JavaScript. L’exemple fetch illustre ce contrôle ; il ne rend pas tous les en-têtes lisibles pour toute requête entre origines.
Si la réponse est une page de challenge documentée, arrêtez l’extraction qui en dépend. Un échec ultérieur de l’analyseur est une conséquence, pas une preuve de modification du schéma de données. Le diagnostic par couches d’un scraper bloqué explique pourquoi transport, HTTP et traitement du document exigent des traces séparées. Un outil de surveillance ne doit pas transformer silencieusement un challenge en jeu de résultats vide.
Le propriétaire doit déterminer si ce chemin d’accès est approuvé et si l’action configurée est attendue. Résoudre automatiquement un défi du navigateur, modifier son code ou changer sans cesse les propriétés du client sort de ce diagnostic. Cette frontière s’applique aussi à un travail conservant des cookies de compte : l’état client ne prouve pas que l’opération demandée reste autorisée.
Conservez la chaîne de réponses lors des redirections. Un HTTP 200 final peut correspondre à une page de connexion atteinte après un changement de route. Consignez l’URL finale, l’historique permis et le type de contenu, sans conserver les valeurs signées des paramètres. Comparer l’endpoint demandé à un autre document final peut faire passer une modification de routage pour une décision du détecteur. Ne suivez pas une destination inattendue hors du périmètre autorisé simplement pour compléter la trace.
Décisions DataDome derrière l’intégration
La référence de validation des requêtes DataDome décrit un module serveur qui consulte son API puis applique la décision reçue. Ses prérequis incluent l’accès aux en-têtes de requête et à l’adresse IP de l’utilisateur ; elle recommande aussi les informations d’empreinte TLS entrante lorsque cette collecte est prise en charge. Ce sont des entrées de l’intégration. La liste publique ne révèle ni leur poids pour une requête précise ni la collecte de toutes les entrées facultatives dans chaque déploiement.
La référence distingue la décision de l’API de la réponse finalement envoyée au client. L’intégration transmet une requête autorisée au backend ; pour un challenge, elle renvoie la réponse fournie par l’API selon le mappage documenté. Le navigateur visitant le site ne reçoit pas nécessairement cet échange interne. N’interprétez pas son HTTP 200 comme une lecture directe d’une autorisation interne DataDome : le contenu ou le résultat d’autorisation applicative peut être différent.
DataDome décrit également, pour cette intégration, un fonctionnement ouvert en cas d’absence de l’en-tête de décision. C’est une consigne pour l’implémentation du module, pas une permission accordée au client lorsqu’un en-tête visible manque. L’absence de métadonnées visibles peut découler de la frontière d’observation. Elle ne prouve ni ce fonctionnement ouvert, ni le bon fonctionnement du module, ni même sa présence.
La référence exige le traitement des mappages d’en-têtes vers l’origine et vers le client, et avertit de ne pas exposer les en-têtes indicateurs internes aux utilisateurs. Pour une enquête autorisée, demandez à l’opérateur la décision applicable et une corrélation expurgée. N’exigez pas sa configuration interne et ne collectez pas de jetons de session simplement pour classifier une réponse. Ainsi, les détails du serveur ne sont pas pris pour une API publique de détection côté client.
Si l’intégration renvoie un document inattendu, l’opérateur peut comparer le statut mappé, le type du corps et les en-têtes descendants à l’observation réelle du client. Examinez ce mappage avant d’accuser une API du navigateur.
Table de décision entre réponse et action
Appliquez cette table à un travail déjà autorisé. Les lignes décrivent des conditions documentées et des observations ambiguës, pas des mesures sur une cible protégée par ces fournisseurs. Utilisez la preuve disponible la plus précise ; si le marqueur ou la trace nécessaires manquent, conservez l’incertitude.
| Observation disponible | Classification étayée | Prochaine action autorisée | Déduction non étayée |
|---|---|---|---|
cf-mitigated: challenge | Marqueur documenté de page de challenge Cloudflare | Arrêter l’analyse de données et consulter le chemin d’accès prévu | Un score ou une propriété précise a causé le challenge |
HTTP 403 sans marqueur spécifique | Accès refusé à la frontière observée | Corréler avec les journaux autorisés du périmètre et de l’origine | DataDome ou Cloudflare a nécessairement décidé |
HTTP 200 avec HTML inattendu | Réponse inadaptée à l’étape JSON attendue | Vérifier type, marqueurs et résultat applicatif | Collecte réussie ou autorisation interne du fournisseur |
| Décision DataDome corrélée par l’opérateur | Décision du module enregistrée pour cette requête | Comparer action, réponse et chemin applicatif permis | Le client lit tous les champs internes de l’API |
| Aucune métadonnée de décision lisible | Preuves insuffisantes pour attribuer à un fournisseur | Conserver une trace expurgée et demander une corrélation | Aucune protection, ou fonctionnement ouvert en cas de défaut |
La table distingue volontairement statut HTTP et réussite applicative. Une page collectée peut être un document d’erreur ; une réponse valide peut ne contenir aucune donnée autorisée pour ce compte. L’analyse des sessions de scraping explique pourquoi des cookies conservés ne règlent pas ce point. Une classification indisponible est un résultat d’enquête, pas un verdict à forcer en réussite ou en échec.
Séparez les résultats d’extraction des incidents. Si l’endpoint renvoie text/html alors que le contrat applicatif exige JSON, conservez une erreur de travail classifiée plutôt que de publier une liste de prix vide ou d’effacer des données précédentes. Ce choix porte sur le traitement des données par le consommateur, pas sur une nouvelle capacité de détection. Reprenez le flux uniquement par la récupération approuvée de l’application, après résolution de la condition d’accès ou d’intégration.
Corréler la requête sans collecter de secrets
Sur un site exploité par votre organisation, conservez la route demandée, l’heure et sa base d’horloge, le statut HTTP, le type de contenu et un identifiant de corrélation permis. La référence des en-têtes Cloudflare décrit Cf-Ray comme identifiant de requête utile à la corrélation. Ce n’est ni un score ni un jeton de permission. Précisez où il a été observé et quel journal a été consulté ; sa présence seule ne prouve pas le traitement par l’origine.
Séparez les observations du client des constats de l’opérateur. Le client peut consigner cf-mitigated: challenge ; l’opérateur autorisé peut ajouter la règle ou la décision corrélée. Sans sa trace, la cause reste non confirmée. Répéter le même statut dans plusieurs exécutions du navigateur ne fournit pas la preuve interne manquante.
Indiquez l’outil d’observation. Un fetch entre origines peut ne pas exposer les mêmes champs qu’une instrumentation réseau autorisée. Si la page ne peut pas lire un en-tête, notez-le comme illisible à cette frontière, pas absent de la réponse réseau. Le propriétaire peut consulter ses journaux ou son instrumentation approuvée sans changer la politique entre origines pour satisfaire un script. La visibilité d’un outil limite la preuve ; ce n’est pas un verdict du fournisseur.
Expurgez cookies, en-têtes d’autorisation, URL de challenge signées et données de compte avant de conserver ou partager un échantillon. Ne gardez que le fragment permis nécessaire à la classification. Un corps peut contenir des secrets même avec un statut 403. L’incident a besoin du contexte d’un échec autorisé, pas d’une session réutilisable ou de l’empreinte complète d’un utilisateur tiers.
Précisez, si l’information est disponible, si la réponse vient d’une nouvelle transaction réseau ou d’un cache contrôlé par l’application. Une erreur HTML sauvegardée peut rester visible après une modification d’intégration. Corréler son ancien Cf-Ray à l’heure actuelle désigne la mauvaise requête. Gardez l’heure d’origine et la provenance ; une capture d’écran ne démontre pas une nouvelle requête.
Conservez les limites de charge du même objectif applicatif à travers requêtes et routes. Un refus n’ordonne ni d’augmenter la concurrence, ni de changer d’adresse, ni de rejouer des jetons. Après classification, la décision utile est le chemin approuvé par l’opérateur ou l’arrêt du travail. L’enquête a ainsi une fin concrète sans supposer une réparation côté navigateur pour chaque refus.
Contrôles du navigateur et frontière d’accès
La documentation des en-têtes personnalisés BotBrowser décrit la définition, la lecture, la modification et le retrait d’en-têtes configurés. Ces contrôles agissent sur la configuration du navigateur, pas sur une décision produite côté serveur. Copier un marqueur de réponse dans une requête ne reproduit pas le processus de confiance qui l’a généré. Explicitez la direction de chaque en-tête lors de la revue.
Sur une application de test appartenant à l’organisation, ces contrôles peuvent vérifier l’arrivée de l’en-tête prévu à sa destination autorisée. Le guide des en-têtes HTTP personnalisés traite cette frontière de configuration. Le résultat établit l’observation de cette application, pas l’acceptation Cloudflare ou DataDome, un changement de score ou des entrées privées de détection. Aucune expérience d’exécution contre ces fournisseurs n’est revendiquée.
Navigateur, intégration du service et application contribuent chacun à une partie distincte de la trace. Les groupes gérés qui prennent une décision comparable ailleurs se composent autrement, et AWS WAF Bot Control : ce qu'un agent voit réellement lit cette structure règle par règle. BotBrowser ne fournit ni capacité de proxy, ni permission, ni décision d’accès au nom du service protégé. Si le refus est la politique attendue, gardez-le comme condition d’arrêt. Si le propriétaire identifie un défaut d’intégration, réparez l’intégration autorisée plutôt que de traiter les valeurs du navigateur comme preuve d’identité.
Questions fréquentes
Un challenge Cloudflare révèle-t-il le score ?
Le marqueur documenté identifie une page de challenge. L’action configurée et un éventuel score nécessitent les traces pertinentes de l’opérateur ; la réponse au client ne fournit pas de conversion de score.
Un en-tête DataDome absent prouve-t-il un fonctionnement ouvert ?
Non. L’intégration serveur et la réponse au client ont des visibilités différentes. L’opérateur doit vérifier la décision réelle du module avant d’attribuer ce fonctionnement.
Une réponse HTTP réussie peut-elle faire échouer l’extraction ?
Oui. Examinez le document et le résultat applicatif, pas seulement le statut. Un HTML reçu à la place de JSON ne doit pas être enregistré comme collecte réussie sans données.
Un en-tête de requête personnalisé fixe-t-il la décision du fournisseur ?
Changer une configuration du navigateur ne crée pas une décision de confiance du fournisseur. Utilisez les en-têtes pour les besoins déclarés de votre application, pas comme prétendu mécanisme d’autorisation.
Sources
- Cloudflare : scores de bots
- Cloudflare : détecter une page de challenge
- Cloudflare : en-têtes de requête HTTP
- DataDome : valider une requête
- BotBrowser : en-têtes HTTP personnalisés
Conclusion pratique
Classifiez la réponse avant extraction : employez le marqueur documenté lorsqu’il est disponible, distinguez statut HTTP et réussite applicative, et laissez scores et causes internes inconnus jusqu’à une corrélation de l’opérateur autorisé. Gardez une trace minimale expurgée, arrêtez le travail refusé et utilisez le chemin d’accès approuvé. La configuration du navigateur est une entrée de ce processus, pas la permission de le poursuivre.
Cet article fait partie du guide : Vue d’ensemble de la configuration proxy : carte des décisions réseau
Articles Connexes
Scraper bloqué : erreurs DNS, TLS, HTTP et de page
RéseauCAPTCHA pendant le scraping : diagnostiquer le changement
EmpreintePreuves et journaux Cloudflare Bot Score
RéseauLimites de scraping : 429, Retry-After et concurrence
DéploiementSignaux d'automatisation et cohérence avec Playwright
DéploiementProtection des empreintes du navigateur pour la collecte web
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.