Règles de couche réseau qu’une page ne peut pas évaluer
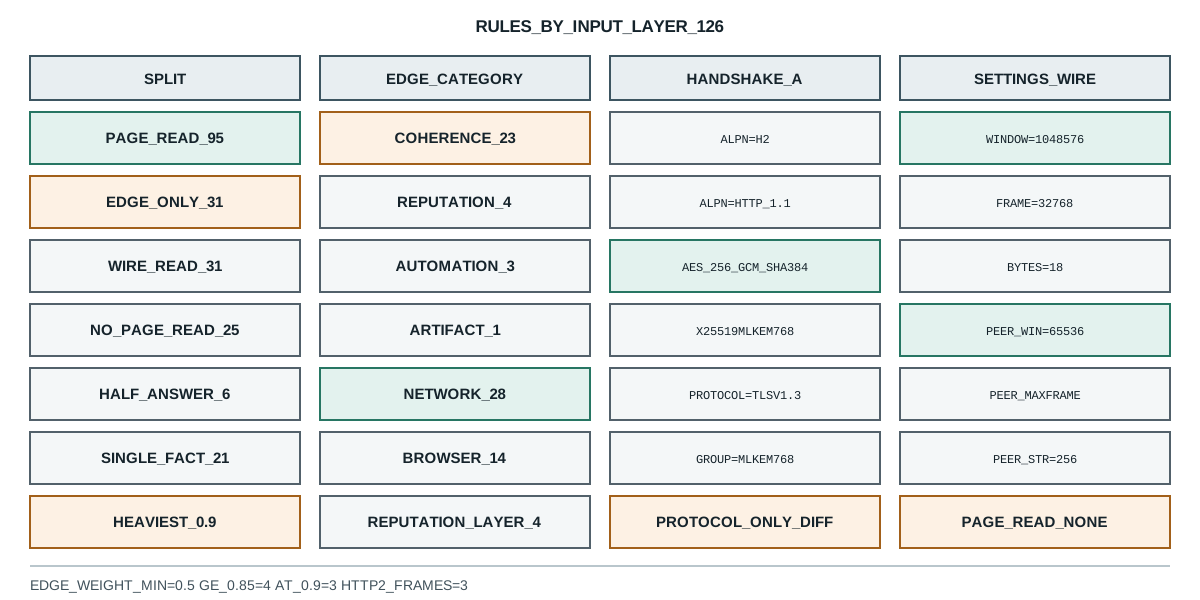
Un jeu de règles public répartit 126 règles : 95 qu’une page peut vérifier et 31 qui exigent le réseau. De vrais échanges montrent où vivent les plus lourdes.
BotBrowser Team
Vous voulez la documentation structurée pour Empreinte ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
BotBrowser garde un profil déclaré cohérent sur les surfaces qu’une page peut lire et peut conserver un enregistrement borné de ce que la page a rapporté, et il ne contrôle pas directement la poignée de main TLS, la trame de réglages HTTP/2 ni l’adresse qu’un proxy présente à l’extrémité distante d’une connexion. Cette analyse lit un jeu de règles public comme des données, sépare ses règles selon la couche dont chacune a besoin, puis mesure ces faits de connexion sur de vraies poignées de main, de sorte que la séparation repose sur des octets observés et non sur une supposition sur ce que voit un réseau.
Résumé
- Le jeu contient 126 règles. Une page peut en évaluer 95 ; les 31 autres exigent un fait qui n’atteint jamais la page.
- Les 31 règles réseau lisent au moins une valeur hors de la page, et 25 d’entre elles ne lisent rien d’autre.
- Ce sous-ensemble compte 23 règles de cohérence, 4 de réputation, 3 d’automatisation et 1 d’artefact, réparties sur la couche réseau 28 fois, la couche navigateur 14 fois et la couche réputation 4 fois.
- Seules 6 des 31 comparent une valeur de page à une valeur de réseau, et ce sont celles qu’une page peut à moitié traiter : elle fournit un côté et n’a rien pour l’autre.
- Toute règle réseau pèse au moins 0.5. Quatre sont à 0.85 ou plus, 8 entre 0.7 et 0.84, et 19 entre 0.5 et 0.69.
- Les trois plus lourdes partagent le poids 0.9 et décrivent toutes trois un comportement de trames HTTP/2, que nul script de page ne peut lire.
- Deux poignées de main qui ne diffèrent que par la liste des protocoles donnent
alpn=h2etalpn=http/1.1sur la même version TLS 1.3, le même chiffrement et le même groupe d’échange de clés. - Une trame de réglages portant une fenêtre initiale de 1048576 et une trame maximale de 32768 arrive comme un enregistrement de 18 octets que le pair lit directement ; la page qui l’a envoyée ne peut lire aucun des deux nombres.
- Le côté serveur d’une vraie connexion a rapporté une fenêtre initiale de 65536, une trame maximale de 16777215 et 256 flux simultanés, tous visibles pour la pile réseau du client et pour aucun script de la page.
- Un rapport côté page peut décrire l’environnement qu’il expose, et il ne peut pas invalider une règle dont il ne voit jamais les entrées.
Sommaire
- Où le jeu de règles se sépare
- Quelles six règles sont à moitié traitées
- Ce qu’une vraie poignée de main met sur le fil
- Pourquoi les règles les plus lourdes restent de l’autre côté
- En quoi lire un constat réseau diffère
- Enregistrer une lecture
Où le jeu de règles se sépare
Un jeu de règles est une liste d’affirmations, et chaque affirmation nomme les valeurs qu’elle lit. La séparation qui compte ici n’est ni la catégorie ni le poids, mais l’endroit où ces valeurs vivent. La sonde lit le jeu publié comme des données et classe chaque règle selon qu’un script dans la page pourrait lire les mêmes entrées :
node=v26.9.0
ruleset=0.74.49 rules=126 digest=cf896731d6c894fb38266206bc121db1f235f536ffbf334aa2c0da7468cc0e59
split -> page_evaluable=95 edge_only=31
edge_categories -> coherence=23 reputation=4 automation=3 artifact=1
edge_layers -> network=28 browser=14 reputation=4
edge_rules_with_a_wire_only_read -> 31 of 31
every_edge_rule_needs_the_wire -> true
edge_rules_with_no_page_read_at_all -> 25
La première ligne de la séparation décide de la part d’un détecteur qu’une page peut raisonner. Quatre-vingt-quinze règles lisent des valeurs présentes dans le document : la chaîne d’agent utilisateur, la liste des langues, la géométrie de l’écran, le fuseau horaire, la forme d’une fonction native. Une page qui veut savoir ce que diront ces règles peut lire les mêmes valeurs et calculer la même réponse.
Les 31 autres lisent autre chose. Les comptes par couche dépassent 31 parce qu’une règle peut couvrir plusieurs couches, et les comptes par catégorie montrent où elles se groupent : cohérence à 23 est de loin la plus nombreuse, ce qui convient au nom, puisqu’une règle de cohérence existe pour comparer deux sources censées s’accorder. Réputation à 4 demande si l’adresse ou le réseau appartient à une plage d’hébergement ou à une sortie de proxy connue. Automatisation à 3 et artefact à 1 complètent l’ensemble.
La ligne qui porte l’argument est every_edge_rule_needs_the_wire -> true. Chacune des 31 nomme au moins une entrée qui n’est pas une valeur de page, donc aucune ne peut être tranchée depuis l’intérieur du document. La ligne suivante resserre encore : 25 des 31 ne lisent que des valeurs de réseau. Pour celles-là, une page n’est pas un témoin partiel ; elle n’est pas témoin du tout. Il n’existe aucune requête côté page qui rende le même nombre, aucune propriété dont l’absence remplace la valeur manquante, aucun calcul qui la retrouve.
Cette distinction sépare deux types de rapport qui se ressemblent en surface. Un balayage côté page produit une liste de constats sur des surfaces qu’il pouvait atteindre, et une vérification côté réseau produit des constats sur une connexion. Quand les deux sont fusionnés en une seule note, la fusion cache quelle moitié a produit quel constat, et le lecteur ne peut pas savoir si un résultat propre signifie que la page était cohérente ou que la connexion n’a jamais été examinée. La cohérence entre couche réseau et navigateur nomme les couches qu’expose une session, et l’empreinte des informations réseau montre celles auxquelles une page accède seule. Un catalogue public de suites montre le même écart de l’extérieur : ce que les suites de détection publiques testent vraiment compte combien de leurs tests publiés nomment la connexion.
Quelles six règles sont à moitié traitées
Six des 31 associent une valeur de page à une valeur de réseau. Ce sont les cas intéressants, car une page fournit la moitié de la comparaison et n’a rien pour l’autre moitié :
| Poids | Côté page | Côté réseau |
|---|---|---|
| 0.85 | browser.webrtc_public_ip | network.observed_ip |
| 0.7 | browser.ua_browser | network.ja4_browser_hint |
| 0.6 | browser.ua_browser | network.h2_browser_hint |
| 0.6 | browser.ua_platform | network.ch_platform_header |
| 0.6 | browser.ua_browser | network.ch_ua_browser |
| 0.55 | browser.nav_language_primary | network.accept_language_primary |
La sonde imprime directement la forme de la plus lourde :
cross_layer -> weight=0.85 net.webrtc_ip_vs_observed page=browser.webrtc_public_ip wire=network.observed_ip
page_side_view -> net.webrtc_ip_vs_observed page_reads=1 wire_reads=1
page_side_view -> predicate=not_equal needs_both_sides=true
page_side_view -> a page can supply browser.webrtc_public_ip and nothing for network.observed_ip
Le prédicat est not_equal, et c’est ce qui rend le couple difficile à trancher depuis l’intérieur de la page. Une page peut lire l’adresse que rapporte sa propre collecte ICE, et une implémentation WebRTC qui renvoie une adresse publique renvoie une valeur que la page peut comparer à ce qu’elle sait. Ce que la page ne peut pas lire, c’est l’adresse que l’extrémité réceptrice a observée pour la même connexion, car cette valeur n’existe qu’au bout distant. Une page qui compare son adresse WebRTC à sa propre idée de son adresse compare une valeur locale à une autre valeur locale, et cette comparaison n’est pas la règle.
La même structure tient pour les cinq autres. Une page lit son propre agent utilisateur, et elle ne peut pas lire la famille de navigateur qu’a impliquée une poignée de main TLS. Une page lit navigator.language, et elle ne peut pas lire la langue principale de l’en-tête Accept-Language envoyé par la pile réseau. Une page lit la chaîne de plateforme, et elle ne peut pas lire l’en-tête de plateforme des client hints. Dans chaque cas la valeur de page est réelle et la valeur de réseau est réelle, et une seule des deux est atteignable depuis un script.
Une deuxième conséquence est facile à manquer. Parce que la règle exige les deux côtés, une page ne peut même pas savoir si la règle se déclencherait. Elle calcule sa moitié et s’arrête. Un déploiement qui modifie une surface de page pour correspondre à un profil cible a modifié une entrée d’une comparaison à deux entrées, et savoir si la comparaison s’accorde désormais dépend d’un fait que le déploiement ne peut pas interroger depuis la page.
Ce qu’une vraie poignée de main met sur le fil
Affirmer que ces valeurs existent hors de la page est facile, et cela vaut la peine d’être mesuré. La sonde ouvre deux connexions TLS vers le même hôte qui ne diffèrent que par la liste des protocoles offerts par le client, et relit ce que la connexion a négocié :
handshake:dual_alpn -> alpn=h2 protocol=TLSv1.3 cipher=TLS_AES_256_GCM_SHA384 group=X25519MLKEM768
handshake:http11_only -> alpn=http/1.1 protocol=TLSv1.3 cipher=TLS_AES_256_GCM_SHA384 group=X25519MLKEM768
wire_only_distinction -> alpn_differs=true
Les deux connexions aboutissent à TLS 1.3, les deux s’accordent sur TLS_AES_256_GCM_SHA384 et les deux utilisent le groupe d’échange X25519MLKEM768. La seule différence est le protocole négocié, h2 contre http/1.1, et cette différence vient d’un paramètre côté client que le pair a lu pendant la poignée de main. Rien dans le document ne peut l’observer. Une page chargée par l’une ou l’autre connexion voit les mêmes API, les mêmes en-têtes sur ses propres requêtes une fois envoyées et le même environnement ; le protocole qui a porté la requête est une propriété de la connexion, pas du document.
Il en va de même pour la trame de réglages HTTP/2. La sonde construit deux trames de réglages et les relit depuis des octets bruts sur un récepteur local, donc les nombres viennent de la trame et non d’un objet client :
settings_frame:wide -> enable_push=0 initial_window=1048576 max_frame=32768 bytes=18
settings_frame:narrow -> enable_push=1 initial_window=65535 max_frame=16384 bytes=18
settings_frame_differs -> initial_window_differs=true max_frame_differs=true
Les deux trames font 18 octets. Elles portent une fenêtre initiale de 1048576 contre 65535, une trame maximale de 32768 contre 16384, et des réglages de poussée opposés. Un pair qui veut savoir comment un client se comporte lit ces entrées de six octets à leur arrivée, avant qu’un document existe. Une page ne peut pas lire la trame qu’elle a envoyée, car la trame est écrite par la pile réseau sous le document et n’est pas exposée vers le haut.
Le côté serveur d’une vraie connexion est aussi lisible par la pile réseau du client :
peer_settings:botbrowser.io -> initial_window=65536 max_frame=16777215 max_streams=256 header_table=4096
Une fenêtre initiale de 65536, une trame maximale de 16777215, 256 flux simultanés et une table d’en-têtes de 4096 sont des valeurs que le client a reçues du serveur. Une page peut envoyer des requêtes et observer des réponses, et elle ne peut lire aucun de ces quatre nombres, car ils décrivent le transport par lequel passent les requêtes.
Ensemble, les mesures établissent la forme de l’écart et non une détection précise. La connexion porte une liste de protocoles, une suite de chiffrement, un groupe d’échange de clés, une trame de réglages et une adresse observée. Le document porte un agent utilisateur, une langue, une plateforme et un ensemble de surfaces rendues. Les deux ensembles se recouvrent exactement aux six endroits du tableau précédent, et à chacun la comparaison exige une valeur de chaque côté.
Pourquoi les règles les plus lourdes restent de l’autre côté
Si les règles réseau étaient une fine queue de vérifications faibles, un balayage côté page couvrirait suffisamment le sujet. Les poids disent le contraire :
edge_weight_bands -> ge_0.85=4 0.7_to_0.84=8 0.5_to_0.69=19 lt_0.5=0
heaviest -> weight=0.9 net.h2_rapid_reset layers=network
heaviest -> weight=0.9 net.h2_continuation_flood layers=network
heaviest -> weight=0.9 net.h2_control_flood layers=network
heaviest -> weight=0.85 net.webrtc_ip_vs_observed layers=network+browser
heaviest -> weight=0.8 net.ja4_unstable_within_session layers=network
single_wire_fact_rules -> 21
Aucune règle réseau ne pèse moins de 0.5. La distribution se concentre au milieu et en haut : 19 règles entre 0.5 et 0.69, 8 entre 0.7 et 0.84, et 4 à 0.85 ou plus. Les trois plus lourdes partagent le poids 0.9 et décrivent toutes trois un comportement de trames sur une connexion HTTP/2. La première est net.h2_rapid_reset, une réinitialisation de flux qui arrive plus vite qu’un client n’aurait pu traiter une réponse. La deuxième compte les trames de continuation sur un seul flux. La troisième compte les trames de contrôle sur toute la session. Chacune est une propriété de temps ou de volume du transport, et chacune se mesure en comptant des trames à l’extrémité réceptrice.
Les deux règles lourdes restantes décrivent la stabilité plutôt qu’une valeur unique. net.ja4_unstable_within_session à 0.8 demande si les paramètres de poignée de main du client ont changé dans une session, et net.webrtc_ip_vs_observed à 0.85 demande si deux adresses du même client ne concordent pas. Les deux exigent plus d’une observation dans le temps ou entre couches, ce qui est une seconde raison pour laquelle une page ne peut pas y répondre : même si un script pouvait lire un paramètre de poignée de main, il n’a pas accès au précédent.
Vingt et une des 31 sont plus simples. Ce sont des vérifications de présence sur un fait réseau unique, comme l’absence d’un en-tête que le client a envoyé, l’omission d’une méthode de compression dans l’encodage accepté, ou la présence d’un paramètre qu’un client actuel inclut normalement dans la poignée de main. Un seul fait tranche la règle, et le fait vit entièrement hors du document. Cette combinaison, une entrée et un poids d’au moins 0.5, fait du sous-ensemble réseau une partie réelle du détecteur et non une note de bas de page.
La lecture pratique porte sur la couverture, pas sur les notes. Une revue côté page peut décrire 95 des 126 règles et aucune des 31 qui lisent la connexion. Quand un rapport énumère des constats sans dire quelle couche les a produits, les 31 absentes sont invisibles : le rapport ne se trompe pas sur ce qu’il a vu, et il reste muet sur la couche où quatre règles pèsent 0.85 ou plus.
En quoi lire un constat réseau diffère
Un constat côté page et un constat réseau soutiennent des affirmations différentes, et la différence décide de ce qu’un enregistrement doit contenir. Un constat côté page est reproductible avec le document seul, car quiconque charge la même page dans le même environnement lit les mêmes valeurs et arrive à la même conclusion ; un désaccord entre deux exécutions pointe alors vers un changement d’environnement. Un constat réseau n’est reproductible qu’avec la connexion, car le même document chargé avec une autre liste de protocoles, un autre chiffrement ou une autre route produit une entrée différente, et deux exécutions qui divergent peuvent différer par le transport et non par le navigateur.
Cela allonge la liste des champs d’un constat réseau. Il doit nommer la connexion dont vient l’observation, pas seulement la page, ce qui pour les exécutions ci-dessus veut dire l’alpn=h2 ou l’alpn=http/1.1 négocié et non une URL. Il doit indiquer quel côté de chaque comparaison a été mesuré, car une règle comme net.webrtc_ip_vs_observed de poids 0.85 n’est pas tranchée en lisant seulement browser.webrtc_public_ip. Et il doit conserver l’identité de la règle plutôt qu’un compte, car 31 règles réparties en 23 de cohérence, 4 de réputation, 3 d’automatisation et 1 d’artefact ne se réduisent pas à un nombre qui signifie quelque chose seul.
Il y a une limite à dire clairement. Un profil qui garde chaque surface de page cohérente avec une cible déclarée ne modifie pas pour autant la poignée de main, la trame de réglages ni l’adresse observée au bout distant ; ce sont des faits distincts produits par des parties distinctes du client. Lire un rapport côté page comme preuve sur la connexion surestime ce qui a été mesuré, et lire un rapport réseau comme preuve sur le document commet l’erreur inverse. Les deux rapports décrivent deux couches, et une affirmation sur le navigateur dans son ensemble exige les deux.
Enregistrer une lecture
Une lecture réseau soutient une affirmation étroite : cette version du jeu de règles, cette connexion, ont produit ces entrées. Quatre champs la gardent vérifiable :
- La version et l’empreinte du jeu de règles, car une règle qui gagne ou perd une entrée change ce que signifie la séparation sans aucun changement du client.
- La couche dont chaque règle a besoin, car 25 des 31 ne lisent rien de la page et un rapport qui omet la couche laisse entendre que la page les a couvertes.
- Les valeurs réseau mesurées pour la connexion réellement utilisée, car une liste de protocoles, un chiffrement et une trame de réglages appartiennent à cette connexion et non au navigateur en général.
- Les six comparaisons qui exigent les deux côtés, marquées comme mesurées à moitié quand seule la valeur de page a été lue.
Sources publiques
- RFC 8446 : The Transport Layer Security (TLS) Protocol Version 1.3
- RFC 9113 : HTTP/2
- RFC 7301 : TLS Application-Layer Protocol Negotiation Extension
- MDN : Navigator.userAgentData
- MDN : Accept-Language
- BotBrowser : référence de cohérence d’automatisation
Conclusion pratique
Séparez dans le rapport ce qui a été mesuré dans le document de ce qui a été mesuré sur la connexion, car seule la seconde partie atteint les règles dont le poids monte à 0.9. Quand la seule preuve est une valeur de page, écrivez half-measured à côté de la règle au lieu d’un résultat. Et conservez la connexion avec le constat, car un alpn négocié et une trame de réglages décrivent ce lien précis et non le navigateur dans son ensemble. Pour la note qui décide si une règle déclenchée peut condamner, lisez pourquoi un signal isolé ne condamne jamais un navigateur ; pour la façon dont une bibliothèque regroupe ses propres constats avant tout verdict, lisez les groupes de signaux de CreepJS et leur combinaison.
Cet article fait partie du guide : Qu'est-ce qu'une empreinte de navigateur ?
Articles Connexes
Pourquoi un seul signal bizarre ne condamne pas
EmpreinteCe que les suites de détection publiques testent vraiment
EmpreinteFingerprinting de la Network Information API : revue de politique
RéseauDNS sur TLS : confidentialité, déploiement et pannes
RéseauCohérence réseau du navigateur pour protéger la vie privée
EmpreinteFingerprinting Navigator : fuites du navigateur
Faites passer BotBrowser de la recherche à la production
Utilisez ces guides pour comprendre le modèle, puis passez à la validation multi-plateforme, aux contextes isolés et au déploiement navigateur prêt pour l'échelle.