FunCaptcha : signaux, sessions et vie privée
Que mesure FunCaptcha ? Distinguez signaux client, session de défi, exposition des URL et vérification serveur à partir de sources primaires.
BotBrowser Team
Vous voulez la documentation structurée pour Empreinte ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
FunCaptcha est souvent associé au puzzle visible, mais la documentation d'Arkose décrit une session plus large : collecte et classification côté client, défi facultatif, puis vérification côté serveur. La réponse au puzzle n'est qu'une partie du processus. BotBrowser propose des contrôles natifs documentés des surfaces d'empreinte exposées par le navigateur ; ils ne déterminent ni l'évaluation d'Arkose, ni l'autorisation du site, ni les données conservées par ses sous-traitants.
TL;DR
- Arkose documente une détection sans défi visuel et une détection accompagnée d'un défi. L'absence de puzzle ne prouve pas l'absence de traitement de la session.
- Le rappel de fin côté client concerne les sessions avec défi comme celles où il est supprimé. Son jeton doit encore être vérifié par le serveur ; terminer ne donne pas l'autorisation d'effectuer l'action protégée.
- Arkose avertit explicitement que son client lit et stocke l'URL du site, paramètres de requête compris. Des informations sensibles dans l'adresse créent une exposition que la difficulté du puzzle n'explique pas.
- La politique actuelle distingue les données des services de production de celles utilisées à des fins commerciales et promotionnelles. Chaque catégorie et ses conditions doivent rester dans leur colonne.
- Aucun événement V8 de FunCaptcha attribuable à une source n'était disponible dans les recherches locales examinées. Les déclarations publiques étayent l'architecture et les catégories de confidentialité suivantes, pas un inventaire mesuré des API actuelles ni une méthode pour obtenir un verdict favorable.
Sommaire
- Le défi est une branche de la session
- Fin, vérification et autorisation sont distinctes
- L'URL constitue une exposition concrète
- Séparer les déclarations de production et commerciales
- Ce qu'une observation du navigateur établit
- Pourquoi deux interactions peuvent différer
- Contrôles du navigateur et décisions du fournisseur ont des responsables différents
- Évaluer une intégration propre sans collecter davantage de secrets
- Conclusion pratique
Le défi est une branche de la session
Les instructions client d'Arkose décrivent deux composants. Le composant de détection collecte des informations et classe le trafic sans intervention visuelle. Le composant de contrôle comprend la détection et peut présenter un Enforcement Challenge, appelé EC dans la documentation. Cette terminologie sépare la session du service de sa tâche visible : la collecte et la classification ne commencent ni ne s'arrêtent à l'apparition d'une image. Le modèle de jetons AWS WAF sépare les horodatages Challenge et CAPTCHA ; ces règles AWS ne doivent pas être attribuées à une session Arkose.
Ces mêmes instructions attribuent à l'intégration client la collecte nécessaire à la classification, la présentation éventuelle d'un EC et la remise d'un jeton à usage unique. L'intégration serveur vérifie ensuite ce jeton. Il s'agit de responsabilités documentées, pas d'observations concernant un visiteur donné. Elles expliquent pourquoi une description limitée aux images omet des questions importantes : quelles informations de la page sont accessibles avant l'interaction et quelle organisation traite la session qui en résulte ?
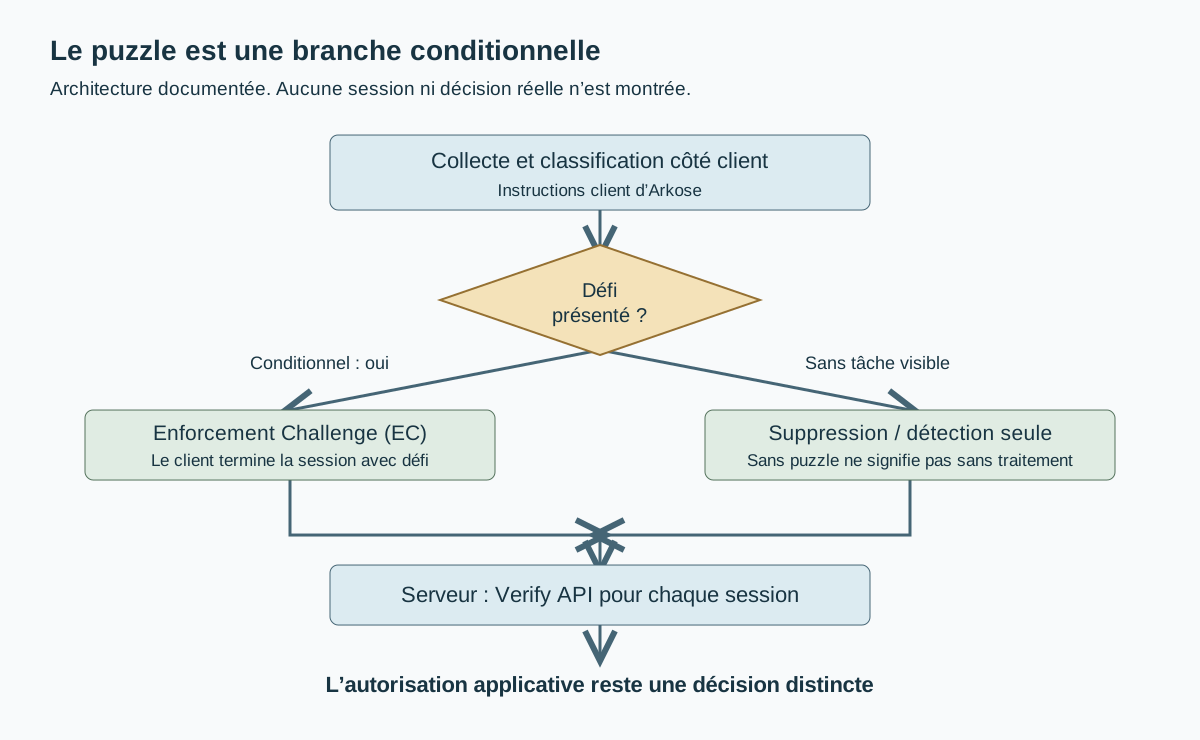
La présentation de Verify API donne trois scénarios. Dans le premier, aucun défi n'est présenté car le service classe la session comme légitime ou à faible risque. Le deuxième présente un défi. Le troisième utilise le mode détection seule. La vérification serveur est requise dans les trois cas. Une personne qui ne voit pas de puzzle décrit donc une interface, sans établir le traitement ou la configuration du client qui l'a produite.
Cette différence compte pour l'évaluation de la vie privée. Un site peut devoir expliquer un traitement de sécurité même lorsque la personne ne clique jamais sur un contrôle de défi. Inversement, une tâche visible ne prouve pas la collecte de toutes les propriétés du navigateur habituellement évoquées dans les études d'empreinte. Les branches documentées montrent que l'interface fournit une preuve incomplète. Elles ne constituent pas une liste exhaustive des informations utilisées dans chaque branche.
Le nom FunCaptcha peut aussi confondre une expérience de défi familière avec l'intégration plus large du produit Arkose décrite par les sources actuelles. Un rapport doit nommer le composant et la configuration pour lesquels il dispose de preuves. Une capture du défi et une référence d'intégration appuient des faits différents : la capture peut documenter la présentation visible ; la référence décrit les rôles prévus. Aucune ne révèle à elle seule le modèle privé, l'ensemble de ses entrées ou le statut d'une personne.
La comparaison des familles de défis distingue les types de tâches et les observations qu'ils exposent. La question propre à Arkose ajoute une limite de session : quelles étapes se déroulent dans le client, lesquelles deviennent visibles et lesquelles nécessitent un enregistrement serveur ? Cette distinction est plus utile pour la vie privée que de prendre la difficulté, le nombre ou l'apparence des puzzles pour une mesure directe des données personnelles collectées.
Fin, vérification et autorisation sont distinctes
La référence Client API indique que onCompleted intervient à la fin d'une session avec défi ou d'une session où celui-ci est supprimé. Ce rappel contient un jeton qui doit être envoyé au serveur du client pour vérification. Ce contrat public évite deux erreurs : croire que le rappel prouve la résolution d'un puzzle visible, et croire qu'un événement client autorise à lui seul une opération de l'application.
La Verify API est appelée depuis le serveur pour chaque session. Sa réponse indique si la vérification a réussi, selon des formats simples ou plus complets décrits par le fournisseur. L'application est responsable du traitement de cette réponse. Un observateur du navigateur peut voir l'événement client sans voir l'échange entre serveurs ; son enregistrement peut donc s'arrêter avant la preuve nécessaire pour expliquer le comportement ultérieur de l'application.
Une inscription illustre cette différence sans essai en conditions réelles. Le composant client peut terminer, le serveur obtenir une réponse de vérification, puis l'application appliquer ses exigences propres concernant le compte ou l'opération demandée. Ces exigences relèvent du site. La présentation de la vérification ne fait pas d'Arkose l'autorité sur chaque règle métier. Un échec d'inscription ne peut donc pas être attribué à un score de défi sur le seul résultat visible.
| Enregistrement disponible | Ce qu'il établit | Question qui reste distincte |
|---|---|---|
| Capture d'écran du défi | Cette présentation était visible à l'instant enregistré | Quelle collecte l'a précédée et comment le serveur a évalué la session |
| Rappel documenté de fin côté client | Le client a atteint cette étape, y compris pour une session sans défi présenté | Si le serveur a vérifié et autorisé l'opération |
| Résultat de vérification serveur corrélé | La réponse de vérification pour cette opération enregistrée | Les règles appliquées ensuite par l'application |
| Entrée d'audit de l'application | La décision enregistrée du site à propos d'une action | Toutes les entrées privées utilisées par le fournisseur |
Ce tableau découle des responsabilités du client et de la vérification. Ce n'est pas une trace de session capturée. La distinction évite de demander trop de données lors d'une enquête de support. Si la question porte sur la décision serveur du site, demander une empreinte plus détaillée au visiteur n'apporte pas l'enregistrement serveur manquant.
Les erreurs nécessitent la même séparation. Un problème de chargement du client, un problème de transport vers le service de vérification et un refus de l'application sont des événements différents. La présentation de Verify traite séparément les erreurs serveur et les requêtes incorrectes, avec des arbitrages relevant du client. C'est une question d'intégration, pas une preuve de l'identité du visiteur ni du rôle causal d'une propriété de navigateur.
Pour une intégration propre, les étapes peuvent être corrélées au moyen du dispositif d'audit interne approuvé, en excluant les identifiants secrets et les artefacts actifs du défi des échanges de support. Il faut identifier l'étape concernée, pas exposer du matériel de session réutilisable. Un enregistrement expurgé indiquant si une vérification a été tentée et son résultat documenté peut répondre à une question opérationnelle sans révéler le jeton, l'adresse complète ou des détails sans rapport sur le compte.
L'URL constitue une exposition concrète
Les instructions client contiennent un avertissement direct : lorsque le code se charge, Arkose lit et stocke l'URL du site, paramètres de requête compris. Cette déclaration est plus précise qu'une référence générale aux signaux de l'appareil. Les adresses contiennent parfois des informations ajoutées par des fonctions applicatives, des campagnes ou des parcours de compte. L'interface du défi ne montre pas au visiteur lesquelles sont accessibles à l'intégration.
Prenons un service de rendez-vous explicitement fictif. Un paramètre de son adresse décrit la catégorie du rendez-vous. Cet exemple n'utilise aucune adresse réelle, donnée personnelle ou capture de navigateur. Si cette information figure dans l'URL d'une page où le client s'exécute, l'avertissement sur les URL signale une question pertinente. Pour savoir si une intégration réelle contient de telles informations, il faut examiner la conception des adresses de l'application concernée.
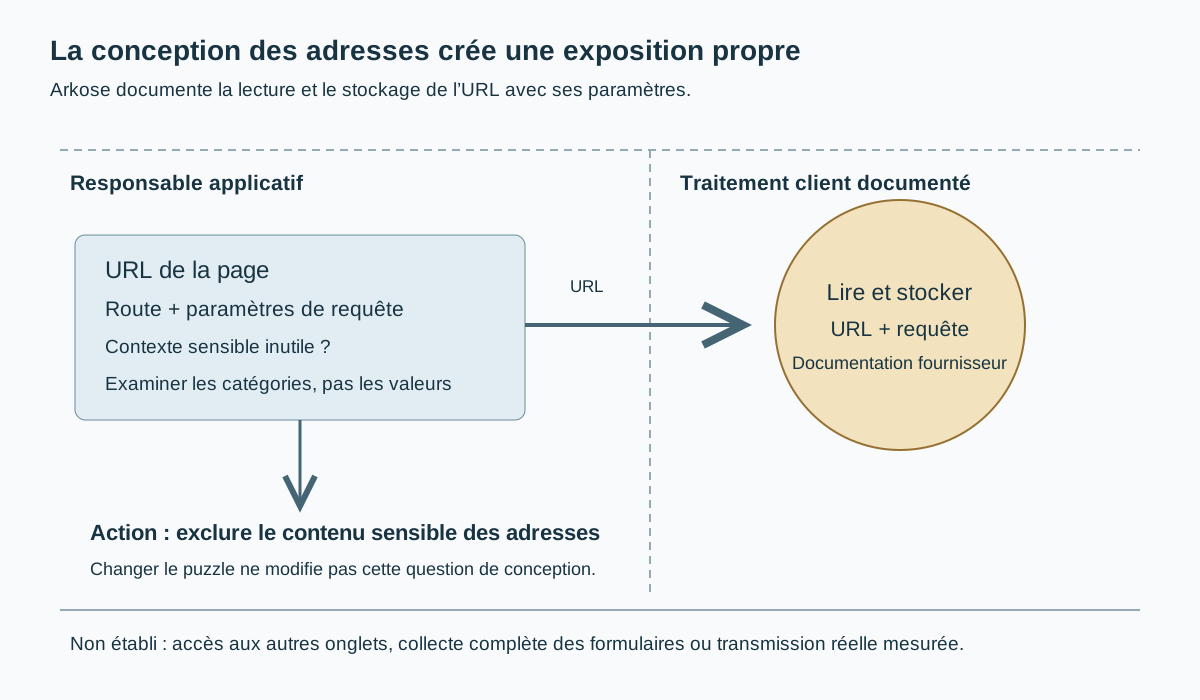
La source recommande d'exclure les informations sensibles des paramètres GET et d'utiliser une méthode d'envoi appropriée pour ce contenu. Cela ne signifie pas qu'un transfert vers le corps d'une requête rende une valeur inaccessible à tous les destinataires. Le choix de méthode concerne un emplacement de l'information. L'application doit encore déterminer quels composants reçoivent l'envoi, ce que la page affiche et quelles finalités de traitement s'appliquent.
La première amélioration consiste à ne pas placer de contexte personnel inutile dans l'adresse. Un développeur peut examiner les routes et les catégories de paramètres sur les pages qui chargent l'intégration sans collecter les valeurs de vrais visiteurs. L'avertissement documenté suffit à justifier cette revue de conception. Une analyse plus large des empreintes comportementales n'est pas nécessaire pour examiner une exposition d'URL déjà déclarée.
Le périmètre reste essentiel. L'avertissement établit le traitement déclaré d'une URL de page. Il ne prouve pas la collecte de chaque champ de formulaire, entrée d'historique ou onglet sans rapport. Le mot URL ne permet pas de généraliser d'une adresse à toute la navigation. Une évaluation doit identifier la page concernée et classer ses paramètres, tout en excluant les valeurs de compte actives et les adresses qui accordent elles-mêmes un accès.
L'infrastructure pose également des questions séparées. Le site, ses propres outils d'analyse et d'autres acteurs réseau peuvent avoir leurs pratiques de traitement des adresses. La documentation d'Arkose n'étaye que la déclaration concernant son client. Retirer le contenu sensible inutile d'une URL peut bénéficier à plusieurs chemins, mais chaque destinataire doit être établi indépendamment plutôt que d'attribuer toute adresse enregistrée à un composant unique.
La règle de décision est concrète : si une catégorie dans l'adresse ne doit pas être communiquée au service intégré, il faut modifier son emplacement dans l'application avant de débattre du puzzle. Le responsable des routes et formulaires contrôle ce changement. Un réglage graphique du navigateur ne remplace pas une conception plus sûre des adresses, et modifier le style du défi visible ne corrigerait pas le traitement d'URL déclaré.
Séparer les déclarations de production et commerciales
La politique de confidentialité d'Arkose examinée est entrée en vigueur le 27 octobre 2026. Son tableau distingue les données pouvant être collectées pour le compte de clients dans les services de production de celles destinées à des fins commerciales et promotionnelles. Les intitulés des colonnes ont une portée réelle. Lire chaque exemple comme un signal de défi de production déformerait la déclaration.
La colonne de production Device/IP Data comprend l'adresse IP et la localisation déduite de l'IP, le type d'appareil ou de navigateur, ainsi que d'autres informations d'analyse et d'identification de l'appareil. Les exemples citent version, résolution et rapports d'aspect, langue et exigences de stockage de session. Ce sont des catégories de politique publique, pas des appels JavaScript actuels attribués à une source. Elles n'établissent ni l'interface ayant obtenu chaque valeur ni l'application de chaque exemple à toute interaction.
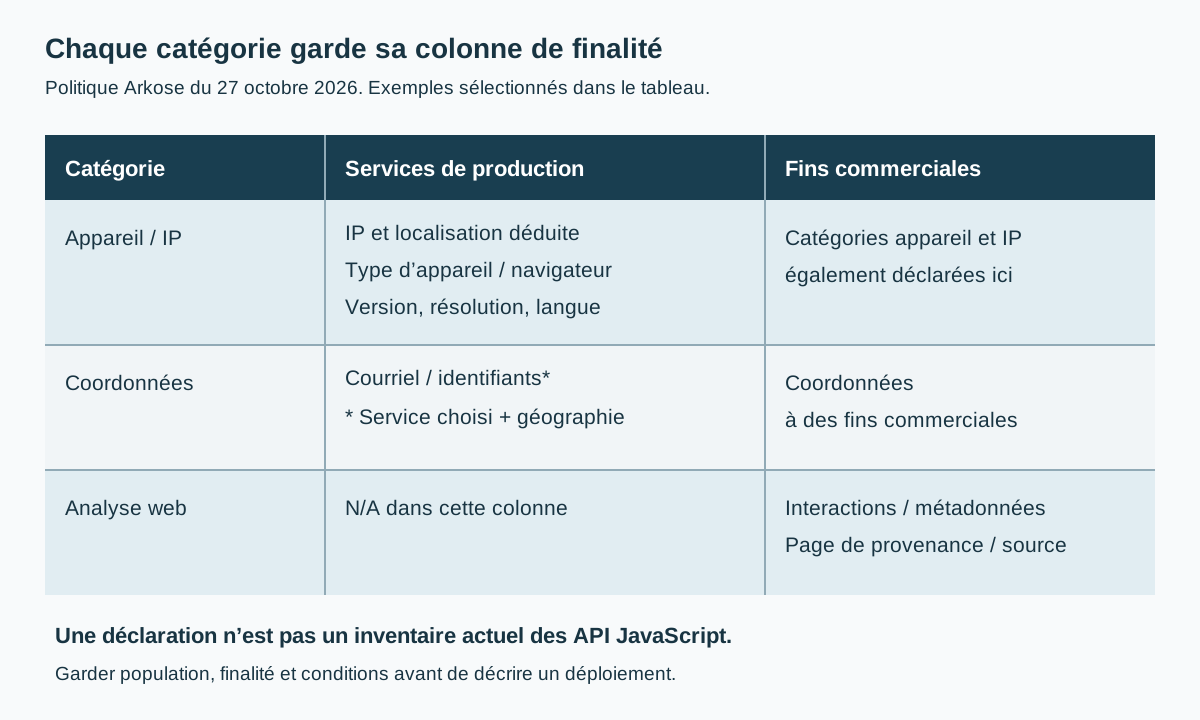
Les coordonnées en production sont assorties de conditions explicites. Courriel, identifiant et nom d'utilisateur portent une note : ils ne s'appliquent que si le client choisit l'offre concernée, sous réserve de restrictions géographiques. La politique ne permet donc pas d'affirmer que chaque défi reçoit un courriel. Elle ne permet pas non plus l'affirmation universelle contraire. L'intégrateur doit établir l'offre et les données fournies avant de décrire son déploiement.
La colonne commerciale recense d'autres catégories : interactions et métadonnées de pages, sources de provenance, informations professionnelles et inférences sur les visiteurs. Certaines cellules correspondantes de production indiquent N/A. Attribuer tous ces exemples à chaque utilisateur final effacerait la distinction entre un service de sécurité et la promotion de l'activité du fournisseur. Population, finalité et conditions doivent rester associées.
La section sur les services de production présente Arkose comme prestataire de services ou sous-traitant pour les traitements clients concernés et invite les personnes à contacter l'entité ayant recueilli initialement les données. Elle indique agir pour le compte des clients d'entreprise et selon leurs exigences. C'est une attribution déclarée des responsabilités, pas une conclusion juridique indépendante sur un déploiement. L'information du site et l'accord applicable restent nécessaires.
Les déclarations de partage et conservation ont également leur périmètre défini. La politique traite les Third Party Provided PII, notamment les informations identifiantes obtenues sur des sites ou applications qu'Arkose ne possède pas. Elle énonce des limites d'utilisation et de communication pour les services antifraude et déclare ne jamais partager cette catégorie définie d'un site client avec d'autres clients. Sa conservation est déterminée par le client concerné. Ce sont des déclarations attribuées, pas des garanties observées dans le navigateur ni un délai universel.
La conséquence pratique est de demander au responsable du site quelles catégories et dispositions de production s'appliquent, au lieu de copier la liste commerciale dans l'information des visiteurs. Les données d'appareil soulèvent des questions même sans nom : utilisation, association à une opération, destinataires et conservation restent pertinents. Mais l'existence d'une catégorie ne prouve pas une identification persistante, un rapprochement publicitaire ou un usage abusif. Ces conclusions nécessitent d'autres preuves.
Ce qu'une observation du navigateur établit
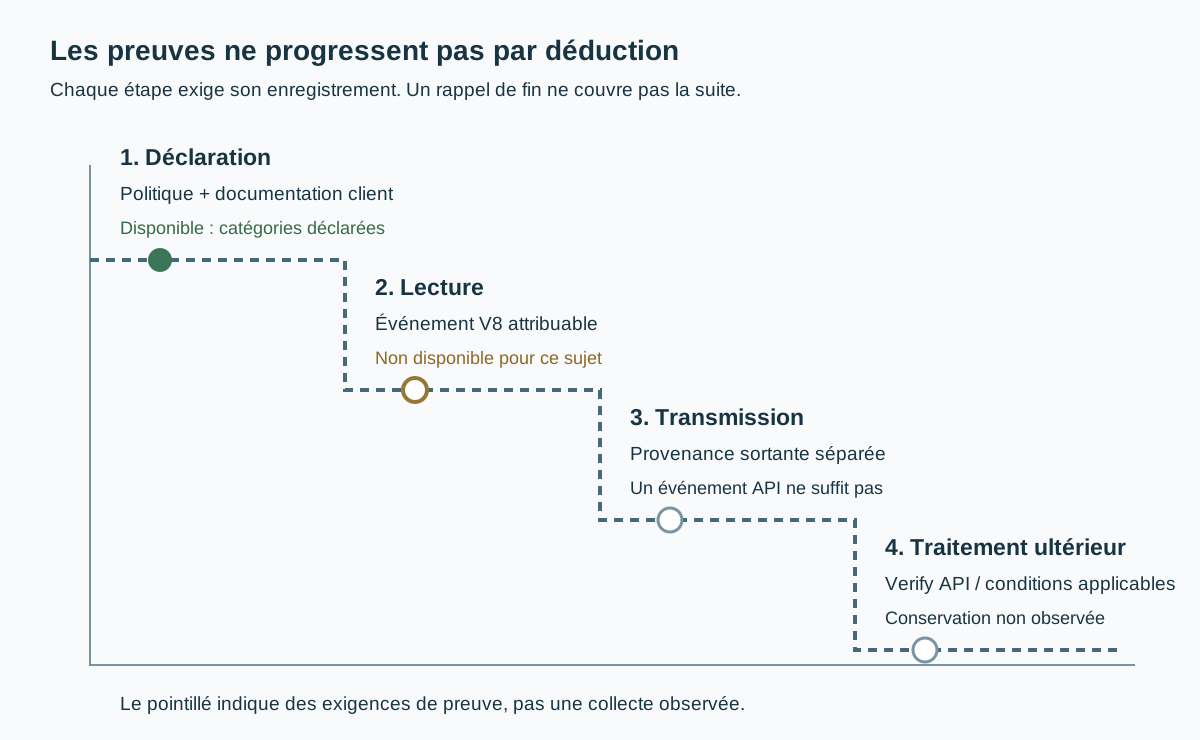
Les journaux V8 peuvent fournir une preuve différente d'une documentation : un événement émis d'interface de navigateur attribuable au script qui l'a causé. Il s'agit de savoir si une source précise a effectué une opération pendant une phase enregistrée. Le nom du fournisseur sur une page, une ancienne liste de propriétés ou un nombre de requêtes ne prouvent pas cette attribution. Événement, source et limites de capture doivent rester liés.
Les recherches locales FunCaptcha examinées comprennent un outil d'injection et un adaptateur de surveillance qui intercepte et interprète le contenu de requêtes. Ils ne sont pas équivalents à des événements originaux --bot-v8-log. Aucun fichier d'événements V8 attribuables à FunCaptcha n'était disponible dans le matériel examiné ; un ancien répertoire de capture ne contenait que des restes d'état du navigateur. Aucun inventaire actuel des API du fournisseur n'en est déduit, et aucun script propriétaire n'a été modifié pour cette publication.
Une opération du navigateur n'est pas automatiquement une mesure d'empreinte. Un composant peut lire une interface pour afficher une tâche, positionner du contenu, gérer l'accessibilité ou son cycle de vie. Lui attribuer une intention exige d'autres preuves. Même une opération graphique bien attribuée ne révèle pas sa contribution à une évaluation privée. La documentation client décrit le rôle de classification, pas la finalité ni le poids de chaque opération.
La transmission constitue une autre limite. Un événement peut montrer l'obtention d'une valeur sans montrer sa sortie du navigateur. Inversement, une requête peut survenir sans révéler les lectures dont provient son contenu. Un rapport ne doit pas convertir la taille d'un message ou un rappel de fin en liste d'attributs transmis. La référence Verify situe aussi les communications serveur hors d'une observation purement navigateur : une capture ne couvre pas automatiquement toute la session.
Une preuve négative doit définir son périmètre. Un événement absent peut correspondre à une branche non exécutée, une observation arrêtée tôt, une attribution manquante ou un journal incomplet. Même une capture complète ne décrit que l'exécution enregistrée, pas toute version future ou configuration client. L'absence d'événements vérifiables ici signifie que cet ensemble de preuves n'étaye pas de lectures d'API précises. Elle ne signifie pas que le service ne lit jamais d'interfaces du navigateur.
La conservation ne se mesure pas en laissant le navigateur ouvert davantage. Stockage du fournisseur, accès des opérateurs et suppression ultérieure se déroulent hors du flux d'événements du navigateur. La politique et les conditions clients énoncent les responsabilités ; un audit opérationnel serait nécessaire pour établir le traitement réel. Lecture, requête sortante, résultat de vérification et obligation de conservation doivent figurer sur des lignes séparées d'un registre de preuves.
Ce registre peut rester réduit. Pour chaque affirmation importante, identifier la source et sa nature : déclaration, activité observée du navigateur, résultat serveur ou disposition contractuelle. Les étapes inconnues doivent rester inconnues. Cela évite une capture disproportionnée censée répondre à tout. Cela permet aussi d'intégrer de nouvelles preuves : un événement attribuable précise une affirmation d'exécution sans remplacer silencieusement les conditions distinctes de traitement et de conservation.
Pourquoi deux interactions peuvent différer
La présentation de Verify établit déjà le caractère conditionnel de la présentation du défi. Deux interactions peuvent donc suivre des chemins visibles différents sans prouver qu'une propriété du navigateur a changé. Configuration client et classification de session font partie de l'architecture documentée. Des captures d'écran ne permettent pas d'isoler leur contribution, et la présentation publique ne révèle pas tous les motifs d'une décision particulière.
La Client API précise qu'une réinitialisation crée une nouvelle session. C'est essentiel pour lire des interactions répétées : une nouvelle session n'est pas simplement l'image suivante d'une observation inchangée. Il faut distinguer la continuité d'une session de la création explicite d'une autre. C'est une limite d'interprétation, pas une instruction pour obtenir un résultat différent ni une affirmation d'amélioration par réinitialisation.
La documentation d'évaluation du risque distingue les informations globales de celles propres au client et précise que cette fonction doit être activée pour les clés concernées. C'est une source documentée de différences de configuration. Elle ne fournit pas un modèle universel reconstructible à partir de la difficulté du puzzle. Une fonction absente d'une intégration ou d'une réponse ne prouve pas l'absence de toute analyse sous-jacente.
La même référence présente l'utilisation de ces informations dans la stratégie de défi ou les modèles internes du client. Ce sont des destinataires fonctionnels différents. Une interaction visible ne révèle pas à un observateur externe quel usage client s'applique. Même un responsable autorisé voyant une réponse serveur documentée doit éviter d'attribuer toutes les décisions ultérieures du compte à Arkose. Les propres enregistrements de l'application montrent ce qu'elle a fait de la réponse.
| Comparaison | Variable documentée qui peut intervenir | Formulation plus limitée et défendable |
|---|---|---|
| Puzzle présenté une fois, absent une autre fois | Chemins conditionnels et configuration client | La présentation a différé ; sa cause n'est pas isolée |
| Nouvelle interaction après réinitialisation | La réinitialisation crée une nouvelle session | La comparaison traverse plusieurs sessions |
| Intégrations de clients différents | Évaluation propre au client et fonctions facultatives | Configuration et interprétation peuvent différer |
| Fin côté client et opération applicative échouée | Vérification serveur et traitement applicatif sont distincts | La fin côté client n'explique pas seule l'opération finale |
Ces règles proviennent des contrats publics d'intégration, pas d'une comparaison de performances mesurée. Elles aident à examiner l'hypothèse qu'un changement de navigateur a causé un résultat. Une conclusion causale demande une investigation contrôlée et autorisée de l'étape pertinente. Des captures avant/après avec sessions, réglages ou comportements serveur différents présentent trop de variables changeantes pour identifier cette cause.
Pour la vie privée, cette variabilité signifie aussi qu'une interaction discrète ne démontre pas un chemin de données toujours vide. L'information pertinente concerne le traitement applicable, pas seulement la dernière tâche visible. Mais l'incertitude sur un modèle privé ne justifie pas de lui attribuer chaque signal imaginable. Les catégories publiées et les enregistrements du déploiement fournissent un départ circonscrit ; les possibilités sans preuve restent des questions ouvertes.
Contrôles du navigateur et décisions du fournisseur ont des responsables différents
La présentation des empreintes de BotBrowser décrit des contrôles fondés sur des profils et des chemins natifs du navigateur plutôt que sur une injection JavaScript. Cette source étaye le niveau de contrôle documenté du produit. Elle n'établit pas les mesures actuelles de FunCaptcha ni un résultat face à Arkose. Documentation produit et preuve d'exécution d'un tiers répondent à des questions différentes.
Une modification de propriété dans la page affecte les chemins qui la rencontrent dans l'environnement JavaScript concerné. Cela ne décrit pas automatiquement chaque contexte intégré ou opération native de rendu. Un contrôle natif possède une autre portée d'implémentation, mais sa couverture dépend toujours de la fonction et de la configuration documentées. Aucune étiquette ne prouve une cohérence universelle, un pouvoir identifiant moindre ou l'acceptation d'une opération par le site.
La question est de savoir quelles informations l'utilisateur peut contrôler à chaque limite. Une surface documentée peut relever des réglages du navigateur. La conception d'URL relève de l'application. Une requête de vérification relève de son intégration serveur. Le traitement du fournisseur dépend de l'accord applicable. Vouloir résoudre ces quatre domaines par une seule propriété de page attribue au contrôle des responsabilités qu'il ne possède pas.
L'analyse de confidentialité de hCaptcha traite un autre fournisseur avec une structure de déclarations différente. Ses preuves ne deviennent pas un inventaire d'API Arkose. Les concepts communs aident à formuler les questions, mais catégories et conditions doivent avoir leurs propres sources. Cela empêche aussi de transformer une comparaison de couches du navigateur en classement infondé des résultats de défis ou en affirmation sur la détectabilité des concurrents.
La cohérence n'est pas l'anonymat. Des valeurs cohérentes peuvent toujours communiquer des informations, et un fournisseur peut recevoir une requête autorisée de l'application. La présentation de BotBrowser décrit ses capacités prises en charge ; la politique d'Arkose explique ses rôles de traitement déclarés. Un contrôle de navigateur ne supprime pas un enregistrement déjà conservé et ne remplace pas l'information du site.
Une équipe choisissant ses contrôles doit nommer la surface, son responsable et la preuve de couverture. Une étiquette unique telle que session protégée risque de faire croire à une évaluation de toutes les couches. Une revue de configuration peut être valide et utile tout en laissant une question de conservation client sans réponse. Séparer ces résultats est plus exact que de présenter l'un ou l'autre comme une protection complète.
Évaluer une intégration propre sans collecter davantage de secrets
Le responsable d'une application peut commencer par les chemins documentés plutôt que par une trace complète du visiteur. Il peut identifier les pages qui chargent le composant, les catégories sensibles de leurs adresses, les options de production activées et l'emplacement des enregistrements de vérification. Les instructions client et le tableau de confidentialité étayent directement ces questions. Aucune ne nécessite d'expérience de résolution de défi ni l'exposition d'artefacts de session.
| Constat dans une intégration propre | Responsable | Première action pertinente |
|---|---|---|
| Contexte sensible dans les paramètres d'une page intégrée | Responsables des routes et de la confidentialité | Retirer le contenu inutile et évaluer le chemin déclaré vers le destinataire |
| Catégories exclusivement commerciales copiées dans une notice de production | Responsables confidentialité et service | Réconcilier la notice avec le traitement activé et les conditions de la source |
| Fin côté client connue, résultat serveur inconnu | Responsable du serveur applicatif | Examiner les enregistrements corrélés et expurgés de vérification et d'application |
| Lectures attribuées au fournisseur à partir d'une ancienne sonde injectée | Responsable de l'observation | Reclasser le résultat comme comportement de sonde jusqu'à disposer d'événements originaux attribuables |
| Demande concernant la conservation en production | Responsables contractuels et confidentialité | Vérifier la catégorie et l'accord de traitement applicable |
Ces règles découlent des sources et ne décrivent pas le déploiement d'un client existant. Une revue des routes peut constater qu'une catégorie de paramètre est inappropriée sans enregistrer de valeurs réelles. Une revue de configuration peut noter l'activation d'un service facultatif en excluant les identifiants secrets. La quantité de preuves doit correspondre à la question, surtout si la préoccupation est une communication inutile d'informations.
Un visiteur externe n'a pas le même rôle. Il peut ne pas accéder aux configurations serveur ou aux contrats ; l'observation du navigateur ne comble pas automatiquement ces lacunes. Une demande de confidentialité utile précise le site, l'opération et la catégorie concernée, sans jeton actif, mot de passe ou URL complète sensible. La politique oriente les questions de production vers l'entité qui a recueilli initialement les informations, selon les droits et la relation applicables.
La question d'exécution non résolue reste précise : quelles interfaces une source attribuable au fournisseur a-t-elle lues pendant une exécution définie ? Aucun événement V8 original du matériel local examiné n'y répond. Les documents publics étayent néanmoins des améliorations concrètes des URL, de l'exactitude des notices et de la séparation entre fin client et vérification serveur. Elles n'exigent ni liste de signaux inventée ni assimilation d'une évaluation privée à une activité observable du navigateur.
Questions fréquentes
Terminer un puzzle FunCaptcha oblige-t-il le site à accepter l'action ?
Non. Fin côté client, vérification serveur et autorisation applicative sont distinctes. Arkose documente une vérification serveur même lorsqu'aucun défi n'est présenté.
L'absence de puzzle signifie-t-elle qu'aucune information n'a été collectée ?
Non. Arkose documente une détection sans intervention visuelle et des sessions sans défi présenté. L'interface ne prouve pas l'absence de traitement.
Le tableau de confidentialité indique-t-il que chaque défi reçoit un courriel ?
Non. Les exemples de coordonnées en production dépendent du service choisi et de restrictions géographiques. Il faut établir les options et les données de l'intégration avant d'attribuer cette catégorie à ses visiteurs.
Les journaux V8 révèlent-ils toute l'évaluation serveur ?
Non. Des événements émis attribuables étayent des opérations enregistrées du navigateur. Ils ne révèlent pas toutes les entrées serveur, décisions ultérieures ou pratiques de conservation.
Modifier les surfaces d'empreinte corrige-t-il les URL sensibles ?
Cela ne corrige pas le placement de contexte sensible dans l'adresse par l'application. Le traitement d'URL documenté fait de la conception des routes une responsabilité distincte.
Sources
- Instructions client d'Arkose
- Client API d'Arkose
- Présentation de Verify API
- Documentation d'évaluation du risque
- Politique de confidentialité, applicable depuis le 27 octobre 2026
- Présentation des empreintes du navigateur de BotBrowser
Conclusion pratique
Le défi visible FunCaptcha est une partie conditionnelle d'une session Arkose. Les surfaces documentées comprennent les URL et des catégories qualifiées d'appareil ou d'IP en production ; fin côté client et vérification serveur restent distinctes. Examiner d'abord les informations sensibles dans les adresses et les déclarations de production applicables. Toute future affirmation de lecture nécessite des événements originaux attribuables ; décisions serveur et conservation doivent être adressées au responsable applicatif ou de confidentialité, pas déduites du puzzle.
Cet article fait partie du guide : Qu'est-ce qu'une empreinte de navigateur ?
Articles Connexes
AWS WAF CAPTCHA : jetons, signaux et vie privée
EmpreinteVie privée hCaptcha : signaux et limites des preuves
EmpreinteVie privée reCAPTCHA : signaux et limites des preuves
EmpreinteKasada : signaux des défis et confidentialité
EmpreintePerimeterX : groupes de signaux et confidentialité
EmpreinteDataDome : signaux et exposition de la vie privée
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.