Navigateur de web scraping : quel type choisir ?
Choisissez entre navigateur piloté, API de résultats et extension selon le contrôle de la page, la gestion de l’état, les permissions et la responsabilité des échecs.
BotBrowser Team
Vous voulez la documentation structurée pour Démarrage ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
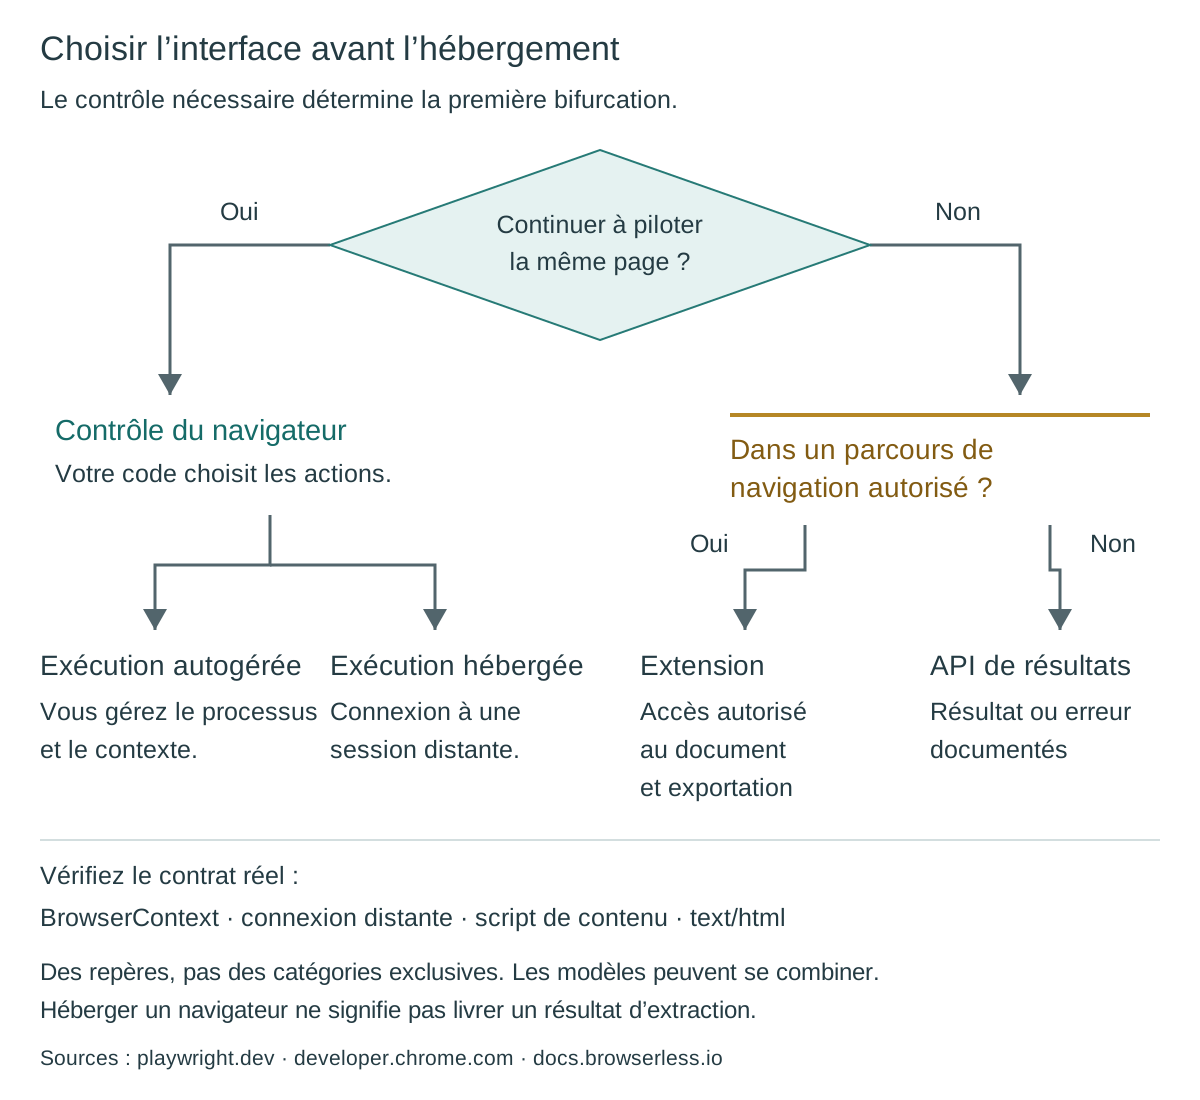
Un navigateur de web scraping peut désigner un navigateur piloté par votre code, un service renvoyant un résultat demandé ou une extension extrayant des informations d’un document dans votre navigateur. Ce sont des interfaces différentes, même si les trois utilisent Chromium quelque part. BotBrowser documente un exécutable contrôlé par Playwright dont la configuration part du profil ; il ne remplace pas une API d’extraction hébergée ni une extension, et ne garantit pas qu’un site autorise la collecte. Le premier choix utile concerne le contrôle nécessaire à votre tâche, pas le nom du navigateur dans une liste comparative. Valider un artefact renvoyé est une question distincte du choix de l’interface navigateur ; voir ce qu’établit une réponse d’API de scraping.
Résumé
- Choisissez le contrôle du navigateur lorsque votre application doit continuer à interagir avec une page et décider de l’action suivante à partir de son état.
- Choisissez un point d’accès de résultats lorsque sa réponse documentée suffit ; une API HTTP peut tout de même exécuter un navigateur et renvoyer du HTML rendu.
- Choisissez une extension lorsque l’extraction s’inscrit dans un parcours de navigation autorisé et que son accès aux documents, ses permissions et sa sortie conviennent à la tâche.
- Un navigateur hébergé peut rester sous le contrôle de votre code d’automatisation. Héberger le processus ne transfère pas automatiquement la logique d’extraction au fournisseur.
- Séparez l’accès du navigateur, l’autorisation applicative et le droit d’utiliser les données collectées. Aucun ne découle d’une connexion ou d’un export réussi.
Sommaire
- Trois significations, quatre modes de fonctionnement
- Contrôler le navigateur signifie décider de l’action suivante
- Une API de résultats relève d’un autre contrat
- Une extension fonctionne dans une limite de permissions
- Examiner un résultat vide à partir de la première frontière en échec
- Choisir la plus petite interface suffisante
- Conclusion pratique
Trois significations, quatre modes de fonctionnement
L’expression mélange une capacité et sa forme de distribution. Un navigateur exécute un document et permet d’interagir avec celui-ci. Une bibliothèque d’automatisation contrôle un navigateur. Un service peut exposer un contrôle du navigateur ou un résultat terminé. Une extension peut lire un document autorisé et proposer un export. Le même fournisseur peut proposer plusieurs modes ; la page d’accueil du produit ne suffit donc pas à identifier le contrat. Examinez l’interface réelle que l’intégration appellera. La référence de connexion du navigateur de Playwright décrit le contrôle d’un navigateur existant ; un point d’accès renvoyant text/html possède une frontière de sortie différente.
La distinction pratique porte sur ce qui se passe après la première réponse. Votre code peut-il examiner une page et continuer à cliquer ou naviguer dans la même session contrôlée ? Reçoit-il un document HTML terminé ou des enregistrements, puis effectue-t-il une nouvelle requête pour poursuivre le travail ? Ou une fonctionnalité agit-elle sur le document déjà ouvert dans un profil de navigateur autorisé ? Ces questions séparent interaction, livraison de résultats et accès aux documents sans établir de classement de qualité. Une tâche peut les combiner, mais chaque transition exige un responsable explicite.
| Mode | Ce que reçoit votre application | Qui exécute le navigateur ou la tâche | Première question de responsabilité |
|---|---|---|---|
| Contrôle du navigateur géré par votre équipe | Un navigateur, un contexte et une page contrôlables | Votre équipe d’exploitation | Qui maintient l’exécutable, le contexte et l’arrêt ? |
| Contrôle du navigateur hébergé | Une connexion distante à une session de navigateur | Le fournisseur du service ; votre code dirige toujours la page | Quel contrat de connexion et de session le client utilise-t-il ? |
| API de résultats hébergée | Le résultat ou l’erreur documenté du point d’accès | Le fournisseur du service derrière ce point d’accès | L’élément renvoyé suffit-il et qui valide ses champs ? |
| Extension du navigateur | L’accès aux documents et l’export pris en charge par l’extension | L’opérateur du navigateur ou du profil et l’implémentation de l’extension | Quels documents et actions disposent d’un accès accordé ? |
Cette matrice précède les six critères de sélection d’un navigateur. Cette grille compare les configurations candidates une fois le contrôle du navigateur choisi comme interface. Elle ne remplace pas la décision de savoir si une session de navigateur est nécessaire. De même, la comparaison du mode sans fenêtre visible concerne l’exécutable et le mode de lancement après le choix d’une solution fondée sur le navigateur. Un navigateur fonctionnant sans fenêtre visible n’est pas, de ce seul fait, un service hébergé ou une API d’extraction.
Les lignes ne sont pas des catégories de produits exclusives. Une extension peut appeler un service distant et un navigateur hébergé peut proposer un point d’accès de résultats distinct. Un programme géré par votre équipe peut encapsuler son propre navigateur dans un service HTTP interne. Décrivez la frontière consommée par votre application au lieu de supposer que tout le système appartient à une seule ligne. Cela garde aussi la responsabilité visible lorsqu’un composant fonctionnant correctement transmet un élément incomplet au suivant.
Contrôler le navigateur signifie décider de l’action suivante
Le contrôle du navigateur est utile lorsque l’extraction dépend d’états successifs de la page. Une application que vous exploitez peut n’afficher un panneau de détails qu’après une action utilisateur, parcourir un processus ou mettre à jour un tableau après le changement d’un réglage. Avec une interface de contrôle du navigateur, votre code choisit l’action, observe le document obtenu et décide si une autre action est nécessaire. La bibliothèque Playwright expose des contextes de navigateur et des pages pour ces parcours. Elle ne choisit pas l’enregistrement métier nécessaire et ne décide pas quel champ manquant est acceptable.
Pour un processus géré par votre équipe, l’équipe d’exploitation est responsable de la disponibilité du navigateur. L’exécutable doit exister, disposer des dépendances d’exécution requises et démarrer sous le compte prévu. Son cycle de vie nécessite aussi une fin délibérée : fermer un onglet ne remplace pas la définition de la gestion du processus, des contextes et de l’état temporaire. La configuration Playwright de BotBrowser décrit la sélection de son exécutable et des paramètres de profil. Ces étapes laissent la navigation applicative, l’extraction, la validation des enregistrements et la planification des tâches à la charge de l’appelant.
L’état exige sa propre décision. Playwright distingue les contextes de navigateur vierges d’un contexte persistant lancé avec un userDataDir. Sa documentation indique que le lancement persistant renvoie l’unique contexte et que fermer ce contexte ferme le navigateur. Elle déconseille aussi l’automatisation du profil utilisateur habituel de Chrome et recommande un répertoire distinct pour l’automatisation. Un opérateur ne doit donc pas attendre d’un processus de scraping nouvellement lancé qu’il hérite de l’état de connexion quotidien d’une personne. Utilisez le contrat documenté du contexte persistant au lieu de traiter tous les dossiers nommés profil comme interchangeables.
Un contexte vierge est tout aussi délibéré. Le guide d’isolation de Playwright décrit des cookies et un stockage séparés pour ses contextes de test. Playwright Test crée automatiquement ces contextes, tandis que les utilisateurs de la bibliothèque peuvent les créer explicitement. Cette frontière de stockage améliore la reproductibilité, mais ne transforme pas les contextes en machines physiques distinctes et n’établit pas l’anonymat. Si une application que vous exploitez nécessite une langue sélectionnée ou l’état d’un compte de test autorisé, consignez si le contexte doit commencer vide ou conserver cet état. Une préférence absente dans un contexte volontairement vierge n’est pas nécessairement un défaut de lancement.
L’hébergement change l’opérateur de l’environnement d’exécution sans nécessairement changer l’interface de contrôle. Playwright peut se connecter à un navigateur exécuté à distance, et sa méthode connectOverCDP s’y attache par Chrome DevTools Protocol. La documentation limite cette connexion CDP aux navigateurs fondés sur Chromium et signale une fidélité inférieure à celle de la connexion par le protocole Playwright. Cela compte lorsqu’un rattachement distant réussit, mais qu’une fonctionnalité précise d’automatisation se comporte différemment. Vérifiez la méthode de connexion et les versions prises en charge avant d’attribuer un problème d’extraction à la page. Un point d’accès distant reste un canal de contrôle, pas un enregistrement de données terminé.
La logique de l’appelant reste importante après la connexion. Si votre programme choisit les sélecteurs, attend un état du document et construit l’enregistrement, le fournisseur n’a pas repris ces responsabilités simplement parce qu’il exécute le processus. Inversement, un fournisseur peut proposer des tâches gérées supplémentaires sous un autre contrat. Séparez ces produits dans la conception de l’intégration. Pour ce choix initial, demandez si votre code a besoin d’un contrôle continu de la page et si votre équipe souhaite exploiter l’environnement d’exécution. Les questions détaillées d’état du fournisseur, de réseau régional et d’adoption relèvent de la décision suivante de déploiement, pas d’une affirmation selon laquelle tous les environnements hébergés échappent au contrôle du client.
Une API de résultats relève d’un autre contrat
Un point d’accès de résultats accepte une requête documentée et renvoie un élément documenté. Cet élément peut être du HTML source, du HTML rendu, une image ou des champs structurés ; ils ne sont pas interchangeables. La documentation de Content API de Browserless fournit un exemple concret : son point d’accès /content décrit le rendu d’une URL ou de HTML fourni dans un navigateur, puis le renvoi de text/html, y compris du contenu rendu par JavaScript. Le recours de l’appelant à une requête HTTP n’établit donc pas que le service a omis l’exécution d’un navigateur.
La question utile est de savoir si cette réponse contient tout ce dont l’étape suivante a besoin. Si un analyseur en aval exige seulement le document rendu dans un état défini, une interface de résultats peut suffire. Si l’appelant doit examiner une boîte de dialogue intermédiaire et décider de l’action suivante, une simple réponse HTML ne fournit pas, à elle seule, un contrôle continu de la page. Certains services exposent des attentes configurables ou des tâches supplémentaires, mais il faut les établir à partir du contrat actuel du point d’accès choisi. Ne les déduisez pas de l’emploi du mot navigateur par le fournisseur.
Le rendu et l’extraction sont aussi des services différents. Renvoyer du HTML ne signifie pas que le service a sélectionné les bons identifiants d’articles, interprété une devise ou vérifié la présence de chaque enregistrement requis. Un point d’accès d’extraction structurée peut accepter certaines de ces responsabilités, mais uniquement selon ses spécifications. Le responsable de l’intégration doit toujours valider sa sortie par rapport au schéma de l’application. Pour un enregistrement hypothétique de catalogue, un document livré et une valeur price valide sont deux résultats distincts. Une information de devise manquante ne se répare pas en qualifiant la requête HTTP de réussie.
Une erreur du point d’accès n’est pas le seul résultat incomplet. Une réponse peut arriver avec le type de média attendu tout en contenant un document de connexion, un message d’élément introuvable, une erreur applicative ou une page dont le contenu requis n’est pas encore apparu. Traitez l’élément renvoyé selon sa signification avant de l’analyser comme les données métier demandées. Le diagnostic du rendu et de la pagination traite de la disponibilité du contenu ; passer d’une bibliothèque de navigateur à une API ne supprime pas la nécessité de définir ce qu’est un document terminé.
L’état et la conservation sont aussi des questions contractuelles ici. Une interface HTTP ne prouve ni une exécution sans état, ni une persistance automatique, ni une suppression après la réponse. Demandez quelles fonctions de session le point d’accès propose réellement et quelles données couvrent ses conditions de traitement. La même prudence vaut pour les nouvelles tentatives : une seconde requête peut répéter la tâche plutôt que reprendre une page antérieure. Ne comptez sur aucun de ces comportements sans documentation. Il s’agit d’une distinction d’interfaces, pas d’une affirmation selon laquelle les API de résultats offrent moins de contrôle ou de confidentialité dans chaque implémentation.
Les API de résultats peuvent réduire le code de gestion du cycle de vie du navigateur dans l’application consommatrice, mais elles ne suppriment pas la responsabilité du périmètre des entrées, du traitement autorisé des données ou de la classification des échecs en aval. Une équipe choisissant cette voie doit pouvoir nommer le type de réponse requis, le moment où la tâche est considérée comme terminée et le responsable chargé des sorties mal formées ou incomplètes. Ces exigences constituent la frontière d’acceptation ; les noms des fournisseurs et la commodité du point d’accès ne les déterminent pas.
Une extension fonctionne dans une limite de permissions
Une extension de scraping est un logiciel opérant par les capacités des extensions du navigateur. Elle peut lire un document ouvert, exposer une interface de sélection, organiser des enregistrements ou exporter des données, selon son implémentation. La documentation des scripts de contenu de Chrome décrit des scripts capables de lire et modifier le DOM d’une page et de communiquer avec l’extension. Une extension est donc pertinente lorsque la tâche s’inscrit dans un parcours de navigation existant et autorisé plutôt que dans un processus d’automatisation lancé séparément.
L’accès aux documents est délimité. Chrome exige des permissions d’hôte appropriées pour l’injection programmatique de scripts de contenu ; l’accès temporaire par activeTab est une option documentée. Les règles de correspondance, les cadres et le moment de l’injection déterminent aussi où les scripts s’exécutent. Une permission du navigateur accorde à une extension une capacité dans le navigateur. Elle n’établit ni l’autorisation du site d’automatiser la collecte ni une finalité licite de réutilisation des données. Le clic d’un utilisateur sur une action de l’extension ne peut fusionner ces décisions séparées en une approbation unique.
Une extension n’est pas nécessairement uniquement manuelle. Chrome prend en charge des scripts de contenu s’exécutant automatiquement sur les pages correspondantes, ainsi que l’injection dynamique et programmatique. La prise en charge de tâches planifiées, de la navigation ou d’un fonctionnement sans surveillance par une extension donnée dépend de son implémentation et de son environnement d’exploitation. Ne sélectionnez ni ne rejetez toute la catégorie en supposant que chaque enregistrement exige un clic distinct. Examinez plutôt le déclencheur pris en charge par la fonctionnalité, son périmètre documentaire et le cycle de vie de sa sortie.
L’environnement d’exécution n’est pas identique à l’environnement JavaScript de la page. Les scripts de contenu s’exécutent normalement dans un monde isolé : ils partagent l’accès au document, mais pas automatiquement les variables de la page. Un tableau visible peut être disponible par accès au DOM alors qu’un objet interne de l’application n’est pas directement accessible depuis ce contexte isolé. Cette distinction explique l’importance du contrat d’extraction pris en charge par l’extension. Ce n’est pas une méthode pour atteindre l’état privé d’une page ou étendre l’accès au-delà des permissions accordées.
Le travail en arrière-plan possède un autre cycle de vie. Le guide des service workers d’extensions de Chrome décrit l’arrêt normal du worker après une période d’inactivité et sa réactivation par des événements ultérieurs. Il avertit que les variables globales sont perdues à l’arrêt du worker et recommande un stockage persistant pour les valeurs durables. Cela ne signifie pas qu’une extension cesse de fonctionner chaque fois que son worker devient inactif. Cela signifie qu’une tâche à plusieurs étapes ne doit pas supposer qu’un même processus d’arrière-plan en mémoire restera actif pendant tout le parcours. Un redémarrage et une extension désinstallée sont des diagnostics différents.
Le profil du navigateur fait aussi partie de la frontière de confidentialité. Une extension peut fonctionner aux côtés de l’état de navigation autorisé d’une personne, mais ses accès demandés et les destinations des données nécessitent un examen. Déterminez si les enregistrements restent locaux ou sont envoyés ailleurs à partir de la documentation et de la politique de l’extension réelle ; ni l’étiquette d’extension ni un bouton d’export local ne répondent à cette question. Limitez le périmètre des documents et des données à la tâche. Si un parcours nécessite un environnement sans surveillance isolé séparément, comparez cette exigence au contrôle du navigateur au lieu d’étendre les permissions jusqu’à ce qu’une extension ressemble à un autre modèle de fonctionnement.
Examiner un résultat vide à partir de la première frontière en échec
Un export vide est un symptôme commun à tous les modes. Les enregistrements manquants ne distinguent pas un problème de démarrage d’un accès refusé au document. Un processus de navigateur peut ne jamais démarrer ; une connexion distante peut employer une combinaison de protocoles non prise en charge ; une API peut renvoyer le mauvais document ; une extension peut ne pas avoir accès au cadre concerné. Ce n’est qu’après avoir établi ces frontières qu’une investigation des sélecteurs ou du schéma devient pertinente. La référence de connexion de Playwright et les règles de permissions de Chrome décrivent des contrats différents et exigent donc des premières vérifications différentes.
| Mode et symptôme hypothétique | Première frontière à établir | Vérification suivante et responsable |
|---|---|---|
| Une tâche gérée par votre équipe n’a pas de page | Démarrage de l’exécutable et création du contexte | Le responsable de l’exécution vérifie le binaire configuré et le résultat du démarrage |
| Le navigateur hébergé se connecte, puis une action échoue | Protocole pris en charge, session et page réelle | Le responsable de l’intégration distingue la capacité de connexion de la disponibilité du document |
| Le point d’accès de résultats renvoie du HTML, mais aucun enregistrement | Élément demandé, document reçu et champs requis | Le responsable de l’API vérifie le contrat de réponse ; le responsable des données valide sa signification |
| L’export de l’extension est vide sur un document | Accès accordé, correspondance ou cadre et moment d’exécution du script | Le responsable du navigateur ou de l’extension vérifie l’accès avant de modifier les règles d’extraction |
| L’extension perd une tâche inachevée après une période d’inactivité | État durable de la tâche contre variables globales du worker | Le responsable de l’extension vérifie le stockage et la reprise par événements |
Ce sont des exemples de diagnostic, pas des incidents observés ni des affirmations concernant des fournisseurs précis. Le tableau attribue la première vérification plutôt que la cause finale. Un lancement réussi du navigateur peut tout de même conduire à un échec applicatif, et une permission d’extension valide ne garantit pas qu’une page contient les champs attendus. Séparez suffisamment les résultats des étapes pour qu’un succès ne certifie pas implicitement l’étape suivante.
Il en va de même pour le coût des ressources. Une navigation terminée, une réponse d’API reçue et un enregistrement valide exporté ont des dénominateurs différents. Comparez les coûts uniquement après avoir défini l’unité acceptée par votre application. La grille existante de sélection des navigateurs fournit des mesures de charge une fois l’interface choisie. Réutiliser cette grille comme classement universel entre sorties différentes masquerait qui a effectué le travail et ce que le résultat contenait réellement.
Choisir la plus petite interface suffisante
Commencez par l’élément requis et la décision suivante. Pour un catalogue hypothétique que vous exploitez et qui exige seulement un document terminé destiné à un analyseur distinct, un point d’accès de résultats documenté peut suffire. Pour un parcours que vous exploitez où le code doit choisir entre des états de page et continuer à interagir, le contrôle du navigateur est le contrat pertinent. Pour un utilisateur autorisé examinant un petit ensemble de documents dans un parcours de navigateur existant, une extension peut convenir si l’accès accordé et l’export prennent en charge les données nécessaires. Ces exemples choisissent des interfaces, pas des produits ou des stratégies d’accès.
Choisissez ensuite où doit résider l’état. Un contexte vierge, un répertoire d’automatisation explicitement persistant, un contexte géré par un fournisseur et le stockage d’une extension ont des cycles de vie différents. Consignez quel état doit survivre et lequel doit être isolé. Évitez d’importer des données sans rapport du profil quotidien pour donner l’apparence d’une tâche complète. Dans l’intégration Playwright de BotBrowser, la configuration de l’exécutable et du profil reste distincte des enregistrements applicatifs ; le programme d’automatisation détermine toujours comment sa tâche commence et se termine.
Enfin, vérifiez un petit cas de test autorisé à la frontière choisie. Vérifiez que le document ou l’enregistrement requis arrive, que l’état prévu se comporte comme annoncé et qu’un résultat incomplet parvient au responsable concerné. Aucun benchmark ni test de service n’est rapporté ici. Le résultat de ce futur cas de test établirait la compatibilité de la configuration testée, pas l’anonymat, une permission ou une promesse générale qu’un site distant acceptera du trafic automatisé.
Questions fréquentes
Un navigateur de web scraping est-il la même chose qu’une extension du navigateur ?
Non. Une extension fournit les fonctionnalités qu’elle implémente dans les permissions du navigateur et le périmètre documentaire. Un logiciel de contrôle du navigateur dirige une session de navigateur. Les deux peuvent examiner un document, mais l’interaction disponible, le cycle de vie et les responsabilités de gestion de l’état diffèrent.
Une API HTTP de scraping signifie-t-elle que JavaScript n’est pas exécuté ?
Non. Un point d’accès de résultats documenté peut exécuter un navigateur et renvoyer du HTML rendu. Vérifiez le contrat de réponse et de disponibilité du point d’accès particulier au lieu de déduire son modèle d’exécution du transport HTTP.
Héberger un navigateur transfère-t-il la logique d’extraction au fournisseur ?
Pas automatiquement. Lorsque votre client pilote les pages par une connexion distante, il reste responsable de sa logique de navigation et d’extraction, sauf si un contrat distinct de tâches gérées attribue ce travail au service.
Une extension peut-elle fonctionner sans cliquer pour chaque page ?
Certaines le peuvent. Chrome prend en charge des scripts de contenu exécutés automatiquement selon des règles de correspondance, mais le comportement sans surveillance d’une extension particulière dépend de son implémentation, de ses permissions, de son cycle de vie en arrière-plan et de l’environnement du navigateur.
BotBrowser remplace-t-il une API de scraping ou un planificateur ?
La documentation citée décrit l’exécution du navigateur et l’intégration Playwright. Cela ne fournit ni schéma d’extraction, ni file d’attente, ni contrat de service hébergé. L’application reste responsable de ces composants et de leur usage autorisé.
Après avoir choisi le contrôle d’un navigateur hébergé, les limites de session et d’état de Browserbase distinguent la fin de session d’un enregistrement valide, la sauvegarde du Context de l’état applicatif, et la région du navigateur de la sortie du proxy. Ces contrats propres au fournisseur déterminent les éléments que le responsable de l’intégration doit vérifier ensuite.
Sources
- Playwright : contextes de navigateur et isolation
- Playwright : BrowserType et contrats de connexion
- Chrome : scripts de contenu
- Chrome : cycle de vie des service workers d’extensions
- Browserless : Content API
- BotBrowser : intégration Playwright
Conclusion pratique
Choisissez l’interface nécessaire avant la marque du navigateur : contrôle continu de la page, résultat documenté ou accès autorisé d’une extension. Si le contrôle du navigateur est nécessaire, décidez séparément qui exploite l’environnement d’exécution. Explicitez les responsabilités de gestion de l’état, de validation et des échecs afin qu’un composant réussi ne tienne pas lieu d’enregistrement valide ou d’autorisation de le collecter.
Cet article fait partie du guide : Débuter avec l'automatisation du navigateur : carte initiale
Articles Connexes
API de scraping web : ce que cache la réponse
DémarrageWeb scraping Browserbase : qui contrôle quoi ?
DémarrageScraping avec Playwright : navigateur et profil
DémarrageWeb scraping JavaScript : rendu, pagination, scroll
DémarrageEmpreinte du navigateur : les limites de Scrapy
DémarrageTwitter scraping: fenêtres API et limites du navigateur
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.