Éthique du scraping au-delà de robots.txt
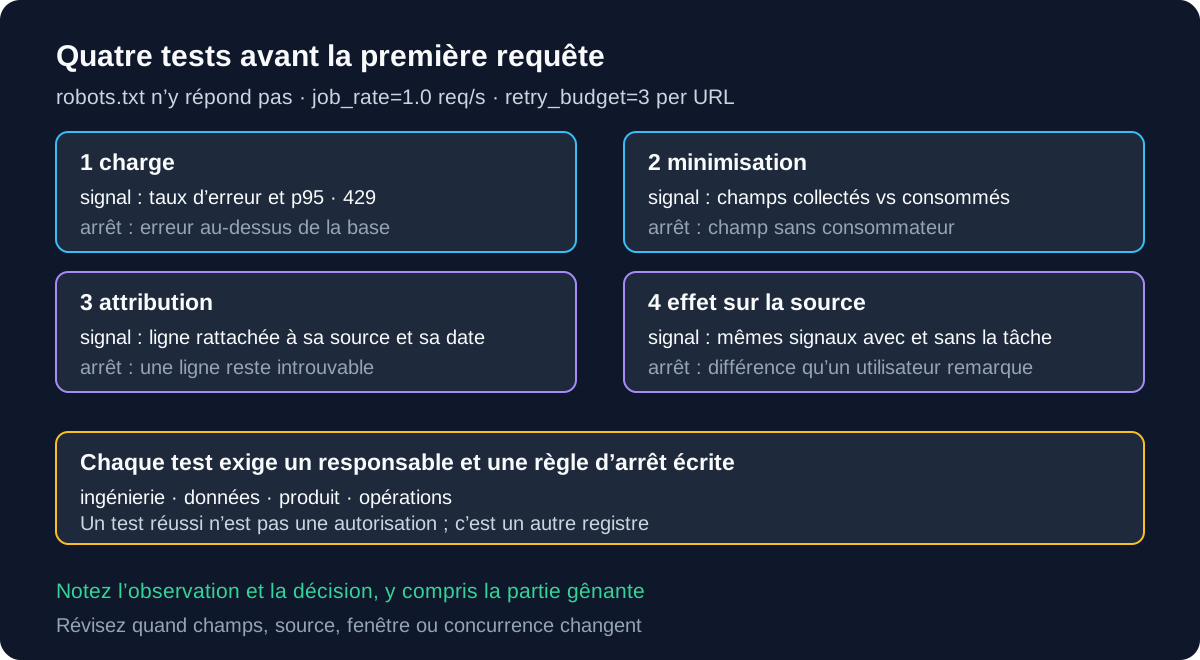
Quatre décisions éthiques qu’une équipe data peut tester sans avocat : charge, minimisation, attribution et effet sur la source.
BotBrowser Team
Vous voulez la documentation structurée pour Démarrage ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
Une vérification robots.txt peut réussir alors qu’une collecte prend encore plus à un service que son propriétaire n’accepterait. BotBrowser documente l’automatisation de navigateur pour un travail autorisé et exige d’opérer sur des systèmes possédés ou testés avec une autorisation écrite ; il ne remplace pas un avis juridique et ne décide pas si une collecte est équitable envers la source.
TL;DR
- Ici, éthique signifie quatre décisions qu’une équipe peut tester sans avocat : quelle charge, quelles données minimales, quel crédit et quel effet la collecte a sur la source.
- Une règle robots est une consigne de coordination. Elle ne répond à aucune des quatre questions.
- Chaque test a besoin d’un signal observable et d’un responsable nommé, sinon il devient un slogan que personne n’applique.
- Les questions juridiques et contractuelles restent dans le registre de décisions préalable, séparé.
- Écrivez les quatre réponses avant la première requête et révisez-les quand la tâche ou la source change.
Sommaire
- Quatre tests, pas quatre principes
- Charge : ce que la source doit servir
- Minimisation : le plus petit ensemble de champs
- Attribution : rendre la source visible
- Effet sur la source : le test oublié
- Conclusion pratique
Quatre tests, pas quatre principes
Une page d’éthique qui énumère des valeurs est facile à approuver et difficile à utiliser. Une équipe a besoin d’un test qu’elle peut exécuter, d’un résultat qu’elle peut consigner et d’un responsable qui peut arrêter la tâche. Les quatre ci-dessous suivent l’ordre dans lequel une tâche touche la source : d’abord la requête, puis les données, puis l’usage de ces données, puis l’effet sur le service.
| Test | Question | Signal observable | Responsable |
|---|---|---|---|
| Charge | La tâche prend-elle plus de capacité que la source ne peut en céder ? | Requêtes par seconde, taux d’erreur, reprises, quota publié | Ingénierie |
| Minimisation | Chaque champ collecté est-il utilisé ? | Liste des champs comparée au rapport ou au modèle qui les consomme | Responsable des données |
| Attribution | Un lecteur peut-il remonter les données à leur source ? | Nom, URL et date de récupération dans la sortie | Produit |
| Effet sur la source | La tâche change-t-elle ce que voient les autres utilisateurs ou son coût ? | Latence, taux d’erreur ou disponibilité pendant la fenêtre | Opérations |
Les tests sont volontairement étroits. Ils ne décident pas de la légalité et ne remplacent pas la revue des conditions, qui reste dans le registre de scraping légal et conditions ; une règle robots, elle, est traitée séparément dans le registre robots.txt. Ils répondent à une autre question : puisque l’équipe peut collecter, cette collecte est-elle respectueuse du service et des personnes derrière lui ? Une équipe peut échouer à un test et rester dans ses droits, et réussir les quatre tout en ayant une question juridique. Séparer les deux conversations est ce qui rend chacune utile.
Charge : ce que la source doit servir
La charge est le test le plus facile à rendre observable et le plus facile à ignorer. Une tâche qui réessaie agressivement pendant un incident ajoute exactement la charge que la source ne peut pas céder. Le test n’est pas « sommes-nous restés sous un nombre » mais « le comportement de la source pendant notre fenêtre est-il resté dans la plage qu’elle montrait quand nous ne tournions pas ».
Mesurez trois choses pendant la fenêtre et comparez-les à une base calme : le débit de requêtes de la tâche, le taux d’erreur de la source et le temps d’attente des autres requêtes. Si le débit de la tâche reste dans le quota publié et que le taux d’erreur et la latence de la source ne bougent pas, le test passe. Si le taux d’erreur monte ou si la latence croît pendant que la tâche tourne, la tâche fait partie de la cause jusqu’à preuve du contraire, et la réponse éthique est de ralentir plutôt que de réessayer plus fort.
window=02:00-04:00 UTC
job_rate=1.0 req/s
source_error_rate_baseline=two tenths of a percent
source_error_rate_window=three tenths of a percent
source_p95_baseline=210 milliseconds
source_p95_window=225 milliseconds
retry_budget=3 per URL
result=pass (within noise, no retry storm)
Les chiffres ci-dessus sont un exemple de forme d’enregistrement, pas une mesure d’un site. La règle de décision compte plus que les valeurs : un petit mouvement dans la variation normale n’est pas un échec, et un grand mouvement avec une heure de début claire n’est pas excusé par un débit moyen bas. Une tempête de reprises apparaît comme un compteur de reprises qui monte avec un compteur de requêtes plat, d’où le budget de reprises dans le même enregistrement.
L’éthique de charge couvre aussi la fenêtre. Une tâche qui tourne à l’heure la plus chargée de la source prend de la capacité aux utilisateurs réels même à débit modeste. Une fenêtre calme, une concurrence plus faible et un arrêt net quand la source signale une pression font partie de la même décision. L’article sur les limites de débit et la concurrence couvre la mécanique ; ce test décide quand la mécanique est respectueuse.
Minimisation : le plus petit ensemble de champs
La minimisation pose une question directe sur chaque champ : qui l’utilise, et que se passe-t-il s’il manque ? Un champ qu’aucun rapport, modèle ou cas de support ne consomme est une charge sans bénéfice. Il coûte du stockage, élargit la surface de confidentialité et rend le jeu de données plus difficile à justifier plus tard.
Exécutez le test comme une comparaison, pas comme une réunion. Prenez la liste des champs de la tâche de collecte et celle du consommateur, et marquez chaque champ comme utilisé, prévu ou inutilisé. Un champ marqué prévu depuis plus d’un cycle de revue est effectivement inutilisé ; soit un consommateur apparaît, soit le champ quitte la tâche. Le test passe quand chaque champ collecté a un consommateur nommé et une raison énoncée.
collected=sku,list_price,currency,observed_at,seller_name,review_text
consumed=sku,list_price,currency,observed_at
unused=seller_name,review_text
decision=drop seller_name and review_text from the collection
next_review=2027-02-01
L’exemple retire deux champs dont un rapport de prix n’a pas besoin. Un champ de texte d’avis est tentant parce qu’il est visible sur la page, mais la visibilité n’est pas un cas d’usage. Si une fonction ultérieure en a besoin, l’équipe peut l’ajouter avec une nouvelle décision, une nouvelle règle de conservation et une nouvelle vérification de confidentialité. Le collecter maintenant « au cas où » inverse cet ordre et transforme une décision facile en projet de nettoyage.
La minimisation s’applique aussi à la précision. Un horodatage complet, une URL complète avec paramètres ou une chaîne d’appareil exacte peuvent dépasser le besoin du consommateur. Une catégorie large, une date au lieu d’une heure à la seconde ou une valeur normalisée peuvent répondre à la même question avec moins d’exposition. Le test consiste à demander au consommateur si la valeur plus grossière change la décision ; si ce n’est pas le cas, collectez la valeur plus grossière.
Attribution : rendre la source visible
L’attribution est le test qui affecte le plus les lecteurs de la sortie. Un jeu de données impossible à rattacher à sa source est difficile à vérifier, difficile à corriger et facile à déformer. Le test est simple : prenez une ligne au hasard et essayez de retrouver la page source et la date de récupération à partir de la seule sortie. Si cela prend plus d’une minute ou dépend de la mémoire de quelqu’un, le test échoue.
Stockez le nom de la source, l’URL de la page et la date de récupération avec chaque enregistrement, et transportez-les dans le rapport ou le modèle qui consomme les données. Pour une page publique, un lien suffit généralement. Pour une page derrière un compte autorisé, notez le contexte du compte et l’autorisation qui a permis l’accès, pas le justificatif. Le but est la traçabilité, pas l’exposition d’un document privé.
record=price-4412
source_name=shop.example.test
source_url=https://shop.example.test/item/4412
retrieved_at=2026-11-13T02:14:07Z
method=rendered page, authorized test account
L’attribution a une seconde moitié : ne présentez pas les données collectées comme une déclaration de la source. Un prix extrait d’une page est une observation à un instant, pas un flux officiel, et un rapport qui le présente comme faisant autorité trompe le lecteur même si le nombre est exact. Étiquetez l’observation, l’heure et la méthode, et laissez le lecteur juger. Le pipeline de collecte de données montre comment garder séparés les enregistrements bruts et normalisés pour qu’une republication ou une carte absente ne devienne pas un fait inventé.
Effet sur la source : le test oublié
Le quatrième test demande ce que la collecte fait au service. Une tâche peut rester dans une limite de débit et changer malgré tout l’expérience des autres utilisateurs si elle tourne à l’heure de pointe, garde des sessions longues ou déclenche à répétition un chemin de page coûteux. Le test consiste à comparer le comportement de la source avec et sans la tâche, à la même heure, et à chercher une différence qu’un utilisateur remarquerait.
Choisissez un petit ensemble de signaux : latence de page, p95, taux d’erreur et rendu correct d’une page connue qui renvoie HTTP 200. Lancez la comparaison dans une fenêtre calme puis dans la fenêtre réellement utilisée par la tâche. Si la fenêtre de la tâche montre une différence constante, la tâche a un effet ; réduisez la concurrence, déplacez la fenêtre ou arrêtez. Une différence qui n’apparaît que pendant la tâche est le signal recherché, et on n’y répond pas en citant un quota publié.
Le test d’effet couvre aussi l’activité de la source, pas seulement ses serveurs. Une collecte qui republie tout le catalogue peut réduire la raison de visiter la source, même si les requêtes sont légères. C’est un jugement que l’équipe doit faire et consigner : quelle part de la valeur de la source est copiée, et la collecte apporte-t-elle quelque chose en retour ? Un historique de prix construit par observations répétées apporte ce qu’une visite unique n’apporte pas. Une copie littérale du catalogue apporte peu.
Consignez la réponse avec la même discipline que les trois autres tests. L’enregistrement peut être court, mais il doit nommer l’effet examiné et la raison pour laquelle l’équipe l’accepte ou le rejette. « Nous ne demandons que quelques pages » répond au test de charge ; pas à celui d’effet.
Registre combiné
Les tests ne servent que si un relecteur peut les lire ensemble. Tenez un registre par tâche avec quatre blocs, un par test, et une règle d’arrêt pour chacun. Le registre peut vivre à côté de la configuration de collecte, à condition d’être versionné et daté d’une revue. Un registre qui ne vit que dans un fil de discussion n’est pas un registre.
| Bloc | Champs | Règle d’arrêt |
|---|---|---|
| Charge | fenêtre, débit, erreur de base, erreur en fenêtre, reprises | Arrêter si l’erreur en fenêtre dépasse la base du seuil fixé à l’avance |
| Minimisation | collectés, consommés, inutilisés, prochaine revue | Arrêter si un champ inutilisé n’a pas de consommateur après un cycle de revue |
| Attribution | nom, URL, date de récupération, méthode | Arrêter si une ligne échantillonnée reste introuvable |
| Effet sur la source | signaux, résultat calme, résultat en fenêtre, raison | Arrêter si la fenêtre montre une différence constante qu’un utilisateur remarquerait |
La règle d’arrêt est la partie que les équipes oublient. Sans seuil convenu d’avance, chaque résultat est discutable après coup, et la personne qui exécute la tâche n’a pas de consigne claire. Écrivez la règle quand la tâche est calme, pas pendant un incident, et rendez-la assez précise pour que deux personnes lisant les mêmes chiffres arrivent à la même décision.
Revoyez le registre quand la tâche change. Un nouveau champ, une nouvelle source, une nouvelle fenêtre ou une concurrence plus élevée peuvent invalider l’un des quatre résultats. La revue n’est pas une formalité : c’est le moment où l’équipe décide si la réponse précédente tient toujours. Si la réponse n’est pas claire, le choix par défaut le plus sûr est la charge plus basse et l’ensemble de champs plus petit jusqu’à mise à jour du registre.
Deux cas d’échec
Le premier cas est une tâche qui réussit chaque test et semble pourtant mauvaise. Elle tourne à faible débit, collecte quatre champs, attribue chaque ligne et ne montre aucun effet mesurable sur la source. Puis quelqu’un remarque que ces quatre champs reproduisent exactement le rapport payant de la source, et la collecte republie un produit au lieu d’observer un marché. Aucun des quatre tests ne le détecte, car la question porte sur le modèle économique de la source, pas sur sa capacité. Le remède est une décision de périmètre : collecter une tranche plus étroite, ajouter une analyse que la source ne fournit pas, ou arrêter. Consignez cette décision dans le test d’effet, même si les signaux mesurables étaient propres.
Le second cas est une tâche qui échoue au test de charge uniquement pendant un incident externe. La source ralentit pour ses propres raisons, les reprises de la tâche ajoutent de la pression, et l’équipe voit un pic qu’elle n’a pas causé seule. La réponse éthique reste de reculer, car la tâche fait désormais partie du problème, et le registre doit le dire. Blâmer l’incident est exact sur la cause et sans effet sur la décision : une tâche respectueuse cède quand la source est sous pression, puis reprend selon un plan, pas immédiatement.
Les deux cas partagent une habitude : l’équipe note ce qu’elle a observé et décidé, y compris la partie gênante, dans le même registre que job_rate et retry_budget. Un registre qui ne liste que des chiffres favorables n’apprend rien à l’équipe suivante.
Questions hors de ces quatre tests
Les quatre tests ne décident pas si une source autorise l’accès automatisé, si un champ est une donnée personnelle au sens d’une loi, ni si une collecte est licite dans une juridiction. Ces questions relèvent du registre de décisions préalable séparé. Les mélanger à une liste éthique donne à celle-ci l’apparence d’une approbation juridique, ce qu’elle n’est pas.
Les tests ne classent pas non plus les sources ou les outils. Une source qui publie une API généreuse et une qui n’en publie aucune ne sont pas moralement différentes par ce seul fait ; les obligations de l’équipe dépendent de ce qu’elle collecte et de son usage. Les quatre tests s’appliquent de la même manière aux deux.
Conclusion pratique
Avant la première requête, exécutez les quatre tests et consignez le résultat : charge contre une base calme, champs contre leurs consommateurs, lignes contre leurs sources, et effet de la tâche contre la même source sans elle. Donnez à chaque test un responsable et une date de revue. Gardez ces décisions éthiques séparées du registre juridique et contractuel ; un test réussi ne crée pas d’autorisation, et une autorisation ne rend pas une collecte négligente respectueuse.
Questions fréquentes
Ces tests constituent-ils un avis juridique ?
Non. Il couvre quatre tests opérationnels qu’une équipe peut exécuter sans avocat. Les questions de conditions, de données personnelles, de juridiction ou d’autorisation relèvent du registre préalable.
Réussir une vérification robots.txt satisfait-il ces tests ?
Non. Une règle robots est une consigne de coordination. Elle ne mesure ni la charge, ni l’usage des champs, ni l’attribution, ni l’effet sur la source. Les quatre tests ont besoin de leurs propres preuves.
À quelle fréquence exécuter les tests ?
Au démarrage d’une tâche, à chaque changement de liste de champs, de source, de fenêtre ou de concurrence, et à la date de revue de l’enregistrement. Une tâche respectueuse le trimestre dernier peut devenir négligente après un changement de source.
Que faire quand un test échoue ?
Réduisez la pression et relancez le test : baissez la concurrence, déplacez la fenêtre, retirez les champs inutilisés, ajoutez l’attribution ou arrêtez la tâche. Un test en échec est une raison de changer la tâche, pas de reformuler le résultat.
Sources
Cet article fait partie du guide : Débuter avec l'automatisation du navigateur : carte initiale
Articles Connexes
Scraping légal et conditions : ce qu’une équipe doit décider
DéploiementScraping et robots.txt : règles, blocages et échecs HTTP
DémarrageNavigateur de web scraping : quel type choisir ?
DémarrageScraping avec Playwright : navigateur et profil
DémarrageExploration web : budget et respect du site
DéploiementScraping d’offres d’emploi : limites du navigateur
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.