Scraping avec Playwright : navigateur et profil
Configurez une collecte autorisée de liste et fiches avec Playwright. Distinguez profil, cookies et erreurs, puis enregistrez un résultat JSON exploitable.
BotBrowser Team
Vous voulez la documentation structurée pour Démarrage ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
Le scraping avec Playwright exige deux vérifications distinctes : ouvrir le navigateur prévu et extraire les bons enregistrements. La réussite de chromium.launch() ne prouve ni le sens d'un prix ni le droit de le collecter. BotBrowser permet de configurer Chromium avec un profil via executablePath et args ; il ne fournit pas les sélecteurs du site, n'autorise pas l'accès et ne garantit pas la réponse du serveur. Sur une application possédée ou autorisée, un parcours limité liste-fiches sépare le diagnostic du navigateur de celui des données.
TL;DR
- Définir
executablePathet passer--bot-profilecomme un argument unique. Le profil BotBrowser est distinct des cookies et du stockage local. - Garder liste et fiches dans un
BrowserContextpour une même session autorisée. Un nouveau contexte isole le stockage, sans créer une nouvelle identité réseau. - Vérifier statut, origine finale et sélecteurs avant d'accepter un enregistrement. HTTP 200 peut aussi correspondre à une page de connexion.
- Séparer données et diagnostics. Un état d'authentification sauvegardé est un secret d'accès, pas une pièce jointe de débogage.
Sommaire
- Configurer le navigateur avant la collecte
- Extraire une liste et ses fiches
- Choisir ce qui persiste entre les exécutions
- Distinguer données et échec dans le résultat
- Diagnostiquer la couche défaillante
- Conclusion pratique
Pour extraire un catalogue propre avec vérification HTTP et schéma des lignes, la comparaison des options de scraping Puppeteer distingue entrées de lancement et observations, avec stockage explicite du contexte isolé.
Configurer le navigateur avant la collecte
La référence BrowserType de Playwright décrit executablePath pour lancer un autre exécutable que celui fourni. Elle avertit aussi que la compatibilité d'un navigateur personnalisé n'est pas garantie. Figer playwright-core dans le fichier de verrouillage, relever la version réelle du navigateur et vérifier la compatibilité après chaque changement. Télécharger le Chromium fourni par Playwright ne met pas à jour le chemin personnalisé.
Les chemins du binaire et du profil doivent être absolus et accessibles dans l'environnement qui lance le travail. Dans un conteneur, un fichier présent uniquement sur l'hôte ne suffit pas. Vérifier les droits d'exécution et de lecture avant le lancement ; une variable absente doit déclencher une erreur, sans repli sur une configuration imprévue. Le guide de lancement Playwright couvre l'installation ; une collecte doit en plus garder assez d'informations pour expliquer un résultat incorrect.
La référence des profils BotBrowser impose la même version majeure au profil et au binaire. Les options CLI remplacent des valeurs du profil ; elles n'ajoutent pas des identités indépendantes. Ne pas ajouter arbitrairement userAgent, fuseau, langues ou descripteur de périphérique copiés d'un exemple générique. Enregistrer tout viewport réellement exigé par l'application. viewport: null désactive l'émulation d'une taille fixe par Playwright, sans affirmer une taille d'écran ni rendre tous les rendus identiques.
L'autorisation, l'environnement compatible et le schéma d'extraction restent trois prérequis. L'exemple vise un catalogue possédé, une liste et au maximum deux fiches, pas une place de marché publique. Cette limite rend le contrat des sélecteurs contrôlable sans crawler illimité ni promesse concernant une protection tierce.
Installer playwright-core dans un projet d'exemple distinct, enregistrer collect.mjs, puis fournir BOTBROWSER_EXEC_PATH, BOT_PROFILE_PATH et OWNED_CATALOG_ORIGIN. L'origine HTTP ou HTTPS appartient à l’application d’exemple contrôlée. Le programme illustre les API documentées ; il ne constitue pas un compte rendu d'exécution de BotBrowser.
L’application d’exemple conserve l'instrumentation d'automatisation par défaut de Playwright. Elle ne teste ni ne revendique aucun résultat relatif aux signaux d'automatisation.
Extraire une liste et ses fiches
La page /catalog de l’application d’exemple contient des liens data-testid="item-link". Chaque fiche contient un unique data-testid="item-name" et un unique data-testid="item-price" avec data-currency. Un lien peut viser /items/a1 et son prix être <span data-testid="item-price" data-currency="USD">12.50</span>. Ces valeurs sont des entrées d'exemple, pas des sorties observées. Un autre balisage demande d'autres sélecteurs.
import { chromium } from 'playwright-core';
import { access, writeFile } from 'node:fs/promises';
import { constants } from 'node:fs';
import { isAbsolute } from 'node:path';

const executablePath = process.env.BOTBROWSER_EXEC_PATH;
const profilePath = process.env.BOT_PROFILE_PATH;
const origin = new URL(process.env.OWNED_CATALOG_ORIGIN);
if (!['http:', 'https:'].includes(origin.protocol)) {
  throw new Error('Fixture origin must use HTTP or HTTPS');
}
if (origin.username || origin.password || origin.search || origin.hash || origin.pathname !== '/') {
  throw new Error('Supply an origin without credentials, path, query or fragment');
}
const safeUrl = value => {
  const url = new URL(value);
  return url.origin + url.pathname;
};
for (const value of [executablePath, profilePath]) {
  if (!value || !isAbsolute(value)) throw new Error('Absolute paths required');
}
await access(executablePath, constants.X_OK);
await access(profilePath, constants.R_OK);

const browser = await chromium.launch({
  executablePath,
  headless: true,
  args: [`--bot-profile=${profilePath}`],
});
const records = [];
const diagnostics = [];
try {
  const context = await browser.newContext({ viewport: null });
  context.setDefaultTimeout(10000);
  const page = await context.newPage();
  async function open(url) {
    const response = await page.goto(url, {
      waitUntil: 'domcontentloaded',
      timeout: 30000,
    });
    const status = response?.status() ?? null;
    const finalUrl = new URL(page.url());
    diagnostics.push({ url: safeUrl(url), finalUrl: safeUrl(finalUrl), status });
    if (status === null || status < 200 || status >= 300) {
      throw new Error(`Unaccepted navigation status: ${status}`);
    }
    if (finalUrl.origin !== origin.origin) {
      throw new Error('Navigation left the fixture origin');
    }
  }
  await open(new URL('/catalog', origin).href);
  const links = page.getByTestId('item-link');
  await page.waitForFunction(() => document.querySelectorAll('[data-testid="item-link"]').length === 2);
  const hrefs = await links.evaluateAll(nodes => nodes.map(node => node.getAttribute('href')));
  const urls = [...new Set(hrefs.filter(Boolean).map(href => new URL(href, page.url()).href))].filter(
    url => new URL(url).origin === origin.origin
  );
  if (urls.length !== 2) throw new Error('Fixture requires two same-origin detail links');
  for (const url of urls) {
    await open(url);
    const name = page.getByTestId('item-name');
    const price = page.getByTestId('item-price');
    await name.waitFor({ state: 'visible' });
    await price.waitFor({ state: 'visible' });
    if ((await name.count()) !== 1 || (await price.count()) !== 1) {
      throw new Error('Detail selector is not unique');
    }
    const label = (await name.innerText()).trim();
    const amount = (await price.innerText()).trim();
    const currency = await price.getAttribute('data-currency');
    if (!label || !/^\d+\.\d{2}$/.test(amount) || !/^[A-Z]{3}$/.test(currency ?? '')) {
      throw new Error('Detail record does not match the fixture schema');
    }
    if (new URL(page.url()).origin !== origin.origin) {
      throw new Error('Detail origin changed during extraction');
    }
    records.push({ url: safeUrl(page.url()), name: label, amount, currency });
  }
  await writeFile(
    'catalog-result.json',
    JSON.stringify(
      {
        browserVersion: browser.version(),
        collectedAt: new Date().toISOString(),
        records,
        diagnostics,
      },
      null,
      2
    ),
    { flag: 'wx', mode: 0o600 }
  );
  await context.close();
} finally {
  await browser.close();
}
La documentation des locators distingue le localisateur d'une référence DOM conservée. Il résout les éléments au moment de l'utilisation, ce qui aide lors du remplacement de nœuds, mais ne connaît pas le bon enregistrement commercial. Le programme attend donc les éléments, exige leur unicité et vérifie le format avant ajout. domcontentloaded marque un événement de navigation, pas la fin du chargement asynchrone du catalogue.
L’application d’exemple attend précisément deux liens ; le programme attend ce compte et refuse moins de deux URL de fiches distinctes de même origine. Une application aux résultats progressifs doit fournir un marqueur de fin ou une réponse API stable définie par son équipe. evaluateAll() n'attend pas le nombre définitif d'éléments : sans signal métier, une seule ligne valide peut être extraite d'une liste qui en contiendra vingt.
Le filtre de même origine borne les liens sélectionnés. Le contrôle après navigation refuse une redirection, et celui avant acceptation refuse un changement d'origine pendant la lecture ; les requêtes ont toutefois déjà eu lieu. Ce n'est pas un pare-feu : images, scripts et frames peuvent contacter d'autres hôtes. Les exigences strictes de sortie réseau doivent aussi être imposées par l'infrastructure, pas rétroactivement par le code.
Le montant reste une chaîne correspondant au format décimal de l’application d’exemple. Les prix réels peuvent employer virgules, séparateurs de milliers, taxes, intervalles d'abonnement et symboles de monnaie ambigus. parseFloat() ne remplace pas le schéma. Définir le format par source et rejeter l'ambiguïté plutôt que convertir le premier préfixe numérique.
Choisir ce qui persiste entre les exécutions
Profil, stockage et résultats n'ont pas le même rôle. L'analyse du cycle de vie des contextes décrit l'isolation des cookies et autres données dans un processus. Un contexte ne fournit ni autre IP publique, ni autre compte, ni preuve que deux requêtes sont impossibles à relier. Deux contextes peuvent partager les paramètres de profil et séparer leurs cookies.
| Composant | Contenu | Ce qu'il ne prouve pas |
|---|---|---|
--bot-profile | Configuration fournie par le paquet | Session authentifiée sur le site |
BrowserContext | État isolé pendant sa durée de vie | Nouvelle IP proxy ou autorisation de collecte |
storageState | Cookies et stockage d'origine pris en charge | Tout état temporaire d'un onglet |
userDataDir | Répertoire persistant du navigateur | Sécurité de plusieurs processus écrivains simultanés |
| JSON de résultat | Données et diagnostics sélectionnés | Identifiants nécessaires pour reprendre la session |
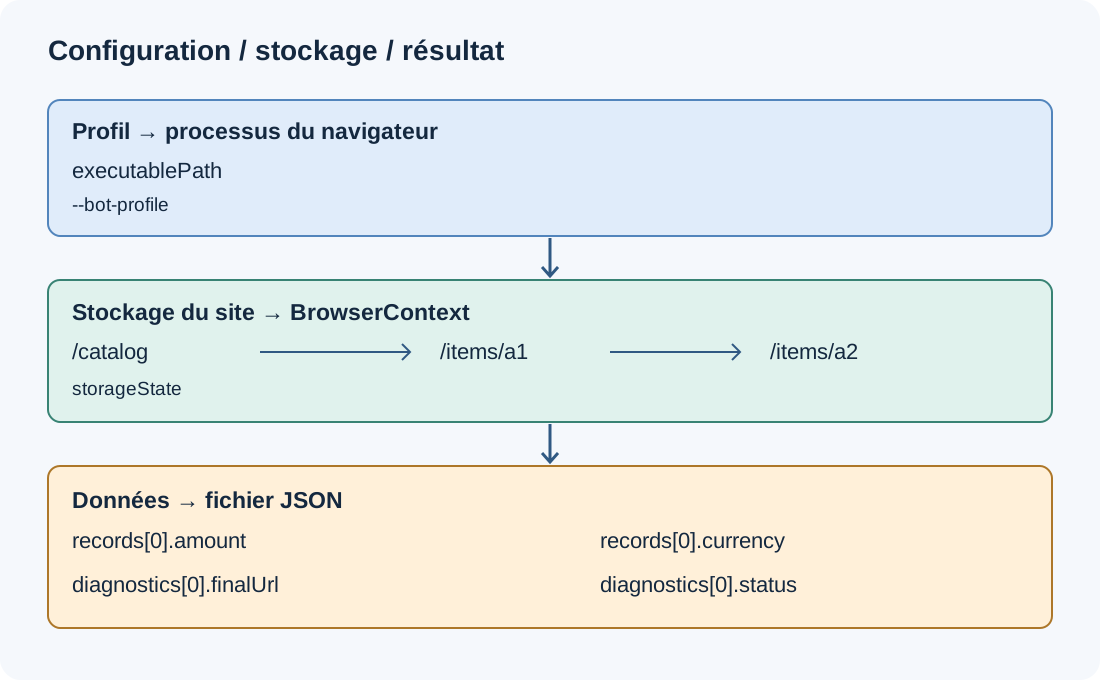
Réutiliser un contexte et une page pour la liste et ses fiches conserve les cookies entre navigations et simplifie le périmètre. Un contexte neuf par fiche peut perdre la session légitime créée sur la liste. Un contexte partagé entre comptes distincts risque au contraire de mélanger leurs états. Définir d'abord la frontière de compte et de session, puis le nombre de pages.
Un contexte non persistant offre un stockage propre à chaque exécution et le perd à sa fermeture. Playwright sait sauvegarder et restaurer storageState pour une connexion autorisée. La documentation d'authentification avertit que ces fichiers peuvent contenir des secrets permettant d'utiliser le compte. Les exclure du contrôle de versions et des exports ordinaires ; limiter accès, conservation et association au compte.
Tout n'est pas inclus automatiquement. La documentation actuelle permet la capture IndexedDB avec indexedDB: true ; vérifier la version épinglée. Le stockage de session nécessite un traitement propre à l'application. Un cookie restauré peut être expiré ou invalidé côté serveur : lire correctement un fichier ne prouve pas une session valide.
Pour une charge qui exige délibérément un répertoire complet, launchPersistentContext() renvoie un contexte utilisant userDataDir. Ce répertoire n'est pas le fichier .enc transmis à --bot-profile. Ne pas partager un répertoire écrivable entre instances : attribuer un répertoire à chaque propriétaire concurrent et respecter les verrous normaux plutôt que forcer le passage.
Distinguer données et échec dans le résultat
Le résultat est écrit seulement lorsque toutes les fiches choisies sont validées. Un échec après la première n'est donc pas présenté comme un lot complet de deux. flag: 'wx' refuse l'écrasement d'un fichier existant. Un ordonnanceur réel doit donner à chaque exécution un identifiant et un répertoire propres, et distinguer succès, lots partiels et tentatives échouées dans son manifeste.
La date est celle de collecte, pas de modification du produit. browserVersion est la version renvoyée par le navigateur connecté, pas l'identité du fichier exécutable. Le profil peut administrer des valeurs accessibles au JavaScript ; navigator.userAgent n'authentifie pas le binaire lancé. Garder chemin résolu, révision du lockfile et empreinte du profil dans des métadonnées restreintes, hors du catalogue public.
URL demandée et URL finale expliquent les redirections vers consentement, connexion ou produit retiré, parfois avec HTTP 200. Les sélecteurs et le schéma sont donc des conditions d'acceptation. Une réponse HTTP réussie et une donnée métier valide exigent des états distincts pour les futures reprises.
La couche navigateur du web scraping concerne l'environnement observable, pas la validité du sélecteur de prix. Refonte graphique, autorisation manquante et erreur de lancement peuvent tous produire un résultat vide ; changer le profil ne répare pas les deux premiers. Séparer erreurs d'extraction et preuves d'environnement.
Ne pas partager par défaut en-têtes complets, cookies et URL authentifiées non expurgées. Le programme refuse les identifiants dans l'origine et retire chaînes de requête et fragments des URL enregistrées. Un chemin peut néanmoins porter un secret : réserver ce application d’exemple aux chemins de catalogue publics et examiner les champs avant partage. Expurger la copie partagée tout en conservant les preuves restreintes approuvées nécessaires à l'identification du travail autorisé.
Diagnostiquer la couche défaillante
| Observation | Premier contrôle | Réponse adaptée |
|---|---|---|
| Aucun navigateur ne démarre | Chemin, droits, dépendances | Corriger installation ou montage |
| Échec de création du contexte | Compatibilité des versions | Reproduire avec une combinaison documentée |
| HTTP 401 ou 403 | Autorisation et réponse serveur | Arrêter et résoudre l'accès avec le propriétaire |
| HTTP 429 | Limite et Retry-After, si présent | Attendre selon la politique du service |
| HTTP 200 sans éléments | URL finale, connexion, marqueur de fin | Classer la page avant de changer les sélecteurs |
| Prix invalide | Schéma et format local | Rejeter sans deviner de conversion |
| Déconnexion au prochain passage | Politique de contexte et expiration | Restaurer un état approuvé ou se reconnecter normalement |
Conserver l'observation qui distingue les causes : catégorie d'URL, statut disponible et type d'exception pour la navigation ; champ du schéma et route atteinte pour les sélecteurs. Un catch qui écrit un tableau vide efface la différence entre refus d'accès et catalogue réellement vide.
Ne pas relancer aveuglément tout le programme. Un dépassement du délai d’attente peut venir d'une application lente, une interdiction exige une décision d'accès et un prix mal formé ne sera pas corrigé par dix navigations identiques. Séparer pannes de transport réessayables, décisions d'autorisation et erreurs déterministes. Appliquer les limites publiées et l'accord de collecte ; BotBrowser ne décide pas si une relance convient au site.
L'exemple n'a ni rotation de proxy, ni crawl parallèle, ni traitement des défis. Ces fonctions changeraient les contrats de session et de trafic, sans être nécessaires au catalogue possédé. Définir propriété des comptes, volume autorisé, exhaustivité et reprise avant extension. Deux données correctes vérifient un schéma, pas la sécurité ou la fiabilité d'un grand crawl.
Questions fréquentes
playwright-core suffit-il pour choisir BotBrowser ?
Seulement si le lancement fournit le bon executablePath. Le paquet expose l'API ; il ne découvre pas BotBrowser ni le fichier .enc. Transmettre le profil à un autre navigateur ne le transforme pas en BotBrowser. Refuser les chemins absents et conserver la version du paquet pour le diagnostic.
Un contexte neuf rend-il deux collectes impossibles à relier ?
Non. Il sépare le stockage ; le serveur peut toujours observer réseau, compte, rythme de requêtes et propriétés du navigateur. C'est une isolation d'application, pas une garantie d'anonymat. Elle évite le mélange d'états sans autoriser le dépassement des limites du site.
Faut-il attendre networkidle plutôt qu'un sélecteur ?
Le silence réseau n'est pas la condition métier. Les données peuvent être prêtes pendant de l'analytique ou du polling ; une page d'erreur peut être silencieuse. Utiliser le signal de fin de l'application puis valider les champs. L’application d’exemple exige les liens présents et des éléments de détail visibles et uniques ; une autre application a besoin de son contrat.
Sources
- Playwright : BrowserType
- Playwright : contextes
- Playwright : locators
- Playwright : authentification et état
- BotBrowser : intégration Playwright
- BotBrowser : profils
Conclusion pratique
Choisir l'exécutable et un profil compatible, puis garder la session autorisée dans un contexte entre liste et fiches. N'accepter les données qu'après contrôle de navigation, d'origine et de schéma. Cookies, profil et export sont trois décisions distinctes de sécurité et de conservation.
Commencer par un catalogue possédé avec deux fiches et le schéma documenté. Adapter les sélecteurs avant d'augmenter le trafic et conserver un échec explicite plutôt qu'un résultat vide apparemment réussi.
Cet article fait partie du guide : Débuter avec l'automatisation du navigateur : carte initiale
Articles Connexes
Scraping avec Puppeteer : options et observations
DémarragePuppeteer + BotBrowser : pièges de lancement et de profil
DémarrageScraping avec Selenium : capacités et relevés
DéploiementPlaywright MCP : lancer un build Chromium personnalisé
DémarrageCycle de vie et état de stockage de BrowserContext avec Playwright
DémarragePlaywright avec des profils d'identité cohérents
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.