Scraping d’offres d’emploi : limites du navigateur
Planifiez la collecte d’annonces publiques avec JobPosting, pagination, état de session et une limite claire aux données authentifiées.
BotBrowser Team
Vous voulez la documentation structurée pour Déploiement ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
Le scraping d’offres d’emploi est surtout un problème de pagination et d’intégrité des enregistrements, et la couche navigateur n’en couvre qu’une partie. La frontière qui compte est la classe d’accès : une page d’annonces publique peut être demandée dans le cadre de l’autorisation d’un opérateur, tandis qu’un profil de candidat, un historique de candidatures, une boîte de recruteur ou une page de compte de recherche enregistrée relèvent de données privées hors de cette charge de travail. BotBrowser fournit un environnement de navigateur configurable qui démarre à partir d’une configuration de l’opérateur et renvoie le résultat de page visible, mais il ne peut pas accorder d’autorisation, décider si les conditions d’un site permettent la collecte, ni supprimer une barrière d’authentification, de consentement ou de limitation de débit. La collecte décrite ici porte uniquement sur les annonces publiques.
TL;DR
- Traitez chaque site d’offres d’emploi comme trois sources d’enregistrements : les cartes d’annonce, les pages de détail et le JSON-LD
JobPosting. Fusionnez-les en un seul enregistrement avec un ordre de priorité explicite. - Définissez la disponibilité de la page comme un conteneur de résultats visible accompagné d’un nombre de cartes stable, et non comme une pause fixe ou un événement réseau inactif global.
- Transportez
job_id,canonical_url,datePosted,validThrough,hiringOrganizationetjobLocationdès la première observation au lieu de les reconstituer plus tard. - Classez chaque URL comme annonce publique ou donnée authentifiée avant la première requête ; arrêtez l’exécution dès qu’une réponse franchit la seconde classe.
- Rattachez un 429, une règle
robots.txt, un interstitiel de consentement et un 401 à des couches différentes. Aucun d’entre eux ne prouve que le navigateur a besoin d’un autre profil.
Sommaire
- Associer la charge des annonces aux tâches du navigateur
- Tracer la frontière entre accès public et accès authentifié
- Mesurer la complétude et attribuer les échecs
Associer la charge des annonces aux tâches du navigateur
Une exécution sur un site d’offres d’emploi part d’une URL de requête telle que https://jobs.example.com/jobs?q=analyst&p=1, suit les liens de pagination fournis par le site et ouvre une page de détail par annonce. Avec 40 cartes par page et 12 pages d’annonces, le plafond attendu est de 480 pages de détail, mais le navigateur ne décide jamais de ce nombre. L’opérateur fixe la requête, la plage de pages autorisée et la règle d’arrêt ; le navigateur crée un contexte, navigue, attend le signal convenu et lit la page qu’il a reçue.
Répartir les responsabilités évite une conclusion fausse fréquente. Un ordonnanceur gère les nouvelles tentatives, l’ordre de la file et la concurrence. Le stockage gère la normalisation et la déduplication. Le navigateur gère la navigation, le rendu, la disponibilité et l’extraction de ce que la page expose. Lorsqu’une page de détail renvoie une carte sans titre, le champ manquant est un problème d’extraction ou de balisage tant qu’un code de statut ou un interstitiel ne prouve pas le contraire.
Les pages d’offres d’emploi sont particulièrement répétitives : un seul gabarit sert des milliers d’annonces, les filtres vivent dans la chaîne de requête et la mise en page de détail change rarement d’un poste à l’autre. Le coût par page est donc dominé par la navigation, l’attente de disponibilité et le travail d’analyse plutôt que par l’apprentissage d’une nouvelle mise en page à chaque fois. Cette forme récompense un contrat de sélecteurs fixe et un contrat de champs fixe, et pénalise les sélecteurs ad hoc écrits pour chaque annonce.
La même arithmétique entre pages de liste et pages de détail apparaît dans la planification de charge pour le scraping SERP, qui sépare les étapes du navigateur de l’attente des réponses avant de choisir une cible de collecte.
Lire l’annonce structurée avant la carte visible
De nombreux sites publient un balisage Schema.org JobPosting sous forme de JSON-LD. Le nœud se trouve généralement dans un bloc <script type="application/ld+json">, parfois à l’intérieur d’un tableau @graph, et parfois réparti sur plusieurs blocs d’une même page. Lisez chaque bloc, conservez les échecs d’analyse comme un champ compté et sélectionnez les nœuds dont @type vaut JobPosting ou dont le tableau contient cette valeur.
| Champ | Forme typique | Stockage | Échec à consigner |
|---|---|---|---|
@type | "JobPosting" ou un tableau | node_type | La page a des cartes mais aucun nœud d’annonce |
datePosted | Date ISO 8601 telle que 2026-11-03 | date_posted | Seulement un texte relatif tel que « il y a 3 jours » |
validThrough | Date ou date-heure ISO 8601 | valid_through | Champ absent sur les postes permanents |
hiringOrganization.name | chaîne Organization.name | employer_name | Employeur affiché comme « Confidentiel » |
jobLocation.address.addressLocality | PostalAddress imbriqué | location_city | Poste à distance sans adresse |
identifier | Chaîne ou PropertyValue | source_job_id | Identifiant qui change entre deux rendus |
Le même champ peut apparaître à trois endroits avec des valeurs différentes : la carte d’annonce, le DOM de détail et le nœud JSON-LD. Enregistrez la source qui a fourni chaque champ au lieu de laisser une passe ultérieure écraser silencieusement une valeur antérieure. Un ordre de priorité applicable est : données structurées d’abord, état de page intégré ensuite, DOM visible en dernier, avec la source retenue stockée dans field_source.
const raw = await page.locator('script[type="application/ld+json"]').allTextContents();
const errors = [];
const nodes = raw.flatMap(text => {
  try {
    const doc = JSON.parse(text);
    return Array.isArray(doc['@graph']) ? doc['@graph'] : [doc];
  } catch (error) {
    errors.push(String(error));
    return [];
  }
});
const postings = nodes.filter(node => [].concat(node['@type'] ?? []).includes('JobPosting'));
Cet extrait renvoie les nœuds d’annonce et laisse les erreurs d’analyse visibles. Il ne suppose pas que le site publie des données structurées ; un site qui rend uniquement des cartes a toujours besoin du contrat DOM, et un site qui injecte le balisage après le premier rendu a toujours besoin de la règle de disponibilité ci-dessous.
Définir la pagination à partir de la page, pas d’une URL devinée
Les sites expriment la pagination d’au moins cinq façons, et cette différence change la manière dont une exécution détecte la fin. Enregistrez l’URL qui a produit chaque page, son index et le lien suivant que la page annonce elle-même.
| Forme | Exemple | Détection | Risque principal |
|---|---|---|---|
| Numéro de page | ?page=2 | Paramètre de requête | Le site plafonne ou ignore les pages profondes |
| Numéro court | ?p=2 | Paramètre de requête | Un même nom de paramètre signifie autre chose sur un autre site |
| Décalage | ?start=25 | Paramètre de requête avec taille de page | Décalage calculé avec une mauvaise taille de page |
| Curseur | ?after=eyJpZCI6MTg0Mn0 | Jeton opaque de la page précédente | Réutilisation d’un curseur périmé |
| Relation de lien | <link rel="next" href="..."> | Attribut DOM | Absent sur certains gabarits |
Arrêtez-vous lorsque la page n’annonce aucun lien suivant, lorsque le conteneur de résultats est présent mais vide, lorsque les clés de la première et de la dernière carte répètent une page antérieure, ou lorsque l’ensemble des URL visitées contient déjà la cible suivante. Traitez un nombre de pages lu dans un composant « 1 sur 12 » comme un indice, et non comme une garantie : un changement de filtre, une personnalisation ou une annonce expirée peut déplacer le total entre deux requêtes.
Deux garde-fous appartiennent à la boucle dès la première exécution. Conservez un ensemble d’URL de page normalisées et refusez une répétition. Conservez une signature construite à partir des clés de la première et de la dernière carte de chaque page ; des signatures identiques sur des pages consécutives signifient généralement que le site a bloqué le numéro de page au lieu de renvoyer de nouveaux résultats.
Fixer une condition de disponibilité alignée sur l’extraction
Un événement de navigation prouve qu’un document est arrivé, pas que la liste est exploitable. DOMContentLoaded peut se déclencher avant le rendu des cartes, et une attente réseau globalement inactive peut rester bloquée sur des publicités, de l’analyse d’audience ou une requête longue. Utilisez une condition liée aux éléments que l’extracteur lit.
| Signal de disponibilité | Ce qu’il prouve | Ce qu’il manque |
|---|---|---|
Événement domcontentloaded | HTML analysé | Cartes rendues côté client |
| Conteneur de liste visible | Gabarit monté | Cartes encore en cours d’arrivée |
| Nombre de cartes stable sur deux vérifications | Liste stabilisée | Injection tardive du JSON-LD |
Nœud JobPosting présent | Données structurées de détail analysées | Sites sans balisage |
| Contrôle suivant activé | Pagination interactive | Plafonnement de page côté serveur |
La règle pratique est une conjonction : le conteneur de résultats est visible, le nombre de cartes égale celui annoncé par la page et chaque carte possède un lien de détail non vide. Pour une page de détail, ajoutez soit un nœud JobPosting analysé, soit un marqueur explicite « aucune donnée structurée » avant le début de l’extraction. Enregistrez l’horodatage de l’événement de disponibilité séparément du début de la requête afin qu’une revue ultérieure puisse calculer l’attente.
L’état de session relève du même contrat. Certains sites gardent les filtres dans l’URL et renvoient la même liste à un contexte neuf. D’autres conservent l’ordre de tri, le rayon géographique ou un curseur de page dans des cookies ou le stockage local, si bien qu’un nouveau contexte repart à la page un alors que l’URL indique toujours la page huit. Décidez quel comportement s’applique, puis réutilisez un contexte pour une exécution ou reconstruisez l’état des filtres à partir de l’URL. Un contexte dédié par exécution empêche aussi le stockage de fuir entre des travaux de collecte sans rapport ; l’isolation navigateur multi-comptes explique comment le stockage et les réglages d’identité par contexte sont séparés lorsque plusieurs charges de travail autorisées partagent un même hôte.
Si une exécution perd sa route au milieu de la pagination, ne redémarrez pas toute l’exploration. Le guide sur la reprise de session après une interruption réseau décrit comment distinguer une connexion interrompue d’une page expirée et comment reprendre sans dupliquer les pages terminées.
Tracer la frontière entre accès public et accès authentifié
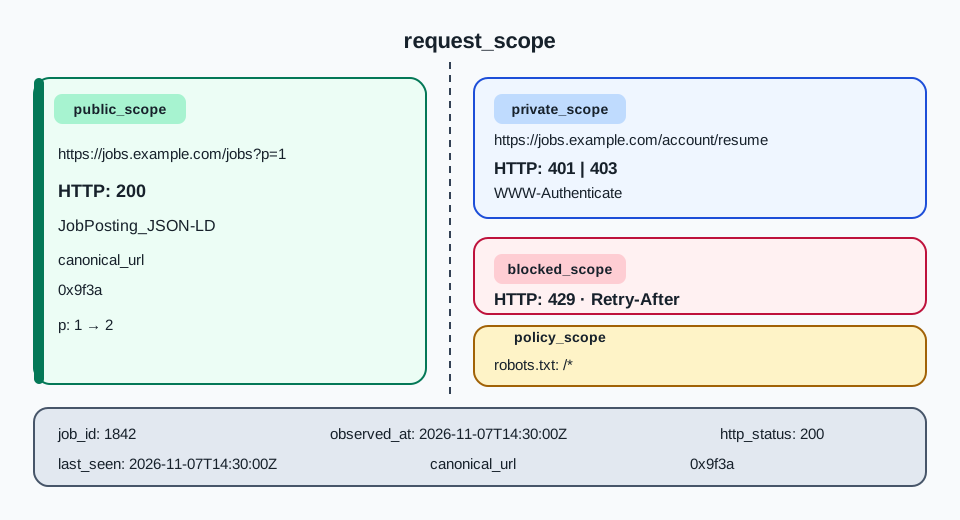
La classe d’accès d’une URL est une propriété du site et de l’autorisation de l’opérateur, pas de la version du navigateur. Un résultat de recherche public, une page de détail publique et une page carrière d’entreprise servie sans session appartiennent à une même classe. Un profil de candidat, une page de statut de candidature, un fil de messages de recruteur, une recherche enregistrée liée à un compte et un formulaire de candidature qui accepte un CV appartiennent à une autre. Cette charge de travail ne demande que la première classe.
Cette frontière des données publiques est celle que la protection des empreintes pour la collecte de données web maintient dans son périmètre : les signaux du navigateur peuvent devenir répétables pour un flux autorisé, mais ils ne transforment pas une page authentifiée en données publiques.
| Classe d’URL ou de réponse | Chemin d’exemple | Réponse attendue | Dans le périmètre | Action |
|---|---|---|---|---|
| Recherche publique | /jobs?q=analyst&p=2 | 200 avec des cartes de résultats | Oui | Demander dans la plage de pages convenue |
| Détail public | /jobs/1842 | 200 avec le balisage de l’annonce | Oui | Extraire et enregistrer |
| Page d’entreprise publique | /careers/acme | 200 sans session | Oui, si autorisé | Traiter comme une autre source d’annonces |
| Formulaire de connexion | /login | 200 avec un formulaire de connexion | Non | Exclure le chemin |
| Profil de candidat | /account/profile | 401 ou 403, ou 200 uniquement avec une session | Non | Arrêter et exclure |
| Historique des candidatures | /account/applications | 200 limité à la session | Non | Arrêter et exclure |
| Boîte de recruteur | /employer/messages | 200 limité à la session | Non | Arrêter et exclure |
| Dépôt de CV | /apply/1842/upload | Formulaire acceptant des fichiers personnels | Non | Arrêter et exclure |
Appliquez le tableau avant la première navigation. Une liste d’autorisation d’URL est plus facile à auditer qu’une liste de blocage, car une nouvelle route de compte ajoutée par le site ne peut pas entrer silencieusement dans l’exécution. Chaque entrée doit porter la référence d’approbation de l’opérateur, la date de vérification et la classe de page attribuée.
Règles de reconnaissance d’une frontière d’authentification
Le signal le plus clair est un HTTP 401 accompagné d’un en-tête WWW-Authenticate, mais les sites réels redirigent aussi vers /login, renvoient 403 sur une route protégée ou servent une page 200 dont le seul contenu est une invitation à se connecter. Un élément de navigation réservé aux candidats, un avatar de compte ou un contrôle « postuler » qui ouvre un formulaire de CV reste un marqueur de frontière même lorsque le statut est 200.
Lorsque l’un de ces signes apparaît, arrêtez cette URL, enregistrez la classe comme authenticated et retirez-la du dénominateur de complétude des annonces publiques. Ne fournissez jamais d’identifiants, ne rejouez pas un cookie copié depuis la session d’une personne, ne complétez pas de challenge et ne poursuivez pas à travers une page qui demande des données de candidat. La sortie correcte est une exclusion motivée, pas un enregistrement partiellement rempli.
Consentement, robots et limites de débit sont des barrières distinctes
Un interstitiel de consentement est une barrière de politique. La bannière peut masquer l’annonce jusqu’à ce qu’un choix soit fait, et les choix disponibles peuvent varier selon la région et selon qu’une session existe déjà. Enregistrez consent_state comme present, required ou absent, capturez l’URL et transmettez la décision à l’opérateur. Automatiser un clic d’acceptation ne fait pas partie d’un plan d’extraction d’annonces publiques, car le choix appartient au visiteur, pas au collecteur.
Le Robots Exclusion Protocol définit la manière dont un site publie ses règles d’exploration, y compris les groupes sélectionnés par jeton d’agent utilisateur. Récupérez robots.txt, enregistrez le statut de la réponse et la règle qui s’applique au client déclaré, puis excluez un chemin interdit. Choisir un autre jeton d’agent utilisateur pour tomber dans un groupe plus permissif est un contournement de politique, pas une exigence du navigateur.
Une réponse 429 avec Retry-After est une limite de débit, définie avec les autres sémantiques de statut dans la RFC 9110. Respectez la fenêtre, réduisez le périmètre demandé ou demandez une API au propriétaire du site. Faire tourner des routes ou des profils pour continuer à demander pendant la fenêtre change le destinataire de la requête, pas son autorisation. Un 503 est une condition de service ; traitez-le comme un échec de disponibilité et ne réessayez que selon la politique convenue avec l’opérateur.
Matrice d’attribution des échecs
La matrice ci-dessous évite qu’une réponse bloquée soit lue comme un défaut du navigateur. Chaque ligne nomme la couche qui a produit l’observation et l’action suivante autorisée.
| Observation | Couche responsable | Ce qu’elle ne prouve pas | Action suivante |
|---|---|---|---|
200 mais aucune carte dans le conteneur | Rendu, contrat de sélecteurs ou résultat vide | Que le site a bloqué le navigateur | Vérifier la disponibilité, le sélecteur et l’état de la requête ; enregistrer empty_result |
200 avec une boîte de dialogue de consentement | Politique de consentement | Que la page est indisponible | Enregistrer consent_gate et attendre une décision de l’opérateur |
401 avec WWW-Authenticate | Authentification | Qu’un autre profil serait autorisé | Exclure l’URL |
403 sur une route de candidat | Autorisation | Que la route est publique mais mal configurée | Exclure l’URL |
Redirection vers /login | Authentification | Un problème de réseau ou de langue | Exclure l’URL |
429 avec Retry-After | Limitation de débit | Que l’identité du navigateur est erronée | Respecter la fenêtre ou réduire le périmètre |
Chemin listé dans robots.txt | Politique d’exploration du site | Que le HTML est cassé | Exclure le chemin |
| Page de challenge au lieu des résultats | Contrôle d’accès | Qu’une option de rendu va la supprimer | Arrêter ; ne pas automatiser le challenge |
| Délai de navigation dépassé | Réseau, hôte ou poids de la page | Que le site a refusé la requête | Enregistrer l’étape et revérifier la route |
200 avec moins d’une page de résultats | Fin de pagination ou filtre restrictif | Que l’exécution a couvert la requête | Comparer la signature de la première page et la requête |
Un profil de navigateur, une route proxy ou une autre langue change ce qu’un serveur observe. Aucun de ces changements ne crée d’autorisation, ne satisfait une règle robots, n’accepte un choix de consentement au nom d’un visiteur ni ne transforme un 403 en autorisation. Une collecte est permise par le propriétaire du site, les conditions applicables et la loi, et la couche navigateur peut seulement rester à l’intérieur ou à l’extérieur de cette décision.
Le routage réseau est une surface de configuration distincte. Le guide sur la configuration du proxy du navigateur couvre la sélection de route, la gestion des identifiants et le comportement DNS ; il précise aussi qu’une route ne valide pas la politique d’une destination. Utilisez une route que l’opérateur est autorisé à employer et gardez-la fixe pendant la comparaison du comportement d’extraction.
Mesurer la complétude et attribuer les échecs
Une question de mesure utile pour cette charge de travail est : sur un ensemble autorisé d’URL d’annonces publiques, combien d’annonces ont été découvertes, combien de champs obligatoires ont été renseignés et quels échecs provenaient de quelle couche. Cette question a un dénominateur défendable. Un « taux de réussite » mesuré contre une page de connexion ou une réponse limitée en débit n’en a pas.
Figez l’entrée avant la première exécution. Le fixture doit lister les URL de requête, la plage de pages attendue, le contrat de disponibilité et le contrat de sélecteurs. Conservez une référence d’approbation à côté. Si le site change son gabarit, le fixture change comme une nouvelle version au lieu d’être modifié sur place, de sorte que les anciens et les nouveaux résultats restent comparables.
Schéma des enregistrements
Stockez un enregistrement par annonce observée et un enregistrement par page. L’enregistrement de page porte le statut, la chronologie et le nombre. L’enregistrement d’annonce porte l’identité et les sources de champs, comme dans cet exemple avec des valeurs illustratives.
{
  "job_id": "1842",
  "canonical_url": "https://jobs.example.com/jobs/1842",
  "page_url": "https://jobs.example.com/jobs?q=analyst&p=2",
  "http_status": 200,
  "observed_at": "2026-11-07T14:30:00Z",
  "date_posted": "2026-11-03",
  "valid_through": "2026-12-01",
  "employer_name": "Example Analytics",
  "location_city": "Toronto",
  "field_source": "jsonld",
  "etag": "W/\"abc123\"",
  "content_hash": "9f2c1d7a4b8e0c31"
}
Conservez job_id comme identifiant propre au site lorsqu’il est stable. Conservez canonical_url comme l’adresse déclarée par la page, et non l’URL paginée qui y a conduit. Conservez page_url pour qu’un doublon puisse être rattaché à la page d’annonces qui l’a produit. Stockez etag et content_hash pour détecter les pages de détail inchangées et éviter de réécrire des enregistrements identiques.
Fusionner les doublons avec une clé déclarée
La même annonce apparaît souvent sur la page de recherche d’un site, sur une page d’entreprise, sur un miroir régional et chez un agrégateur. Les identifiants d’annonce sont la clé la plus solide lorsqu’ils existent, mais une republication peut recevoir un nouvel identifiant tout en gardant le même employeur, le même intitulé, la même ville et la même description.
| Clé candidate | Stabilité | Risque de collision | Utilisation |
|---|---|---|---|
source_job_id plus l’hôte du site | Élevée tant que l’annonce existe | Même identifiant réutilisé après suppression | Le site publie un identifiant stable |
canonical_url | Élevée | Deux URL pour un même poste | Le lien canonique est présent |
Employeur, intitulé, ville, date_posted | Moyenne | Même poste ouvert deux fois le même jour | Identifiant et URL canonique absents |
| Employeur, intitulé, ville, empreinte de description | Moyenne | Texte de gabarit identique entre équipes | La description est substantielle |
| Intitulé et ville uniquement | Faible | Beaucoup de postes réels partagent un intitulé | Jamais, sauf comme indice de revue |
Fusionnez sur la clé disponible la plus solide, puis conservez les correspondances plus faibles dans variant_urls au lieu de les supprimer. Un enregistrement fusionné doit retenir chaque URL qui y a contribué, les heures de première et de dernière observation, et la source qui a fourni chaque champ.
Matrice de décision sur les doublons
| Situation | Fusionner | Raison |
|---|---|---|
Même canonical_url, page_url différent | Oui | Une annonce atteinte par deux pages de liste |
Même employeur, intitulé, ville et date_posted ; job_id différent | Oui, avec variantes | Probablement le même poste syndiqué deux fois |
| Même employeur et intitulé, ville différente | Non | Le lieu fait partie du poste |
Même employeur, intitulé et ville, date_posted séparés de plus de 30 jours | Non, sauf si l’empreinte de description correspond | Une ouverture ultérieure peut être un véritable nouveau poste |
valid_through dépassé mais la page renvoie encore 200 | Conserver, marquer expired | La page n’a pas été retirée à la date prévue |
| Copie d’agrégateur et page carrière de l’entreprise | Fusionner vers l’enregistrement de l’entreprise lorsque les deux sont autorisés | La page source est la meilleure cible canonique |
| Chaîne de redirections aboutissant à une nouvelle URL canonique | Fusionner et stocker la chaîne | L’ancienne URL n’identifie plus l’annonce |
Plan d’exécution et jalons de chronométrage
Le plan ci-dessous utilise un objet de contrat de site afin que les sélecteurs et la règle de disponibilité soient nommés au même endroit. Les noms sont illustratifs ; remplacez-les par le contrat convenu pour le site autorisé.
const contract = {
  list: "[data-testid='job-card']",
  detailLink: "a[data-testid='job-link']",
  next: "a[rel='next']",
};

const started = performance.now();
const response = await page.goto(listUrl, { waitUntil: 'domcontentloaded' });
await page.locator(contract.list).first().waitFor({ state: 'visible' });
const cards = page.locator(contract.list);
const count = await cards.count();
await page.waitForTimeout(250);
const stabled = await cards.count();
if (count !== stabled) throw new Error('card count changed before extraction');
const links = await cards.locator(contract.detailLink).evaluateAll(nodes => nodes.map(node => node.href));
Enregistrez request_start, response_received, ready_signal et extract_done comme des horodatages distincts. Calculez l’attente de disponibilité comme ready_signal - request_start et le temps d’extraction comme extract_done - ready_signal. Si l’exécution ne rapporte qu’une durée pour la page, un sélecteur lent et un serveur lent deviennent indistinguables. La documentation sur l’optimisation des performances couvre le réglage du runtime pour un déploiement existant ; les jalons ci-dessus décrivent la base à laquelle ce réglage doit être comparé.
Utilisez trois répétitions du même fixture et rapportez le minimum, la médiane et le maximum de chaque étape au lieu de la meilleure exécution. Gardez les pages en échec dans le dénominateur. Une page qui a expiré avant la disponibilité compte comme une page tentée avec un échec d’étape, pas comme une annonce absente.
Complétude et couverture des champs
La complétude compare les annonces découvertes aux annonces annoncées par la requête autorisée. Si la première page indique 480 résultats à 40 par page et que l’exécution extrait 462 annonces uniques après fusion, rapportez 462 / 480 avec le nombre de doublons et le nombre d’exclusions. N’augmentez pas silencieusement le numérateur en fusionnant des postes sans rapport et ne réduisez pas le dénominateur en retirant les pages en échec.
La couverture des champs est un ratio distinct par champ. Rapportez date_posted présent dans 440 des 462 enregistrements, valid_through dans 301 et jobLocation dans 455. Un site peut avoir une pagination complète et une faible couverture de champs, ou l’inverse. Les deux nombres répondent à des questions différentes, et un chiffre unique de « réussite » masque lequel a échoué.
Matrice de décision sur l’attribution
| Schéma dans l’enregistrement | Interprétation à vérifier | Mesure suivante |
|---|---|---|
| Cartes présentes, JSON-LD absent sur chaque page de détail | Le site ne publie peut-être pas de balisage | Confirmer sur une seconde version de gabarit avant de changer l’extraction |
Attente de disponibilité croissante alors que le statut reste 200 | Rendu client ou poids des scripts modifié | Comparer les horodatages de disponibilité à version de fixture identique |
Pages 200 moins nombreuses sans changement de requête | Plafond de pagination ou état de filtre | Revérifier la première page et la chaîne de liens suivants |
429 seulement à une concurrence plus élevée | Débit de requêtes au-delà de la limite du site | Réduire la concurrence ou demander une API |
403 seulement sur des chemins de compte | Frontière d’authentification atteinte | Exclure le chemin et revoir la liste d’autorisation |
| Taux de doublons en hausse après un changement de gabarit | Nouveau modèle d’URL ou d’identifiant | Comparer les clés de fusion entre versions |
| Couverture de champs en baisse mais nombre de cartes stable | Dérive du balisage ou des sélecteurs | Comparer field_source champ par champ |
Liste de vérification avant exécution
- Chaque URL de départ est une annonce publique ou une page de détail publique, avec une référence d’approbation.
- Les routes de compte, de candidature, de CV, de message et de recherche enregistrée sont exclues par liste d’autorisation.
-
robots.txta été récupéré et la règle applicable enregistrée. - La condition de disponibilité est écrite comme un élément visible plus un nombre stable.
- La règle d’arrêt de pagination inclut les URL visitées et une signature de page répétée.
- La clé de fusion et les clés de repli plus faibles sont déclarées avant l’extraction.
- Le statut, la chronologie et le nombre au niveau de la page sont stockés à côté des enregistrements d’annonce.
- Les pages en échec et exclues restent dans le dénominateur avec un code de motif.
- L’exécution s’arrête sur un
401, un403, une barrière de consentement, une page de challenge ou un429. - L’enregistrement d’exécution nomme la version du navigateur, la route utilisée et la version du fixture.
FAQ
Le JSON-LD JobPosting suffit-il à identifier chaque annonce ?
Non. La couverture varie selon le site et le gabarit, et certaines pages rendent les cartes depuis un objet d’état interne sans aucun bloc de données structurées. Utilisez le JSON-LD comme source préférée, gardez un contrat DOM comme repli et stockez field_source pour qu’une baisse de couverture reste visible. Une page avec des cartes et aucun nœud d’annonce est une observation de balisage, pas un échec d’accès.
La pagination doit-elle s’arrêter à la première page vide ?
Arrêtez-vous, puis vérifiez. Un conteneur vide peut signifier que la requête est épuisée, qu’un filtre a réduit l’ensemble ou que le numéro de page a été plafonné. Comparez la signature de page, le total annoncé et le lien suivant avant d’enregistrer l’exécution comme terminée. Une seule page vide est une condition d’arrêt des requêtes, pas la preuve que la requête n’a rien renvoyé.
Un profil de navigateur décide-t-il si la collecte est autorisée ?
Non. L’autorisation vient du propriétaire du site, des conditions applicables et de la loi. Un profil modifie les signaux observables du navigateur et un proxy modifie la route, mais ni l’un ni l’autre ne satisfait une règle robots, un choix de consentement ou une limite de débit. Le tableau des classes d’accès et la matrice des échecs constituent la surface de décision ; la configuration du navigateur se situe en aval de cette décision.
Conclusion pratique
Commencez par classer chaque URL comme annonce publique ou donnée authentifiée, et retirez la seconde classe avant toute requête. Définissez ensuite le signal de disponibilité, la règle d’arrêt de pagination et la clé de fusion comme un seul contrat écrit. Mesurez séparément la complétude et la couverture des champs, et rattachez chaque échec à la couche de statut, de politique ou de rendu qui l’a produit.
L’action suivante est limitée : rédiger la liste d’autorisation et la référence d’approbation pour une requête publique autorisée sur un site d’offres d’emploi, puis confirmer que la première page renvoie 200 avec soit un nœud JobPosting, soit le contrat DOM convenu. Tout le reste de l’exécution dépend du maintien de cette frontière.
Sources
Cet article fait partie du guide : Déploiement et livraison du navigateur : carte opérationnelle
Articles Connexes
Scraping SERP à grande échelle : exigences navigateur
DéploiementProfils de navigateur pour le monitoring SEO et le suivi SERP
DéploiementProtection des empreintes du navigateur pour la collecte web
DéploiementCaptures fiables avec un navigateur headless
DéploiementAdapter la charge avec les profils Per-Context
RéseauSurveillance des prix e-commerce : la couche navigateur
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.