Web crawler vs web scraper : résultats et erreurs
Distinguez la découverte des URL de l’extraction des champs et séparez pages manquantes et données incomplètes avant de choisir un navigateur.
BotBrowser Team
Vous voulez la documentation structurée pour Démarrage ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
Web crawler vs web scraper distingue deux résultats : un ensemble délimité de récupérations et les enregistrements extraits du contenu obtenu. Une page peut être chargée correctement sans fournir de prix. BotBrowser fournit un navigateur Chromium pour une étape de rendu autorisée ; il ne détermine pas les URL à découvrir, ne planifie pas la file d’exploration et ne définit pas les champs attendus de l’extracteur.
TL;DR
- L’exploration choisit les URL à visiter et gère leur récupération ; l’extraction sélectionne des informations dans leur contenu.
- Un programme peut remplir les deux rôles. Le nom du framework ne révèle pas quel résultat a échoué.
- La frontière d’exploration contient le travail en attente. Une file vide ne prouve pas que toutes les pages pertinentes ont été découvertes.
- Le rendu dans un navigateur est un choix distinct ; aucune tâche n’exige systématiquement JavaScript.
- Reliez les résultats de récupération et de validation avant de déclarer une collecte complète.
Sommaire
- Les résultats des deux tâches
- Une même chaîne peut assurer les deux rôles
- Le nombre de requêtes ne décrit pas tout le coût
- Un relais avec deux critères d’acceptation
- Identité des URL et identité des enregistrements
- Un sélecteur correspondant ne suffit pas
- Attribuer l’erreur avant de remplacer l’outil
- Séparer achèvement et retraitement
- Définir le périmètre avant toute récupération
- Conclusion pratique
Les résultats des deux tâches
Un robot d’exploration choisit des URL, programme des requêtes et consigne le résultat de chaque récupération. Ses points de départ peuvent provenir d’une liste explicite, d’un sitemap ou de liens découverts dans les pages. Google décrit un crawler comme un programme qui découvre et examine automatiquement des sites. Un livrable utile est un journal avec source_url, l’origine de la découverte, le statut et l’heure de récupération. Conserver les corps de réponse reste facultatif : un audit de disponibilité peut se limiter aux statuts et aux liens. Le parcours d’un robot étape par étape suit une URL initiale à travers récupération, analyse, résolution des liens et ordonnancement, et montre pourquoi un lien découvert peut rester sans requête.
Un extracteur sélectionne des informations dans une réponse ou un document rendu, puis les transforme en enregistrement. Son contrat peut exiger sku, price et currency. Son entrée peut être une page sauvegardée ou des milliers de documents ; suivre des liens n’est pas nécessaire à l’extraction. Une réponse HTTP 200 peut néanmoins contenir un prix vide, une présentation inattendue ou une valeur qui échoue à la validation.
| Décision | Responsabilité de l’exploration | Responsabilité de l’extraction |
|---|---|---|
| Entrée | Points de départ autorisés et périmètre d’URL | Contenu récupéré et schéma de champs |
| État de travail | URL en attente et résultats des requêtes | Résultats d’analyse et enregistrements candidats |
| Contrôle du résultat | Éléments visités, exclus ou non résolus | Champs obligatoires et clés valides |
| Défaut habituel | Une page autorisée n’a jamais été mise en file | Une page récupérée ne fournit aucun price valide |
La frontière représente le travail restant à examiner, pas l’inventaire complet du site. Elle peut être épuisée après l’oubli d’un lien de pagination. La couverture exige un périmètre déclaré et une règle indépendante d’achèvement, par exemple une comparaison avec la liste d’URL fournie par le propriétaire.
Une même chaîne peut assurer les deux rôles
L’architecture de Scrapy contredit une séparation rigide entre crawler et scraper. Un spider peut retourner des éléments extraits et de nouvelles requêtes. Le moteur transmet les requêtes au planificateur et les éléments aux pipelines, qui peuvent les valider et les stocker. Deux responsabilités partagent un framework sans devenir un seul critère d’acceptation.
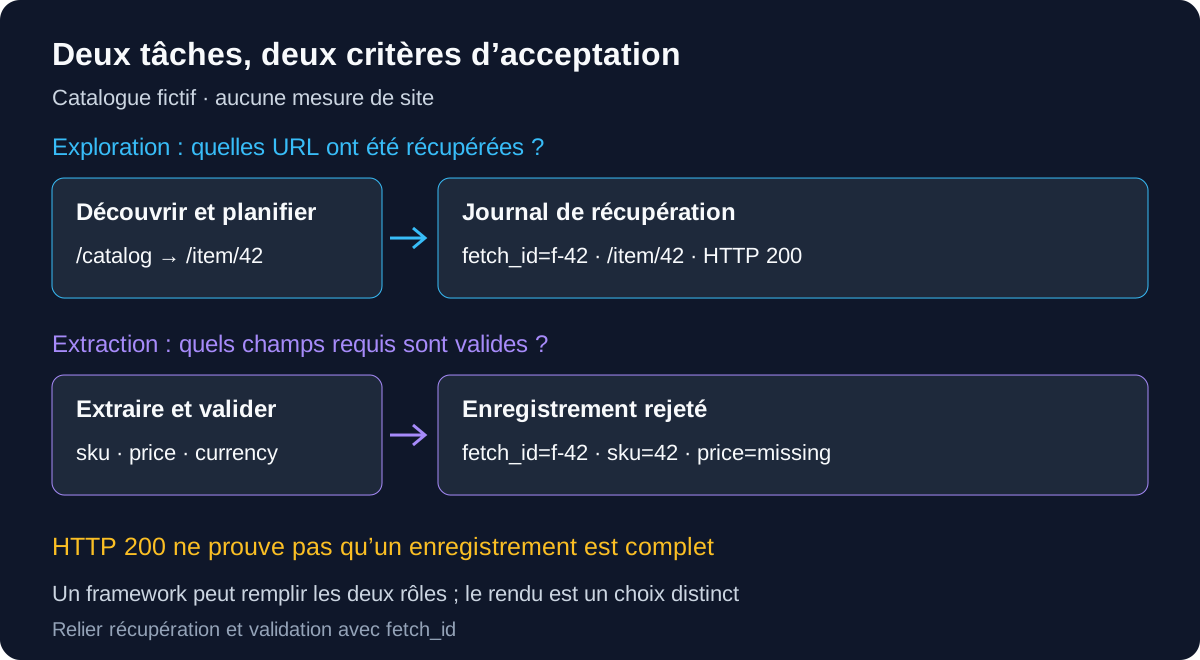
Dans un catalogue autorisé, un composant peut découvrir /item/42 depuis /catalog, récupérer le document et le transmettre à l’extracteur. Celui-ci produit ensuite un enregistrement de prix. S’il émet aussi l’URL suivante du catalogue, il participe à la découverte. Il faut identifier le composant qui décide des URL et celui qui décide des champs.
Le rendu se place entre récupération et interprétation lorsque le contenu requis dépend de JavaScript. Un crawler peut afficher une page pour découvrir des liens de navigation ; un scraper peut le faire pour obtenir un prix. Tous deux peuvent aussi utiliser le HTML reçu du serveur. BotBrowser peut fournir cette étape, tandis que l’application conserve la responsabilité de la frontière, des règles d’extraction et des données stockées. La configuration du navigateur avec Playwright explique comment connecter cette étape lorsque l’entrée consignée l’exige.
Le nombre de requêtes ne décrit pas tout le coût
Explorer la navigation peut produire des requêtes sans aucun enregistrement métier. Extraire depuis des documents sauvegardés peut produire des données sans recontacter la source. Si les deux étapes récupèrent séparément /item/42, la source subit un travail en double même si l’équipe ne voit qu’une ligne finale.
Comptez séparément les requêtes source, tentatives d’analyse et opérations du navigateur. Les compteurs utiles incluent fetch_attempts, render_attempts, parse_attempts et les clés acceptées. Attribuez chaque nouvelle tentative à son étape : corriger l’analyse d’un corps conservé ne doit pas déclencher automatiquement une requête réseau. La conservation exige sa propre politique de stockage et de traitement ; elle ne définit pas à elle seule un crawler.
Le diagnostic du débit et de la concurrence distingue fréquence des requêtes et opérations simultanées. Cette différence vaut pour toute la chaîne : deux modules utilisant la même origine contribuent à sa charge totale. Le navigateur ajoute du rendu et peut charger des sous-ressources ; « une page » ne correspond donc pas nécessairement à une requête HTTP.
Un relais avec deux critères d’acceptation
Utilisez un identifiant stable de récupération pour relier le journal des requêtes et le résultat d’extraction. Conservez l’URL demandée avec l’URL finale après redirection ; une redirection ne doit pas modifier silencieusement l’objet supposé de la collecte. Les lignes suivantes illustrent un contrat fictif, pas une exécution ni les mesures d’un site réel.
fetch_id | source_url | Récupération | Extraction | Décision |
|---|---|---|---|---|
f-41 | /item/41 | HTTP 200 | sku=41; price=12.90; currency=USD | Accepter après validation du schéma |
f-42 | /item/42 | HTTP 200 | sku=42; price=missing | Rejeter l’enregistrement ; examiner l’extraction |
f-43 | /item/43 | HTTP 503 | Non tentée | Garder la récupération non résolue |
Ajoutez fetched_at, l’URL finale, schema_version et le statut d’analyse au journal réel. Si les corps sont conservés, une empreinte ou une référence de stockage identifie l’entrée exacte à retraiter. Séparez clé d’enregistrement et URL : un document peut contenir plusieurs lignes, et plusieurs URL décrire un même article. Comptez les enregistrements uniques après application de la clé et des règles déclarées.
Le premier contrôle rapproche le périmètre autorisé des entrées visitées, volontairement exclues et non résolues. Le second valide les champs requis dans les entrées censées produire des données. Récupérer 3 URL et accepter 1 enregistrement ne démontre ni « un tiers terminé » ni « tout terminé » sans ces deux dénominateurs. Un index peut ne produire aucune ligne volontairement ; un échec de récupération peut en masquer plusieurs.
Identité des URL et identité des enregistrements
La déduplication du crawler détermine si une récupération est déjà planifiée ou assez récente. Celle du scraper détermine si une entité métier ou une observation existe déjà. Ces clés peuvent différer. /item/41 et /offers/41 peuvent décrire le même article, tandis qu’un seul document /catalog peut en contenir plusieurs. Dédupliquer par URL conserverait des doublons dans le premier cas et supprimerait des lignes valides dans le second.
Définissez l’identité des URL avec le propriétaire plutôt que de supprimer aveuglément les paramètres. page peut choisir un autre segment du catalogue. Un paramètre de langue ou de variante peut modifier les valeurs nécessaires au consommateur. Un paramètre de suivi, explicitement reconnu comme sans effet sur le contrat, peut au contraire être ignoré. Ces décisions dépendent de la source ; trier toute requête ou retirer tous les paramètres n’est pas une équivalence universelle.
| Décision d’identité | Conséquence pour la récupération | Conséquence pour les données |
|---|---|---|
Conserver un page significatif | Les différents segments restent accessibles | Le chevauchement exige des clés propres |
| Suivre une redirection autorisée | Garder URL demandée et finale | Associer les valeurs au document réel |
| Distinguer les heures d’observation | Une récupération ultérieure est une nouvelle observation | Un historique peut exiger sku et date |
| Retraiter un document conservé | Aucune nouvelle requête source | Une autre schema_version peut modifier la validation |
Pour une table de prix actuels, sku peut convenir dans une source et une variante déclarées. Pour un historique, écraser toutes les lignes portant le même sku détruirait les observations. Inscrivez la clé du consommateur dans le contrat et utilisez fetch_id comme provenance, pas comme identifiant d’entité. On peut alors distinguer doublon accidentel, variante distincte et observation ultérieure volontaire.
Un sélecteur correspondant ne suffit pas
Trouver .price établit seulement que le sélecteur correspond à un élément du document. Le contrat doit encore définir l’interprétation numérique, l’unité ou la devise et le traitement de l’absence. 0.00 et une chaîne vide ne peuvent pas devenir une même valeur fausse : zéro peut être un montant légitime, tandis que l’absence peut signaler un champ requis manquant.
Définissez des cas de validation pour le format réel. Le consommateur du catalogue fictif peut exiger un sku non vide, un price décimal et une currency reconnue. Un message promotionnel, une fourchette ou un prix réservé aux membres ne doit pas devenir le prix standard simplement parce qu’il occupe la même zone visuelle. Déclarez les formes admises et rejetez les autres avec un statut consultable.
| Valeur candidate | Question à résoudre | Résultat à conserver |
|---|---|---|
price=0.00 | Zéro est-il permis ? | Zéro valide ou échec nommé |
price=missing | Ce champ est-il obligatoire pour ce type ? | Absence, jamais zéro inventé |
price=12.90; currency=USD | Le format source autorise-t-il cette lecture ? | Montant typé, devise et provenance |
Plusieurs éléments .price | Lequel correspond à l’article et au type de prix ? | Valeur désambiguïsée ou erreur d’ambiguïté |
Ces vérifications relèvent de l’extraction même avec un navigateur. Le rendu peut rendre un élément disponible sans expliquer son sens métier. Conservez la version du schéma et la référence de l’entrée rejetée pour tester un analyseur corrigé sur le même document. Si le champ requis n’existe pas dans cette entrée, modifier le sélecteur ne le crée pas : l’enquête revient au contrat d’entrée, pas à l’idée que le rendu corrige toujours l’extraction.
Attribuer l’erreur avant de remplacer l’outil
Si /item/42 n’est jamais entré dans la frontière, examinez les points de départ, les liens découverts et les règles de périmètre. Modifier le sélecteur du prix ne récupère pas une page inconnue. Si elle était en file mais a retourné HTTP 503, examinez récupération et politique de nouvelle tentative autorisée avant d’imputer l’échec à l’extraction.
Si le journal contient la bonne page en HTTP 200 mais sans prix valide, inspectez le contenu remis à l’extracteur. Il peut s’agir du mauvais document, d’une page nécessitant un rendu ou d’une structure désormais inconnue. Une navigation réussie ne prouve pas un enregistrement valide. Séparez les alertes fetch_failed et required_field_missing : elles demandent des preuves et souvent des responsables différents.
Des enregistrements valides peuvent aussi être dupliqués. Tout recharger ou ajouter un navigateur ne répare pas une mauvaise clé. Comparez clé normalisée, URL source et identifiant de récupération avant de choisir entre déduplication des découvertes et déduplication des données.
Séparer achèvement et retraitement
Une frontière vide arrête le travail admis, mais ne certifie pas la couverture. Avec une liste finie fournie par le propriétaire, rapprochez chaque URL attendue d’un résultat terminal explicite : récupérée, volontairement exclue selon le périmètre ou non résolue avec motif. Gardez ces catégories visibles. Supprimer une URL échouée sans la consigner ferait paraître la collecte achevée en effaçant la preuve de son inachèvement.
Une découverte ouverte peut ne pas avoir de dénominateur exhaustif. Déclarez le véritable périmètre : origines et chemins autorisés, points de départ et règle de découverte. Une profondeur maximale, une fenêtre temporelle ou une exclusion volontaire modifie le sens de « terminé ». Ne transformez pas ce résultat limité en « tout le site a été extrait ». Le propriétaire définit le périmètre ; découvrir un lien ne l’y admet pas automatiquement.
Acceptez séparément les documents censés produire des éléments. Un index peut seulement générer des requêtes ; une fiche peut produire plusieurs offres. Un consommateur attendant un prix actuel par sku doit rapprocher les clés attendues, pas comparer lignes et réponses HTTP. Gardez HTTP 503 parmi les récupérations non résolues, sans le confondre avec les pages légitimement dépourvues d’enregistrements.
Le retraitement a son propre contrat. Si le corps est conservé et que seul l’analyseur change, relancez l’extraction sur cette entrée identifiée et consignez la nouvelle schema_version ; ne présentez pas le résultat comme une observation fraîche de la source. Une valeur actuelle exige une nouvelle récupération autorisée avec son heure et son fetch_id. Actualité de l’analyseur et actualité de la source sont différentes.
Livrez les deux journaux et leur rapprochement. Le responsable de l’exploration accepte le périmètre et les requêtes non résolues ; celui des données accepte champs, clés et rejets. Un résultat partiel devient exploitable sans être déclaré complet : le consommateur décide si les éléments manquants conviennent à son usage et conserve les preuves d’un futur nouvel essai ou correctif d’analyse.
Définir le périmètre avant toute récupération
Évaluez les règles robots applicables avant de planifier les requêtes automatiques. RFC 9309 précise qu’elles ne constituent pas une autorisation d’accès ; la distinction entre politique robots.txt et permission sépare ce contrôle de la livraison technique. Examinez indépendamment les conditions du site et l’autorisation de l’équipe, notamment l’usage prévu des données. L’étiquette crawler ou scraper ne change rien à cette décision.
Écrivez origines, chemins permis, conditions d’arrêt et champs obligatoires avant la première requête. BotBrowser n’accorde aucun droit de collecte et n’augmente aucune limite du site. Une file achevée décrit le travail accepté par la politique de l’équipe ; elle n’autorise pas à l’élargir et ne garantit pas une couverture exhaustive.
Questions fréquentes
Un crawler est-il toujours un scraper ?
Non. Un audit de liens ou de disponibilité peut récupérer des pages sans champs métier. Une chaîne peut faire les deux, mais journal des requêtes et schéma des données répondent à des questions distinctes.
Un scraper a-t-il besoin d’un crawler ?
Pas s’il reçoit une liste autorisée connue ou du contenu sauvegardé. Découvrir les entrées est une exigence distincte lorsqu’il faut les trouver, pas une propriété inhérente de l’extraction.
Faut-il un navigateur sans interface ?
Seulement si le contenu ou l’interaction le nécessite. Vérifiez si les liens ou valeurs figurent déjà dans la réponse avant d’ajouter le rendu. La présence de JavaScript quelque part ne suffit pas à établir ce besoin.
Sources
- Google : présentation des crawlers et fetchers
- Scrapy : architecture et flux, source du projet
- RFC 9309 : Robots Exclusion Protocol
- BotBrowser : démarrage
- BotBrowser : usage responsable
Conclusion pratique
Déclarez séparément le périmètre des URL et les champs requis. Reliez-les avec fetch_id, distinguez récupérations non résolues et enregistrements invalides, puis rapprochez les deux avant l’acceptation. Ajoutez un navigateur seulement si l’entrée consignée établit le besoin ; confiez découverte et validation à leurs responsables applicatifs.
Cet article fait partie du guide : Débuter avec l'automatisation du navigateur : carte initiale
Articles Connexes
Qu’est-ce qu’un robot d’exploration ? Cinq étapes
DémarrageScraping headless : ce qui change vraiment
DémarrageExploration web : budget et respect du site
DémarrageScraping avec Playwright : navigateur et profil
RéseauScraper bloqué : erreurs DNS, TLS, HTTP et de page
DémarrageWeb scraping JavaScript : rendu, pagination, scroll
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.