Exploration web : budget et respect du site
Dimensionnez une exploration autorisée avec espacement, concurrence, pauses et reprises. Calculez un budget fini sans confondre tentatives et couverture.
BotBrowser Team
Vous voulez la documentation structurée pour Démarrage ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
La capacité d’exploration web correspond au travail autorisé qu’un robot peut tenter pendant une fenêtre définie. Le trafic permis par le site et les ressources soutenables du robot limitent ensemble cette quantité. Ajouter des exécutants n’élargit pas l’autorisation du propriétaire, et une requête commencée ne représente pas nécessairement une page correctement collectée.
BotBrowser documente les contextes de navigateur partagés, les limites de pages simultanées et la surveillance mémoire pour l’automatisation autorisée. Il ne peut pas accorder le budget d’exploration d’un site, identifier une limite de requêtes non publiée ou rendre complets des résultats partiels. Ses options de déploiement aident à gérer le navigateur ; l’opérateur reste responsable de l’autorisation, du comptage et de la décision d’arrêt.
TL;DR
- Convenez de l’origine autorisée, de la fenêtre, de l’unité de comptage et du plafond de trafic avant de dimensionner le travail. Une règle robots permissive n’est ni une autorisation ni un quota chiffré.
- La concurrence mesure le travail simultané ; l’espacement détermine quand une requête peut démarrer. Tous les exécutants partageant le budget doivent respecter les deux contraintes.
- Le calcul de capacité donne une borne d’admission. Les variations de latence, les échecs et l’attente de l’application peuvent réduire les résultats utiles.
- Les pauses et les nouvelles tentatives consomment du temps ou des créneaux de requête. Conservez les URL restantes au lieu de présenter l’épuisement du budget comme une réussite complète.
- Comptez les requêtes secondaires du navigateur dans le périmètre défini par le propriétaire. Une navigation peut produire plusieurs requêtes.
Sommaire
- Deux sens du budget d’exploration
- Calculer un budget fini de requêtes
- Compter les pauses, reprises et requêtes du navigateur
- Expliquer une exploration partielle
- Dimensionner et consigner une première exécution autorisée
- Conclusion pratique
Deux sens du budget d’exploration
Google emploie le budget d’exploration pour décrire ce que Googlebot peut et souhaite explorer. Ses conseils pour les grands sites distinguent la limite de capacité de la demande d’exploration. Cette explication concerne Google Search, notamment ses propres décisions de ressources et de planification. Ce n’est pas un quota standard que chaque site attribuerait à chaque robot, ni une promesse d’indexation des pages explorées.
Pour un robot exploité par le lecteur, séparez deux données : le trafic permis par le propriétaire et celui que le système de collecte peut soutenir. La première peut préciser chemins, horaires, espacement, requêtes simultanées, volumes transférés et opérations interdites. La seconde dépend du temps d’occupation des exécutants, du processeur, de la mémoire, du réseau et du traitement en aval. Ces deux données peuvent évoluer ; aucune ne doit disparaître dans une constante non documentée appelée « vitesse sûre ».
L’autorisation doit décrire le périmètre de comptage. Une allocation peut couvrir une origine pour tous les exécutants du projet, un compte authentifié ou une ressource précise d’API. La section 4 de RFC 6585 ne définit volontairement pas comment le serveur identifie l’utilisateur ou compte les requêtes pour répondre 429. Le client ne peut pas déduire un périmètre universel du seul code. Demandez au propriétaire quel trafic partage l’allocation approuvée.
Les règles robots constituent une autre donnée, pas un remplacement de cet accord. RFC 9309 indique explicitement qu’elles ne sont pas une autorisation d’accès. Un chemin autorisé ne signifie pas à lui seul une requête par seconde, dix pages simultanées ou une collecte nocturne. L’absence de réponse 429 ne prouve pas davantage que le débit actuel soit autorisé ou soutenable.
Le respect du site a donc un sens opérationnel : rester dans le périmètre convenu, respecter la politique robots applicable, partager l’allocation et réagir prudemment à une surcharge ou au retrait de l’autorisation. Répartir discrètement le même travail entre davantage d’identités change la source du trafic, pas l’autorisation. Si le propriétaire retire l’accès, arrêtez le travail concerné au lieu de rechercher un autre chemin pour continuer.
Calculer un budget fini de requêtes
Prenez un catalogue hypothétique appartenant au lecteur, avec une liste connue de 900 URL HTML uniques. Le propriétaire autorise explicitement au plus 1 départ de requête par seconde pour l’ensemble du travail et pas plus de 2 requêtes simultanées. Supposez une fenêtre de 900 secondes et une occupation locale de 0.5 seconde par emplacement de requête. Ce sont des hypothèses, pas des performances mesurées ni des limites déduites d’un serveur réel.
Dans une approximation simple à charge stable, le débit local ne peut dépasser le nombre d’emplacements disponibles divisé par leur temps d’occupation. Avec 2 emplacements et 0.5 seconde par emplacement, cela donne 4 départs par seconde. La règle de 1 par seconde imposée par le propriétaire est plus restrictive. Préparer davantage d’exécutants de navigateur ne permet pas de dépasser cette fréquence convenue.
| Donnée ou calcul | Valeur hypothétique | Signification |
|---|---|---|
| Ensemble cible connu | 900 URL uniques | Dénominateur fourni par le propriétaire |
| Espacement approuvé | 1 requête/s | Plafond partagé des départs de cet exemple |
| Plafond simultané | 2 requêtes | Maximum de requêtes autorisées en cours |
| Occupation locale | 0.5 s | Hypothèse, pas un banc d’essai |
| Approximation locale | 2 / 0.5 = 4 requêtes/s | Plafond de ressources sous ces hypothèses |
| Débit contraignant | min(1, 4) = 1 requête/s | Les deux contraintes s’appliquent |
Cette approximation identifie la contrainte dominante ; elle ne prédit pas l’heure de fin. Elle suppose du travail disponible en permanence et une occupation stable. Les latences réelles comprennent réponses lentes, délais dépassés et coûts de connexion. Une tâche de navigateur peut aussi occuper une page en attendant un état applicatif. Utilisez les observations d’une petite exécution autorisée pour planifier la suite et distinguez-les toujours du plafond permis.
Définissez exactement le calendrier de l’exemple : un départ prévu à chaque seconde entière de 0 à 899, dans l’intervalle semi-ouvert incluant 0 et excluant 900. Cela produit 900 occasions de départ. Aucune rafale n’est permise ; une occasion inutilisée expire au lieu de devenir un crédit pour plus tard. Cette convention rend le comptage reproductible ; une autre convention approuvée demande son propre calcul.
Même sans interruption, ces 900 occasions ne garantissent pas 900 pages terminées avant l’échéance. La dernière requête peut se terminer après sa fenêtre de départ et certaines réponses peuvent échouer. Précisez si l’échéance interdit les nouveaux départs, impose l’arrêt de tout trafic ou laisse finir les requêtes en cours. Si un silence complet est exigé à la fin, réservez le temps nécessaire pour arrêter ou annuler les opérations en vol plutôt que de démarrer juste avant la limite.
La distinction entre débit et concurrence devient cruciale lorsque les réponses ralentissent. À 1 départ par seconde avec 0.5 seconde d’occupation, le plafond de 2 requêtes n’est pas contraignant. Si chaque requête occupe désormais 3 secondes, 2 emplacements ne soutiennent plus ce calendrier. L’approximation locale devient 2 / 3 requêtes par seconde avant les autres coûts. L’ordonnanceur doit sauter ou reporter les départs sans place disponible, pas ignorer le plafond pour maintenir le plan initial.
Compter les pauses, reprises et requêtes du navigateur
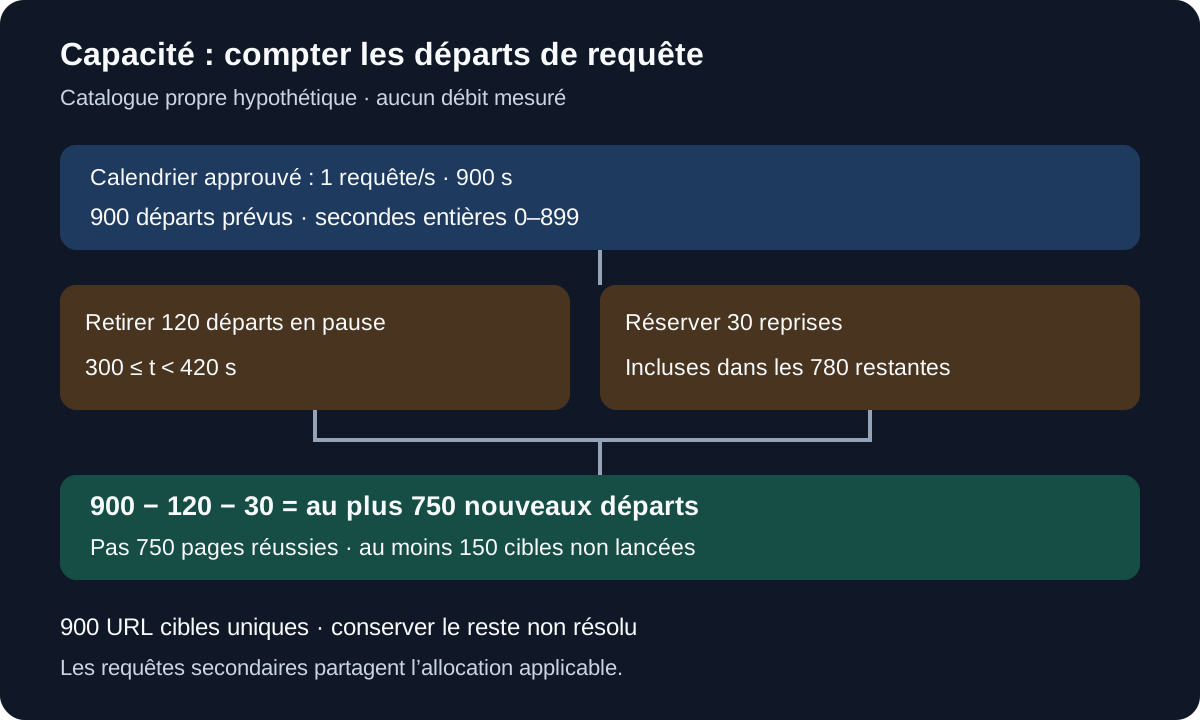
Supposez maintenant que cette même exécution hypothétique suspend tous les départs de la seconde 300 incluse à la seconde 420 exclue. La pause retire 120 occasions du calendrier initial. Il reste un plafond de 900 moins 120, soit 780 tentatives. Si l’opérateur réserve en plus 30 de ces occasions aux nouvelles tentatives, il en reste au plus 750 pour une première tentative sur une nouvelle URL. Ce sont des allocations, pas des résultats d’une exécution réelle.
| Étape du calcul | Occasions restantes | Ce que le nombre ne prouve pas |
|---|---|---|
| Calendrier initial aux secondes entières | 900 | Réponses terminées avant l’échéance |
| Retirer les 120 départs suspendus | 780 | Pages de catalogue réussies |
| Réserver 30 départs aux reprises | 750 pour de nouvelles URL | Couverture réussie de 750 URL uniques |
| Comparer aux 900 cibles | Au moins 150 sans première tentative sous cette allocation | Taux final de réussite ou résultat réel |
Les 30 occasions de reprise sont incluses dans les 780, pas ajoutées. Si seulement 10 reprises sont nécessaires, les 20 autres ne peuvent être réaffectées à de nouvelles URL que pendant le temps encore admissible et si la politique de planification l’autorise. Une réservation rigide conserve le plafond de 750. Indiquez la politique retenue ; ne mélangez pas budget réservé et reprises réellement consommées pour comparer des exécutions.
HTTP 429 signifie que le serveur estime que le client a envoyé trop de requêtes pendant une période donnée. La référence MDN du statut précise que la réponse peut contenir Retry-After. Sa présence n’est pas garantie. La référence de l’en-tête décrit soit un entier non négatif en secondes, soit une date HTTP. Conservez la valeur reçue et l’heure utilisée pour l’interpréter.
Lorsqu’une réponse applicable demande une reprise ultérieure, le travail concerné ne doit pas être planifié avant cette échéance. Une politique locale peut attendre davantage ou arrêter l’exécution. Un en-tête absent ou invalide ne justifie pas une reprise immédiate ; suivez l’accord et une récupération prudente et bornée. Sonder à répétition avec un débit supérieur pour trouver un plafond invisible n’est pas dimensionner une capacité. Le diagnostic du débit et de la concurrence traite les réglages détaillés ; le calcul de capacité retient surtout que la pause supprime des occasions d’admission.
Le trafic du navigateur exige une autre décision de comptage. Une navigation peut charger HTML, scripts, styles, images et données applicatives ; redirections et reprises ajoutent des requêtes. Limiter les tâches par page n’impose pas directement un plafond de départs par origine. Si l’allocation couvre toutes les requêtes vers cette origine, les requêtes secondaires concernées la partagent. Espacer les navigations principales ne suffit pas à affirmer la conformité du trafic.
Pour un second calcul hypothétique, supposez exactement 5 requêtes par page dans le périmètre approuvé. Une allocation de 750 requêtes permet alors au plus 150 chargements avant échecs ou reprises. La conversion n’est pas générale : cache, ressources variables et interrogations en arrière-plan modifient le compte. Une autre origine nécessite sa propre décision d’autorisation et de comptage. Si le dispositif ne peut contrôler ou borner fiablement ces requêtes, convenez d’une autre récupération approuvée au lieu d’affirmer qu’un limiteur de navigations suffit.
Expliquer une exploration partielle
Une exploration limitée par la capacité peut être utile sans être complète. Il faut un dénominateur honnête et conserver le reste. Pour les 900 URL du catalogue, tenez l’état courant de chaque cible et l’historique de ses tentatives. Le parcours des étapes d’un robot distingue file d’attente, opérations en cours, travail reporté et états terminaux. L’épuisement de la fenêtre est une raison d’arrêt, pas une réussite terminale pour toutes les URL encore en attente.
Séparez le registre des requêtes de celui des URL. Une tentative consigne un envoi et son résultat ; une URL peut avoir plusieurs tentatives. Une reprise réussie ne compte pas comme une deuxième URL couverte. Un échec n’efface pas le caractère non résolu de l’URL. Si une redirection consomme une requête supplémentaire selon l’accord, comptez ce trafic sans prétendre avoir collecté un autre élément du catalogue.
| État d’URL proposé | Signification à l’arrêt | Conséquence dans le bilan |
|---|---|---|
| Jamais commencée | Aucune première tentative admise | Non couverte dans l’ensemble connu |
| Reportée | Attend une heure ou condition autorisée | Travail restant, pas page réussie |
| En cours | Tentative sans résultat enregistré | Fin encore inconnue |
| Échec terminal | Récupération terminée sans contenu utile | Couverture échouée selon cette politique |
| Résultat exploitable | Réponse conforme au besoin de contenu | URL couverte selon ce besoin explicite |
Ces états sont un modèle applicatif proposé, pas des termes HTTP. Définissez avant l’exécution ce qui rend un résultat exploitable. HTTP 200 peut représenter une connexion, une enveloppe d’erreur ou une page sans catalogue. Un téléchargement peut échouer à l’analyse ; une page analysée peut manquer de champs pour l’extracteur en aval. Le bilan doit préciser son critère de réussite plutôt que de confondre ces étapes.
Le nombre 750 borne les premières tentatives sur de nouvelles URL sous les hypothèses retenues. Il ne fournit aucun numérateur observé de pages réussies. La formulation défendable est « au moins 150 des 900 URL connues ne peuvent recevoir de première tentative avec cette allocation fixe ». Ce n’est pas « le robot a collecté 83 pour cent ». La couverture réelle demande des résultats exploitables enregistrés ; échéances et ressources peuvent laisser plus de 150 URL non commencées.
Une exploration fondée sur la découverte ajoute une limite : l’ensemble complet des URL peut être inconnu. Présentez alors la couverture de l’ensemble admis ou fourni par le propriétaire et expliquez son origine. Une file immédiate vide ne prouve pas l’absence de pages encore inconnues. Un grand nombre de requêtes ne remplace pas ce dénominateur manquant. Conservez graines, périmètre, exclusions et limites de découverte pour expliquer les différences au passage suivant.
Dimensionner et consigner une première exécution autorisée
Commencez par un sous-ensemble borné approuvé par le propriétaire, avec les types de pages pertinents. Séparez l’allocation de requêtes du réglage local des exécutants. Mesurez occupation, multiplicité des requêtes et mémoire sans transformer un petit échantillon en capacité permanente du site. Une période calme et une page en cache peuvent différer fortement d’un passage ultérieur avec des données applicatives non mises en cache.
La documentation de performance BotBrowser décrit plusieurs BrowserContexts partageant un navigateur, la fermeture des pages inutilisées, la limitation des pages simultanées et la surveillance mémoire. Ces options gèrent les ressources lorsque la collecte approuvée exige un navigateur. Elles n’appliquent pas l’accord de requêtes à la place du robot. Des contextes indépendants peuvent produire du trafic contre la même allocation par origine, et davantage de contextes peuvent accroître cette pression.
Utilisez les observations pour choisir une occupation locale prudente et une tranche finie de travail. Si les ressources ne soutiennent pas le débit autorisé, réduisez les admissions prévues ou prolongez la fenêtre avec accord. Si l’allocation du site est plus restrictive, laissez des ressources locales inoccupées. Ces situations sont normales. Optimiser l’utilisation passe après le respect de l’autorisation et la conservation de résultats corrects.
| Donnée consignée | Utilité |
|---|---|
| Référence d’autorisation, origine et chemins | Établit la cible réellement autorisée |
| Périmètre, espacement et plafond simultané | Définit le trafic partageant le budget |
| Convention temporelle et comportement final | Rend explicites départs et fin des opérations |
| Pauses et réservation des reprises | Explique les déductions du plan |
| Tentatives, URL exploitables et restantes | Sépare consommation de trafic et couverture |
| Raison d’arrêt et prochaine condition admissible | Rend la poursuite délibérée |
Une reprise exige un nouveau contrôle d’admissibilité. Reporter une file à demain ne conserve ni l’autorisation d’hier, ni l’état du site, ni sa fenêtre. Vérifiez l’accord actuel, gardez l’historique et évitez de collecter à nouveau les URL déjà utiles sauf si leur actualisation est approuvée. Plusieurs exécutants doivent obtenir leur admission d’un budget commun au lieu d’appliquer chacun l’allocation entière.
Questions fréquentes
Augmenter la concurrence augmente-t-il le budget ?
Cela peut relever le plafond local lorsque l’occupation limite les ressources. Cela n’élargit pas l’allocation du propriétaire, ne supprime pas l’espacement et ne garantit pas des réponses utiles. Appliquez la contrainte la plus basse et comptez tous les exécutants ensemble.
robots.txt définit-il le débit de tous les robots ?
RFC 9309 ne définit aucune allocation universelle de débit et n’accorde pas d’autorisation. Certains outils acceptent d’autres conventions, mais une directive non prise en charge ou un chemin permis n’autorise pas un débit supposé.
Une exploration en pause est-elle un échec ?
Pas nécessairement. Une pause prévue ou demandée par le serveur peut être le bon comportement. Présentez les résultats exploitables réels et le reste reporté. Reprenez seulement si autorisation, échéances et ressources le permettent.
Sources
- Google Search Central : budget d’exploration des grands sites
- MDN : 429 Too Many Requests
- MDN : Retry-After
- RFC 6585 : codes HTTP supplémentaires
- RFC 9309 : protocole d’exclusion des robots
- BotBrowser : optimisation des performances
- BotBrowser : utilisation responsable
Conclusion pratique
Pour une exploration finie autorisée, consignez l’accord de requêtes, choisissez la convention temporelle et calculez le plafond d’admission avant de fixer les exécutants. Déduisez pauses et réservations de reprises, puis distinguez URL réussies, tentatives et travail restant. Le plan hypothétique de 900 départs laisse au plus 750 premiers départs après ses déductions ; il n’établit jamais 750 pages utiles. Une exploration plus petite, explicable et conservant son reste fonde la prochaine exécution autorisée.
Cet article fait partie du guide : Débuter avec l'automatisation du navigateur : carte initiale
Articles Connexes
Qu’est-ce qu’un robot d’exploration ? Cinq étapes
DémarrageWeb crawler vs web scraper : résultats et erreurs
RéseauLimites de scraping : 429, Retry-After et concurrence
DéploiementScraping et robots.txt : règles, blocages et échecs HTTP
DémarrageNavigateur pour le web scraping : six critères
RéseauGestion des pools de proxies selon la charge
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.