Qu’est-ce qu’un robot d’exploration ? Cinq étapes
Suivez un robot d’exploration de ses URL initiales à la requête suivante : périmètre, récupération, analyse, découverte de liens et décisions de file.
BotBrowser Team
Vous voulez la documentation structurée pour Démarrage ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
Un robot d’exploration est un programme qui découvre des adresses web et récupère des pages selon une politique. Il part d’URL connues, récupère les pages admissibles, lit leur contenu, trouve d’autres liens et décide quelle adresse visiter ensuite. La boucle est simple ; déterminer quelles URL doivent y entrer concentre une grande partie du travail d’ingénierie.
BotBrowser peut fournir un navigateur Chromium pour l’automatisation autorisée lorsqu’une page nécessite un rendu par navigateur. Il ne remplace pas la liste des URL initiales, la frontière d’exploration ou les règles de déduplication et ne donne pas l’autorisation de collecter un site. Un robot peut employer un client HTTP ordinaire, un navigateur ou les deux. Le navigateur n’est qu’un composant de récupération dans un processus plus large.
TL;DR
- Une URL initiale lance la découverte ; elle ne décrit pas toutes les pages appartenant à un site ou à un projet.
- Une récupération exige une URL admissible, une décision sur la politique du site et un créneau de requête disponible. Découvrir une adresse n’autorise pas sa requête.
- Analyser une réponse et extraire ses liens sont des opérations distinctes : un HTML exploitable peut ne contenir aucune prochaine URL admissible.
- Résolvez chaque référence par rapport à la base du document avant les contrôles de périmètre et de doublons. Conservez l’URL résolue et le motif d’admission ou de rejet.
- La frontière contient le travail en attente. Une frontière vide signifie seulement qu’aucun travail admissible ne reste selon les règles enregistrées, pas que toutes les pages possibles ont été découvertes.
Sommaire
- La boucle en cinq étapes
- Choisir les URL initiales et définir le périmètre
- Récupérer une URL admissible
- Analyser la représentation reçue
- Résoudre les liens et rejeter les doublons
- Choisir la prochaine requête et expliquer l’arrêt
- Conclusion pratique
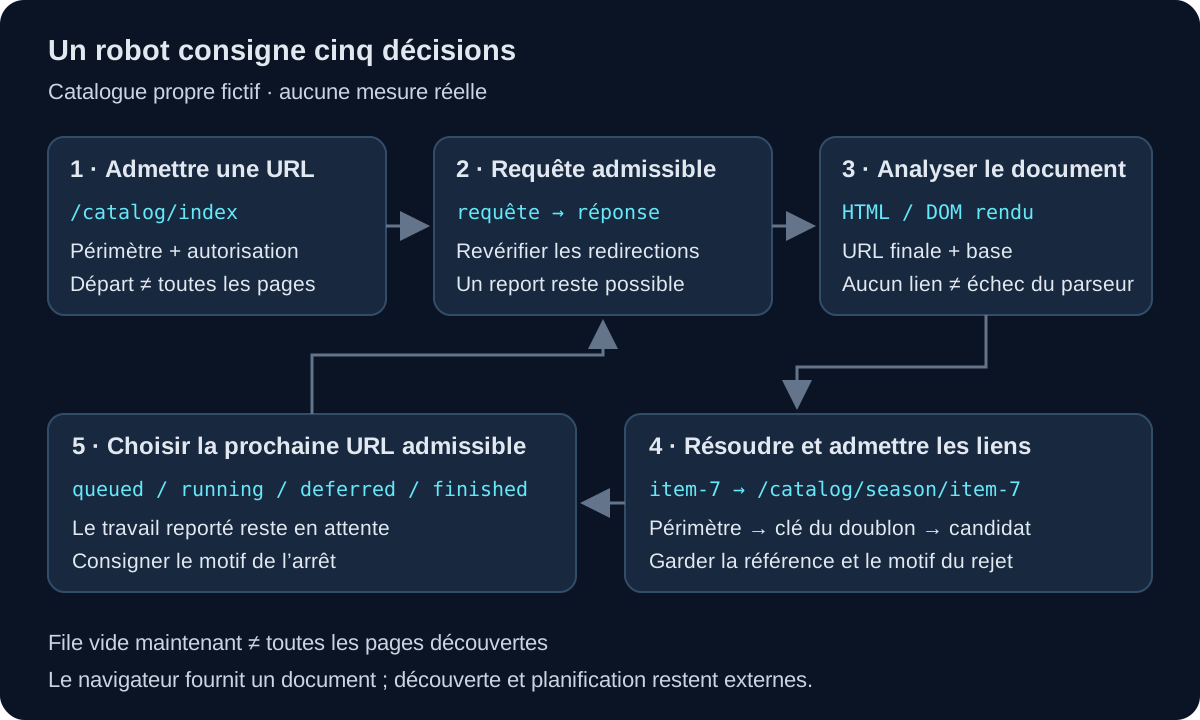
La boucle en cinq étapes
Prenons un catalogue expressément fictif sur https://catalog.example/. Son propriétaire veut qu’un robot inspecte les pages HTML publiques sous /catalog/, à partir de /catalog/index. L’exécution exclut les pages de connexion, les autres origines et les fichiers à télécharger. Ce sont des règles choisies pour ce projet, pas une définition imposée à tous les robots. Les exemples suivants proposent une trace ; ils ne sont pas la sortie d’une exploration exécutée.
| Étape | Entrée | Décision | Résultat consigné |
|---|---|---|---|
| Départ | /catalog/index | Ce point de départ appartient-il au périmètre déclaré ? | URL initiale admissible |
| Récupération | URL absolue admissible | Une requête peut-elle partir maintenant et sa redirection peut-elle être suivie ? | Réponse ou tentative reportée ou échouée |
| Analyse | Corps et métadonnées de réponse | Quelle représentation et quel analyseur conviennent ? | Document analysé ou échec d’analyse identifié |
| Découverte | Liens du document | Quelles URL absolues désignent les références, et lesquelles sont nouvelles et admissibles ? | Candidats admis et motifs de rejet |
| Planification | Candidats et travail restant | Quel élément admissible exécuter ensuite, et que reste-t-il ? | Prochaine requête, élément reporté ou arrêt consigné |
Il s’agit d’un modèle pédagogique, pas d’une architecture logicielle obligatoire. Un framework peut combiner ces opérations ou lancer plusieurs requêtes simultanément. La documentation d’architecture de Scrapy sépare ordonnanceur, téléchargeur et spiders : la réponse arrive au spider, et les nouvelles requêtes qu’il produit reviennent à l’ordonnanceur. Cette séparation permet d’identifier le composant qui a perdu ou rejeté une URL.
La description du fonctionnement de la recherche de Google Search Central distingue également découverte, exploration et indexation. Ce sont les étapes documentées de Google, pas une garantie que chaque URL découverte sera récupérée ou indexée. Un robot chargé d’inventorier son propre catalogue n’a pas nécessairement besoin de construire un index de recherche.
La comparaison entre robot d’exploration et outil de scraping distingue couverture de récupération et extraction de champs. Ici, l’artefact utile est une suite de décisions sur les URL. Une page peut être récupérée et analysée correctement alors qu’un extracteur de fiches distinct rejette son prix manquant. À l’inverse, le robot ne peut pas déclarer un échec d’extraction de fiche pour une page qu’il n’a jamais récupérée.
Choisir les URL initiales et définir le périmètre
Une URL initiale est une adresse fournie au robot pour démarrer. Elle peut venir d’un fichier de configuration, d’une liste remise par le propriétaire ou d’un sitemap. L’exécution fictive commence par https://catalog.example/catalog/index. Ce choix indique le début de la découverte. Il ne prouve pas que chaque page autorisée du catalogue est accessible depuis cette adresse.
Séparez la liste de départ de la règle de périmètre. Une autre URL initiale, comme /catalog/archive, peut révéler une partie déconnectée du même catalogue autorisé. Une adresse sous /account/ échoue à la restriction /catalog/ de cette exécution même si elle partage le même hôte. Le robot doit la rejeter avant toute opération réseau, avec un motif tel que outside_path_scope.
Définissez une frontière évaluable au lieu de vous contenter de « rester sur le site ». Ici, les URL admissibles utilisent https:, ont l’origine exacte https://catalog.example et un chemin sous /catalog/. Le propriétaire exclut aussi /catalog/private/. Une origine comprend schéma, hôte et port ; une marque ou un suffixe commun ne fait pas entrer une autre origine dans la cible approuvée.
| Candidat | Décision dans cet exemple | Motif |
|---|---|---|
https://catalog.example/catalog/index | Admettre | Page initiale du catalogue |
https://catalog.example/catalog/archive | Admettre | Autre entrée approuvée par le propriétaire |
https://catalog.example/account/ | Rejeter | Chemin hors du catalogue déclaré |
https://cdn.example/catalog/index | Rejeter | Origine différente |
https://catalog.example/catalog/private/item | Rejeter | Exclusion explicite d’un chemin privé |
Évaluez les chemins sur une URL analysée, pas sur une sous-chaîne brute. Une recherche textuelle de catalog.example peut aussi correspondre à un chemin, à un paramètre de requête ou à un autre nom d’hôte. Convenez avec le propriétaire du traitement des chemins encodés et des redirections ; décoder ou réécrire sans distinction les composants peut changer leur sens. Un filtre de périmètre n’est pas un système d’autorisation pour des entrées arbitraires.
L’échec évité ici est une affirmation de couverture invalide. Supposons que le propriétaire fournisse séparément une liste finie des URL attendues. La comparaison avec les résultats récupérés peut faire apparaître des pages manquantes. Sans ce dénominateur indépendant, « toutes les pages trouvées » ne signifie que celles trouvées par cette méthode de découverte. Ni une entrée très large ni un grand nombre de requêtes ne fournit le dénominateur absent.
Conservez ensemble les URL initiales, la version du périmètre et l’identifiant d’exécution. Si /catalog/archive est ajouté à mi-parcours, les découvertes suivantes reposent sur des entrées modifiées. Rendre ce changement visible permet d’expliquer une URL nouvellement trouvée sans l’attribuer à une correction d’analyseur ou à un changement de navigateur.
Récupérer une URL admissible
La récupération transforme une URL admise en tentative de requête. Avant de l’envoyer, vérifiez les règles du site et l’autorisation du projet, puis si la requête peut partir à cet instant. Ces décisions sont distinctes. Une URL peut appartenir au catalogue tout en étant interdite par la politique robots applicable, hors de l’autorisation du propriétaire ou reportée par l’ordonnanceur de son origine.
L’explication de la politique robots.txt couvre le groupe d’agent nommé et l’interprétation des règles. La RFC 9309 précise que ces règles ne constituent pas une autorisation d’accès. Une permission robots ne remplace ni conditions, ni consentement, ni décision de contrôle d’accès ; l’absence du fichier ne transforme pas une ressource privée en cible autorisée.
Employez une politique de requête qui consigne pourquoi l’opération a eu lieu. Pour la page fictive /catalog/index, le relevé d’une tentative peut contenir request_url, requested_at, policy_version, attempt_number et son résultat. Ces champs sont une proposition applicative. Ils ne constituent pas une preuve d’autorisation fournie par le navigateur, et aucune valeur d’exemple ne prétend représenter une mesure réseau réelle.
Les redirections imposent une nouvelle vérification de la frontière. Une requête vers /catalog/old peut mener à /account/login ou à une autre origine. Vérifier seulement l’URL de départ puis suivre automatiquement les redirections peut faire sortir du périmètre déclaré. Examinez la destination avant de la suivre, conservez la chaîne pour le diagnostic et arrêtez-vous si la prochaine destination est inadmissible. Fixez aussi un nombre maximal fini de redirections.
Une réponse récupérée doit encore être classée. Une page HTML du catalogue, une page de connexion renvoyée avec HTTP 200, une réponse 404 et une erreur temporaire du service ne signifient pas la même chose. Conservez statut, URL finale et type de média pertinent à côté de la décision sur le corps. Ne classez pas chaque HTTP 200 comme une page de catalogue correcte : l’application a pu recevoir une autre représentation.
L’ordonnanceur a également besoin d’une politique par origine. La concurrence contrôle le travail simultané ; l’espacement limite le début d’une nouvelle requête. L’un ne remplace pas l’autre. Si l’origine signale une surcharge, conservez un résultat reporté et la politique de nouvelle tentative applicable au lieu de relancer immédiatement en boucle. Le dimensionnement relève de la capacité ; ici, la règle est plus précise : une page découverte n’est pas nécessairement récupérable maintenant. Le calcul de capacité d’exploration montre comment les pauses et les réserves de nouvelles tentatives réduisent un budget fini de départs de requête.
Séparez résultat de tentative et résultat d’URL. /catalog/item-7 peut subir une expiration puis recevoir une réponse correcte lors d’un autre essai. Le registre doit conserver cet historique tout en attribuant à l’URL un seul état courant de planification. Compter ces tentatives comme deux pages couvertes gonfle la couverture ; supprimer la première efface la preuve nécessaire pour expliquer la nouvelle tentative.
Analyser la représentation reçue
L’analyse interprète une réponse comme un document. Le robot doit d’abord savoir ce qu’il traite. Un analyseur HTML, un analyseur JSON et un processeur PDF remplissent des fonctions différentes. Si l’exécution accepte des pages HTML publiques du catalogue, un type de média inattendu doit produire un résultat identifié plutôt qu’être envoyé aveuglément à l’extracteur de liens HTML.
L’URL de réponse compte parce que les références suivantes ont besoin d’une base. Si /catalog/index redirige vers /catalog/season/, le document récupéré correspond à cet emplacement final. Une référence relative telle que item-7 se résout différemment depuis ces deux emplacements. Conservez l’URL finale de la récupération plutôt que de la reconstruire depuis l’adresse initiale.
Analyser le HTML reçu et rendre une page sont aussi deux opérations distinctes. Un client HTTP peut analyser les liens déjà présents dans la réponse. Un navigateur peut exécuter des scripts créant d’autres nœuds et liens DOM. Google documente ces chemins dans ses principes de SEO JavaScript. Cette documentation décrit son pipeline ; elle n’établit pas que tout robot exécute JavaScript.
Choisissez délibérément la représentation. Sur une page de test appartenant au lecteur, comparez les liens de la réponse à ceux créés par l’application après son état de disponibilité documenté. Si les liens utiles sont déjà dans le HTML reçu, ce travail de découverte n’exige pas de rendu. S’ils apparaissent seulement après initialisation, il faut concevoir l’étape navigateur correspondante ou utiliser une autre source d’URL approuvée par le propriétaire.
BotBrowser peut fournir cette étape dans une automatisation autorisée, comme le décrit sa documentation de démarrage. Il ne choisit pas la condition de disponibilité et ne décide pas que le DOM est complet. Le contrat applicatif doit nommer l’événement, l’état ou l’élément qui rend la collecte pertinente. Une attente arbitraire peut se terminer avant l’arrivée des données, ou durer indéfiniment sur une page qui entretient une activité de fond.
Conservez les erreurs d’analyse dans une branche propre. Si la réponse a été récupérée mais que l’analyseur a rejeté son contenu, l’URL a été récupérée sans être interprétée correctement. Une page analysée sans ancre admissible peut au contraire avoir été traitée avec succès. Ces cas demandent des résultats distincts, tels que parse_failed et parsed_no_candidates, dont l’application définit le sens.
Cette distinction évite une correction coûteuse mais inadéquate. Davantage de ressources navigateur ne transforme pas une réponse de connexion en page de catalogue autorisée. Répéter une récupération HTTP ne révèle pas des liens créés par script si la représentation ne change pas. Diagnostiquez la catégorie de réponse et la cible d’analyse avant de remplacer le composant de récupération.
Résoudre les liens et rejeter les doublons
La découverte commence par des références, pas forcément des URL absolues. Une ancre peut contenir item-7, ../archive/ ou #details. La référence du constructeur URL explique leur résolution par rapport à une base. Dans un document HTML analysé, l’URI de base du document peut aussi dépendre d’un élément base applicable.
Le tableau suppose une base enregistrée de https://catalog.example/catalog/season/. Il expose des décisions proposées pour cet exemple, pas les résultats d’un robot en cours d’exécution. Une base externe modifierait la résolution ; la destination résolue reste soumise au même contrôle d’origine.
| Référence | URL résolue | Décision |
|---|---|---|
item-7 | https://catalog.example/catalog/season/item-7 | Nouveau candidat admissible |
./item-7 | https://catalog.example/catalog/season/item-7 | Candidat en double |
item-7#details | https://catalog.example/catalog/season/item-7#details | Même clé de récupération selon la politique de fragments de cette exécution |
../archive/ | https://catalog.example/catalog/archive/ | Candidat admissible |
/account/login | https://catalog.example/account/login | Hors du périmètre des chemins |
https://other.example/catalog/item-7 | https://other.example/catalog/item-7 | Hors du périmètre des origines |
Vérifiez l’admissibilité après résolution. Un lien relatif apparemment anodin peut désigner une destination exclue lorsque la base change. N’admettez que les schémas adaptés : une référence mailto: ou javascript: n’est pas une requête HTTP au catalogue. Un service général acceptant des URL arbitraires doit ajouter des contrôles de sécurité des destinations réseau, au-delà du périmètre de cet exemple.
La déduplication exige une clé explicite. Ici, l’exécution retire le fragment pour identifier une récupération réseau : les trois références d’article partagent donc une clé. Cette politique ne prouve pas que les fragments n’influencent jamais une application. Une route rendue côté client peut employer le fragment pour sélectionner une autre vue. Si cette vue appartient à la tâche, la clé de navigation du navigateur peut différer de celle de la récupération HTTP.
Ne supprimez pas les paramètres de requête parce qu’ils paraissent répétitifs. /catalog/search?page=1 et /catalog/search?page=2 peuvent exposer des articles différents. À l’inverse, un paramètre de suivi confirmé par le propriétaire peut parfois être omis de la clé de planification. Consignez la transformation autorisée et son motif. Trier, mettre en minuscules ou décoder toute une URL peut fusionner des adresses que le serveur distingue.
Conservez la référence d’origine et sa page source avec le candidat résolu. Un rejet comportant source_url, raw_reference, resolved_url, candidate_key et decision_reason explique la décision. Il révèle aussi un extracteur qui tronque une adresse ou ignore sa base. Ne garder que la liste finale des visites fait perdre ces preuves de découverte.
Doublons d’URL et doublons de document sont des questions distinctes. Deux adresses peuvent renvoyer des corps identiques ; une adresse peut changer de contenu dans le temps. Un hash de contenu peut étayer une décision de stockage ou de détection des changements, mais ne prouve pas que les deux identités URL soient fusionnables pour tous les usages. La frontière doit suivre la règle d’identité déclarée et conserver séparément la comparaison de contenu si nécessaire.
Choisir la prochaine requête et expliquer l’arrêt
La frontière réunit les URL en attente et l’état nécessaire à leur planification. Ce n’est pas forcément une seule file en mémoire. Un petit script peut employer une file et un ensemble ; un service plus grand peut persister le travail entre workers. Les deux doivent distinguer travail découvert, en file, en cours, reporté et terminé.
Dans le catalogue fictif, /catalog/archive/ peut être en file tandis que /catalog/season/item-7 attend un instant autorisé. La prochaine requête est choisie parmi les travaux en attente admissibles. Le parcours en largeur tend à visiter d’abord les liens proches des URL initiales ; une politique de priorité peut favoriser une section définie par le propriétaire. Aucun ordre ne garantit une couverture complète avec des pages inaccessibles ou un espace d’URL qui s’étend.
| État de l’élément | Ce que sait l’exécution | Travail restant |
|---|---|---|
queued | Le candidat a passé les contrôles d’admission actuels | L’attribuer à une récupération admissible |
running | Un worker possède une tentative | Terminer ou récupérer cette tentative |
deferred | Du travail reste, mais ne peut pas encore s’exécuter | Réévaluer à l’instant ou à la condition enregistrés |
finished | L’URL a atteint un résultat terminal déclaré | Conserver réponse et résultat de traitement |
rejected | Une politique enregistrée a exclu le candidat | Garder le motif sans compter une récupération |
Ce sont des états de registre proposés, pas un standard de framework. Un échec de worker ne doit pas transformer silencieusement running en finished. Un ordonnanceur persistant peut utiliser un bail ou un autre mécanisme explicite de possession pour rendre le travail interrompu récupérable. La reprise exige aussi une protection contre les doublons : retenter une opération abandonnée ne doit pas créer deux propriétaires simultanés de la même clé.
Évitez un ensemble général où « vu signifie terminé ». Si l’URL est marquée vue à sa découverte mais que son écriture dans la file échoue, elle peut disparaître des découvertes suivantes sans jamais être récupérée. L’admission doit laisser un résultat durable, en attente ou rejeté. Une requête échouée n’est pas davantage terminée parce que son URL a déjà été observée. Le registre distingue découverte répétée et état courant du travail.
L’arrêt demande plus qu’une file immédiate vide. Les éléments reportés, tentatives en cours et réponses non traitées peuvent encore produire du travail. Une exécution bornée doit indiquer si elle s’est arrêtée parce que tout travail admis est terminal, qu’une limite de temps ou de pages est atteinte, qu’un opérateur le demande ou qu’un échec de politique empêche la poursuite. Ces résultats justifient des affirmations de couverture différentes.
Par exemple, si /catalog/archive/ est terminé mais qu’item-7 reste reporté, l’affirmation défendable est « aucune requête n’est admissible maintenant ; une URL admise reste en attente ». Pas « le catalogue est complet ». Quand toutes les URL admises sont terminales, rapportez périmètre, entrées et décomptes par résultat terminal. Une liste indépendante fournie par le propriétaire permet ensuite une comparaison de couverture ; la frontière ne révèle pas les pages jamais découvertes.
FAQ
Tous les robots d’exploration utilisent-ils un navigateur ?
Non. Un client HTTP et un analyseur peuvent découvrir les liens présents dans le HTML reçu. Le navigateur est utile si la tâche dépend du document rendu ; il a toujours besoin d’une politique externe de découverte et de planification.
Le robot a-t-il terminé après avoir visité l’accueil ?
Seulement si cette URL unique constitue la tâche déclarée. Pour découvrir un catalogue, la réponse initiale crée normalement d’autres candidats, dont l’admission et les résultats terminaux doivent être enregistrés.
Un lien canonical ordonne-t-il de supprimer une autre URL ?
Une déclaration canonical ne remplace pas la règle d’identité de récupération du projet. Conservez la déclaration observée et décidez de son effet sur la tâche. Ne la traitez pas automatiquement comme une autorisation, une redirection HTTP ou une preuve de réponses identiques.
Sources
- Google Search Central : fonctionnement de la recherche
- Projet Scrapy : architecture
- RFC 9309 : protocole d’exclusion des robots
- Google Search Central : principes de SEO JavaScript
- MDN : constructeur URL()
- MDN : Node.baseURI
- BotBrowser : démarrage
- BotBrowser : usage responsable
Conclusion pratique
Donnez à une exploration autorisée du catalogue une liste de départ, un périmètre et une condition d’arrêt finie. Pour chaque référence découverte, conservez sa source, son URL résolue et le motif d’admission ; pour chaque URL admise, les résultats de récupération, d’analyse et de planification. Ces relevés rendent les cinq étapes explicables, y compris les URL refusées ou reportées. Le navigateur peut fournir le document rendu si nécessaire, tandis qu’autorisation, politique de découverte et finalisation restent à la charge de l’opérateur.
Cet article fait partie du guide : Débuter avec l'automatisation du navigateur : carte initiale
Articles Connexes
Web crawler vs web scraper : résultats et erreurs
DémarrageExploration web : budget et respect du site
DéploiementScraping et robots.txt : règles, blocages et échecs HTTP
DémarrageScraping Instagram : vérifier l’accès API
DémarrageEmpreinte du navigateur : les limites de Scrapy
DémarrageConfigurer browser-use avec un navigateur contrôlé
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.