Scraping d’offres d’emploi : titres, reposts et clôture
Construisez un enregistrement d’ingestion inter-sites : conservez les champs bruts et normalisés, séparez les reposts et traitez l’absence comme une observation.
BotBrowser Team
Vous voulez la documentation structurée pour Déploiement ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
Le scraping d’offres d’emploi devient un problème de modèle de données dès que plusieurs sites publient le même poste. Des titres identiques n’identifient pas un emploi, une nouvelle URL ne prouve pas un nouveau poste et une ligne qui cesse d’apparaître ne prouve pas que l’employeur l’a fermé. BotBrowser fournit des entrées de navigateur documentées et fondées sur un profil pour une observation autorisée ; il ne fournit pas de données d’emploi, ne se connecte pas à votre place et n’accorde pas l’accès à un site. Choisissez une source autorisée, conservez les champs bruts à côté de toute normalisation et rendez explicites chaque occurrence et chaque résultat d’observation.
Résumé
- Conservez les chaînes brutes de titre, employeur et lieu à côté des valeurs normalisées, avec une version de règle.
- Indexez chaque enregistrement par l’occurrence de publication de la source. Un repost exige une preuve de continuité avant de remplacer l’occurrence précédente.
- Traitez
datePosted,validThroughet le moment d’observation comme des faits distincts aux sens distincts. - Un rafraîchissement échoué est un incident. L’absence d’une liste limitée est une absence, pas la preuve qu’un poste a été fermé.
- Préférez un flux officiel ou un export approuvé lorsqu’il existe. Le vocabulaire et l’éligibilité des données structurées n’autorisent pas la collecte.
Sommaire
- Séparer les trois problèmes de normalisation
- Conserver les champs bruts et les versions de mapping
- Décider quand un repost est une nouvelle occurrence
- Détecter la clôture sans l’inventer
- Utiliser un schéma d’ingestion minimal
- Choisir une source approuvée avant une route de navigateur
- Conclusion pratique
Séparer les trois problèmes de normalisation
Les données d’emploi inter-sites exigent trois décisions distinctes, et les fusionner dans une seule étape de nettoyage fait perdre les preuves nécessaires plus tard.
Titre. « Senior Engineer », « Sr. Engineer, Platform » et « Engineer III » peuvent décrire une ancienneté comparable ou des périmètres différents. Normalisez un champ séparé pour un objectif déclaré, par exemple une famille de rôles grossière, tout en conservant le titre source. N’écrasez pas le titre avec le libellé normalisé.
Lieu. « Remote », « Remote, US », « New York, NY (Hybrid) » et un nom de ville dans un champ libre répondent à des questions différentes. Conservez le texte brut, puis enregistrez les champs réellement fournis : pays, région, ville, portée du télétravail et modalité. Un pays manquant n’autorise pas à le déduire de la langue du navigateur ou de la région du proxy.
Employeur. Une marque, une entité juridique, une agence de placement et un libellé propre au site ne sont pas interchangeables. Conservez le libellé source et toute référence d’organisation fournie. Des noms similaires peuvent désigner des entités distinctes, et un employeur peut publier par plusieurs canaux.
Enregistrez les trois décisions de mapping dans des champs distincts, comme title_family, location_parts et employer_ref, chacun avec sa version de règle. Un champ unique cleaned_title ou city masque quelle partie a été fournie et laquelle a été déduite. Gardez les chaînes brutes à côté de ces champs et un état inconnu explicite lorsque la source ne répond pas. Une comparaison ultérieure reste ainsi vérifiable sans reconstruire la réponse d’origine.
Le contrat de champs d’emploi établit comment un site expose champs et observations. Ce pipeline commence après ce contrat et ajoute un enregistrement inter-sites avec la source, le champ d’origine et la version de règle de chaque valeur mappée.
Conserver les champs bruts et les versions de mapping
La normalisation est une décision d’application, donc l’enregistrement doit montrer l’entrée et la règle qui l’a modifiée. Le vocabulaire JobPosting de schema.org décrit une annonce de poste et définit notamment datePosted comme la date de publication d’une annonce en ligne. Il fournit des sens à comparer, pas une règle d’extraction pour tous les sites.
| Champ | Conserver | Limite |
|---|---|---|
| Source | Identité du site ou flux et portée du jeu de données | Des valeurs égales de sources différentes ne sont pas automatiquement la même publication |
| Clé de publication | Identifiant fourni par le fournisseur lorsqu’il existe | Une URL ou un titre n’est pas automatiquement une clé stable |
| Titre brut | Chaîne exacte de la source dans la rétention permise | Ne le remplacez pas par un libellé normalisé |
| Lieu brut | Texte exact et parties structurées fournies | Ne déduisez pas un pays manquant des paramètres régionaux ou du proxy |
| Libellé d’employeur | Texte employeur ou organisation fourni | Marque, entité juridique et agence restent distinctes sans preuve |
| Champs normalisés | Valeur, identifiant de règle et version de mapping | Un changement de mapping ouvre une autre interprétation, pas une réécriture silencieuse |
| Publication et expiration | datePosted et validThrough fournis | Aucun n’établit la date de pourvoi du poste ni une clôture confirmée |
| Observation | Moment de collecte, état de la source et résultat d’acceptation | Le moment de collecte n’est ni publication, ni expiration, ni transaction |
La documentation Google JobPosting décrit des données structurées pouvant rendre une annonce éligible à une expérience de recherche d’emploi, et cite notamment identifier, datePosted, validThrough, employmentType, hiringOrganization et jobLocation. L’éligibilité ne garantit ni exactitude, ni permission d’accès, ni balisage identique entre sites. Utilisez le vocabulaire pour nommer les champs, puis ne mappez que ce que la source approuvée renvoie réellement.
Versionnez la règle de mapping. Si « Senior » change de famille de rôles, un ancien enregistrement ne doit pas sembler avoir toujours utilisé la nouvelle règle. Une série normalisée peut être reconstruite à partir des valeurs brutes et d’une règle enregistrée ; écraser les champs bruts détruit cette capacité. Ne conservez que ce que l’accord de source permet, dans la même limite de rétention approuvée que l’enregistrement normalisé.
Cela compte surtout lorsque deux sites décrivent le même rôle dans des formats différents. L’un peut fournir ville et pays structurés, un autre les regrouper dans un champ texte, un troisième omettre le pays tout en nommant une zone métropolitaine. Une comparaison normalisée reste utile, mais elle exige une règle indiquant ce qui a été déduit et ce qui a été fourni. Consignez le chemin du champ source ou l’emplacement de la réponse pour chaque valeur mappée, afin qu’un relecteur voie si le pays vient du fournisseur ou d’une supposition de l’application. Si la source ne fournit aucun pays et que le mapping en exige un, la valeur normalisée reste inconnue. Ne substituez ni les paramètres régionaux du navigateur, ni la région du proxy, ni la langue de l’interface : ils décrivent l’environnement d’observation, pas l’emploi.
La normalisation des employeurs exige la même traçabilité. Un site peut libeller la même organisation par un nom affiché, un nom légal ou une agence. Un identifiant d’organisation fourni par la source est plus fort qu’une correspondance de nom, mais reste propre à cette source. Consignez le libellé, l’identifiant et la règle qui relie deux enregistrements. Gardez visible une relation peu sûre plutôt que de la réduire à une seule ligne d’employeur. Cela préserve la comparaison des comptes par source et la possibilité de retirer une correspondance lorsque de nouvelles preuves montrent deux organisations.
Les champs normalisés doivent aussi porter une confiance ou un état de résolution lorsque le mapping n’est pas décisif. Une famille de rôles peut être mapped, un lieu partial, un employeur unresolved. Ces états distinguent « non fourni » de « pas encore interprété ». Conservez-les dans les exports et rapports afin qu’un analyste ne traite pas silencieusement une valeur non résolue comme propre.
Décider quand un repost est une nouvelle occurrence
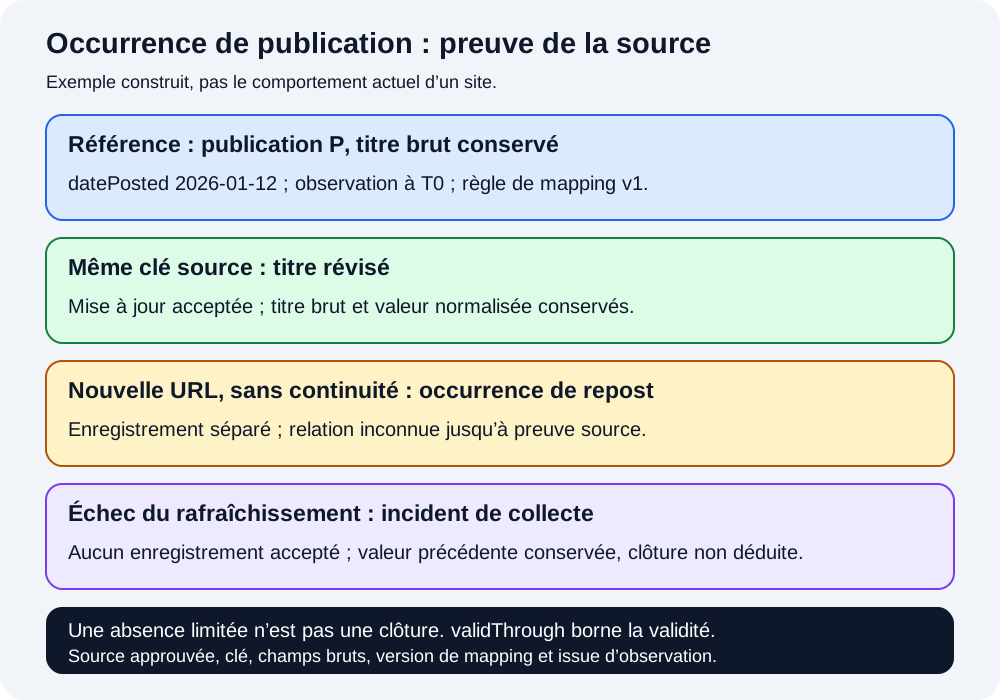
Un site peut republier un rôle avec une nouvelle URL, un nouvel identifiant interne ou un titre modifié. Aucun de ces changements ne prouve seul un nouveau poste, et aucun ne prouve la continuité. Gardez l’occurrence séparée sauf si la source approuvée établit une relation.
| Observation construite | Preuve de la source | Relation acceptée |
|---|---|---|
| Même clé, titre révisé | Clé inchangée ; la source fournit la mise à jour | Même occurrence avec une révision de champ observée |
| Nouvelle URL, même employeur et titre visibles | URL modifiée ; aucun champ de continuité | Relation non résolue ; occurrence séparée jusqu’à preuve |
| Nouvelle clé, source signalant un remplacement | La source relie explicitement la nouvelle annonce à l’ancienne | Occurrence liée ; conserver les deux clés et la relation |
| Même titre et ville sur un autre site | Autre source, aucune clé partagée | Occurrence d’une autre source ; ne pas fusionner sur titre et lieu |
Le tableau est construit, pas un comportement mesuré. Le modèle d’annonces immobilières applique la même discipline : une occurrence d’annonce, le bien physique et une offre sont distincts. Pour l’emploi, une occurrence de publication, le rôle de l’employeur et la candidature d’une personne le sont aussi.
Utilisez une clé propre à la source lorsqu’elle existe et consignez pourquoi une correspondance est acceptée ou laissée ouverte. Une correspondance approximative sur titre, employeur et lieu peut proposer une paire candidate, mais une proposition ne prouve pas la continuité. Conservez les deux clés et le libellé de relation. Quand une déduplication fusionne des enregistrements, consignez la règle et la preuve afin qu’un audit ultérieur puisse séparer deux postes réellement différents qui partageaient un titre.
Un libellé de relation doit survivre à un rafraîchissement. Consignez same_occurrence, related_occurrence ou unknown, et stockez la preuve : clé partagée, champ de remplacement explicite ou référence canonique fournie. Ne déduisez pas le libellé du seul titre normalisé courant. Un titre peut changer dans une annonce, tandis qu’un titre identique peut accompagner une ouverture nouvelle. La relation décrit la continuité de la source, pas la similarité du texte.
Si un site fournit à la fois un identifiant de publication et un identifiant d’emploi, gardez-les séparés. Le premier peut changer lors d’un repost alors que le second reste stable, ou l’inverse selon le modèle de source. N’en conserver qu’un perd la distinction nécessaire à la déduplication. Si aucun n’est fourni, gardez l’URL et le moment d’observation comme preuves, mais marquez l’occurrence provisoire. Un enregistrement provisoire reste utile dans une analyse limitée ; il ne doit pas rejoindre un rôle canonique permanent sans preuve supplémentaire.
Stockez la référence source à côté de la clé plutôt que de la remplacer. Une URL peut changer via des paramètres de suivi, des préfixes de langue ou une migration, et une ancienne URL peut rediriger. Conservez la référence réellement observée et une forme normalisée de comparaison séparément. Une redirection peut signaler une relation à examiner, sans prouver que la cible est la même publication. Traitez-la comme une question à la source, non comme une règle sur la chaîne URL.
Détecter la clôture sans l’inventer
Le guide d’expiration Google indique que les annonces qui n’acceptent plus de candidatures doivent expirer, et cite plusieurs moyens : renseigner validThrough dans le passé, retirer la page avec un 404 ou 410, ou supprimer les données structurées JobPosting. Cela décrit une obligation de l’éditeur envers une expérience de recherche. Un collecteur qui observe une carte absente ou une réponse modifiée n’a pas nécessairement observé l’un de ces événements.
| Événement construit après la référence | Observation | Interprétation acceptée |
|---|---|---|
| Mise à jour de champ acceptée | Même clé ; titre ou lieu révisé fourni | Révision observée ; aucune nouvelle entreprise ni vacance affirmée |
| Repost avec nouvelle URL | Nouvelle référence ; aucune preuve de continuité | Occurrence séparée à relation non résolue |
| Échec du rafraîchissement | Aucun enregistrement accepté | Incident de collecte ; ne pas supprimer la valeur acceptée |
| Carte absente d’une liste limitée | Fenêtre valide ; cible non observée | Absence limitée ; clôture non établie |
datePosted décrit la publication d’une annonce en ligne, validThrough une limite de validité, et le moment d’observation le moment où l’application a regardé. Un validThrough dépassé peut soutenir une expiration si le sens source est connu, mais ne montre pas quand le poste a été pourvu. Une ligne absente soutient « non observé dans cette fenêtre », pas « fermé ». Une page de défi, un délai dépassé ou un rejet d’analyseur sont un incident, pas un résultat vide réussi.
Un jeu de test propre peut rejouer les quatre lignes sans collecter de site réel. Exigez une révision acceptée, une occurrence de repost séparée, un incident de rafraîchissement et une absence limitée. Refusez toute sortie qui transforme les quatre en clôtures. Cela vérifie la logique de l’application ; cela ne mesure pas la cadence d’un site ni ne prouve qu’un poste est ouvert.
La détection de clôture exige aussi une limite temporelle. Une annonce peut disparaître d’un résultat parce que la fenêtre de requête a bougé, la liste a été tronquée ou l’ordre a changé. Consignez la portée de la requête ou du flux, la plage de pages demandée et le moment d’observation. Si le collecteur n’a regardé que la première page, l’absence de cette page n’est pas l’absence du site. Si une liste change d’ordre entre deux observations, un élément manquant peut être un artefact de pagination. Gardez ces issues séparées d’un état d’expiration fourni par la source.
L’état de la source prime sur une inférence de l’application. Si la source approuvée renvoie un état explicite de clôture ou d’expiration, consignez-le avec le nom du champ et le moment d’observation. Si elle renvoie une réponse de retrait, consignez-la séparément d’une liste vide réussie. Si elle ne renvoie rien d’utilisable à cause d’un défi, d’un délai ou d’un corps mal formé, consignez un incident. L’application peut alors produire une vue de cycle de vie « expiré confirmé par la source », « non observé dans cette fenêtre » ou « inconnu », au lieu de réduire toute disparition à une clôture.
Les enregistrements historiques doivent conserver les preuves disponibles à ce moment. Un contrat source ultérieur peut ajouter un champ de statut, mais cela ne transforme pas rétroactivement une ancienne absence en clôture. Gardez ensemble le résultat d’observation et la version du schéma source. Lorsqu’il change, ouvrez une nouvelle série d’interprétation ou réconciliez explicitement les anciens enregistrements. C’est la même discipline que pour les champs normalisés : un changement de règle ne doit pas ressembler à un changement du monde.
Utiliser un schéma d’ingestion minimal
Un petit enregistrement garde les décisions vérifiables :
source_namespace, source_posting_key, raw_title, raw_location,
raw_employer_label, employer_ref, normalized_title, normalized_location,
normalization_rule_version, date_posted, valid_through,
query_scope, page_range, source_schema_version,
observed_at, observation_outcome, relation_to_prior_occurrence
Le schéma est un enregistrement d’application, pas un format obligatoire. Un champ manquant reste nul ou inconnu plutôt que de recevoir une valeur devinée. Gardez l’issue de la réponse source séparée du cycle de vie interprété. Si deux observations partagent une clé d’occurrence, leurs révisions sont comparables ; sinon, la relation reste ouverte jusqu’à preuve source.
La limite d’accès aux sites d’emploi sépare les pages publiques des données de candidats authentifiées. Un schéma d’ingestion ne modifie pas cette limite. Profils, candidatures et messages restent hors périmètre même si une session de navigateur pouvait les atteindre. Préférez un flux officiel ou un export approuvé et arrêtez-vous sans permission ni preuve nécessaire.
Choisir une source approuvée avant une route de navigateur
La RFC 9309 indique que les règles robots ne constituent pas une autorisation d’accès. Une page publique autorisant le crawl peut ne pas autoriser la construction d’un jeu de données de marché ni la redistribution. Les conditions du site et un véritable accord de données décident de la collecte et de la rétention. Une réponse de navigateur réussie n’est pas une permission.
La documentation BotBrowser sur fuseau, paramètres régionaux et langue décrit des entrées de langue, fuseau et paramètres régionaux avec détection automatique et dérogations manuelles. Ces réglages rendent explicite un environnement d’observation autorisé ; les dérogations manuelles exigent une licence ENT Tier1. Ils n’établissent pas le lieu d’un emploi, le pays d’un employeur ni le sens du texte de lieu d’un site.
La référence de configuration des profils documente des paquets de profil configurables, dont le paquet doit correspondre à la version majeure, la priorité de configuration et la disponibilité des champs. Un profil peut rendre reproductibles les entrées déclarées du navigateur ; il ne se connecte pas, n’accorde pas de licence de données et ne garantit pas les mêmes annonces entre exécutions. Consignez profil et conditions à côté des enregistrements acceptés, et gardez l’accord source comme autorité d’accès et de rétention.
Questions fréquentes
Peut-on fusionner des titres identiques de deux sites en un seul emploi ?
Seulement avec une preuve source qu’ils décrivent la même publication ou le même rôle. Un texte identique est un candidat à examiner, pas une preuve. Conservez chaque occurrence et une relation ouverte explicite jusqu’à établir la continuité.
Une annonce disparue d’une liste signifie-t-elle que le poste est fermé ?
Non. Une liste limitée peut omettre une annonce pour de nombreuses raisons, et un échec de rafraîchissement n’est pas un résultat vide. Consignez l’absence et exigez une preuve source, comme un état d’expiration ou une réponse de retrait, avant d’attribuer une clôture.
Faut-il utiliser datePosted comme moment de collecte ?
Non. C’est la date de publication d’une annonce en ligne. Gardez le moment d’observation, datePosted et validThrough comme champs séparés avec leurs sens propres.
BotBrowser fournit-il des offres ou une permission de collecte ?
Non. Il fournit des entrées de configuration documentées. Il ne fournit pas de données d’emploi, ne se connecte pas, n’accorde pas l’accès et n’établit pas les conditions d’un site ; utilisez une source approuvée et ne conservez que ce que l’accord permet.
Sources
- schema.org JobPosting
- Données structurées JobPosting de Google
- RFC 9309
- BotBrowser : fuseau, paramètres régionaux et langue
- Configuration des profils BotBrowser
Conclusion pratique
Construisez un enregistrement d’emploi permis autour d’occurrences de publication propres à la source. Conservez valeurs brutes et normalisées avec une version de mapping, séparez les reposts jusqu’à preuve de continuité et traitez publication, expiration et observation comme des faits distincts. Classez échecs et absences limitées sans inventer de clôtures. Les entrées du navigateur rendent reproductible une observation autorisée ; la source approuvée et son accord déterminent les données disponibles, leur sens et l’historique conservable.
Cet article fait partie du guide : Déploiement et livraison du navigateur : carte opérationnelle
Articles Connexes
Scraping Indeed : champs, pages et doublons
DéploiementScraping d’offres d’emploi : limites du navigateur
DéploiementZillow scraping : identifiants, prix et historique
DéploiementPrix des concurrents : concevoir la collecte
DéploiementGoogle Maps : Places API ou listes affichées ?
DéploiementScraping Amazon : données et limites du navigateur
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.