Scraping et robots.txt : règles, blocages et échecs HTTP
Vérifiez robots.txt avant une tâche de navigateur : choisissez le groupe du crawler et distinguez politique et accès HTTP.
BotBrowser Team
Vous voulez la documentation structurée pour Déploiement ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
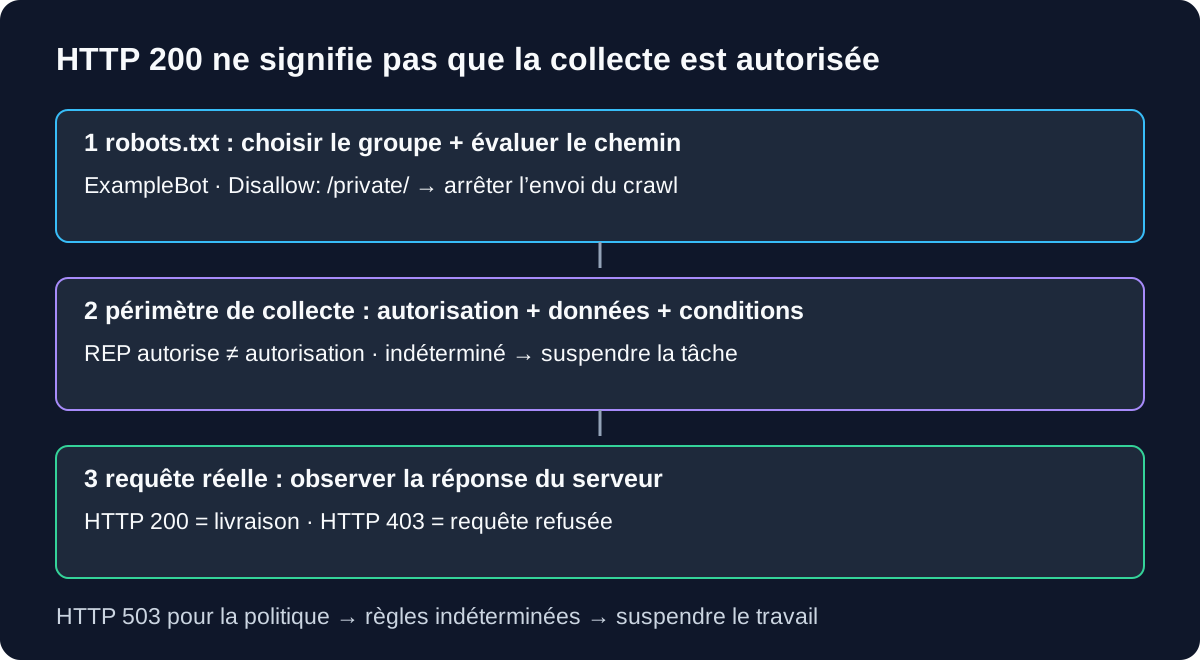
Une page qui renvoie HTTP 200 ne suffit pas à trancher une décision de scraping au regard de robots.txt. Le serveur peut transmettre un document interdit par les règles publiées pour les crawlers. BotBrowser prend en charge les intégrations d’automatisation de navigateur, mais ne remplace pas l’évaluateur robots.txt de l’application et n’autorise pas la collecte d’une page.
Résumé
- Évaluez les règles applicables au jeton de produit déclaré par le crawler avant d’envoyer la requête cible.
- Combinez les groupes nommés correspondants ; utilisez
User-agent: *uniquement si aucun groupe nommé ne correspond. - Résolvez les chemins correspondants selon leur spécificité, et non selon la position de la première règle.
- Traitez la règle robots, l’autorisation de collecte et la réponse HTTP réelle comme des décisions distinctes.
- Suspendez tout nouvel envoi lorsque la récupération de la politique reste indéterminée ; une erreur HTTP ne justifie pas un changement d’identité.
Sommaire
- Distinguer politique, autorisation et livraison
- Choisir le groupe du crawler avant l’URL
- Exécuter un exemple limité de correspondance
- Traiter robots avant la page
- Inscrire la décision dans la file de requêtes
- Conclusion pratique
Distinguer politique, autorisation et livraison
Le protocole d’exclusion des robots, RFC 9309, définit un moyen pour les propriétaires de services de publier des règles destinées aux crawlers. C’est un mécanisme de coordination : un crawler participant récupère /robots.txt, sélectionne les règles applicables et s’en sert pour décider quelles ressources demander. Le serveur n’a pas à consulter ce fichier à chaque requête reçue. Un navigateur peut donc obtenir HTTP 200 pour un document interdit. Cela correspond à la conception du protocole ; ce n’est pas la preuve que la règle a cessé de s’appliquer.
Un compte rendu d’incident doit distinguer trois questions. Premièrement, la règle robots applicable autorise-t-elle cette URL pour ce crawler déclaré ? Deuxièmement, l’équipe a-t-elle établi un fondement approprié pour la collecte, compte tenu des conditions du service, de l’autorisation, du périmètre des données et des obligations applicables ? Troisièmement, qu’a réellement renvoyé le serveur ? L’évaluation d’une règle ne répond pas à la deuxième question, et une réponse réussie ne répond à aucune des deux premières.
| Observation | Ce qu’elle établit | Ce qu’elle n’établit pas | Prochaine action sûre |
|---|---|---|---|
Disallow: /private/ correspondant | La règle REP applicable interdit les chemins correspondants | Que le serveur rejettera une requête manuelle | Retirer ces chemins de la file de crawl |
| Aucune règle de chemin correspondante | REP n’interdit pas cette URL dans le groupe sélectionné | Une autorisation, une licence de collecte ou un quota | Appliquer la politique de collecte approuvée séparément |
| HTTP 200 de la cible | La cible a renvoyé une réponse HTTP réussie | Le respect de robots, l’exhaustivité des données ou une autorisation juridique | Séparer les résultats de politique et de validation du contenu |
| HTTP 403 de la cible | Le serveur a refusé cette requête | Quelle règle robots, quel signal d’identité ou quel produit de sécurité a causé le refus | Arrêter et diagnostiquer à partir d’éléments autorisés |
La dernière ligne relève du diagnostic par couche d’un scraper bloqué : elle distingue un échec DNS ou de connexion d’une réponse HTTP et d’un problème de données de page. L’évaluation robots intervient avant cette requête, tandis que le diagnostic d’incident explique un résultat ultérieur. Confondre ces étapes mène à des affirmations trompeuses comme « robots a bloqué le navigateur » alors que les seuls éléments disponibles sont HTTP 403.
Le RFC 9309 avertit également que la publication de chemins les rend accessibles à tous. Le propriétaire du service doit protéger les ressources confidentielles avec des contrôles d’accès adaptés ; Disallow n’est pas une authentification. Inversement, la visibilité d’un chemin n’invite pas un crawler à le récupérer. Pour un parcours autorisé sur une boutique, les limites des collections Shopify distinguent une page observée des données et du périmètre d’accès réellement nécessaires à la collecte. Ce périmètre reste important même après validation de la règle.
Choisir le groupe du crawler avant l’URL
Un enregistrement User-agent identifie le jeton de produit d’un crawler, pas une empreinte complète ni automatiquement l’intégralité de l’en-tête User-Agent du navigateur. Le RFC 9309 exige une comparaison du jeton de produit sans distinction de casse. Le jeton doit figurer dans la chaîne d’identification du crawler, qui devrait décrire son objectif. Choisissez un jeton honnête et stable pour l’application de collecte ; ne passez pas au groupe d’un moteur de recherche nommé simplement parce que ses règles diffèrent.
Considérez ce fichier synthétique sur un service d’exemple que vous possédez :
User-agent: *
Disallow: /catalog/

User-agent: ExampleBot
Disallow: /catalog/private/
Allow: /catalog/private/help/

User-agent: examplebot
Disallow: /exports/
Allow: /exports/public/
Pour ExampleBot, les deux groupes nommés correspondent sans tenir compte de la casse, donc leurs règles sont combinées. Le groupe générique n’est pas ajouté à ces groupes nommés. Pour un autre crawler sans groupe nommé correspondant, User-agent: * fournit les règles applicables. Si aucun groupe nommé ni générique ne s’applique, aucune règle de groupe ne s’applique. Aucun de ces résultats n’établit une autorisation de collecte au-delà de REP.
Cette distinction modifie le résultat pour /catalog/item : le groupe générique l’interdit, tandis que les règles combinées de ExampleBot ne correspondent pas à ce chemin. Pour ce même crawler nommé, /catalog/private/item correspond à une règle d’interdiction et /catalog/private/help/start correspond à la fois à une interdiction et à une règle Allow plus longue. Un parseur qui fusionnerait simplement tous les groupes produirait une décision différente pour /catalog/item. Un parseur qui s’arrêterait au premier groupe nommé correspondant manquerait entièrement /exports/.
N’assimilez pas le jeton de produit à la chaîne de navigateur qu’un outil de test envoie par hasard. Un processus de navigateur peut charger une URL sans jouer le rôle d’un planificateur complet de crawler. L’application qui gère la découverte des URL, la récupération des politiques, l’interprétation des règles et l’envoi doit expliciter ces responsabilités. La référence d’automatisation BotBrowser décrit la couche d’intégration du navigateur ; elle ne prouve pas qu’une bibliothèque ait implémenté REP à votre place.
Correspondre à un service, pas à toute une organisation
Le fichier de règles est /robots.txt, à la racine du service. Consignez le schéma et l’autorité avec son URL : https://example.test/robots.txt n’est pas une récupération de politique pour tous les noms d’hôte, ports et protocoles associés à cette organisation. Ne copiez pas une décision Allow d’une origine dans la file d’une autre. La navigation relative, les sous-domaines et les redirections peuvent modifier le contexte du service, même si la marque visible reste identique.
Le RFC 9309 indique que les crawlers devraient suivre au moins cinq redirections robots consécutives, y compris entre autorités. Lorsque le fichier est atteint au terme de cette chaîne, ses règles s’appliquent dans le contexte de l’autorité initiale. Consignez l’URL de politique demandée et l’URL finale de la réponse. Sinon, un cache indexé uniquement par l’hébergement final pourrait associer par erreur les règles d’un site à la file de cibles d’un autre.
Exécuter un exemple limité de correspondance
La correspondance des chemins commence au début du chemin cible. Le RFC 9309 retient la règle correspondante la plus spécifique, mesurée en octets ; la comparaison des chemins respecte la casse. En cas d’égalité entre des règles Allow et Disallow équivalentes, la règle Allow devrait s’appliquer. L’ordre des lignes ne constitue donc pas une méthode de décision fiable. Le protocole définit également *, le marqueur terminal $, les commentaires et le comportement de l’encodage en pourcentage, que toute implémentation de production doit gérer.
L’exemple Node.js suivant isole uniquement la sélection du groupe et la correspondance littérale de préfixes ASCII. Les groupes sont déjà des enregistrements analysés provenant du fichier synthétique ci-dessus. Le programme rejette volontairement les chemins avec caractère générique, marqueur terminal, encodage ou caractères non ASCII, au lieu de prétendre implémenter le reste du RFC 9309. Il n’effectue aucune requête réseau et ne teste pas la politique d’un site actif. Collez-le dans un fichier .mjs local et exécutez-le avec node.
import assert from 'node:assert/strict';

const groups = [
  { agent: '*', rules: [['disallow', '/catalog/']] },
  {
    agent: 'ExampleBot',
    rules: [
      ['disallow', '/catalog/private/'],
      ['allow', '/catalog/private/help/'],
    ],
  },
  {
    agent: 'examplebot',
    rules: [
      ['disallow', '/exports/'],
      ['allow', '/exports/public/'],
    ],
  },
];

function literalDecision(agent, path) {
  const named = groups.filter(g => g.agent.toLowerCase() === agent.toLowerCase());
  const selected = named.length ? named : groups.filter(g => g.agent === '*');
  const rules = selected.flatMap(g => g.rules);
  for (const value of [path, ...rules.map(r => r[1])]) {
    if (!value.startsWith('/') || /[^\x20-\x7e]|[%*$?#]/.test(value)) {
      throw new Error('literal ASCII paths only');
    }
  }
  const matches = rules.filter(([, prefix]) => path.startsWith(prefix));
  matches.sort((a, b) => b[1].length - a[1].length || Number(b[0] === 'allow') - Number(a[0] === 'allow'));
  return !matches.length || matches[0][0] === 'allow';
}

const cases = [
  ['ExampleBot', '/catalog/item', true],
  ['OtherBot', '/catalog/item', false],
  ['ExampleBot', '/catalog/private/item', false],
  ['ExampleBot', '/catalog/private/help/start', true],
  ['ExampleBot', '/exports/file', false],
  ['EXAMPLEBOT', '/exports/public/file', true],
  ['ExampleBot', '/Catalog/private/item', true],
];
for (const [agent, path, allowed] of cases) {
  const actual = literalDecision(agent, path);
  assert.equal(actual, allowed, `${agent} ${path}`);
  console.log(`${agent} ${path} repAllowed=${actual}`);
}
La sortie emploie le nom repAllowed afin que l’étiquette ne devienne pas discrètement « autorisé ». Les deux premiers cas illustrent la sélection entre groupe nommé et groupe générique. Les deux cas du catalogue privé illustrent la sélection du préfixe le plus long. Les cas exports montrent la combinaison et la comparaison insensible à la casse du jeton. Le dernier cas modifie la casse du chemin URL, pas celle du jeton du crawler. Une étape de normalisation URL qui mettrait tous les chemins en minuscules effacerait cette distinction et pourrait changer les ressources demandées.
Cet exemple limité ne parse pas un fichier texte téléchargé, ne combine pas plusieurs enregistrements de jetons de produit dans un même groupe, ne normalise pas les octets URI, ne suit pas les redirections, ne valide pas de type MIME, ne gère pas la durée du cache et ne choisit pas de stratégie de nouvelle tentative réseau. Il aide seulement à raisonner sur les entrées présentées. En production, choisissez une implémentation REP maintenue, vérifiez la syntaxe prise en charge et testez ces cas avec ceux de l’encodage en pourcentage et de */$. Réussir sept cas ASCII ne prouve pas la conformité au protocole.
Une valeur Disallow vide constitue un autre cas pour un parseur de production, et non une interdiction générale de /. Selon le RFC 9309, le champ de motif du chemin peut être vide ; cela ne crée pas de préfixe interdit couvrant le site. Ne transformez pas une ligne vide en / lors de la normalisation de la configuration. De même, une directive inconnue ne doit ni terminer un groupe valide ni effacer les enregistrements Allow/Disallow analysables qui l’entourent.
Traiter robots avant la page
Une requête cible et une requête robots sont deux événements distincts. Enregistrez policyStatus et targetStatus dans des champs séparés. Si /robots.txt renvoie HTTP 503, la récupération de politique du crawler reste indéterminée, même si la page cible a renvoyé HTTP 200 hier. Un tableau de bord qui ne conserve que le dernier code HTTP par hôte peut masquer cette distinction et relancer le travail pour une mauvaise raison.
| Résultat de la récupération de politique | Référence RFC 9309 | Décision de l’application de collecte |
|---|---|---|
| Téléchargement robots réussi | Suivre les règles analysables | Évaluer le jeton déclaré et l’URL cible |
| HTTP 404, fichier indisponible | REP peut autoriser l’accès aux ressources | Appliquer les contrôles distincts d’autorisation et de politique de collecte |
| HTTP 401 ou 403, également dans la plage 4xx | La catégorie « indisponible » du RFC ne vaut pas autorisation | Suspendre en attendant une décision explicite ; ne pas déduire un consentement |
| HTTP 429 | Ne pas supposer que tous les crawlers le traitent comme un fichier simplement absent | Arrêter les envois et respecter les indications de limitation du service |
| HTTP 5xx ou échec réseau | Supposer une interdiction complète tant que le fichier est inaccessible | Suspendre les nouveaux travaux et appliquer une reprise limitée |
| Quelques enregistrements mal formés dans un fichier utilisable | Utiliser les règles analysables | Conserver les diagnostics du parseur plutôt que d’abandonner tout le fichier |
La catégorie « indisponible » du RFC couvre HTTP 400-499, tandis que la catégorie « inaccessible » comprend HTTP 500-599 et les erreurs réseau. Cette distinction porte sur le comportement du protocole crawler. Les décisions d’arrêt plus strictes pour HTTP 401, 403 et 429 dans la colonne de droite relèvent de la politique de l’application, pas d’exigences inventées du RFC. La documentation Google sur le traitement de robots distingue aussi HTTP 429 de la plupart des autres réponses 4xx. Le comportement de Googlebot est une documentation éditeur utile, mais pas un algorithme de nouvelle tentative universel pour votre collecteur.
La mise en cache exige également un horodatage. Le RFC 9309 indique qu’un crawler ne devrait pas utiliser une copie en cache pendant plus de 24 heures, sauf si le fichier est inaccessible. Ses recommandations en cas d’inaccessibilité autorisent d’autres choix après un délai raisonnablement long, avec 30 jours comme exemple. Ces réserves ne justifient pas un indicateur « dernière autorisation connue » indéfini sans horodatage de récupération, historique des réponses ou décision de revue. Si un lot reprend après une panne de politique, réévaluez les URL restantes selon les règles actuelles avant de rouvrir les envois.
Crawl-delay ne fait pas partie des règles Allow/Disallow définies par le RFC 9309. Certaines implémentations interprètent des enregistrements supplémentaires, d’autres non. L’absence d’une directive de délai prise en charge ne fournit pas de quota de requêtes. Séparez les décisions de concurrence et de fréquence de l’application du moteur de chemins, et réduisez ou arrêtez les envois si le service signale une limitation. Une règle de chemin permissive ne garantit pas qu’une fréquence soit acceptable.
Inscrire la décision dans la file de requêtes
Le point d’intégration utile est le composant capable d’empêcher une URL d’entrer dans le travail du navigateur. Évaluer robots après la navigation arrive trop tard pour cette requête. Enregistrez la décision avec l’origine, le jeton de produit du crawler, l’heure de récupération de la politique, le groupe sélectionné, la règle correspondante et le périmètre de collecte approuvé séparément. Lorsque les règles de conservation le permettent, gardez le texte de politique ou une empreinte de son contenu afin qu’une enquête ultérieure identifie la version ayant produit la décision.
Un enregistrement d’envoi compact peut utiliser origin, productToken, policyFetchedAt, policyStatus, matchedRule, repDecision et collectionDecision. Même si repDecision=allow, collectionDecision=unresolved maintient la tâche en attente. repDecision=disallow retire la tâche de l’ensemble admissible, même si le navigateur y accédait auparavant. Une panne réseau produit repDecision=unresolved, pas un fichier robots vide inventé. Ces états explicitent les conditions d’arrêt sans assimiler tous les échecs de récupération.
L’application à la file doit aussi tenir compte des requêtes générées par le navigateur. L’ouverture d’un document autorisé peut charger des images, des scripts, des cadres ou des requêtes API en arrière-plan. La vérification de l’URL principale ne prouve pas à elle seule que toutes les sous-requêtes automatiques respectent la politique de collecte. Inventoriez les origines des ressources nécessaires et définissez le périmètre autorisé avant l’envoi ; si le parcours ne peut pas le respecter, arrêtez-vous et choisissez une interface approuvée ou une tâche de collecte plus réduite. N’utilisez pas une page autorisée comme prétexte pour demander des points de terminaison de données interdits.
Pour une collecte multitravailleur, faites publier par l’ordonnanceur une décision de politique par origine et jeton déclaré, plutôt que de laisser chaque travailleur inventer son propre résultat. Invalidez les décisions en file lorsque la version de politique pertinente change. Si le fichier actuel interdit maintenant un chemin déjà placé en file, retirez les tâches non commencées ; ne laissez pas survivre la décision d’hier au seul motif que la session de navigateur reste ouverte. C’est une exigence de cohérence de l’application, pas une propriété d’un profil de navigateur.
Les intégrations d’automatisation documentées par BotBrowser fournissent une cible de navigateur pour une tâche autorisée. Elles ne transforment pas REP en contrôle d’accès, ne choisissent pas le nom de crawler que votre application doit déclarer, n’établissent pas l’autorisation de collecte et ne garantissent pas l’acceptation par une destination. La politique d’utilisation responsable et l’avertissement juridique restent des limites pertinentes. Les réglages du navigateur et un lancement réussi ne remplacent pas une décision de politique encore indéterminée en amont.
Questions fréquentes
Une règle Allow dans robots.txt signifie-t-elle que je peux collecter des données personnelles ?
Non. Une règle Allow résout une décision de chemin au niveau du protocole pour le crawler concerné. La catégorie de données, la finalité, les modalités d’accès, la conservation et les obligations applicables restent des questions distinctes pour l’équipe responsable. REP ne fournit pas de licence d’utilisation des données, et cette distinction technique ne constitue pas un conseil juridique.
Disallow empêche-t-il une URL d’apparaître dans les résultats de recherche ?
Pas nécessairement. L’introduction de Google sur robots distingue le crawl de l’indexation : une URL interdite peut encore être découverte par des liens. La confidentialité d’un document exige une protection d’accès. L’interdiction de crawl n’est pas un substitut fiable à l’authentification ni une instruction universelle de désindexation.
La même décision robots peut-elle être réutilisée après une redirection ?
Consignez séparément les contextes source et destination. Une redirection du fichier robots suit la règle de l’autorité initiale décrite par le RFC 9309 ; une redirection de page cible peut introduire un autre service dont la politique et le périmètre d’autorisation doivent encore être évalués. Ne déduisez pas qu’une redirection transfère une décision Allow ou une autorisation de collecte à un hôte sans lien.
Pourquoi un navigateur ordinaire peut-il ouvrir un chemin interdit par Disallow ?
REP est mis en œuvre par les applications de crawler participantes ; il n’impose pas automatiquement le rejet de chaque navigation dans un navigateur. Le serveur HTTP peut toujours fournir le chemin. Cette réponse prouve la livraison à cette requête, tandis que l’obligation du crawler de suivre ses règles applicables reste une décision distincte.
Sources
- RFC 9309 : Robots Exclusion Protocol, notamment les sections 2.2-2.5 et 3
- Google Search Central : introduction à robots.txt
- Google Search Central : interprétation de robots.txt et traitement HTTP
- Référence de cohérence de l’automatisation BotBrowser
- Utilisation responsable de BotBrowser
- Avertissement juridique BotBrowser
Conclusion pratique
Pour la prochaine décision de scraping avec robots.txt, partez d’un jeton de crawler déclaré, d’une origine de service et d’un chemin cible. Évaluez les règles applicables, séparez l’autorisation de collecte et empêchez les tâches indéterminées ou interdites d’entrer dans la file du navigateur. Une réponse HTTP réussie indique que le serveur a transmis un document ; elle ne remplace pas les décisions qui la précèdent.
Cet article fait partie du guide : Déploiement et livraison du navigateur : carte opérationnelle
Articles Connexes
Scraping Shopify : Storefront API, Ajax ou navigateur ?
RéseauScraper bloqué : erreurs DNS, TLS, HTTP et de page
DéploiementScraping d’offres d’emploi : limites du navigateur
RéseauEn-têtes Fetch Metadata : contexte CSRF et confidentialité
DéploiementPrix des concurrents : concevoir la collecte
PlateformeSpeculation Rules : limites de prefetch et prerender
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.