Scraping légal et conditions : ce qu’une équipe doit décider
Un registre de décisions avant collecte : conditions de la source, périmètre des données, charge des requêtes et conservation, avec le point exact de revue juridique.
BotBrowser Team
Vous voulez la documentation structurée pour Démarrage ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
La plupart des projets de scraping commencent par une question technique et découvrent la question de l’autorisation plus tard, souvent quand quelqu’un demande pourquoi la source a bloqué la tâche. BotBrowser documente l’automatisation de navigateur pour un travail autorisé et exige d’opérer sur des systèmes que l’on possède ou pour lesquels on dispose d’une autorisation écrite explicite de test. Il ne décide pas si une collecte est licite, n’accorde pas la permission de collecter et ne remplace ni une revue des conditions ni un avis juridique.
TL;DR
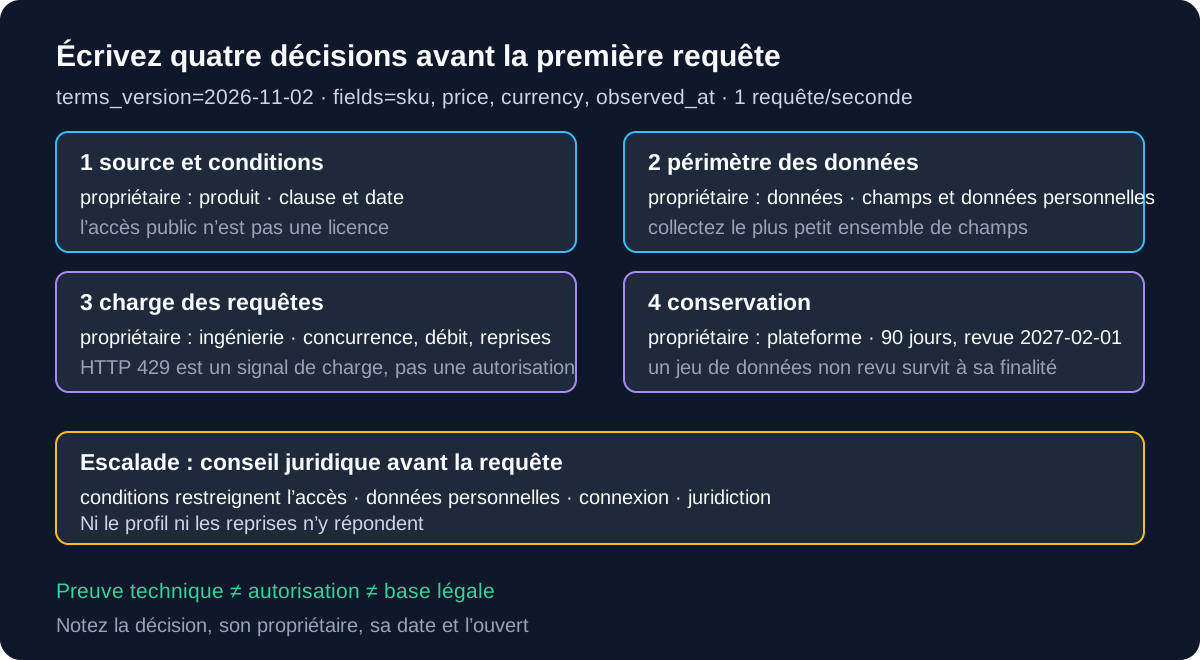
- Écrivez quatre décisions avant la première requête : quelle source et quelles conditions, quelles données, quelle charge et quelle durée de conservation.
- Une règle robots, une limite de débit, une connexion et une décision d’autorisation sont quatre choses différentes. En satisfaire une ne dit rien des autres.
- Un contrôle technique est une preuve de comportement. Ce n’est ni une licence, ni une clause contractuelle, ni une base légale.
- Notez la version des conditions de la source et la date de lecture, pour qu’un changement ultérieur soit visible plutôt que mémorisé.
- Escaladez vers un conseil juridique si la source restreint l’accès automatisé, si les données contiennent des informations personnelles ou si la réponse dépend de la juridiction. Ne réglez pas ces questions avec un réglage du navigateur.
Sommaire
- Quatre décisions avant la première requête
- Lire les conditions au niveau de la clause
- Écrire le registre de décisions
- Séparer le contrôle technique de l’autorisation
- Connaître le point d’escalade
- Conclusion pratique
Quatre décisions avant la première requête
La première décision porte sur la source et sur les conditions qui s’y appliquent. Les conditions de service, un accord d’API, une politique développeur et une licence de données publiques peuvent dire des choses différentes, et changer sans préavis. Notez le document lu, sa version ou sa date de mise à jour et la clause qui compte. « Le site semblait public » n’est pas la trace d’une décision.
La deuxième porte sur les données réellement nécessaires. Une page peut contenir un prix, un avis, une photo de profil, un identifiant et un horodatage. Chacun a une sensibilité et un besoin de conservation différents. Décidez les champs avant l’exploration, pas après l’export, car un export large est difficile à réduire une fois qu’il existe. Gardez le plus petit ensemble de champs qui répond à la question métier.
La troisième porte sur la charge des requêtes. La concurrence, la politique de nouvelle tentative, la fenêtre d’exploration et le débit par origine appartiennent au registre, avec les limites publiées par la source le cas échéant. Une réponse 429 est un signal de charge, et la capacité technique de réessayer ne rend pas un débit plus élevé acceptable. L’article sur les limites de débit et la concurrence pour les scrapers couvre la mécanique ; ce registre décide le budget que la mécanique doit respecter.
La quatrième porte sur la conservation et la suppression. Décidez où vivent les données, qui peut les lire, combien de temps elles restent et ce qui déclenche la suppression. Une collecte sans décision de conservation devient permanente par accident. Notez le propriétaire et la date de revue, car un jeu de données non revu survit au projet qui l’a justifié.
| Décision | Registre | Raccourci erroné |
|---|---|---|
| Source et conditions | Nom du document, date de version, clause pertinente, relecteur | Supposer que l’accès public autorise un usage sans restriction |
| Périmètre des données | Liste des champs, indicateur de données personnelles, finalité, note de minimisation | Exporter la page entière et décider ensuite |
| Charge des requêtes | Concurrence, débit, fenêtre, plafond de nouvelles tentatives, limite de la source | Réessayer jusqu’à ce que ça marche |
| Conservation | Emplacement de stockage, liste d’accès, déclencheur de suppression, date de revue | Tout conserver indéfiniment |
Lire les conditions au niveau de la clause
Une page de conditions n’est pas une phrase. Elle contient généralement une autorisation d’accès, une liste de comportements interdits, une clause de propriété intellectuelle, une limitation de responsabilité et une clause de modification. La clause qui encadre la collecte automatisée peut se trouver dans une liste d’interdictions, dans une section API ou dans un accord développeur séparé. Lire le titre ne revient pas à lire la clause, et un résumé écrit par quelqu’un d’autre n’est pas le document.
Lisez quatre points. D’abord, le document traite-t-il de l’accès automatisé et emploie-t-il des termes comme crawl, scrape, robot, moyens automatisés ou débit ? Ensuite, restreint-il la réutilisation du contenu séparément de l’accès, par exemple en interdisant la redistribution ou la création d’une base dérivée ? Puis, exige-t-il un compte, une clé d’API ou un accord écrit pour les données visées ? Enfin, se réserve-t-il le droit de modifier les conditions et précise-t-il comment un changement est notifié ? Chaque réponse appartient au registre avec le numéro de clause et la date de version.
Une licence de données publiques est un instrument distinct d’une page de conditions. Une licence ouverte peut accorder des droits de réutilisation que la page de conditions n’accorde pas, et une page de conditions peut restreindre des comportements que la licence ne mentionne pas. Si les deux existent, notez les deux et indiquez laquelle l’équipe estime régir l’usage prévu. Cette appréciation relève d’un conseil juridique lorsque les documents se contredisent ; un crawler ne peut pas la trancher en choisissant la lecture la plus permissive.
La même discipline s’applique à une API. Un accord d’API peut autoriser les appels qu’il documente et interdire d’autres collectes, et une limite de débit dans la documentation est une limite opérationnelle, pas une affirmation sur la réutilisation légale. Notez la version de l’API, le point de terminaison, le quota et la clause qui autorise l’usage. Si la tâche exige un champ que l’API ne renvoie pas, c’est une question de périmètre, pas une raison de revenir au scraping de pages sans nouvelle décision.
Les règles robots méritent aussi une lecture précise. La RFC 9309 définit un mécanisme de coordination pour les crawlers qui choisissent d’y participer. Elle ne crée ni licence, ni contrat, ni base légale, et ne supplante pas une page de conditions. Une ligne Disallow peut demander à un crawler déclaré de rester hors d’un chemin ; une ligne Allow peut indiquer que le chemin n’est pas interdit. Aucune des deux ne tranche si la collecte est autorisée, et c’est pourquoi la décision robots et la décision d’autorisation occupent des lignes distinctes.
Écrire le registre de décisions
Un registre utile est assez court pour être relu et assez précis pour être audité. Une ligne par décision, un propriétaire nommé, une date. Il doit montrer ce qui a été décidé, quelles preuves l’ont soutenu et ce qui reste ouvert. Un point ouvert n’est pas un échec ; une hypothèse non consignée en est un.
project=price-watch
source=https://shop.example.test
terms_version=2026-11-02
terms_clause=sections 4 and 9
fields=sku,list_price,currency,observed_at
personal_data=false
load=2 concurrent, 1 request/second, window 02:00-04:00 UTC
retention=90 days, owner=data-platform, review=2027-02-01
counsel_review=not_required (no personal data, no access restriction)
Le registre énonce une décision ; il ne prouve pas que cette décision est correcte. Si la source ajoute une clause, ou si la tâche commence à collecter un champ non approuvé, le registre est périmé et la tâche doit s’arrêter jusqu’à sa révision.
Un registre avec un point ouvert est plus utile qu’un registre avec une supposition assurée. Marquez le point ouvert, nommez la personne qui répondra et fixez la date à laquelle la tâche continue ou s’arrête. Une tâche qui démarre alors qu’un point est ouvert doit se limiter à un fixture synthétique ou à des données déjà détenues par l’équipe, pour que la question ouverte ne devienne pas une collecte de production.
Gardez le registre lisible par machine là où l’équipe dispose déjà d’un schéma. Les noms de champs ci-dessous suffisent pour un petit projet et peuvent être étendus sans changer le sens des existants.
| Champ | Type | Finalité |
|---|---|---|
source | URL | L’origine exacte et le périmètre de chemins que la tâche peut demander |
termsVersion | date | La version ou la date de mise à jour du document lu |
termsClause | string | La clause qui encadre l’accès automatisé ou la réutilisation |
fields | list | L’ensemble de champs approuvé, pas la page entière |
personalData | boolean | Si un champ approuvé peut se rapporter à une personne |
load | object | Concurrence, débit, fenêtre et plafond de nouvelles tentatives |
retentionDays | integer | Combien de temps les données collectées peuvent rester |
owner | string | Le rôle responsable, pas une boîte partagée |
reviewDate | date | Quand le registre doit être relu |
counselStatus | enum | not-required, requested, answered ou stop |
Le champ counselStatus est celui que les équipes oublient. Sans lui, une tâche peut glisser de « nous avons demandé une fois » à « nous avons supposé que c’était bon » sans que personne ne le remarque. Notez la question posée et la réponse reçue, y compris une réponse d’arrêt. Une réponse d’arrêt est un résultat valable et doit mettre fin à la tâche plutôt que déclencher un autre contournement technique.
Séparer le contrôle technique de l’autorisation
Les ingénieurs se tournent souvent vers un signal technique comme s’il réglait la question de l’autorisation. Ce n’est pas le cas. Une requête réussie montre que le serveur a livré une réponse. Une évaluation robots favorable montre ce que disent les règles publiées pour un jeton déclaré. Une connexion montre qu’un compte s’est authentifié. Aucun de ces faits n’est une licence, un droit contractuel ou une base légale, et chacun peut être vrai alors que la collecte reste inappropriée.
L’inverse est vrai aussi. Une requête bloquée ne prouve pas que la collecte est interdite, et une limite de débit n’établit pas une limite légale. Le résultat technique et la question d’autorisation exigent des propriétaires et des preuves distincts. Le registre de décisions robots.txt couvre le côté des règles de crawler, et les limites du scraping de sites d’emploi montrent la même séparation pour une source précise ; il maintient explicitement l’autorisation et la livraison HTTP comme décisions séparées, et cette séparation vaut ici aussi.
BotBrowser documente l’automatisation de navigateur pour un travail autorisé et configure l’exécution sur des systèmes possédés ou testés avec autorisation écrite ; il ne remplace pas une revue des conditions ni un avis juridique.
La politique d’usage responsable de BotBrowser exige d’opérer sur des systèmes possédés ou pour lesquels une autorisation écrite de test existe, et l’avis juridique place la conformité à la loi applicable et aux conditions de service à la charge de l’utilisateur. Ce sont des limites de politique produit. Elles ne constituent pas un avis juridique sur une source particulière, et les lire ne crée pas d’autorisation pour une tâche.
Un contrôle technique peut aussi créer une fausse impression de diligence. Ajouter un proxy, un délai ou un profil rotatif change l’apparence de la requête ; cela ne change pas ce que l’équipe est autorisée à faire. Si une tâche a besoin de ces contrôles pour éviter une restriction déclarée par la source, la restriction est la question à résoudre, pas le contrôle à régler. La vue d’ensemble de la configuration proxy explique ce qu’une route peut et ne peut pas changer ; aucun de ces changements n’est une autorisation.
Gardez trois ensembles de preuves séparés dans le registre. L’ensemble technique contient les codes de réponse, les observations de débit et les résultats de fixtures. L’ensemble contractuel contient la version des conditions, la clause et toute approbation écrite. L’ensemble juridique contient la réponse du conseil, si elle a été demandée. Un relecteur doit voir quel ensemble soutient quelle décision, et aucun ensemble ne doit combler le manque d’un autre. Une réponse 200 ne remplace pas une clause absente, et une clause ne prouve pas qu’une requête a réussi.
Lorsqu’une source publie une politique lisible par machine, utilisez-la comme entrée, pas comme substitut. Un fichier robots, un en-tête de quota d’API ou une fenêtre d’exploration documentée indiquent ce que la source attend sur le plan opérationnel. Ces entrées appartiennent au plan de charge et à la décision robots. Elles ne suppriment pas la lecture des conditions et ne répondent pas à la question des données personnelles.
Connaître le point d’escalade
Certaines questions relèvent d’un conseil juridique, et prétendre le contraire fait perdre du temps aux ingénieurs et crée du risque. Escaladez lorsque les conditions de la source restreignent l’accès ou la réutilisation automatisés, lorsque les données contiennent des informations personnelles, lorsque la collecte franchit une connexion ou un contrôle d’accès, ou lorsque la réponse dépend de la juridiction applicable. Ce ne sont pas des décisions qu’un profil de navigateur, un proxy ou une politique de nouvelle tentative peuvent prendre.
Apportez au conseil une question étroite et les preuves déjà rassemblées : la source, la version et la clause des conditions, la liste des champs, le plan de charge, le plan de conservation et la finalité métier. Une question précise obtient une réponse utile ; « pouvons-nous scraper ceci » invite à un avertissement général. Notez la réponse et sa date dans le même registre.
L’escalade ne concerne pas seulement la première requête. Un nouveau champ, une nouvelle source, une conservation plus longue ou un changement des conditions peuvent rouvrir une décision déjà close. Traitez le registre comme un document vivant avec une date de revue, et suspendez la collecte lorsqu’une entrée matérielle change.
La question d’escalade est plus facile à trancher avec des exemples. Le tableau ci-dessous montre le déclencheur, la preuve à apporter et la décision qui reste au conseil. C’est une aide au routage, pas un test juridique, et une équipe doit y ajouter ses propres cas.
| Déclencheur | Preuve à apporter | Qui décide |
|---|---|---|
| Les conditions interdisent l’accès automatisé | Clause, date de version, usage prévu | Conseil juridique, avec le propriétaire produit |
| Les champs approuvés peuvent identifier une personne | Liste des champs, finalité, plan de conservation | Conseil juridique et le responsable vie privée |
| La tâche exige une connexion ou un contrôle d’accès | Rôle du compte, périmètre d’autorisation, clause de la source | Conseil juridique et le propriétaire du compte |
| La source relève de plusieurs juridictions | Localisation de la source, de l’équipe et des personnes | Conseil juridique |
| La source propose une API pour les mêmes données | Conditions d’API, quota, champs manquants | Propriétaire produit, puis conseil si les conditions se contredisent |
Une équipe peut préparer tout cela sans avocat et atteindre malgré tout le point où seul un avocat peut répondre. C’est la frontière prévue. Le travail d’ingénierie consiste à rendre la question précise, à rassembler les preuves et à arrêter la tâche tant que la réponse est ouverte. Le travail juridique consiste à décider la base applicable. Mélanger les deux produit soit une collecte non autorisée, soit un projet bloqué qui n’obtient jamais de réponse claire.
Un second déclencheur d’escalade est souvent manqué : un changement dans la source. Une nouvelle clause, un nouveau mur de connexion, une nouvelle version d’API ou un changement des données renvoyées peuvent invalider une décision qui était correcte le trimestre précédent. Inscrivez la date de revue dans le registre et considérez-le comme expiré à cette date jusqu’à ce que quelqu’un relise la source. Un registre expiré n’est pas une raison de continuer ; c’est une raison de suspendre.
Conclusion pratique
Avant la première requête, notez la source et sa version de conditions, les champs et leur sensibilité, le budget de requêtes et la règle de conservation. Attribuez un propriétaire à chacun. Gardez séparées les preuves techniques et celles d’autorisation, et envoyez au conseil juridique les questions qui dépendent de la loi ou du contrat avec le registre joint. Cette pratique ne rend pas une collecte licite à elle seule, et ce n’est pas un avis juridique, mais elle transforme une hypothèse implicite en décision que l’équipe peut relire.
Questions fréquentes
Une page publique signifie-t-elle que les données sont libres à collecter ?
Non. La disponibilité publique décrit qui peut voir une page, pas ce qu’une équipe peut faire de son contenu. Les conditions de service, les droits sur les bases de données, les règles sur les données personnelles et les limites contractuelles peuvent s’appliquer indépendamment. Lisez les documents applicables et notez la clause qui encadre l’usage prévu.
Une règle Allow de robots.txt peut-elle servir d’autorisation ?
Non. Une règle robots est une consigne de coordination destinée à un jeton produit déclaré. Elle n’accorde ni licence, ni droit d’usage des données, ni base légale, et ne dit rien des données personnelles. Gardez la décision de règle et la décision d’autorisation dans des champs séparés du registre.
Suffit-il de s’arrêter quand le site renvoie 403 ?
S’arrêter est la bonne réponse opérationnelle, mais ce n’est pas une analyse d’autorisation. Un 403 montre que le serveur a refusé une requête ; il n’établit pas pourquoi et n’indique pas si une autre route serait appropriée. Diagnostiquez le refus, puis révisez la décision d’autorisation plutôt que d’essayer des variantes jusqu’à ce que l’une fonctionne.
Quand une équipe doit-elle consulter un avocat ?
Lorsque les conditions restreignent l’accès ou la réutilisation automatisés, lorsque des données personnelles sont concernées, lorsque la collecte franchit une connexion ou un contrôle d’accès, ou lorsque la juridiction applicable n’est pas claire. Apportez le registre et une question précise ; une demande générale d’approbation produit rarement une réponse utilisable.
Sources
Cet article fait partie du guide : Débuter avec l'automatisation du navigateur : carte initiale
Articles Connexes
Scraping et robots.txt : règles, blocages et échecs HTTP
IdentitéRevue de confidentialité pour les projets de mesure Web
DéploiementScraping d’offres d’emploi : limites du navigateur
DémarrageScraping avec Playwright : navigateur et profil
ComparaisonRevoir la confidentialité du navigateur avant la mise en production
DémarrageScraping avec Selenium : capacités et relevés
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.