Déploiement et livraison du navigateur : carte opérationnelle
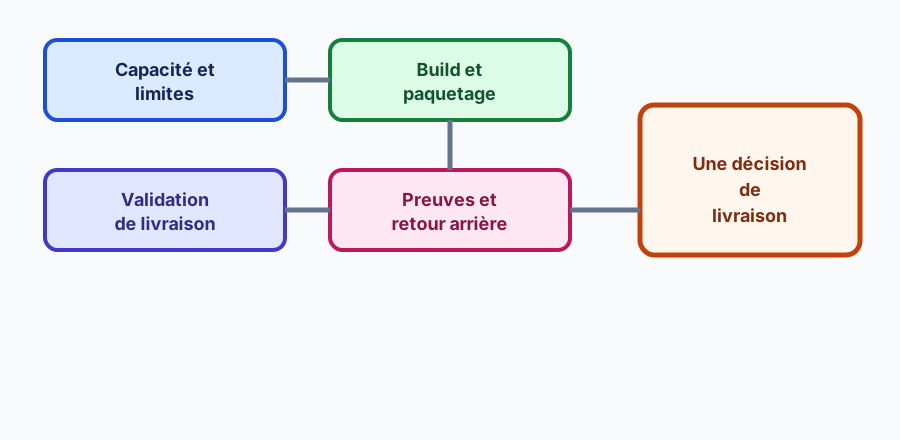
Ordonnez capacité, choix de build, validation et preuves en une décision de déploiement prête au retour arrière, sans affirmer une exécution que vous n'avez pas faite.
BotBrowser Team
Vous voulez la documentation structurée pour Déploiement ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
Déployer un navigateur est un ordre de revue, pas une liste d'options. Ce hub relie le groupe déploiement et ajoute un enregistrement de livraison borné qui nomme la décision de capacité, le choix de build, le résultat de validation et le chemin de retour arrière, en commençant par Valider une livraison de navigateur.
BotBrowser prend en charge l'exécution d'un profil autorisé dans des conteneurs et des serveurs de longue durée et peut garder les valeurs visibles du navigateur cohérentes avec ce profil ; il ne dimensionne pas votre infrastructure, ne garantit pas un build fournisseur et ne décide pas si une livraison convient à votre produit, et il ne remplace pas vos propres tests de capacité et de retour arrière.
Résumé
- Décidez la capacité d'après la concurrence mesurée, pas d'après le plus grand nombre qu'une machine a supporté une fois.
- Fixez le build du navigateur et la classe de profil dans le même enregistrement que la livraison.
- Validez sur la classe de machine qui exécutera réellement la charge.
- Livrez avec un chemin de retour arrière et les preuves qui rendent la décision vérifiable.
Sommaire
- Les quatre surfaces de déploiement
- Parcourir le groupe déploiement
- Mener une revue de livraison
- Enregistrement et portée de la livraison
- Traiter le premier échec
- Conclusion pratique
Les quatre surfaces de déploiement
Un déploiement de navigateur a quatre surfaces opérationnelles. La capacité couvre le nombre de contextes qu'une machine supporte, la manière dont la mémoire est récupérée et les limites qui ont été mesurées plutôt que supposées. Le choix de build couvre le paquet installé : édition standard ou allégée, cible de plateforme et pile de pilotes derrière. La validation de livraison couvre ce qui a été vérifié avant de déplacer le trafic : le profil se charge, les pages s'affichent, les interactions se comportent correctement. Les preuves et le retour arrière couvrent ce qui reste après la livraison : l'enregistrement qui explique la décision et le chemin de retour au build précédent.
La capacité dépend aussi du budget de contextes décrit dans Planification de capacité des BrowserContext, donc lisez les deux avant de publier un chiffre de concurrence.
Ces surfaces échouent de façons différentes et selon des horloges différentes. Une limite de capacité apparaît sous charge soutenue, souvent des heures après la première requête réussie. Un choix de build se manifeste par une bibliothèque absente ou un chemin de rendu que le conteneur n'offre pas. Une lacune de validation se manifeste par une interaction qui marchait au laboratoire et échoue en production. Un chemin de retour arrière absent transforme une mauvaise livraison récupérable en panne qui dure aussi longtemps que le diagnostic.
Le rôle de BotBrowser est de garder l'identité visible du navigateur cohérente avec le profil déclaré dans ces contextes. Cette cohérence rend un écart attribuable : si deux conteneurs portant le même profil divergent, la surface de déploiement est la cause probable et non une variable non maîtrisée.
Parcourir le groupe déploiement
- Valider une livraison de navigateur fixe quels profils, versions et états de retour arrière vérifier avant de livrer.
- Automatisation en Docker couvre une base de conteneur reproductible.
- Installer un navigateur sans interface sur Ubuntu couvre les prérequis serveur.
- Édition standard ou allégée sous Linux x64 compare les deux éditions empaquetées.
- Mesa llvmpipe et SwiftShader couvre le choix de backend de rendu sous Linux.
- Mettre à l'échelle les contextes couvre les profils par contexte à volume.
- Planifier la capacité des BrowserContext transforme les mesures mémoire en budget de contextes.
- Limites de ressources du conteneur traite CPU, mémoire et disque ensemble.
- Performance de l'automatisation couvre le coût d'exécution d'une charge.
- Capture d'écran fiable couvre la sortie que ce type de déploiement produit.
Le hub possède l'ordre et la forme de l'enregistrement. Chaque article lié possède le détail de sa surface et l'échec qu'elle peut produire.
Mener une revue de livraison
Écrivez les entrées déclarées avant toute mesure : la classe de machine, le build du navigateur, la classe de profil, la concurrence attendue et la charge prévue. Enregistrez ensuite une ligne par surface dans la même revue, afin qu'un écart ultérieur ait un point de référence.
{
  "runId": "deploy-review-20261019-01",
  "declared": {
    "hostClass": "8 vCPU / 16 GB",
    "browserBuild": "standard-linux-x64",
    "profileClass": "fresh-temporary",
    "expectedConcurrency": 24
  },
  "observed": {
    "capacity": "24-contexts-stable-30min",
    "build": "profile-loaded-renderer-recorded",
    "validation": "owned-fixture-passed",
    "rollback": "previous-build-redeployable"
  },
  "firstFailure": null,
  "testedOn": "2026-10-19"
}
L'enregistrement est une donnée, pas un rapport. Il doit être assez court pour être joint à un fil d'incident et assez explicite pour qu'un autre opérateur rejoue les quatre lignes sur la même classe de machine. Remplissez-le pendant la revue, pas après : un enregistrement écrit de mémoire décrit souvent la configuration prévue plutôt que celle que la machine a réellement exécutée.
Choisir le build et le backend délibérément
de rendu sont deux décisions distinctes, et chacune change ce que le déploiement peut faire. L'édition standard porte la pile de rendu complète ; l'édition allégée réduit le paquet et sa surface d'attaque et peut être le bon choix pour une charge étroite. Aucune n'est universellement plus rapide en production : le débit dépend des pages chargées et du chemin de rendu emprunté.
Sous Linux, le backend graphique décide si les pages passent par un rasteriseur logiciel comme llvmpipe ou par un chemin matériel choisi par --use-angle. Le rendu logiciel est disponible sur les machines sans GPU, ce qui est courant en conteneur, et se comporte différemment pour WebGL, canvas et les polices. Notez le backend réellement utilisé et gardez-le stable entre les livraisons. Un changement de backend entre deux builds par ailleurs identiques est un changement de rendu et appartient à la note de livraison.
Comparez les deux éditions et les deux backends sur la charge que vous exécutez réellement, sur la classe de machine que vous déployez réellement. Une comparaison faite sur un poste de travail répond à une autre question. Quand la comparaison est serrée, préférez la configuration dont le retour arrière est le plus simple : un redéploiement de deux minutes vaut mieux qu'un petit écart de débit.
Planifier la machine avant la première requête
La plupart des déploiements de navigateur échouent sur la machine bien avant d'échouer dans le navigateur. Un conteneur qui démarre proprement peut encore manquer de mémoire partagée, épuiser ses descripteurs de fichiers ou heurter un quota disque pendant une rafale de captures. Revoir ces limites ensemble transforme un succès ponctuel en déploiement répétable.
Fixez la limite mémoire du conteneur à partir de l'empreinte mesurée d'un contexte, multipliez par la concurrence réellement prévue, puis ajoutez le coût du processus navigateur mesuré sur la même classe de machine. N'utilisez pas le minimum annoncé par le fournisseur comme plafond : c'est un plancher de démarrage, pas un chiffre qui reflète votre charge. Une tâche de conversion avec de grands tampons et une tâche de captures avec beaucoup de pages ouvertes donnent des chiffres différents sur la même machine.
Donnez au navigateur une zone de mémoire partagée accessible en écriture, par exemple --shm-size=1g, et confirmez-la avec df -h /dev/shm dans le conteneur. La taille par défaut de /dev/shm dans beaucoup de runtimes de conteneurs est faible, et un navigateur qui n'obtient pas assez de mémoire partagée termine des processus de rendu sous charge plutôt qu'au démarrage. Fixez la taille explicitement, notez la valeur dans l'enregistrement et revérifiez-la quand l'image de base change. Il en va de même du stockage temporaire : le navigateur écrit caches et données de session, et un système de fichiers en lecture seule échoue d'une manière qui ressemble à un bug applicatif.
Surveillez aussi les descripteurs de fichiers et les limites de processus. Chaque contexte, chaque worker et chaque grande page peuvent retenir plusieurs descripteurs, et une limite généreuse au laboratoire devient serrée quand le même conteneur porte deux fois plus de trafic. Notez la limite que vous avez fixée, pas celle que vous avez héritée.
Enregistrement et portée de la livraison
Une revue d'incident pose quatre questions : qu'a-t-on déployé, où, avec quel profil, et qu'est-ce qui a changé depuis la dernière livraison saine. Un enregistrement qui répond aux quatre fait gagner la première heure d'investigation. Il n'a pas besoin d'être élaboré ; il lui faut la classe de machine, le build, la classe de profil, la concurrence, la version du fixture et le résultat de validation, au même endroit et daté.
Gardez l'enregistrement à côté de docs/blog-release-batches.json plutôt que dans un fil de discussion. Au moment de préparer la livraison suivante, comparer les deux enregistrements montre exactement quelles entrées ont changé, et cette comparaison est souvent la voie la plus rapide vers la cause d'une régression. Un enregistrement collé dans un ticket ne se compare à rien, alors que deux fichiers se comparent ligne par ligne.
Décidez la fenêtre de rétention avec le responsable produit, généralement liée à supportWindow. Un enregistrement qui explique une livraison est utile pendant sa fenêtre de support, par exemple retentionDays: 90 ; le conserver indéfiniment transforme le stock en bruit. Une courte note nommant la livraison, le motif et la date de retrait suffit.
La revue de livraison est aussi l'endroit où se décide ce que le déploiement peut affirmer. S'il tourne sur une machine partagée avec des voisins bruyants, le chiffre de capacité est une borne basse et non une garantie, et l'enregistrement doit le dire à côté de hostClass. S'il utilise un volume géré, la première minute d'E/S n'est pas représentative. Écrire ces contraintes dans l'enregistrement évite qu'une plainte de performance ultérieure ne devienne un débat sur la mesure.
Traitez la première fenêtre de production comme une partie de la validation, pas comme une formalité qui suit. Observez les quatre lignes enregistrées : capacité, build, validation et préparation du retour arrière. Une livraison qui passe au laboratoire et se dégrade dans la première heure n'est pas une livraison ratée, mais une livraison dont la ligne capacité a été mesurée trop brièvement. Le correctif est une mesure plus longue, pas une machine plus grosse, jusqu'à ce que la courbe dise autre chose.
Quand la charge change, refaites la revue au lieu d'extrapoler. Un nouveau type de page, un envoi plus gros ou un onglet supplémentaire changent l'empreinte et le nombre de descripteurs, et le chiffre précédent ne décrit plus le déploiement. L'extrapolation depuis une charge semblable est la façon dont un conteneur qui portait vingt contextes le trimestre dernier échoue à douze celui-ci.
Séparez l'enregistrement de déploiement de l'enregistrement d'incident même lorsqu'ils citent la même livraison. Le premier dit ce qui était prévu et ce qui a été mesuré ; le second dit ce qui s'est produit et ce qui a été décidé. Les fusionner fait passer une décision de livraison pour un jugement postérieur à l'incident et masque le fait qu'elle a été révisée avant.
Revoyez le déploiement après la première semaine calme, pas uniquement après un échec. Un déploiement resté dans sa ligne de capacité mérite le même enregistrement qu'un déploiement ayant exigé un retour arrière, car le relecteur suivant a besoin d'une base de comparaison. Une histoire faite uniquement d'incidents ne montre pas à quoi ressemble une livraison normale sur cette classe de machine, donc gardez les livraisons calmes dans la même liste singleReleases.
Traiter le premier échec
Si le profil ne se charge pas, arrêtez : les lignes suivantes décrivent un navigateur qui n'exécute pas le profil déclaré. Si la page s'affiche mais l'interaction échoue, vérifiez la version du fixture et la pile de pilotes avant la machine. Si l'interaction passe et la sortie diffère, comparez le backend de rendu et la classe de profil. Si tout passe et que la machine signale encore de la pression, traitez cela comme un constat de capacité et re-mesurez à concurrence plus basse avant de changer autre chose.
Nommez la surface responsable, conservez l'enregistrement et changez une entrée déclarée par essai. Une revue qui se termine par un échec nommé est plus utile qu'une liste d'une douzaine d'observations sans propriétaire, et cet échec nommé raccourcit aussi la revue suivante.
Conclusion pratique
Un déploiement de navigateur est vérifiable quand capacité, build, validation et retour arrière sont enregistrés ensemble. Utilisez ce hub pour ordonner la revue et le groupe pour le détail, et limitez chaque conclusion à la classe de machine, au build et au profil qui l'ont produite.
Sources publiques
Tous les guides sur ce sujet
- Mises à jour des service workers et cohérence des clients
- Isolation des processus du navigateur et responsabilité opérationnelle
- Limites de ressources d’un conteneur de navigateur : méthode pratique
- Journalisation du déploiement et vie privée
- CSP pour les responsables d’applications web
- Planifier la capacité des BrowserContext
- Profils de navigateur pour le monitoring SEO et le suivi SERP
- Mémoire des BrowserContext dans Chromium 151 : cas de version
- Validation des interactions après un changement de navigateur
- Validation des versions du navigateur et des profils
- Captures fiables avec un navigateur headless
- Mesa llvmpipe ou SwiftShader pour Chromium sous Linux
- BotBrowser Trimmed Linux x64 : choix et validation
- Protection des empreintes du navigateur pour la collecte web
- Protection des empreintes pour la surveillance des prix e-commerce
- Adapter la charge avec les profils Per-Context
- Performance navigateur : optimisation à grande échelle
- Signaux d'automatisation et cohérence avec Playwright
- BotBrowser headless sur serveurs Ubuntu
- Navigateur automatisé dans Docker : déploiement et mise à l'échelle
Articles Connexes
Limites de ressources d’un conteneur de navigateur : méthode pratique
DémarrageDébuter avec l'automatisation du navigateur : carte initiale
PlateformeSurfaces de la plateforme web : carte de revue
DéploiementPlanifier la capacité des BrowserContext
DéploiementAdapter la charge avec les profils Per-Context
DéploiementBotBrowser Trimmed Linux x64 : choix et validation
Faites passer BotBrowser de la recherche à la production
Utilisez ces guides pour comprendre le modèle, puis passez à la validation multi-plateforme, aux contextes isolés et au déploiement navigateur prêt pour l'échelle.