Automatisation MCP : ce que transporte le protocole
Distinguez appels MCP, état du navigateur et contexte du modèle. Interprétez sorties structurées, ressources et erreurs sans supposer une API universelle.
BotBrowser Team
Vous voulez la documentation structurée pour Déploiement ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
L’automatisation de navigateur par MCP relie une application d’IA aux outils d’un serveur ; elle ne transmet pas tout le navigateur au modèle. Un appel nomme une opération et fournit des arguments, tandis que la réponse contient les représentations choisies par le serveur. Cookies, onglets ouverts et mémoire de page peuvent rester dans le navigateur même si la réponse se limite à un bref résumé. Rien ne garantit qu’ils y restent : un outil renvoyant un état sensible peut le transporter par ce même protocole. BotBrowser peut fournir le processus Chromium contrôlé via un lanceur compatible, mais ne fournit pas de serveur MCP et ne détermine pas les résultats qui entrent dans le contexte du modèle.
TL;DR
tools/listdécrit les outils disponibles ;tools/callen invoque un par son nom. Aucun ne définit un vocabulaire universel d’actions de navigateur.- L’
idJSON-RPC associe une réponse à une requête, pas à un onglet, un compte ou un contexte de navigateur. - Un résultat peut contenir texte, images, audio, liens de ressources, ressources intégrées et JSON structuré. L’hôte décide comment ces éléments atteignent le modèle.
- Persistance du navigateur, transmission protocolaire et visibilité pour le modèle sont trois questions distinctes. Une petite réponse ne prouve pas une session courte.
- Une erreur de protocole et un résultat avec
isError: truesont deux canaux d’échec différents. Aucun n’établit seul si une modification applicative a eu lieu.
Sommaire
- Hôte, client, serveur et navigateur ont des responsabilités distinctes
- La découverte décrit un outil, pas son implémentation
- Ce que contiennent un appel et son résultat
- L’état du navigateur a une durée de vie séparée
- Lire le canal d’erreur avant de réessayer
- Choisir une représentation et une limite de divulgation
- Conclusion pratique
Hôte, client, serveur et navigateur ont des responsabilités distinctes
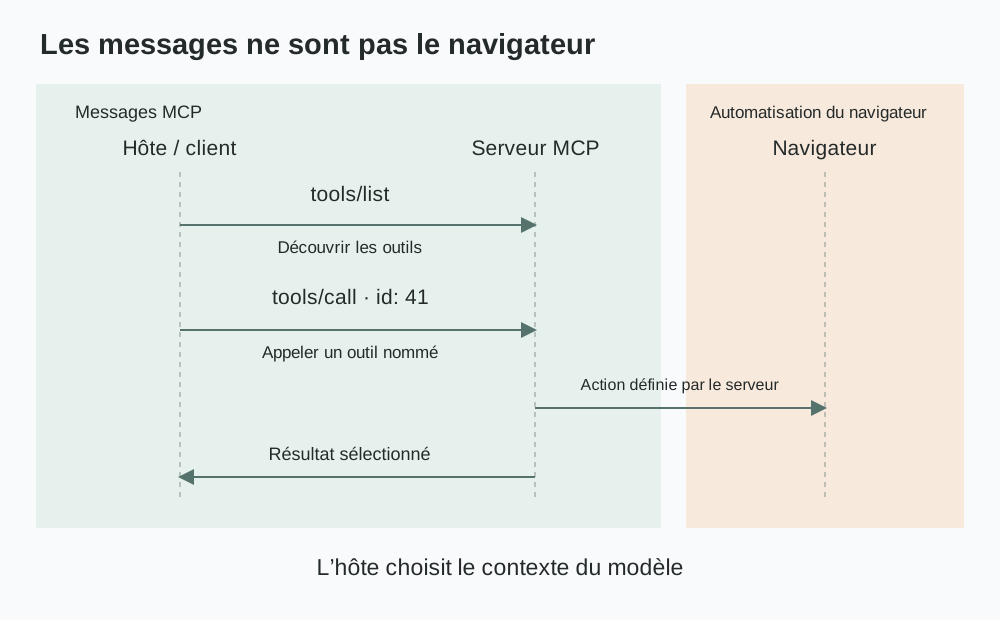
La spécification d’architecture MCP distingue l’application hôte de ses clients et serveurs. L’hôte gère l’intégration de l’IA et l’agrégation du contexte. Un client maintient une connexion avec un serveur, qui propose ses capacités par cette connexion. Un serveur d’automatisation pilote ensuite le navigateur avec sa propre implémentation. MCP ne remplace pas l’interface d’automatisation du navigateur et ne décrit pas chaque commande envoyée à cette couche.
Une application peut donc avoir une connexion MCP valide sans navigateur correctement configuré. La réussite de l’initialisation établit les capacités négociées de la connexion, pas l’exécutable Chromium, le profil ou l’état de la page. La configuration Puppeteer MCP traite séparément le lancement. Ces réglages appartiennent à l’implémentation du serveur plutôt qu’à l’enveloppe standard de tools/call.
La séparation fonctionne aussi dans l’autre sens. Le navigateur peut afficher correctement une page tandis que l’hôte exclut une image du contexte du modèle. Une capture renvoyée par la connexion prouve un résultat d’outil, pas qu’un modèle donné en a consommé les pixels. Il faut examiner l’assemblage réel du contexte et les modalités prises en charge par l’hôte. L’analyse du lancement et des responsabilités de l’agent distingue les preuves du processus des résultats visibles par l’agent ; le contrat supplémentaire concerne ici le message qui passe entre les deux.
La figure représente des responsabilités, pas une capture de paquets. Un déploiement peut exécuter le serveur localement ou à distance. Le déplacer hors du poste change l’emplacement du navigateur et de son stockage, sans retirer à l’hôte le contrôle de son intégration au modèle. Un serveur local ne prouve pas non plus que sa sortie reste locale si l’hôte envoie le contexte à un service de modèles distant.
La question de déploiement ne se résume donc pas à l’emplacement du serveur. Il faut identifier le responsable de chaque copie : répertoire d’état du navigateur, résultat du serveur, conversation enregistrée par l’hôte et éventuelle requête au modèle. Ces copies peuvent avoir des politiques de conservation différentes. L’architecture hôte/client/serveur répartit les responsabilités ; elle ne certifie pas une durée de conservation pour chaque implémentation.
La découverte décrit un outil, pas son implémentation
La spécification des outils définit tools/list pour la découverte. Chaque outil possède un nom, un schéma d’entrée et une description ; il peut aussi déclarer un schéma de sortie et des annotations. La pagination compte : la première réponse peut contenir un curseur plutôt que tout le catalogue. Un hôte qui ignore les pages suivantes peut présenter des capacités incomplètes malgré une connexion saine.
L’inputSchema décrit les arguments acceptés. Il ne prouve ni l’application des autorisations, ni la présence actuelle d’un élément, ni l’approbation humaine de l’action. Par exemple, un outil illustratif nommé fixture_read_status pourrait accepter l’identifiant d’une page de test publique. Ce nom n’est pas une norme MCP ; un autre serveur peut définir un autre nom et d’autres paramètres pour la même tâche.
Les descriptions aident le modèle à choisir, mais ne constituent pas une garantie exécutable. La spécification prévient également que les annotations provenant de serveurs non fiables doivent être considérées comme non fiables. Une action présentée comme étant en lecture seule doit donc être vérifiée par rapport à l’implémentation et aux pouvoirs réels du serveur ; une métadonnée de découverte ne confère pas une autorisation.
Trois questions de compatibilité sont à séparer :
| Couche | Contrat vérifié | Une vérification réussie ne prouve pas |
|---|---|---|
| Protocole | Client et serveur comprennent les messages MCP négociés | Qu’un outil de navigateur précis existe |
| Catalogue | Nom et inputSchema correspondent à l’appelant | Que le navigateur utilise la session prévue |
| Application | Cible actuelle et action autorisée correspondent à la tâche | Qu’un transport réussi signifie une tâche réussie |
Une modification du catalogue peut influencer la sélection par le modèle sans changement de version du protocole. Renommer un outil, élargir ses arguments ou modifier sa description change l’interface disponible. Conserver un catalogue versionné avec l’intégration permet de rattacher un échec aux noms et schémas réellement découverts. Dire que deux composants prennent en charge MCP est trop vague pour diagnostiquer un argument refusé par un serveur particulier.
Les outils de navigateur ont aussi besoin d’un périmètre que le protocole ne peut inventer. Si plusieurs onglets sont ouverts, la définition doit expliquer comment la cible est choisie. L’id ne remplit pas cette fonction. Deux requêtes numérotées différemment ne créent pas automatiquement deux contextes isolés. Le choix de session appartient à la sémantique documentée des outils, à la configuration du serveur ou à un contrat applicatif distinct.
Ce que contiennent un appel et son résultat
Une requête tools/call fournit name et arguments dans une enveloppe JSON-RPC. L’id permet de rattacher la réponse même lorsque d’autres requêtes sont en cours. Ce n’est pas un identifiant de session et il ne demande pas de nouveau profil. L’échange suivant illustre une page de test contrôlée ; il ne s’agit ni d’un trafic capturé ni de l’interface d’un serveur de navigateur nommé.
{
  "jsonrpc": "2.0",
  "id": 41,
  "method": "tools/call",
  "params": {
    "name": "fixture_read_status",
    "arguments": { "fixtureId": "public-status-7" }
  }
}
Une réponse illustrative réussie peut joindre texte et contenu exploitable par une machine :
{
  "jsonrpc": "2.0",
  "id": 41,
  "result": {
    "content": [{ "type": "text", "text": "The public fixture is ready." }],
    "structuredContent": { "ready": true, "pendingJobs": 0 },
    "isError": false
  }
}
Le structuredContent est un objet JSON produit par le serveur. Ce n’est pas la fonction de sortie structurée du modèle et cela ne prouve pas qu’un LLM a validé les valeurs. Si l’outil déclare un outputSchema, la spécification exige une sortie structurée conforme du serveur et recommande sa validation par le client. L’hôte peut effectuer cette validation avant d’accepter pendingJobs comme champ numérique. Le schéma ne peut cependant établir que l’observation est actuelle ou véridique.
Les deux représentations peuvent se contredire. Un texte indiquant que la page de test est prête accompagné de ready: false est un résultat incohérent. Choisir la moitié la plus commode ne résout rien. L’application doit disposer d’une règle d’interprétation déclarée ou rejeter l’incohérence. La validation est utile parce que le transport peut réussir alors que le contenu ne convient pas à la tâche.
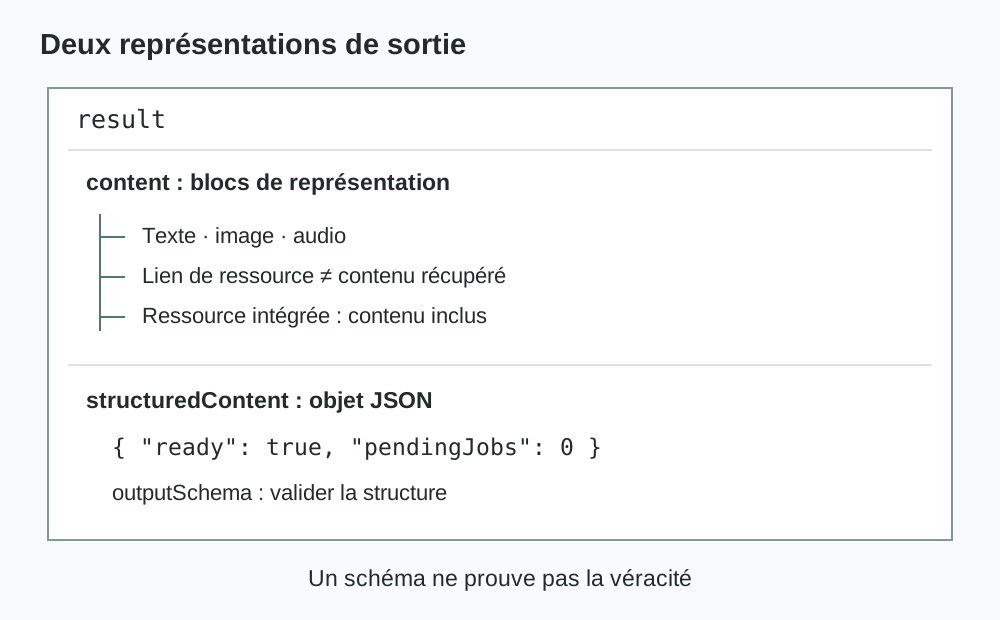
Le tableau content ne se limite pas au texte. Images et audio ont leurs formes propres ; les liens de ressources pointent vers des éléments qui ne sont pas forcément inclus dans la réponse, tandis que les ressources intégrées contiennent effectivement les données. La spécification précise que les liens renvoyés par des outils ne figurent pas nécessairement dans resources/list. Leur absence de cette liste ne les rend pas invalides ; leur présence ne prouve pas que le contenu référencé a été récupéré.
Cette différence compte pour la traçabilité des divulgations. Renvoyer un lien, récupérer le fichier et transmettre son contenu au modèle sont trois événements. Un audit limité à la réponse initiale de tools/call peut manquer une récupération ultérieure. À l’inverse, un enregistrement comportant l’URI d’une capture ne prouve pas que ses octets sont entrés dans la requête au modèle. Il faut suivre le traitement réel des ressources, pas estimer la divulgation à partir d’un nom de fichier.
L’état du navigateur a une durée de vie séparée
La documentation Playwright MCP figée à une révision donne un exemple concret sans le rendre universel. Elle décrit des profils persistants conservant les connexions aux comptes et des sessions isolées dont le stockage ne persiste pas après fermeture. Elle documente aussi la réutilisation d’un contexte entre clients connectés. Ces choix définissent la responsabilité et la durée de vie de l’état ; ils ne découlent pas d’un numéro de requête JSON-RPC.
Le serveur peut renvoyer un bref instantané d’accessibilité pendant que le navigateur conserve cookies et stockage local. Des appels ultérieurs peuvent observer des pages influencées par cet état même si aucun outil n’a explicitement renvoyé ces valeurs. Le modèle peut donc recevoir des informations propres à un compte sans recevoir le cookie qui l’a sélectionné. Exclure le justificatif réduit une voie de divulgation, mais ne rend pas la représentation de page non personnelle.
La possibilité inverse compte aussi. Un outil strictement limité à la lecture de page et un outil d’évaluation ou d’inspection réseau étendue peuvent exposer des parties différentes de la même session. La documentation figée décrit l’inspection de requêtes avec en-têtes et corps. La visibilité d’éléments sensibles dépend des capacités activées, de la requête réelle et du traitement de la réponse. L’absence d’un champ protocolaire nommé cookies ne permet pas d’affirmer que les secrets ne traversent jamais MCP.
Il faut distinguer trois cycles de vie : connexion MCP, contexte du navigateur et conversation de l’hôte. La fermeture d’une connexion ne promet pas, de manière générale, la destruction des deux autres. Un répertoire persistant peut survivre au redémarrage du processus et une conversation enregistrée à la suppression de ce répertoire. Le mode documenté du serveur et la politique de l’hôte déterminent leur relation réelle.
Pour une tâche liée à un compte, le contexte doit être affecté au travail autorisé avant les appels. Si le serveur partage un contexte, une nouvelle connexion cliente ne crée pas un isolement. C’est une question de configuration et de responsabilité, pas une raison de réécrire des valeurs visibles par la page. La documentation Playwright de BotBrowser traite le passage explicite de l’exécutable et du profil ; elle ne promet ni séparation des clients MCP ni suppression des conversations de l’hôte.
Lire le canal d’erreur avant de réessayer
La spécification sépare les erreurs de protocole des erreurs d’exécution d’outil. Un outil inconnu ou une requête invalide peut produire une erreur JSON-RPC. Un outil exécuté qui rencontre un échec applicatif peut plutôt renvoyer un résultat avec isError: true. Dans ce second cas, l’enveloppe reste result ; assimiler tout résultat à une action réussie fait perdre l’information d’échec fournie.
| Observation | Fait établi | Décision applicative adaptée |
|---|---|---|
JSON-RPC error | La requête a échoué au niveau protocolaire ou de répartition décrit | Vérifier méthode, catalogue et arguments avant de renvoyer |
result.isError: true | L’outil a signalé un échec d’exécution | Lire le détail et la sémantique de l’action |
| Résultat valide sans le champ demandé | Une réponse est arrivée mais le contrat de données est incomplet | Refuser le champ manquant plutôt qu’inventer sa valeur |
| Connexion perdue après début d’action | L’appelant n’a pas de réponse concluante | Vérifier l’état applicatif de référence avant de répéter une écriture |
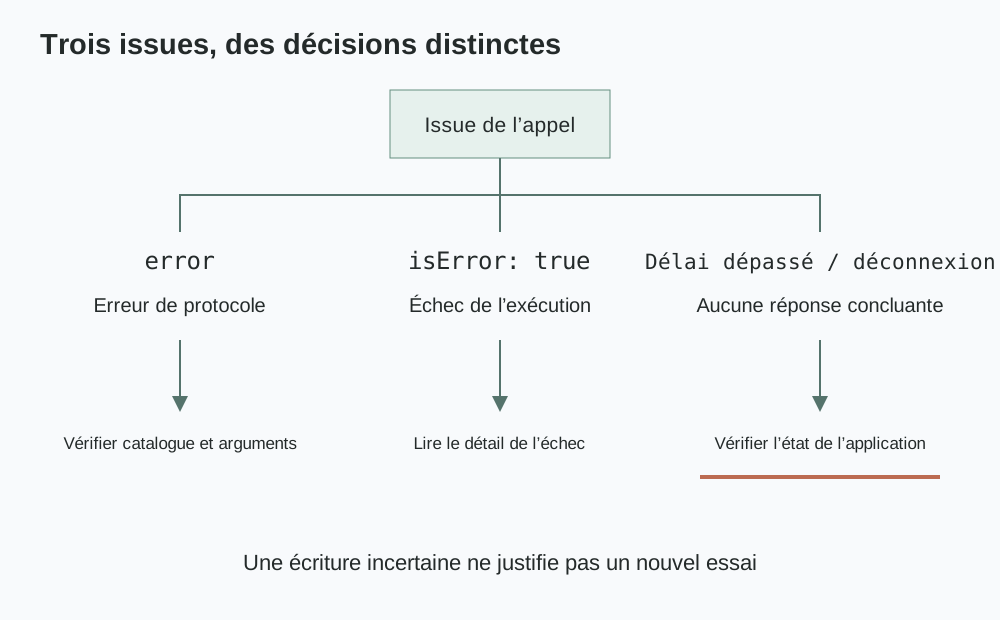
La dernière ligne est une déduction applicative, pas une garantie spéciale de MCP. Une connexion peut disparaître après qu’un bouton a déclenché une modification côté serveur, mais avant le retour de l’outil. Ni le délai dépassé ni l’absence de réponse ne prouvent que rien n’a changé. Pour une écriture autorisée, utiliser le statut ou le mécanisme d’idempotence de l’application s’il existe. Sans cette preuve, un opérateur doit résoudre l’issue incertaine plutôt que laisser l’agent deviner.
Même une erreur explicite exige du contexte. Un outil peut lire une page, tenter une interaction puis échouer lors de la capture finale. L’erreur peut concerner la capture sans annuler l’interaction antérieure. Le canal d’erreur signale une exécution imparfaite ; seules la sémantique de l’outil et les preuves applicatives établissent les effets restants. Réduire toute erreur à un booléen autorisant un nouvel essai efface cette différence.
Les erreurs influencent aussi la divulgation. Une réponse d’échec peut inclure texte de page, console ou fichiers diagnostiques absents d’une réponse réussie. Il faut examiner la politique de sortie des échecs autant que le chemin nominal. Enregistrer les erreurs complètes dans une conversation durable peut créer une copie supplémentaire des données de compte, même si les résultats habituels sont volontairement brefs.
Choisir une représentation et une limite de divulgation
Le README figé distingue les instantanés d’accessibilité browser_snapshot des captures browser_take_screenshot, avec des réglages pour la représentation renvoyée. Un arbre d’accessibilité sert aux noms, rôles et références de contrôles ; une capture conserve l’agencement visuel. Aucun ne décrit tout l’état du navigateur. Une capture peut omettre ce qui se trouve hors de sa zone, et une représentation accessible ne garantit pas la présentation visuelle exacte.
Le choix dépend de la décision autorisée. Lire un état public peut nécessiter une petite valeur structurée et le contexte d’observation, pas une image entière. Comparer une disposition exige une preuve visuelle, pas une phrase affirmant que tout semblait correct. Examiner une requête défaillante nécessite ses champs pertinents expurgés, pas toutes les requêtes du navigateur. La minimisation commence dans la sortie de l’outil, avant que l’hôte puisse la réduire.
Le serveur n’est pas le seul point de contrôle. L’hôte peut sélectionner, reformater ou résumer les éléments reçus avant de les ajouter au contexte du modèle. Il faut distinguer le résultat reçu de ce qui a réellement été transmis. Une requête plus courte au modèle n’efface pas un fichier complet déjà enregistré par le serveur ou l’hôte. Stockage et transmission nécessitent des responsables distincts.
La documentation figée dit explicitement que Playwright MCP n’est pas une frontière de sécurité. Elle présente aussi le remplacement des secrets comme une commodité plutôt qu’une fonction de sécurité, et les restrictions d’accès aux fichiers comme des garde-fous plutôt qu’un bac à sable sûr. Une interface conviviale ne doit donc pas être assimilée à une frontière de permissions du système d’exploitation. Les limites de pouvoir doivent être imposées par les vrais droits des processus, fichiers et comptes.
Une vérification locale peut utiliser une page contrôlée exposant un état public, un champ volontairement absent et un lien inoffensif. La réponse MCP brute et le contexte assemblé doivent être examinés séparément. Une réussite établit que ce serveur a renvoyé la représentation prévue et que cet hôte a transmis le sous-ensemble prévu dans cette configuration. Elle ne certifie ni tous les outils activés, ni les erreurs inconnues, ni la conservation d’un autre hôte. Aucune telle exécution de navigateur ou de MCP n’est revendiquée ici ; exemples et figures dérivent des spécifications et de la documentation figée citées.
Questions fréquentes
MCP est-il identique à Chrome DevTools Protocol ?
Non. MCP expose des capacités au client d’une application d’IA. Un serveur de navigateur peut utiliser en aval une bibliothèque d’automatisation ou un protocole de navigateur. L’enveloppe MCP n’impose pas de transmettre toutes ces commandes et tous ces événements à l’appelant.
Un lien de ressource signifie-t-il que le modèle a reçu le fichier ?
Pas nécessairement. Lien renvoyé, récupération ultérieure et inclusion dans le contexte sont trois opérations. Il faut vérifier la gestion des ressources par l’hôte et la requête réelle au modèle plutôt que déduire la livraison du lien.
Deux clients peuvent-ils partager un contexte sans risque ?
Seulement si la politique des tâches et des comptes autorise ce partage. Des connexions MCP séparées ne garantissent pas seules la séparation du stockage, des onglets ou des droits. Une option de contexte partagé doit être évaluée au niveau de l’état du navigateur.
Un schéma de sortie rend-il le texte de page fiable ?
Non. outputSchema contraint la forme du contenu structuré. Il ne rend pas une instruction de page légitime, ne prouve pas l’actualité d’une observation et n’approuve aucune modification. Validation de schéma et décisions de confiance sont distinctes.
Sources
- Architecture MCP, révision 2025-06-18
- Outils MCP, révision 2025-06-18
- README Playwright MCP figé à a62ea28698af6d9bc89438bcec50c63377cef957
- Intégration Playwright de BotBrowser
Conclusion pratique
L’automatisation MCP transporte des appels nommés et des représentations sélectionnées, pas une copie universelle du navigateur. Vérifier le schéma découvert, valider la structure renvoyée et distinguer les échecs d’exécution des effets applicatifs incertains permet d’interpréter les réponses. Avant de connecter un navigateur lié à un compte, identifier les outils qui exposent son état, les sorties transmises par l’hôte et les copies qui restent après fermeture.
Cet article fait partie du guide : Déploiement et livraison du navigateur : carte opérationnelle
Articles Connexes
Navigateur headless pour agents IA : lancement et limites des outils
DéploiementPlaywright MCP : lancer un build Chromium personnalisé
DéploiementPuppeteer MCP : configurer un build Chromium propre
DéploiementAutomatiser le navigateur avec Stagehand
DéploiementMises à jour des service workers et cohérence des clients
DémarrageQu’est-ce qu’un robot d’exploration ? Cinq étapes
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.