Scraping SERP à grande échelle : exigences navigateur
Planifiez le scraping de SERP à grande échelle en mesurant séparément pages par heure, délai de démarrage, capacité du navigateur et attente réseau avant de choisir un navigateur.
BotBrowser Team
Vous voulez la documentation structurée pour Déploiement ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
Le scraping de SERP à grande échelle relève de la planification de charge : le navigateur doit soutenir un objectif requis de pages par heure sans que le démarrage, le rendu ou la mémoire deviennent le goulot d’étranglement caché. Le plan de mesure s’appuie sur un fixture maîtrisé ou sur une cible/API explicitement autorisée ; aucune procédure de collecte en direct n’est fournie. BotBrowser fournit un runtime navigateur configurable pour une comparaison contrôlée, mais ne planifie pas les tâches, ne décide pas si la collecte est autorisée et ne garantit pas la réponse d’un tiers. Une comparaison d’achat mesure séparément le travail du navigateur et l’attente réseau.
TL;DR
- Fixez un objectif en pages terminées par heure et une latence maximale acceptable, puis mesurez les deux au lieu de déduire la capacité du temps de lancement.
- Comparez le même jeu de pages représentatif à deux niveaux de concurrence prévus ; enregistrez le démarrage du navigateur, le délai avant page prête, la mémoire et les échecs.
- Maintenez la configuration du navigateur fixe pendant la mesure de l’attente réseau, puis ne changez qu’une variable côté navigateur à la fois.
- Traitez la feuille de calcul et la formule ci-dessous comme un plan de mesure, et non comme des résultats de référence BotBrowser.
- Mesurez uniquement un fixture maîtrisé ou une cible/API explicitement autorisée ; aucune procédure de collecte en direct n’est incluse.
Sommaire
- Traduire la charge de travail en exigences navigateur
- Séparer le temps navigateur du temps réseau
- Un plan de mesure réutilisable
- Conclusion pratique
Traduire la charge de travail en exigences navigateur
« À grande échelle » ne cache aucun nombre de navigateurs unique. Un objectif de planification exige au moins un volume de pages, une fenêtre d’observation, une définition de page prête et une plage acceptable de temps d’achèvement. Si un travail nécessite 12,000 pages terminées en 4 heures, l’objectif arithmétique est de 3,000 pages par heure. Il s’agit d’un exemple de calcul, et non d’une capacité mesurée du navigateur ni d’une recommandation sur le volume de collecte.
Les pages par heure sont plus utiles que les lancements de navigateur par heure, car un lancement ne représente que la préparation. La charge de travail paie aussi la création d’un contexte, la navigation, l’exécution des scripts de page, l’attente de la condition de disponibilité choisie et le stockage du résultat. Un navigateur qui démarre rapidement, mais passe la majeure partie de chaque travail à attendre le traitement de page, peut manquer l’objectif. À l’inverse, un lancement initial lent peut être amorti lorsqu’une conception prise en charge réutilise un processus ou un contexte de navigateur. La documentation sur l’optimisation des performances couvre le réglage du runtime ; les exigences de charge de travail relèvent de la comparaison avant l’achat.
La latence doit elle aussi être définie. Enregistrez le temps entre le début de la navigation et le signal de disponibilité exact dont la charge de travail a besoin, et non un événement « page chargée » non précisé. Une SERP peut contenir du contenu utile avant que toutes les images ou ressources différées soient terminées, mais le choix d’une autre condition de disponibilité change le résultat. Conservez cette condition à l’identique dans toutes les comparaisons et documentez-la avec le résultat.
| Champ d’exigence | Valeur d’exemple | Remarque |
|---|---|---|
| Pages terminées | 12000 | Travail total, et non nombre de lancements |
| Fenêtre d’observation | 4 h = 14400 s | Temps écoulé disponible |
| Signal de disponibilité | page-ready une fois le contenu requis présent | Doit rester fixe |
| Objectif moyen | 12000 / 14400 * 3600 = 3000 pages/h | Exigence arithmétique uniquement |
| Objectif de latence | p95 <= 20 s pour le même événement de disponibilité | Limite de queue, et non moyenne |
La formule rend explicite la moyenne demandée ; elle ne prédit pas la capacité d’un navigateur, d’un hôte, d’une route ou d’une réponse. Le démarrage, les pauses planifiées, les nouvelles tentatives et la persistance consomment une partie de la fenêtre ; enregistrez-les donc au lieu de les masquer dans l’agrégat. Un parc peut atteindre 3,000 pages/h alors qu’un sous-ensemble prend plus de 20 s, ce qui explique pourquoi le débit et l’objectif p95 appartiennent à la même exigence.
Définissez une page terminée avant de comparer des produits. Le navigateur peut signaler le moment où l’événement de disponibilité sélectionné s’est produit, tandis que la validation ou le stockage hors du navigateur peuvent se terminer plus tard. Gardez ces horodatages séparés : un goulot d’étranglement en aval ne doit pas être étiqueté à tort comme latence du navigateur, et un traitement des résultats plus rapide ne doit pas être crédité comme une navigation plus rapide.
Avant d’observer un candidat, fixez l’échantillon et la règle d’arrêt. Sélectionnez un ensemble représentatif de pages du fixture, enregistrez le nombre de pages et le mélange de complexité, puis décidez combien de répétitions chaque niveau de concurrence nécessite. Par exemple, utilisez 500 pages par répétition, 3 repetitions et deux niveaux prévus comme 4 contexts et 8 contexts ; ce sont des entrées de la feuille de calcul, et non des limites mesurées. Commencez chaque répétition depuis un état de navigateur documenté et conservez les pages en échec ou expirées dans le décompte.
Décidez aussi comment les échantillons de ressources sont collectés. Enregistrez l’allocation de CPU et de mémoire de l’hôte, l’intervalle d’échantillonnage, la version du navigateur, l’identifiant du profil, le mode de lancement et la version de la bibliothèque d’automatisation. Si un candidat nécessite une autre route proxy, comparez-le uniquement avec une route que l’opérateur est autorisé à utiliser. Gardez le contenu du fixture, l’événement de disponibilité, l’hôte et la route inchangés pendant le test d’une variable côté navigateur. Joignez l’identifiant exact du fixture, les champs de configuration et le nombre d’échantillons à chaque résultat afin qu’une nouvelle exécution utilise les mêmes entrées.
La même règle d’autorisation s’applique lorsque la charge passe des résultats de recherche aux annonces organisées par employeur ; les limites du scraping d’offres d’emploi définissent la liste autorisée des pages publiques et les conditions d’arrêt pour les données authentifiées.
Séparer le temps navigateur du temps réseau
Une durée observée combine plusieurs coûts : le démarrage du navigateur et le travail sur le contexte, l’initialisation du proxy, la navigation, le rendu local et l’exécution des scripts, la connexion réseau et l’attente des réponses, ainsi que toute attente de page volontaire dans la charge de travail. Une observation lente, à elle seule, ne permet pas d’identifier la couche responsable. Le navigateur ne peut pas faire arriver plus tôt une réponse en amont, et un changement de route ne prouve pas que le démarrage du navigateur était efficace. Pour ces comparaisons, utilisez uniquement un fixture maîtrisé ou une cible/API explicitement autorisée.
Utilisez une base contrôlée. Maintenez constants la version du navigateur, le profil, le fixture maîtrisé ou le jeu de pages autorisé, la condition de disponibilité, les ressources de la machine et la route réseau. Enregistrez séparément le démarrage du navigateur, l’initialisation du proxy, la navigation et l’attente de page comme des étapes distinctes. Faites ensuite varier un seul facteur : par exemple, comparez la réutilisation d’un processus avec des lancements neufs en laissant la route inchangée. Pour examiner les effets de route, conservez la configuration du navigateur et utilisez seulement des routes et cibles que l’opérateur est autorisé à tester. La documentation sur la configuration du proxy décrit la route réseau comme une surface de configuration distincte.
La réutilisation du contexte et la condition de page prête choisie peuvent modifier le travail côté navigateur sans changer la route. La documentation sur les performances décrit le réglage du runtime d’un déploiement déjà en service ; le présent plan capture plutôt les étapes de chronométrage avant l’achat sur un fixture contrôlé. Gardez le comportement du fixture et la disponibilité identiques entre les comparaisons, puis consignez toute option côté navigateur modifiée pendant une exécution. Aucun sélecteur, aucune logique d’exploration, aucune procédure de SERP en direct et aucun contournement de contrôle d’accès ne fait partie de la mesure.
L’article sur l’optimisation des performances traite du réglage du runtime une fois le déploiement existant, tandis que la planification de capacité des contextes montre comment les courbes mémoire mesurées fixent une limite d’admission. Ce plan de mesure maintient ces couches séparées : le démarrage du navigateur et le travail de page sont consignés séparément de la route et de l’attente des réponses, afin qu’une comparaison d’achat n’attribue pas chaque résultat lent au navigateur.
| Étape | Événement de début | Événement de fin | Ce qu’elle permet d’étayer |
|---|---|---|---|
browser_startup | lancement demandé | le navigateur peut accepter une action de la charge de travail | comparaison à froid et avec réutilisation |
proxy_initialization | route configurée | la première requête peut utiliser la route | coût de préparation |
navigation | début de la navigation | événement de disponibilité sélectionné | intervalle de page complet |
response_wait | début de la requête | en-têtes ou corps de réponse disponibles | comportement réseau observé |
completion | événement de disponibilité | acceptation en aval | coût hors navigateur |
Les étapes peuvent se chevaucher : plusieurs requêtes peuvent être en cours pendant que le travail du navigateur continue. Ajouter la durée de chaque requête à la latence de page prête peut donc compter le temps deux fois. Traitez le tableau comme des frontières d’attribution, et non comme la preuve qu’un runtime possède un coût navigateur et un coût réseau parfaitement séparables.
L’échantillonnage des ressources exige un intervalle fixe, par exemple sample every 5 s, et un relevé des contextes actifs au pic de mémoire. L’utilisation du processeur doit provenir de la même fenêtre. Si l’hôte atteint CPU 100% ou épuise la mémoire, le navigateur peut ralentir même si sa configuration n’a pas changé ; la capacité de l’hôte fait partie du dossier de test.
Le travail à froid et le travail à chaud ne doivent pas être mélangés dans une moyenne inexplicable. Une première page peut inclure le démarrage du processus, le chargement du profil et la configuration initiale que les pages suivantes ne répètent pas. Si la charge de travail prévue démarre un nouveau processus pour chaque unité, ce coût à froid est représentatif. Si la conception prévue réutilise un processus, le parcours à chaud compte aussi. Présentez les deux cas lorsque les deux modèles de déploiement sont envisagés, et précisez lequel la décision d’achat doit soutenir. Un parcours à chaud plus rapide ne prouve pas que le parcours à froid tiendra dans le même calendrier.
Un plan de mesure réutilisable
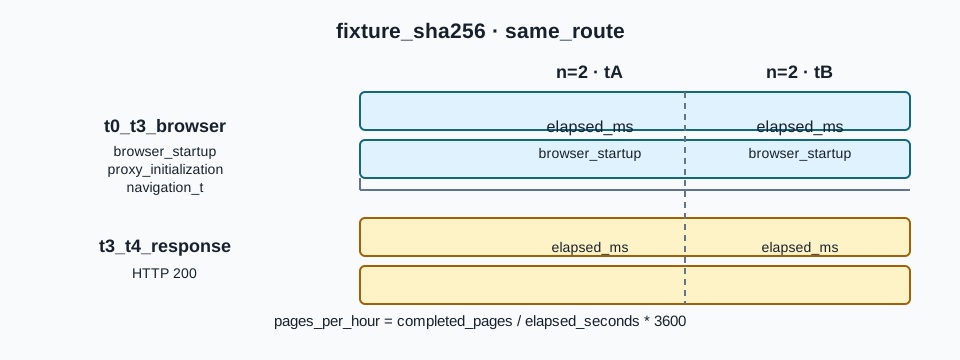
La feuille de calcul suivante est un plan à remplir avec des observations issues d’un fixture maîtrisé ou d’une cible/API explicitement autorisée ; les valeurs restent vides, car aucun relevé d’exécution ne les renseigne.
| Champ planifié | À enregistrer pour chaque comparaison | Pourquoi il compte |
|---|---|---|
| Charge de travail | Identifiant du fixture/API maîtrisé et condition de page prête | Rend les exécutions comparées équivalentes |
| Navigateur | Version, profil, mode de lancement, choix de réutilisation | Identifie les changements côté navigateur |
| Étape 1 | Durée du démarrage du navigateur | Isole l’initialisation du processus |
| Étape 2 | Durée de l’initialisation du proxy | Sépare la préparation de la route du travail de page |
| Étape 3 | Durée de la navigation | Enregistre l’intervalle de navigation complet |
| Étape 4 | Attente de page jusqu’à la condition de disponibilité fixe | Rend explicite la règle d’achèvement |
| Charge | Concurrence prévue : niveau A et niveau B | Montre si le débit mesuré change |
| Résultat | Pages terminées, temps écoulé, échecs | Permet le calcul des pages par heure |
| Coût | Pic de mémoire et attente des réponses observée | Expose la capacité et la pression réseau |
La feuille de calcul doit être traitée comme un dossier minimal, et non comme une spécification de test complète. Ajoutez l’allocation de CPU et de mémoire de l’hôte, le système d’exploitation, l’identifiant de version du navigateur et toute version de bibliothèque d’automatisation lorsqu’ils diffèrent entre les candidats. Indiquez si le navigateur a tourné en mode headless ou avec un affichage visible, car une comparaison n’a de sens que si les modes correspondent au déploiement prévu. Si un candidat exige une autre forme d’hôte, documentez explicitement ce fait au lieu d’attribuer son résultat au seul navigateur. Les quatre étapes de chronométrage sont des catégories d’observation, et non la garantie que chaque bibliothèque d’automatisation expose quatre mesures sans chevauchement ; précisez la frontière d’événement utilisée pour chaque catégorie.
Pour la planification, un tableau de décision compact peut garder les conclusions liées aux éléments de preuve :
| Observation dans la comparaison prévue | Interprétation à examiner | Mesure suivante |
|---|---|---|
| Le démarrage ou l’initialisation du proxy augmente au niveau B | La préparation peut être en concurrence avec les travaux simultanés | Répétez aux niveaux A et B en gardant le fixture et la route fixes |
| La navigation augmente alors que les autres étapes restent similaires | L’intervalle de navigation complet exige une attribution plus précise | Gardez le navigateur fixe et examinez les observations de l’attente des réponses |
| L’attente de page augmente, mais la navigation reste stable | Le moment de disponibilité ou le travail de page peut expliquer l’écart | Revérifiez le même événement de disponibilité sur le même fixture |
| Les pages par heure changent peu et le pic de mémoire augmente | L’hôte ou la charge du navigateur peut être limité par les ressources | Répétez les deux niveaux et examinez les échantillons de ressources de l’hôte |
| Les étapes du navigateur restent similaires, mais l’attente des réponses change | Les conditions réseau peuvent expliquer l’écart | Gardez la configuration du navigateur fixe et examinez une comparaison de routes autorisées |
Ces lignes sont des invites d’interprétation, et non des résultats de référence. Une ligne décrit ce qu’une future observation pourrait signifier et quelle variable examiner ensuite ; elle n’affirme pas qu’une exécution BotBrowser a produit ce schéma. La même discipline s’applique aux synthèses d’achat : joignez la configuration et la fenêtre de mesure à chaque résultat, et distinguez un écart observé d’une explication causale.
Pour chaque exécution, calculez pages_per_hour = completed_pages / elapsed_seconds * 3600. Cette formule normalise une exécution terminée ; elle ne prédit pas l’exécution suivante. Comparez les mêmes champs à deux niveaux de concurrence, par exemple une base à faible charge et un niveau prévu plus élevé, au lieu de traiter un résultat unique comme une limite. Si le débit cesse d’augmenter tandis que la mémoire du navigateur ou la latence avant page prête augmente, le navigateur ou l’hôte peut être saturé. Si les mesures côté navigateur restent stables tandis que l’attente des réponses change, examinez séparément le chemin réseau.
Répétez le plan suffisamment de fois pour voir la variation, puis indiquez le nombre d’échantillons et la dispersion plutôt que seulement l’exécution la plus rapide. Conservez dans le dossier les pages du fixture en échec et expirées : les retirer ferait paraître le débit meilleur tout en masquant un coût opérationnel. Il s’agit d’une conception de mesure, et non de la promesse que deux points de concurrence établissent un plafond de capacité universel.
Un fixture maîtrisé doit représenter la complexité pertinente des pages sans contenir de données de requête sensibles dans un rapport partagé. Un fixture stable peut préserver différents chargements de rendu et de scripts tout en utilisant des libellés neutres. Enregistrez son identifiant et les caractéristiques qui comptent pour le travail du navigateur, comme l’activité des scripts, la mise en page et le contenu attendu à la disponibilité. N’utilisez pas un résultat obtenu sur quelques pages légères du fixture comme affirmation sur toutes les charges de travail. Gardez le fixture exact inchangé entre les candidats afin que les différences entre navigateurs ne se mélangent pas aux différences de contenu. Si la cible est une API autorisée, identifiez l’opération API, sa condition de réponse documentée et un échantillon public sûr qui omet les entrées sensibles.
Les échecs font partie du dénominateur et d’une synthèse distincte. Une expiration de navigation, une condition de disponibilité qui ne se produit jamais et une erreur de persistance en aval sont des événements différents. Étiquetez-les selon l’étape qui les a émis, conservez leurs nombres et indiquez si les pages sont incluses dans la sortie terminée. Un débit en pages par heure annoncé sans nombre d’échecs peut masquer un faible taux d’achèvement. Le dossier de mesure doit conserver assez de détails pour qu’un autre évaluateur comprenne si le candidat a terminé la tâche définie, et pas seulement s’il a généré une activité de navigateur.
La fenêtre de test exige aussi une règle d’arrêt. Une exécution courte peut mesurer surtout le démarrage, tandis qu’une exécution très longue peut intégrer des changements non liés de l’hôte ou de la route. Choisissez une durée ou un nombre de pages avant d’observer les résultats, répétez dans les mêmes conditions et notez toute interruption. Ne prolongez pas uniquement le candidat qui semble d’abord plus lent, sauf si le plan révisé est ensuite appliqué de façon cohérente. Cela évite de modifier la comparaison après avoir vu quel résultat est plus commode.
Enfin, résumez trois quantités distinctes : le débit moyen demandé, le débit achevé observé et la distribution de latence observée. La première est une exigence ; la deuxième est un résultat pour une configuration enregistrée ; la troisième décrit la variation temporelle autour de ces achèvements. Aucune ne permet à elle seule d’établir une capacité universelle du navigateur. Une décision d’achat doit aussi conserver le dossier de configuration, l’allocation de ressources, les nombres d’échecs et les limites du fixture de pages afin que les changements ultérieurs puissent être comparés à la même base.
FAQ
Le temps de lancement suffit-il pour estimer la capacité ?
Non. Le temps de lancement omet la navigation, la disponibilité, l’exécution de page et le traitement des résultats. C’est une composante utile, surtout lorsque les lancements sont fréquents, mais la mesure au niveau de la charge de travail reste le nombre de pages terminées par heure.
Chaque page doit-elle utiliser la même condition de disponibilité ?
Utilisez la même condition dans une comparaison afin que les exécutions soient comparables. La condition doit correspondre au résultat dont la charge de travail a réellement besoin ; attendre des ressources non liées peut surestimer le travail du navigateur, tandis qu’un arrêt trop précoce peut omettre le contenu requis.
Une concurrence plus élevée augmente-t-elle toujours le débit ?
Non. Des pages simultanées supplémentaires peuvent accroître la contention sur le CPU, la mémoire, les processus du navigateur ou les ressources réseau. Mesurez aux niveaux prévus et traitez un plateau ou une latence croissante comme un élément à examiner, et non comme une limite de capacité universelle.
BotBrowser détermine-t-il si une charge de travail SERP réussit ?
Non. BotBrowser fournit le runtime navigateur et les résultats de page visibles pour une comparaison contrôlée. La planification du travail, la qualité du réseau, les réponses de tiers et les décisions d’autorisation restent hors de cette frontière de capacité.
Conclusion pratique
Avant de choisir une configuration de navigateur pour le scraping de SERP à grande échelle, traduisez la charge de travail en pages par heure et en latence de disponibilité définie. Exécutez un plan reproductible avec un fixture maîtrisé ou une cible/API explicitement autorisée à deux niveaux de concurrence ; enregistrez séparément le démarrage, l’initialisation du proxy, la navigation et l’attente de page. Gardez les variables du navigateur et du réseau distinctes, puis utilisez la comparaison pour identifier la ressource qui demande attention. La prochaine action consiste à définir le fixture autorisé et la condition de disponibilité ; aucun nombre générique de navigateurs ne peut remplacer cette base. Aucune procédure de collecte de SERP en direct, de sélection d’éléments de page, de mise en œuvre d’une logique d’exploration ni de contournement de CAPTCHA, de limites de débit ou de contrôles d’accès n’est fournie.
Sources
Cet article fait partie du guide : Déploiement et livraison du navigateur : carte opérationnelle
Articles Connexes
Performance navigateur : optimisation à grande échelle
DéploiementProfils de navigateur pour le monitoring SEO et le suivi SERP
DéploiementPlanifier la capacité des BrowserContext
DéploiementLimites de ressources d’un conteneur : méthode pratique
DéploiementAdapter la charge avec les profils Per-Context
DéploiementScraping d’offres d’emploi : limites du navigateur
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.