Performance navigateur : optimisation à grande échelle
Optimisez mémoire, processeur, réseau et densité d’instances pour une automatisation navigateur stable à grande échelle.
BotBrowser Team
Vous préférez la doc produit maintenue ?
Cet article a une page équivalente dans le centre de documentation. Utilisez les docs pour le flux canonique, les flags à jour et la référence durable.
Quand les tâches du navigateur ralentissent avec la concurrence, la question utile est de savoir quelle ressource ou quelle file limite cette charge. BotBrowser fournit l'isolation des profils et des contrôles de charge, mais ne garantit pas un nombre universel d'instances par hôte ; mesurez ensemble les pages, la route et l'hôte cible avant de modifier la capacité.
Résumé
- Mesurez des tâches représentatives à froid et à chaud avant de fixer une limite de workers.
- Identifiez la ressource limitante et définissez des règles explicites d'admission et de reprise pour une file bornée.
- Ne changez qu'un coût à la fois, puis acceptez ou annulez selon la même charge et le même objectif de service.
Sommaire
- Mesurez d'abord la charge de travail
- Protégez le budget par la régulation de charge
- Ajustez un coût à la fois
- Acceptez les versions avec des preuves de reprise
- Où BotBrowser s'intègre
- Conclusion
Mesurez d'abord la charge de travail
Une charge d'automatisation de navigateur consomme de la mémoire, du temps processeur, du stockage et de la capacité réseau dans des proportions fixées par les pages et par le travail effectué dessus. Une courte navigation textuelle se comporte très différemment d'une longue session avec médias, captures d'écran, téléchargements ou plusieurs étapes applicatives. La planification de capacité part donc de la répartition réelle des tâches, pas d'un nombre d'instances fixé à l'avance. BotBrowser peut exécuter des profils isolés en parallèle dans un environnement de test contrôlé pour mesurer votre propre répartition de tâches ; il ne peut pas garantir le même débit sur d'autres versions, plateformes ou matériels.
La capacité en production dépend des pages, du mode du navigateur, de la durée des sessions, de la route réseau, de la version, du backend graphique, du paquet de profil, de l'hôte et de la concurrence utilisée par l'application. Mesurez ces paramètres ensemble avant de modifier la mémoire, le processeur, le réseau ou le cycle de vie. L'objectif est d'achever les tâches de façon stable avec une protection de la vie privée cohérente, pas d'atteindre le plus grand nombre possible de workers.
La performance est aussi une question de fiabilité. Un manque de mémoire peut arrêter un navigateur en pleine opération et laisser des résultats incomplets et un état de session endommagé. Un processeur saturé ralentit chaque instance, ce qui allonge le chargement des pages et multiplie les délais dépassés. Les processus de navigateur orphelins épuisent peu à peu l'hôte. Un hôte sans marge de mémoire peut transformer la sortie d'un seul navigateur en interruption de service plus large : réservez donc de la capacité pour la variation normale de la charge et pour les démarrages simultanés.
Établissez une référence de capacité
Choisissez un petit ensemble de tâches qui reflète la production. Incluez une page rapide, une page plus lourde, la plus longue session normale et tout flux qui capture des médias ou télécharge des fichiers. Exécutez le même ensemble sur la classe d'hôte cible, avec la version de BotBrowser, la famille de profils, la politique de routage et le mode de navigateur prévus.
Enregistrez les tâches terminées, les tâches échouées, l'attente en file, la durée totale, la durée de lancement, la pression mémoire, la saturation du processeur, l'activité de stockage et le débit réseau. Utilisez des percentiles pour la latence plutôt qu'une moyenne unique. Les moyennes peuvent masquer les tâches lentes qui déterminent le comportement des délais d'attente et de la file.
Mesurez séparément un démarrage à froid et une exécution à chaud. Le résultat à froid représente le remplacement d'un hôte et la reprise après déploiement. Le résultat à chaud représente le service en régime établi. Les deux comptent, mais les fondre en un seul chiffre rend la comparaison entre versions difficile à interpréter.
Conservez une référence écrite pour chaque classe de charge. L'enregistrement doit identifier la classe d'hôte, le couple de versions, la famille de profils, l'ensemble de pages, la région de la route, le mode du navigateur, la fenêtre de test et le résultat. Il ne doit contenir ni contenu de pages, ni identifiants, ni données de navigation personnelles.
Fixez un budget de ressources
Réservez de la capacité pour le système d'exploitation, la supervision, l'activité de déploiement et le démarrage simultané. Le reste constitue le budget de la charge navigateur. Traitez la mémoire, le processeur, le stockage et le réseau comme des limites distinctes, car une tâche peut en épuiser une pendant que les autres paraissent saines.
La planification de la mémoire doit s'appuyer sur le pic observé et sur la tendance durable de RSS. Celle du processeur doit considérer à la fois la saturation et la latence des tâches. Celle du stockage doit inclure l'accès aux profils, les téléchargements, les artefacts temporaires et les journaux. Celle du réseau doit inclure la route approuvée en plus des pages cibles.
Le budget a aussi besoin d'une marge pour les échecs. Un worker qui réessaie immédiatement après un délai dépassé peut créer plus de pression que la tâche d'origine. Incluez les nouvelles tentatives normales et l'activité de reprise dans les mesures de préproduction avant d'approuver un plafond de production.
Associez chaque symptôme au compteur qui l'explique
Un symptôme indique où regarder, pas quoi changer. Le tableau associe une observation courante au compteur qui la tranche, pour que la revue de capacité parte de mesures réelles plutôt que d'une hypothèse sur l'hôte.
| Symptôme | Compteur à lire | Décision |
|---|---|---|
| L'attente en file monte et le processeur reste plat | p95_queue_wait face à completion_latency | La limite vient de la politique d'admission ; ajoutez des places par classe quand l'attente baisse |
| La mémoire résidente monte et le processeur reste bas | rss_per_context sur les contextes ouverts | Fermez les contextes inactifs ou allégez la page ; l'hôte est limité par la mémoire |
| Le processeur approche le plafond de l'hôte | cpu_saturation avec error_rate_after_retry | Baissez la concurrence ou passez les courtes sessions sur une compilation allégée |
| Le p95 de page monte avec un débit stable | p95_page_time par route avec error_rate_after_retry | Une dépendance ou une route lente ; isolez l'URL avant d'ajouter des hôtes |
error_rate_after_retry monte avec queue_depth | Nouvelles tentatives par tâche terminée | La régulation rend la capacité avant la fin du nettoyage ; différez la nouvelle tentative |
Lisez la ligne qui correspond à l'incident avant d'ouvrir une revue de capacité. Acheter un hôte sur la mauvaise ligne masque la limite réelle et ajoute du coût sans rétablir l'objectif de service.
Ordonnez l'analyse d'un incident
Écrivez l'ordre comme une politique pour que deux opérateurs arrivent à la même réponse :
- Gelez les nouvelles admissions pour que l'échantillon arrête de bouger pendant sa lecture.
- Comparez
rss_per_contextà la concurrence fautive avec la même valeur à la dernière concurrence acceptée. Une valeur plate alors que la mémoire libre de l'hôte passe sous un quart du nominal désigne l'hôte. - Comparez
p95_queue_waitàcompletion_latency. Une attente en file supérieure à la latence d'achèvement avec un processeur sous la moitié du nominal désigne la politique d'admission. - Comparez
launch_durationaux deux niveaux de concurrence. Un lancement qui croît avec les lectures parallèles de profils désigne le stockage des profils.
Cet ordre n'écarte un problème d'hôte que lorsque les étapes 2 et 4 reviennent plates et que l'étape 3 montre l'attente dans la file. Changez d'abord la ligne qui franchit la ligne de politique ; changer deux lignes à la fois laisse l'incident sans responsable. Traitez le quart et la moitié comme la politique d'exploitation de ce déploiement, pas comme un fait universel sur les navigateurs.
Protégez le budget par la régulation de charge
Placez une file bornée devant le travail du navigateur. N'admettez une nouvelle tâche que si le déploiement a la capacité pour sa classe de charge. Lorsque la file atteint sa limite, rejetez, différez ou redirigez le travail selon la politique du service. Ne laissez pas les appelants créer directement un travail navigateur sans limite.
Utilisez des files séparées lorsque les charges ont des coûts ou des objectifs de service très différents. Une longue tâche avec médias ne doit pas consommer tous les emplacements dont ont besoin les courtes vérifications applicatives. Un ordonnancement équitable et des limites par classe rendent le service plus simple à exploiter qu'un seul nombre global de concurrence.
Définissez explicitement la responsabilité de la file. L'ordonnanceur doit distinguer le travail en attente, actif, terminé, annulé et incertain, afin que la reprise ne duplique pas une tâche en silence. Appliquez les limites de nouvelles tentatives et les reprises différées au niveau de la file, et ne rendez de la capacité qu'après la fermeture propre de la session précédente.
La régulation doit réagir à des preuves durables, pas à un seul échantillon bruité. L'attente en file, la latence des tâches, les sorties du navigateur, la marge de l'hôte et l'achèvement du nettoyage donnent une vue combinée utile. Suivez queue depth avec ces indicateurs ; réduisez les admissions lorsque plusieurs sortent de la plage approuvée, et rétablissez-les progressivement après la reprise.
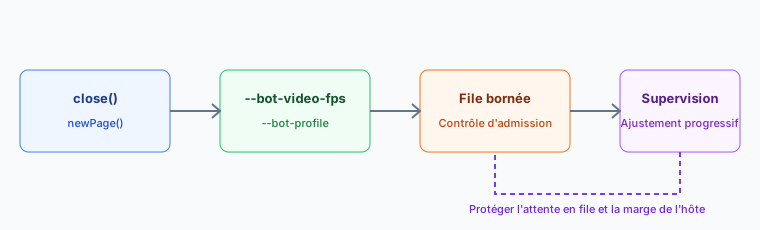
Réexaminez le budget après un changement de version du navigateur, d'image d'hôte, de famille de profils, de route ou de charge. Un plafond précédent reste une observation historique, pas un droit au même débit. Rejouer la référence garde les décisions opérationnelles liées à des preuves actuelles.
Une charge qui passe à 20 contextes et échoue à 40
Le même hôte, les mêmes pages et la même famille de profils peuvent passer une revue de capacité à 20 contextes et échouer à 40. L'échec a trois causes courantes, et chacune laisse un compteur différent.
- Mémoire de l'hôte.
rss_per_contextreste plat, mais la mémoire résidente totale franchit la mémoire libre de l'hôte, le noyau récupère des pages et les contextes les plus lents se bloquent. La décision est moins de contextes par hôte ou un hôte plus grand. - Temps de chargement du profil.
launch_durationcroît avec la concurrence parce que chaque contexte lit son profil au démarrage. Le stockage local et un jeu de profils plus petit raccourcissent le lancement ; l'hôte n'est pas la limite. - Politique d'admission.
p95_queue_waitcroît alors que le processeur reste bien sous le plafond et que la mémoire est stable. La file admet plus vite que le nettoyage ne rend de capacité : séparez les classes ou différez la nouvelle tentative.
Exécutez le cas à 40 contextes une fois avec les admissions gelées après le premier blocage. Si rss_per_context et launch_duration correspondent à l'exécution à 20 contextes, l'hôte n'est pas la cause et la file porte la correction. S'ils divergent, corrigez la ressource avant de régler l'admission, car un changement de politique ne récupère pas une mémoire déjà perdue.
Inscrivez la cause retenue, les deux niveaux de concurrence, ainsi que rss_per_context, launch_duration et p95_queue_wait dans le dossier de décision de capacité de la charge, pour que la revue suivante parte de cette comparaison plutôt que d'une page blanche.
Ajustez un coût à la fois
Validez une optimisation à la fois sur une charge de préproduction contrôlée. Comparez l'achèvement des tâches, le statut de sortie du navigateur, la tendance mémoire, la latence de création de page, l'achèvement des captures et la fermeture des contextes avec la configuration de version inchangée. Gardez constants la famille de profils, la route réseau, le backend graphique et l'ensemble de pages pendant la comparaison.
Mémoire et cycle de vie des pages
Traitez les limites de tas comme des réglages propres à chaque charge. Une limite basse peut interrompre du JavaScript légitime, tandis qu'une limite excessive peut supprimer la marge de l'hôte. Mesurez le tas conservé pendant le flux représentatif et ne modifiez les limites qu'avec le responsable de l'application et un plan de retour arrière.
Fermez les pages sans attendre pour que le navigateur libère les ressources du travail terminé. Appeler page.close() donne au navigateur une frontière claire de cycle de vie, alors que naviguer vers une autre URL ne met pas fin à la propriété de la page. Fermez aussi le navigateur lui-même sur chaque chemin de sortie et utilisez le superviseur du déploiement pour repérer un worker qui ne répond plus.
const page = await context.newPage();
try {
  await page.goto('https://example.com', { waitUntil: 'domcontentloaded' });
  // Lisez ici les données dont le flux a besoin.
} finally {
  await page.close();
}
Préférez domcontentloaded à l'attente d'un réseau inactif lorsque le flux n'a besoin que du document. La détection d'inactivité peut ajouter des secondes sur les pages lourdes, alors que le DOM est prêt bien plus tôt. Déduisez les délais de navigation et d'opération de l'objectif de service approuvé et de la distribution de latence observée, et traitez un délai dépassé comme un échec explicite, avec assez de diagnostics pour distinguer un retard de page d'une pression sur les ressources.
Recyclez les instances du navigateur à partir de preuves sur le cycle de vie. N'introduisez une limite par nombre de tâches ou par durée que si les tendances de préproduction et de production montrent qu'elle améliore la stabilité, gardez-la configurable et réexaminez-la après chaque changement de version. Ne réutilisez une page que tant qu'elle représente la même session et le même plan d'identité, et créez un nouveau contexte lorsque le stockage ou l'état du profil doivent être séparés.
Consignez dans les journaux applicatifs la fin du lancement, le statut de sortie, stderr, la durée des tâches, l'attente en file et la fermeture des contextes, et surveillez la mémoire de l'hôte avec les outils standard du système d'exploitation. Définissez les alertes à partir de la capacité mesurée de l'hôte et de l'objectif de service, et suivez les tendances plutôt que d'attendre l'épuisement.
Processeur et cadence vidéo
Conservez les fonctions du navigateur dont l'application a besoin. Désactiver le comportement en arrière-plan, les extensions, les médias ou les services de mise à jour peut changer le comportement des pages et la sûreté opérationnelle. Partez de la configuration documentée de la version et ne retirez une fonction qu'après qu'un contrôle qualité représentatif a confirmé que le flux n'en dépend pas.
Limitez la concurrence à partir de la saturation mesurée du processeur. Augmentez les workers progressivement en suivant le travail terminé, les erreurs du navigateur, le temps en file et la marge de l'hôte. Les charges de captures, de médias, de JavaScript complexe et de Canvas demandent des plafonds différents, si bien qu'un ratio universel d'instances par cœur n'est pas fiable.
Réduisez la cadence vidéo lorsque la lecture visuelle complète n'est pas nécessaire. Les pages riches en vidéo peuvent maintenir actif le travail de décodage et de rendu même quand l'automatisation n'a besoin que de mises à jour visuelles occasionnelles. Pour les profils dont Video FPS Control est activé, --bot-video-fps fixe la cadence vidéo réelle séparément du FPS média que les pages voient annoncé.
chromium-browser \
  --bot-profile="profiles/profile.enc" \
  --bot-video-fps=1:30 \
  --headless
Employez cette option pour la supervision riche en vidéo, le contrôle qualité ou les pages de longue durée dont le résultat ne dépend pas des pixels vidéo image par image. Consultez Video FPS Control pour la syntaxe et le benchmark pour la charge testée. Les réductions de processeur du benchmark sont des plages de référence pour une charge vidéo précise, pas des engagements de capacité ni des seuils de réussite ou d'échec.
Séparez les classes de charge au lieu d'appliquer une valeur globale à toutes les pages. Les pages dont la vidéo est le contenu principal exigent en général la cadence normale, alors que celles qui gardent des éléments vidéo en arrière-plan n'en ont souvent pas besoin. Mesurez le processeur avant et après le changement sur le même hôte, avec le même ensemble de pages et la même concurrence, et prenez une fenêtre d'échantillonnage assez longue pour inclure la lecture en régime établi et pas seulement le démarrage de la page.
Vérifiez aussi le type de sortie qui compte pour le flux. L'extraction du DOM, la capture d'API, les captures d'écran et les contrôles de pixels média tolèrent différemment une cadence visuelle réduite, et la sortie en pixels suit la cadence réelle. Gardez le réglage près du profil de lancement ou de la définition de tâche pour que l'opérateur suivant sache quelles tâches utilisent une cadence média réduite, et séparez-le des contrôles de FPS d'affichage.
Réseau et stockage
Bloquer les médias inutiles peut réduire le travail réseau et de rendu. Conservez les ressources dont l'application a besoin pour la mise en page, l'interaction, l'authentification et la validation de la vie privée, et testez chaque règle de blocage sur des pages représentatives. Gardez les feuilles de style et les polices lorsque le rendu du texte compte.
Lorsque la bande passante de la route est limitée, le routage sélectif peut garder certains chemins de requêtes hors du proxy. Consultez Proxy Selective Routing pour la syntaxe des règles et la licence requise. Les requêtes correspondantes se connectent directement : décidez quelles ressources peuvent quitter la route du proxy selon la politique réseau approuvée, et répétez la validation de la route chaque fois que les identifiants, la région ou la sortie changent.
Un proxy ajoute de la latence réseau à chaque requête qu'il transporte. Gardez la route stable pendant un benchmark et comparez p95 request latency avant de changer la région de sortie.
Stockez les paquets de profil sur un stockage local rapide plutôt que sur des volumes montés en réseau. Le chargement du profil a lieu une seule fois au démarrage, et son coût relatif dépend de l'ensemble du flux de lancement. Pour les déploiements qui redémarrent souvent des instances, le stockage local peut réduire le délai lié au réseau dans le chemin de démarrage.
Graphisme et hôtes headless
Plus de capacité apporte une marge utile, mais ne corrige ni les files sans limite, ni une fermeture incomplète, ni un backend graphique inadapté. Mesurez la charge avant d'ajouter des hôtes, et ajoutez de la capacité lorsqu'une charge durable ne respecte plus l'objectif de service après vérification de la file et de la fermeture.
Le mode headless peut réduire une partie du travail du système de fenêtrage, mais la page utilise toujours des ressources visuelles, réseau, JavaScript et de stockage : considérez la différence comme propre à chaque charge. Gardez le support graphique activé, car le retirer peut modifier les capacités de rendu des charges qui reposent sur WebGL ou WebGPU.
Utilisez le guide Linux GPU Backend lorsque le déploiement s'exécute sans écran physique. Sous Linux, gardez le même backend graphique sélectionné sur les workers comparables. Un changement qui supprime une capacité requise du navigateur n'est pas une amélioration de performance valable.
Acceptez les versions avec des preuves de reprise
Comparez des phases opérationnelles représentatives
Une version candidate doit être mesurée par rapport à la référence approuvée avec les mêmes classes de charge et la même image d'hôte. Gardez séparés le démarrage à froid, le travail stable à chaud et l'arrêt contrôlé. Le démarrage à froid montre si de nouveaux workers peuvent entrer en service de façon prévisible. La phase stable montre si l'attente en file et l'usage des ressources restent stables une fois les caches et les connexions installés. L'arrêt montre si la capacité revient après le travail terminé, annulé et échoué. Comparez p95 queue delay à la latence d'achèvement pour repérer une attente d'admission croissante.
Exécutez chaque phase assez longtemps pour révéler la variation normale de la réponse des pages et de la latence de la route. Comparez les distributions du temps d'achèvement et de l'attente en file, ainsi que la pression mémoire durable, la contention processeur, l'activité de stockage et l'usage réseau. Une courte exécution réussie sert à vérifier la compatibilité de base, mais ne suffit pas pour approuver un budget de ressources de production.
Documentez la répartition de charge utilisée pour la décision. Incluez des tâches ordinaires, la plus longue session prise en charge et un cas d'échec autorisé. Ainsi, le dossier d'acceptation reste utile lorsque l'application, la route, l'image d'hôte ou la version du navigateur changent plus tard.
Appliquez des critères d'acceptation explicites
L'acceptation d'une version doit établir si le service accomplit le travail requis tout en préservant la marge opérationnelle. Examinez ensemble l'achèvement réussi, la gestion attendue des erreurs, la croissance de la file, l'achèvement du nettoyage et le temps de reprise. Une version ne doit pas être validée simplement parce que ses tâches les plus rapides s'améliorent alors que les plus lourdes deviennent moins fiables.
Prenez l'objectif de service existant comme limite de décision. S'il n'existe aucun objectif formel, établissez-en un à partir de la version approuvée actuelle avant de comparer une candidate. Consignez tout compromis délibéré, comme une légère hausse de latence en échange d'une pression mémoire durable plus faible, et obtenez l'accord du responsable de l'application. Ajoutez le SLO et la fenêtre de mesure au dossier d'acceptation.
Gardez les contrôles de vie privée et les contrôles fonctionnels dans le même plan d'acceptation. Un changement qui économise des ressources mais supprime un comportement de rendu, de stockage, de média ou de réseau nécessaire est une régression, même si l'utilisation de l'hôte baisse. Les preuves de performance ne soutiennent une version que si le flux représentatif produit toujours le résultat autorisé.
Éprouvez la régulation et la reprise
Les tests d'acceptation doivent inclure une période où les arrivées dépassent la capacité de service disponible. Vérifiez que la file bornée applique la politique d'admission prévue, protège le travail déjà en cours et revient à sa plage normale quand la demande baisse. Observez si les nouvelles tentatives sont différées selon la politique au lieu d'ajouter immédiatement de la pression.
Testez aussi une interruption contrôlée d'un worker. Le superviseur doit identifier le worker indisponible, conserver un résultat de tâche clair et n'admettre du travail de remplacement qu'une fois la capacité disponible. Le travail terminé ne doit pas être répété en silence, et le travail incertain doit suivre la politique de rapprochement de l'application.
Après l'interruption, vérifiez que la mémoire, l'activité de stockage, l'attente en file et la latence d'achèvement reviennent dans la plage opérationnelle approuvée. Un service qui recommence à accepter des tâches alors que le nettoyage est incomplet n'a pas entièrement récupéré. Maintenez l'admission réduite jusqu'à ce que les preuves montrent que le flux de tâches et la marge de l'hôte sont stables ; incluez queue depth dans l'observation de reprise.
Conservez les preuves de retour arrière
Chaque changement de performance a besoin d'une condition de retour arrière et d'un responsable. La condition peut être une croissance durable de la file, une fiabilité d'achèvement réduite, un nettoyage incomplet ou la perte de marge de reprise. Définissez-la avant le déploiement afin que la décision ne repose pas sur une interprétation improvisée pendant un incident.
Conservez l'identifiant de version, l'image d'hôte, le manifeste de charge, la classe de route, le dossier de configuration, la fenêtre d'observation et les résultats résumés pour la candidate comme pour la référence approuvée. Associez les valeurs release_id de la candidate et de la référence à leurs fenêtres d'observation. Stockez les journaux selon la politique de conservation et d'accès de l'organisation, et retirez de l'enregistrement les identifiants, le contenu des pages et les données personnelles.
Pendant un déploiement progressif, n'élargissez que lorsque l'étape précédente satisfait les critères d'acceptation sur une fenêtre d'observation suffisante. Si une condition de retour arrière apparaît, arrêtez toute nouvelle extension, réduisez les admissions, terminez ou rapprochez le travail accepté, puis rétablissez la dernière configuration approuvée. Rejouez la référence représentative après le retour arrière pour confirmer que la reprise est complète, au lieu de supposer que le changement de version a suffi.
Où BotBrowser s'intègre
Pour les sessions riches en vidéo, BotBrowser prend en charge --bot-video-fps (ENT Tier2, sur les profils dont Video FPS Control est activé), qui abaisse la cadence réelle de décodage et de rendu vidéo tandis que le FPS média annoncé se règle séparément. Quand la cadence visuelle complète n'est pas nécessaire, cela peut réduire la charge processeur : il vaut donc la peine de le tester comme un changement contrôlé dans le plan ci-dessus. BotBrowser ne peut pas garantir une économie de processeur ni un chiffre de capacité pour toutes les charges, ne remplace pas les références de capacité, les files, la régulation de charge et la fermeture ordonnée dont l'opérateur est responsable, et ne peut pas préserver la sortie en pixels image par image une fois la cadence réelle abaissée. Relevez la valeur réelle lorsqu'un flux échantillonne les pixels vidéo.
Pour les déploiements qui évaluent des flux par contexte, Per-Context Fingerprint (ENT Tier3) est une option dépendant de la licence, à mesurer avec la même charge autorisée et les mêmes exigences de vie privée que la topologie existante. Considérez le résultat comme une preuve propre à la charge, pas comme un engagement général de capacité. BotBrowser ne fixe ni la capacité de l'hôte, ni la politique de files, ni les performances du proxy, ni le comportement des pages : ces décisions restent au responsable de l'application.
Téléchargez BotBrowser pour préparer un déploiement ou contactez notre équipe entreprise pour planifier l'infrastructure. Consultez Configuration d'un serveur headless, Guide de déploiement Docker, CLI Recipes et Bonnes pratiques pour les captures d'écran pour les détails d'implémentation.
Lorsqu’une page doit choisir des indications de file en plus de la capacité de l’hôte, les priorités scheduler.postTask fournissent le registre d’annulation et de repli qui garde cette limite explicite.
Sources publiques
- BotBrowser FPS Control
- Benchmark BotBrowser
- BotBrowser Proxy Selective Routing
- BotBrowser Linux GPU Backend
- API Page de Playwright
Conclusion
Commencez par une référence qui couvre l'attente en file, la latence d'achèvement, la pression sur les ressources et le nettoyage. Définissez une admission bornée à partir de ces mesures, ne changez qu'un coût à la fois et conservez la configuration précédente jusqu'à ce que les mêmes tâches représentatives respectent l'objectif de service après le déploiement.
Cet article fait partie du guide : Déploiement et livraison du navigateur : carte opérationnelle
Articles Connexes
Planifier la capacité des BrowserContext
DéploiementAdapter la charge avec les profils Per-Context
DéploiementLimites de ressources d’un conteneur : méthode pratique
DéploiementMémoire des BrowserContext dans Chromium 151 : cas de version
DéploiementBotBrowser Trimmed Linux x64 : choix et validation
DéploiementDéploiement et livraison du navigateur : carte opérationnelle
Faites passer BotBrowser de la recherche à la production
Utilisez ces guides pour comprendre le modèle, puis passez à la validation multi-plateforme, aux contextes isolés et au déploiement navigateur prêt pour l'échelle.