Puppeteer MCP : configurer un build Chromium propre
Configurez un serveur MCP basé sur Puppeteer pour lancer un build Chromium précis avec un profil, et voyez pourquoi une configuration Playwright ne se copie pas.
BotBrowser Team
Vous voulez la documentation structurée pour Déploiement ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
Un serveur MCP basé sur Puppeteer possède le lancement du navigateur, donc la configuration qu’on lui remet décide quel binaire Chromium et quel profil chaque tâche d’agent utilise. Le LaunchOptions de Puppeteer a une forme différente de celui de Playwright, et une configuration copiée de l’un à l’autre perd silencieusement les parties qui n’existent pas de l’autre côté. La défaillance est discrète : le serveur démarre, les outils répondent, et le navigateur est celui que le serveur aurait utilisé de toute façon. Puppeteer documente executablePath comme un chemin utilisé à la place du navigateur embarqué, avec un avertissement que seul son propre build est garanti, donc le réglage est délibéré plutôt que transparent. BotBrowser démarre depuis Puppeteer avec executablePath et un argument de profil dans args, et ne fournit aucun serveur MCP, donc un serveur qui ne transmet jamais ces valeurs ne peut pas être corrigé côté navigateur.
TL;DR
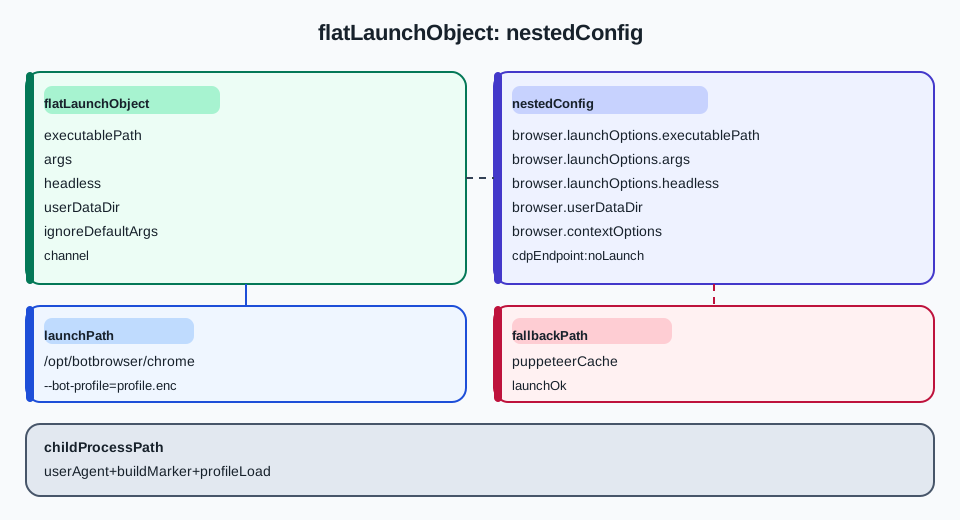
- L’objet de lancement Puppeteer place
executablePath,args,headless,userDataDir,ignoreDefaultArgs,pipeetbrowserau même niveau. Playwright imbrique les mêmes idées souslaunchOptions, donc les deux formes ne sont pas interchangeables. headlessacceptetrue,falseou la chaîne'shell', et'shell'sélectionne l’ancienne implémentation headless. Un booléen de style Playwright écrit ici reste valide ; une configuration Playwright copiée en bloc ne l’est pas.executablePathremplace le navigateur embarqué, et la documentation de Puppeteer avertit que seul le build embarqué est garanti. Traitez un chemin personnalisé comme une configuration prise en charge mais non vérifiée, et prouvez-la en relisant le processus.- Le profil voyage dans
argscomme élément propre, exactement comme sous Playwright, parce que c’est un argument du navigateur et non une option Puppeteer. ignoreDefaultArgsetpipechangent ce que le serveur remet au processus. Un serveur qui définitignoreDefaultArgs: trueretire les options que Puppeteer ajouterait, donc l’argv effectif n’est ni le vôtre ni celui par défaut de Puppeteer.
Sommaire
- Où vit l’objet de lancement Puppeteer
- En quoi il diffère de la forme Playwright MCP
- Transmettre le profil et le mode headless
- Vérifier le binaire réellement démarré
- Conclusion pratique
Où vit l’objet de lancement Puppeteer
Le LaunchOptions de Puppeteer est un objet plat passé à puppeteer.launch(). executablePath en est un membre de premier niveau, aux côtés de args, headless, userDataDir, ignoreDefaultArgs, pipe, browser, channel et debuggingPort. Il n’y a pas d’enveloppe launchOptions, parce que l’objet entier est l’objet de lancement.
{
  "mcpServers": {
    "puppeteer": {
      "command": "npx",
      "args": ["-y", "@modelcontextprotocol/server-puppeteer"],
      "env": {
        "PUPPETEER_EXECUTABLE_PATH": "/opt/botbrowser/chrome",
        "PUPPETEER_LAUNCH_OPTIONS": "{\"headless\":true,\"args\":[\"--bot-profile=/etc/botbrowser/profile.enc\"]}"
      }
    }
  }
}
L’exemple ci-dessus montre les deux façons dont un serveur peut recevoir les valeurs : une variable d’environnement dédiée pour l’exécutable et un bloc JSON pour le reste. Aucun de ces noms n’est normalisé entre serveurs Puppeteer, ce qui est la première chose à vérifier : lisez la documentation du serveur pour la variable ou l’option exacte qu’il lit, puis confirmez que la valeur arrive.
| Membre Puppeteer | Type | Effet sur un build personnalisé |
|---|---|---|
executablePath | string | Remplace le navigateur embarqué ; seul le build de Puppeteer est garanti |
args | string[] | Arguments de ligne de commande supplémentaires, un élément par argument |
headless | boolean ou 'shell' | true utilise le nouveau mode headless, 'shell' l’ancien |
userDataDir | string | Répertoire de données utilisateur persistant, distinct d’un argument de profil BotBrowser |
ignoreDefaultArgs | boolean ou string[] | Retire les options par défaut de Puppeteer, ou filtre celles nommées |
pipe | boolean | Transporte le protocole sur stdio au lieu d’un WebSocket |
browser | SupportedBrowser | Sélectionne la famille de navigateurs attendue par Puppeteer |
channel | ChromeReleaseChannel | Cherche un Chrome installé à un emplacement système connu |
Deux de ces lignes méritent attention dans un déploiement personnalisé. channel et executablePath peuvent tous deux désigner un navigateur, et la documentation décrit channel comme la recherche d’une installation Chrome à un emplacement système connu. Définir les deux laisse deux réponses à la même question, et celle qui l’emporte est un détail d’implémentation qu’il vaut mieux éliminer que tester.
Pourquoi la forme plate se lit mal
Un objet plat n’offre aucun signal structurel sur les clés qui relèvent du lancement et celles qui relèvent d’un contexte. Sous Playwright, une clé mal placée atterrit dans un autre objet et est ignorée ; sous Puppeteer, une clé absente de LaunchOptions ne fait simplement pas partie des options, et puppeteer.launch() n’a aucune raison de protester. Le résultat est le même silence par un autre chemin : le serveur démarre, et l’un des réglages n’a jamais été appliqué.
La vérification pratique consiste à écrire l’objet et à comparer ses clés avec les membres documentés de LaunchOptions. Tout ce qui n’est pas sur cette liste n’est pas une option de lancement, quelle que soit son apparence.
Ce que Puppeteer fait d’un chemin inutilisable
executablePath désigne un fichier, et Puppeteer démarre ce fichier. Si le chemin n’existe pas, ne se résout pas dans le répertoire de travail du serveur, ou existe sans être exécutable par le compte qui fait tourner le serveur, le lanceur produit une erreur au lieu de substituer un autre binaire ; cela découle du fait que Puppeteer remet le chemin donné au processus qu’il engendre, et c’est une inférence sur le comportement du lanceur, non une phrase que la page LaunchOptions affirme. Ce comportement mérite d’être connu parce qu’il est l’inverse du cas silencieux : un mauvais chemin qui existe produit un navigateur fonctionnel qui n’est pas celui visé, tandis qu’un chemin inexistant produit une erreur que l’opérateur voit.
La défaillance qui se cache est donc celle où le chemin est valide et pointe ailleurs. Un serveur qui substitue un chemin par défaut quand sa configuration est absente produit exactement cela : un exécutable valide, un navigateur fonctionnel et aucune erreur. La vérification doit comparer le chemin observé avec le chemin visé plutôt que constater qu’un chemin existe.
Ce que le serveur ajoute par-dessus
Un serveur MCP basé sur Puppeteer est une enveloppe : il lit sa propre configuration, construit un objet LaunchOptions et appelle puppeteer.launch(). Tout ce que le serveur ajoute entre sa configuration et cet appel est invisible de l’extérieur. C’est pourquoi la relecture compte davantage ici que dans un script direct, où l’objet d’options est celui que l’opérateur a écrit.
La variante Playwright de cette enveloppe, avec sa forme imbriquée et son repli silencieux vers un navigateur embarqué, est traitée dans configurer Playwright MCP pour un build Chromium personnalisé, et le partage des responsabilités entre une boucle d’agent et le processus du navigateur se trouve dans navigateur headless pour agents IA. Un serveur peut ajouter un tableau args par défaut, une valeur headless par défaut ou un ignoreDefaultArgs. Un serveur qui ajoute ses propres arguments produit un argv qui est l’union des vôtres et de ses valeurs par défaut, dans un ordre que vous n’avez pas choisi. Lire le processus en cours est le seul moyen de voir cette union.
Pourquoi l’argv effectif compte plus que la configuration
Deux exécutions peuvent partager un fichier de configuration et démarrer des navigateurs différents si la version du serveur a changé ses valeurs par défaut entre les deux. Un serveur qui commence à ajouter une nouvelle option par défaut, ou cesse d’en ajouter une, change l’argv effectif sans toucher au fichier de l’opérateur. Comme le navigateur lit l’argv et non la configuration du serveur, le comportement observable suit l’argv.
C’est l’argument pour enregistrer l’argv effectif à côté de l’observation plutôt que seulement la configuration qui l’a produit. Une configuration plus une version de serveur est reproductible ; une configuration seule ne l’est plus dès que le serveur peut changer ce qu’il ajoute.
En quoi il diffère de la forme Playwright MCP
Les deux écosystèmes répondent à la même question avec des structures différentes, et les différences sont celles qui cassent une configuration copiée.
| Sujet | Playwright MCP | Objet de lancement Puppeteer |
|---|---|---|
Où va executablePath | browser.launchOptions.executablePath | executablePath au premier niveau |
Où va args | browser.launchOptions.args | args au premier niveau |
| Valeur headless | Booléen headless dans launchOptions | Booléen ou chaîne 'shell' |
| Réglages de contexte | Objet browser.contextOptions séparé | Absents de LaunchOptions ; le serveur ou le code règle la fenêtre ailleurs |
| Persistance du profil | userDataDir sous browser | userDataDir au premier niveau |
| Connexion à un navigateur déjà lancé | cdpEndpoint ou remoteEndpoint | browserWSEndpoint ou connect(), hors LaunchOptions |
Les deux premières lignes expliquent pourquoi un bloc JSON Playwright MCP collé dans un serveur Puppeteer ne fait rien : les clés n’existent dans aucun des endroits que le serveur Puppeteer consulte. La troisième est plus subtile, parce que headless: true est valide dans les deux, donc une copie peut sembler fonctionner alors que la structure environnante est fausse.
La séparation de contexte n’existe pas ici
Playwright sépare les options de lancement des options de contexte, ce qui explique que la fenêtre, la langue et les permissions vivent dans un autre objet. Le LaunchOptions de Puppeteer n’a pas cette séparation : la fenêtre et les réglages de page sont appliqués après le lancement, par page.setViewport() ou un descripteur d’appareil. Une configuration qui attend d’un bloc contextOptions qu’il porte une langue n’en trouvera aucun.
Cette différence compte quand une tâche dépend d’une langue ou d’un fuseau horaire. Sous Playwright MCP, ils appartiennent au contexte et sont configurés avant que la page existe. Sous Puppeteer, ce sont soit des arguments de navigateur dans args, soit des appels de script après le lancement, et le serveur doit exposer un moyen de faire l’un ou l’autre.
Les appels d’émulation sont une troisième voie
page.emulate() et page.setViewport() changent ce que la page rapporte après le démarrage du navigateur, ce qui en fait un troisième endroit d’où peuvent venir une langue, un fuseau horaire ou une taille de fenêtre. Une charge qui définit une langue dans args, une autre par un appel d’émulation et une troisième par les valeurs par défaut du serveur possède trois sources et aucune réponse unique.
La règle qui garde cela traitable est une source par propriété. Choisissez args pour tout ce que le navigateur doit savoir avant la première requête, et un appel d’émulation seulement pour ce dont la page a besoin après le chargement. Enregistrez la voie utilisée par chaque propriété, parce qu’une comparaison ultérieure entre une exécution qui a réglé une langue dans args et une exécution qui l’a réglée par émulation ne compare pas la même chose.
Deux notions différentes de profil
Le userDataDir de Puppeteer et un argument de profil BotBrowser décrivent tous deux un état persistant, et ce ne sont pas la même chose. userDataDir est un répertoire de données utilisateur Chromium que Puppeteer transmet. Un profil BotBrowser est un fichier de configuration chiffré que le binaire charge par sa propre option. Définir l’un ne définit pas l’autre, et un serveur qui n’expose que userDataDir n’a aucun emplacement pour l’argument de profil sauf s’il transmet des args arbitraires.
Transmettre le profil et le mode headless
L’argument de profil est un argument du navigateur, donc il va dans args comme un élément. Le mode headless est une option Puppeteer, donc il va dans headless. Confondre les deux est la prochaine erreur à vérifier après la confusion de forme.
{
  "executablePath": "/opt/botbrowser/chrome",
  "headless": true,
  "args": ["--bot-profile=/etc/botbrowser/profile.enc", "--bot-locale=en-US", "--no-first-run"]
}
Chaque élément est un argument, sans guillemets de shell. Une chaîne unique contenant des espaces est un argument malformé. Le troisième élément de l’exemple est une option Chromium ordinaire plutôt qu’une option BotBrowser, ce qui mérite d’être noté parce que args mélange librement les deux : Puppeteer ne les distingue pas.
Guillemets, échappement et la couche JSON
Si la configuration est du JSON, les arguments traversent deux couches : l’échappement de chaîne JSON puis le vecteur d’arguments. Un chemin Windows comme C:\botbrowser\chrome.exe exige des barres inverses échappées en JSON, et une valeur contenant un guillemet exige l’échappement JSON plutôt qu’un échappement de shell. Réussir une couche et échouer l’autre produit un chemin qui semble correct dans le fichier et faux au lancement.
Gardez les valeurs exemptes de caractères à échapper quand c’est possible. Un chemin de profil sans espaces ni guillemets évite toute cette classe de problème, et un chemin absolu sous un répertoire court se vérifie caractère par caractère plus facilement qu’un chemin long.
Headless, 'shell' et ce qui change
Puppeteer documente headless comme acceptant true ou la chaîne 'shell', où true sélectionne le nouveau mode headless et 'shell' l’ancien. La distinction n’est pas cosmétique : les deux modes diffèrent dans la façon dont le navigateur compose et dans les API qui rapportent quoi. Une charge qui compare le rendu ou lit une capacité média doit enregistrer le mode utilisé, parce que deux exécutions dans des modes différents ne sont pas la même mesure.
Quand ignoreDefaultArgs change la réponse
ignoreDefaultArgs accepte true ou un tableau de noms d’options. Avec true, Puppeteer cesse d’ajouter ses arguments par défaut, donc le navigateur démarre avec seulement ce que contient args. Avec un tableau, les valeurs nommées sont filtrées et le reste demeure. Les deux changent l’argv effectif, et les deux sont le genre de réglage qu’un serveur peut appliquer de lui-même.
La conséquence opérationnelle est qu’une option BotBrowser documentée peut être neutralisée par une valeur par défaut que Puppeteer ajoute, et qu’une valeur par défaut attendue par Puppeteer peut être retirée par ignoreDefaultArgs. Ni l’une ni l’autre n’est visible dans le fichier de configuration, ce qui explique que l’étape de vérification lise le processus plutôt que la configuration.
pipe et la façon dont le serveur parle au navigateur
pipe: true transporte le protocole d’automatisation sur l’entrée et la sortie standard au lieu d’ouvrir un WebSocket. Pour un serveur qui exécute le navigateur comme processus enfant, cela retire un port d’écoute de l’équation, ce qui change à la fois les modes de défaillance et la surface de sécurité. Une configuration qui suppose qu’un port de débogage existera ne tient pas quand pipe est défini, et un outil qui se connecte par un port ne peut pas atteindre un navigateur transporté par pipe.
Enregistrez le transport utilisé par une exécution. Un résultat recueilli par pipe et un résultat recueilli par port proviennent du même navigateur seulement si le reste de la configuration correspond, et le transport fait partie de cette configuration plutôt que d’un détail d’implémentation.
Vérifier le binaire réellement démarré
La vérification comporte trois lectures, et elles répondent à des questions différentes. Le chemin du processus prouve quel fichier a été exécuté. L’agent utilisateur décrit ce que la page rapporte, qu’un build personnalisé peut configurer indépendamment du binaire. Un marqueur de build prouve une capacité que le build standard n’a pas.
Lisez d’abord le processus. Sur l’hôte qui a engendré le serveur, trouvez le processus enfant et comparez son exécutable avec le chemin configuré. Un serveur qui n’a pas transmis executablePath affiche à la place un chemin sous le répertoire de cache de Puppeteer, et cette seule comparaison tranche la question sans aucune sonde au niveau de la page.
| Lecture | Ce qu’elle prouve | Ce qu’elle ne prouve pas |
|---|---|---|
| Exécutable du processus enfant | Quel fichier le serveur a exécuté | Que le profil a été chargé |
navigator.userAgent | Ce que la page rapporte | Quel binaire l’a produit |
| Marqueur de build | Qu’une capacité précise est présente | Que la configuration l’a atteinte par la voie prévue |
| Preuve de chargement du profil | Que le profil chiffré a été accepté | Que le contenu de la page est correct |
Quand l’arbre de processus n’est pas visible
Un serveur exécuté dans un conteneur, un hôte distant ou un bac à sable peut ne pas exposer ses processus enfants au shell de l’opérateur. Dans ce cas le chemin doit venir de l’intérieur de l’environnement qui possède le processus, par une ligne de journal que le serveur écrit, une entrée /proc ou un outil de diagnostic fourni par la plateforme. L’exigence ne change pas : comparez l’exécutable observé avec celui configuré, depuis l’endroit où l’observation est disponible.
Là où aucun de ces moyens n’existe, un marqueur de build dans la page est la preuve de repli, et il faut la présenter comme plus faible. Un marqueur prouve qu’une capacité est présente ; il ne prouve pas que le processus qui sert la page est celui que l’opérateur a configuré.
Enregistrer une vérification
Stockez le chemin configuré, le chemin observé, le mode headless, l’args effectif et le résultat du marqueur avec un horodatage. Une exécution ultérieure peut alors comparer sans redéduire ce qu’était la référence. Quand une mise à jour du serveur change son args par défaut, cet enregistrement est ce qui rend le changement visible.
Ce qu’un client ne voit pas
Un client MCP voit les outils que le serveur publie. Il ne voit pas l’objet de lancement, l’arbre de processus ni les arguments transmis. Du côté client, un serveur mal configuré est indiscernable d’un serveur correct, ce qui explique que la vérification doive être demandée à travers la session et enregistrée en dehors d’elle.
Un tableau de symptômes pour la voie Puppeteer
| Symptôme | Cause | Confirmation | Correction |
|---|---|---|---|
| Le navigateur démarre sans réglages de profil | Argument de profil absent de args | args n’a aucun élément commençant par l’argument de profil | Ajouter un élément de tableau par option |
| Le navigateur démarre depuis le répertoire de cache | executablePath n’a jamais atteint l’objet de lancement | Le chemin du processus enfant se résout sous le cache Puppeteer | Déplacer la clé au premier niveau de l’objet de lancement |
| Le serveur sort avec une erreur de lancement | Chemin absent ou non exécutable | Le chemin ne se résout pas pour le compte du serveur | Utiliser un chemin absolu exécutable par ce compte |
| Les options se comportent autrement après une mise à jour | Le serveur a changé son args par défaut | L’argv effectif diffère de celui enregistré | Enregistrer l’argv et figer la version du serveur |
| Un outil ne joint pas le navigateur | Transport incohérent entre pipe et port | La configuration définit pipe alors que l’outil attend un port | Choisir un transport par déploiement |
La deuxième ligne est celle qui survit à une session qui fonctionne. Un serveur retombé sur son navigateur embarqué répond correctement à chaque appel d’outil, et la seule preuve est le chemin du processus.
FAQ
Une configuration Playwright MCP peut-elle être réutilisée pour un serveur Puppeteer ?
Non. Playwright MCP imbrique executablePath et args sous browser.launchOptions, et Puppeteer attend les deux au premier niveau de son objet de lancement. Un bloc collé laisse le serveur Puppeteer sans chemin d’exécutable, donc il démarre son navigateur embarqué et signale un succès.
headless: 'shell' est-il identique à headless: false ?
Non. 'shell' sélectionne l’ancienne implémentation headless, qui tourne toujours sans fenêtre visible mais compose et rapporte différemment du nouveau mode headless. false lance un navigateur avec fenêtre. Enregistrer lequel des trois une exécution a utilisé garde deux mesures comparables.
userDataDir remplace-t-il un profil BotBrowser ?
Non. userDataDir est un répertoire de données utilisateur Chromium que Puppeteer transmet au navigateur. Un profil BotBrowser est un fichier de configuration chiffré que le binaire charge par sa propre option dans args. Un serveur qui n’expose que userDataDir n’a aucun emplacement pour le profil sauf s’il transmet des arguments arbitraires.
Conclusion pratique
Écrivez l’objet de lancement à plat, avec executablePath, args et headless au même niveau, et placez l’argument de profil dans args comme élément propre. Lisez ensuite le processus enfant sur l’hôte et comparez son exécutable avec le chemin configuré avant de faire confiance à un résultat de la session.
L’action suivante tient en un lancement : démarrer le serveur, demander au client une seule navigation, et lire le chemin du processus enfant sur l’hôte. S’il correspond au chemin configuré, le binaire est prouvé. S’il pointe dans le cache de Puppeteer, le serveur a ignoré l’option et chaque résultat décrit un navigateur que vous n’avez pas choisi.
Sources
Cet article fait partie du guide : Déploiement et livraison du navigateur : carte opérationnelle
Articles Connexes
Playwright MCP : lancer un build Chromium personnalisé
DémarrageNavigateur headless pour agents IA : lancement et limites des outils
DéploiementSignaux d'automatisation et cohérence avec Playwright
DéploiementAutomatiser le navigateur avec Stagehand
DémarragePlaywright avec des profils d'identité cohérents
DémarragePuppeteer + BotBrowser : pièges de lancement et de profil
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.