Browserless face aux navigateurs auto-hébergés
Un navigateur géré vous remet une session via CDP. Ce qu’il ne remet pas, c’est une identité de navigateur stable. Voici la frontière, avec ses limites documentées.
BotBrowser Team
Vous voulez la documentation structurée pour Déploiement ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
Un navigateur géré est un service qui exécute le processus du navigateur et vous en remet une connexion, et toute la décision repose sur les parties du navigateur qu’il contrôle. BotBrowser fournit un profil déclaré qui maintient cohérentes entre elles les surfaces qu’une page peut lire d’un lancement à l’autre, et il ne peut pas remplacer une flotte hébergée, un courtier de sessions ni un quota de concurrence. Le service publie plus qu’un socket : l’état de session, l’émulation de système d’exploitation et les routes renforcées couvrent des couches différentes, et la couche qu’elles ne couvrent pas est celle qui décide si une session neuve ressemble à la précédente.
Résumé
- Un navigateur géré vous donne un navigateur en cours d’exécution via CDP ou WebSocket ; l’automatisation reste la vôtre et le résultat face au contrôle anti-bot aussi.
- Les services de scraping gérés sont un autre produit : ils renvoient des données, pas une session.
- Browserless documente deux mécanismes de persistance : l’API de session conserve cookies,
localStorageet cache, et les profils authentifiés ajoutent IndexedDB et deux en-têtes stables. - Son émulation de système d’exploitation est un paramètre de requête par session sur des routes précises, pas un profil stocké ; elle laisse le fuseau horaire et la langue à votre code ou au proxy, et ne fixe un viewport mobile qu’avec la persona Android.
browserless vs puppeteerest une erreur de catégorie : l’un est un service, l’autre la bibliothèque avec laquelle vous vous connectez.- La facturation est la concurrence multipliée par le temps, donc le point de bascule face à l’auto-hébergement est une question d’utilisation, pas de volume.
- Un navigateur auto-hébergé est le bon choix quand l’identité doit survivre entre les sessions, les builds et les machines ; un navigateur géré l’est quand le travail n’a pas besoin d’identité.
Sommaire
- Ce qu’un navigateur géré est
- Les trois architectures côte à côte
- L’état de session n’est pas l’identité du navigateur
- La comparaison qui n’en est pas une
- Ce que la facture couvre réellement
- Conclusion pratique
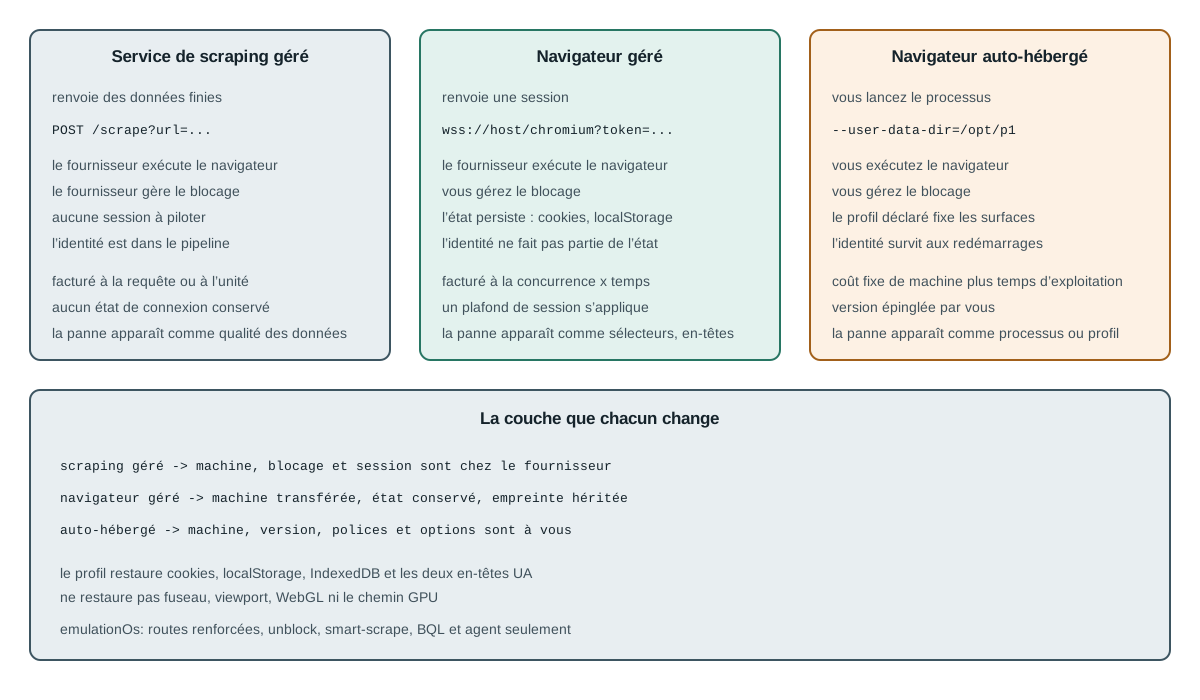
Ce qu’un navigateur géré est, et ce qu’il n’est pas
Le service exécute un processus du navigateur sur sa propre infrastructure et l’expose par un protocole que votre code parle déjà. Browserless le documente comme Browser-as-a-Service : connectez Puppeteer ou Playwright à un endpoint WebSocket et gardez le script que vous avez déjà, la chaîne de connexion étant le seul changement. Le même compte expose aussi des endpoints REST sans état comme /content, /scrape et /screenshot, où une requête HTTP exécute une tâche du navigateur et renvoie un résultat.
Cette séparation est la première chose à garder en tête, parce que les deux moitiés ont des économies différentes et des modes de défaillance différents. Un cadre d’agents qui enveloppe un navigateur ajoute une troisième couche, et comment un navigateur géré et une couche d’agents se partagent le travail est la même question posée un niveau plus haut.
BaaS endpoint      -> wss://.../chromium?token=...   session you drive; you own the code
REST endpoint      -> https://.../content?url=...    one request, one result, no session
self-hosted        -> chrome --user-data-dir=...     process on your machine
Ce que la moitié gérée supprime, c’est la surface opérationnelle : pools de processus, redémarrages après incident, installations de version et capacité. Ce qu’elle ne supprime pas, c’est la couche de décision. Vous choisissez toujours le viewport, les en-têtes, le moment de la navigation et la politique de nouvelle tentative, et vous découvrez toujours si la cible a accepté la session. Un navigateur géré est un autre endroit où le navigateur s’exécute, pas une conclusion différente sur sa réussite. La même séparation apparaît quand une page est assemblée à partir de plusieurs sources à l’exécution, et une boutique qui mélange API et données rendues le montre dans un cas concret.
Le troisième produit de cet espace se confond facilement avec les deux précédents. Un service de déblocage web ou une API de scraping exécute lui aussi un navigateur côté serveur, mais il renvoie le résultat extrait plutôt que la session. Si ce dont vous avez besoin est une session à piloter, ce produit a la mauvaise forme quelle que soit sa qualité, et l’inverse est tout aussi vrai : automatiser un flux page par page au-dessus d’un endpoint sans état revient à reconstruire l’état de session à chaque appel.
Une conséquence pratique de l’architecture est que vos outils de débogage locaux fonctionnent toujours. Un endpoint WebSocket accepte les mêmes messages du protocole devtools qu’un navigateur local, donc un script qui enregistre le trafic CDP en local l’enregistre aussi contre le navigateur distant, et une trace capturée d’un côté peut être rejouée contre l’autre. Ce qui ne se transfère pas, c’est le navigateur lui-même : une extension installée localement, un jeu de polices local ou un chemin GPU local n’existent que là où ils sont installés, et la session distante a ce que le fournisseur y a mis.
Les trois architectures côte à côte
La distinction qui compte en exploitation est qui exécute le navigateur, qui assume le résultat face au contrôle anti-bot et ce que le code appelant reçoit en retour.
| Service de scraping géré | Navigateur géré | Navigateur auto-hébergé | |
|---|---|---|---|
| Ce que vous recevez | Des données finies | Une session via CDP/WebSocket | Un processus que vous avez lancé |
| Qui exécute le navigateur | Le fournisseur | Le fournisseur | Vous |
| Qui gère le blocage | Le fournisseur | Vous | Vous |
| Identité entre sessions | Non exposée | État, pas empreinte | Ce que le profil déclare |
| Contrôle de la version du navigateur | Choix du fournisseur | Matrice du fournisseur | Épinglée par vous |
| Panne que vous déboguez | Qualité des données | Sélecteurs, timing, en-têtes | Processus, profil, build |
Lisez la troisième ligne avec attention, car c’est celle qui change la décision d’achat. Un navigateur géré déplace la machine, pas le problème : les routes renforcées de la documentation Browserless sont décrites comme modifiant le comportement du navigateur et ne sont donc pas l’option par défaut. Si une cible rejette votre session, la session restait la vôtre à diagnostiquer.
La quatrième ligne est celle où les deux produits gérés diffèrent vraiment l’un de l’autre, et où l’auto-hébergement se sépare des deux. Un service de scraping masque l’identité parce que l’identité est à l’intérieur de son pipeline ; un navigateur géré expose un état, ce qui est plus étroit ; un navigateur auto-hébergé expose le navigateur entier, et c’est le seul des trois où l’empreinte est une propriété que vous fixez délibérément plutôt qu’une propriété héritée.
La ligne de la version mérite un exemple, parce que c’est celle que les équipes découvrent tard. Un fournisseur qui met à jour sa flotte selon son propre calendrier change le moteur de rendu sous un script qui n’a pas changé du tout, et une assertion de mise en page qui passait lundi peut échouer mercredi pour une raison qu’aucun commit n’explique. L’auto-hébergement ne fait pas disparaître ce risque non plus ; il le convertit en une décision que vous planifiez, ce qui est un problème différent et généralement préférable. L’épinglage de version avec Chrome for Testing est le mécanisme qui en fait une décision plutôt qu’un accident.
L’état de session n’est pas l’identité du navigateur
Browserless documente deux façons de conserver des choses entre les connexions, et les deux valent une lecture précise à cause de ce qu’elles énumèrent. La première est une commande CDP appelée au milieu du script, Browserless.reconnect, qui marque le navigateur en cours comme reconnectable pour que le serveur garde le processus ouvert pendant une fenêtre de délai ; la documentation précise qu’elle est réservée à Puppeteer car il faut browser.disconnect(), et que Playwright n’a pas cet appel. La seconde est une API REST de session qui provisionne un répertoire de données utilisateur isolé par session et conserve les données pendant des jours à travers des redémarrages complets du navigateur.
standard session   -> process kept alive; window in seconds to minutes; Puppeteer only
persisting state   -> isolated user-data-dir per session; survives process restarts
L’API de session persiste les cookies, localStorage et le cache, ce qu’énumère la page de présentation des sessions. La fonction de profils authentifiés va plus loin et nomme cookies, localStorage et IndexedDB, et elle exclut sessionStorage au motif documenté que le rejouer injecte un état périmé dans les redirections OAuth et les flux CSRF. Cette exclusion est une décision d’ingénierie correcte pour son objectif, et la frontière qu’elle trace est la partie utile : ce qui est restauré, c’est l’état connecté et les en-têtes que le fournisseur a choisi de conserver, pas le navigateur entier qui l’a produit.
Les en-têtes sont la partie qui garde honnête l’affirmation précédente. Un profil enregistré depuis une session Browserless retient aussi le User-Agent de ce navigateur, et les sessions qui le chargent présentent le même ; les sessions de création de profil et les sessions Brave qui chargent un tel profil envoient un Accept-Language stable, tandis que les autres sessions Brave conservent la variation intégrée de Brave. Un profil n’est donc pas du stockage seul, et l’énoncé juste est qu’il porte une connexion enregistrée plus les deux en-têtes que le fournisseur documente, et non qu’il ne porte aucune identité. Ce qu’il ne porte toujours pas, c’est tout le reste à partir duquel une empreinte se calcule.
Le paramètre d’émulation de système d’exploitation montre la même séparation des couches depuis l’autre côté. emulationOs fixe un ensemble cohérent de signaux dérivés du système : user agent, client hints, navigator.platform, le moteur de rendu WebGL, hardwareConcurrency et la liste des périphériques multimédias. La documentation énumère ensuite ce qu’il ne change pas, et la liste est la partie utile : le fuseau horaire, la langue et Accept-Language suivent le proxy, et pour les personas de bureau la taille d’écran et le viewport restent au client. Le paramètre agit sur les routes renforcées, sur les API REST de déblocage et de scraping, dont /unblock, /smart-scrape et leurs variantes préfixées par le fournisseur, sur les routes BQL et sur la route agent, et il est ignoré sur un endpoint /chromium ou /chrome simple.
emulationOs=windows  -> changes: UA, client hints, navigator.platform, WebGL renderer
                     -> keeps:   timezone, locale, Accept-Language, viewport, WebRTC
emulationOs=android  -> also sets a high-DPI mobile screen and viewport
La valeur Android est l’exception qui rend la règle de bureau précise. emulationOs=android fixe bien la taille d’écran et le ratio de pixels dans le cadre d’un persona mobile cohérent, éventuellement resserré par emulatedDevice ; les personas de bureau laissent les deux à defaultViewport ou setViewport. Lire la liste des changements sans cette exception conduit à une conclusion fausse sur les tests mobiles.
Rien de tout cela n’est un défaut. Un service qui doit exécuter des milliers de sessions par heure ne peut pas donner à chacune un binaire sur mesure, et la frontière documentée dit honnêtement où son contrôle s’arrête. La conséquence pratique est plus étroite et plus utile : si votre exigence est que la même identité apparaisse demain, une connexion enregistrée plus deux en-têtes stables, c’est moins que cela, et les surfaces restantes doivent venir d’ailleurs.
Il y a une seconde conséquence pour qui teste un comportement multi-compte ou multi-région. Un profil qui restaure une connexion est exactement adapté pour reprendre un compte, et exactement inadapté pour prouver que deux comptes sont distinguables, parce que la partie qui les distingue n’est pas le stockage qu’il restaure. Tester cette propriété demande deux environnements qui diffèrent par les surfaces déclarées et sont identiques par ailleurs, ce qui est une comparaison qu’un cookie stocké ne peut pas exprimer.
La comparaison qui n’en est pas une
Deux des phrases d’autocomplétion autour de ce produit sont browserless vs puppeteer et browserless vs playwright, et aucune n’est une comparaison à armes égales. Puppeteer et Playwright sont des bibliothèques qui pilotent un navigateur ; Browserless est un endroit où ce navigateur s’exécute. Demander laquelle gagne revient à demander si une voiture bat une route.
La composition est la réponse, et elle diffère d’une bibliothèque à l’autre d’une manière documentée. Avec Puppeteer, le flux de reconnexion standard fonctionne parce que browser.disconnect() existe. Avec Playwright, il ne fonctionne pas, et c’est pourquoi la documentation oriente les utilisateurs de Playwright vers l’API REST de session. Si votre pile est Playwright, c’est la forme à prévoir ; si c’est Puppeteer, les deux formes sont disponibles.
Cette asymétrie a aussi un coût hors de la frontière du service. Un flux de reconnexion qui dépend de la déconnexion d’un navigateur vivant suppose que le client sait distinguer une déconnexion propre d’un socket coupé, et un script Playwright qui réessaie après une erreur de socket ne fait pas la même chose qu’un script Puppeteer qui se déconnecte volontairement. Avant de choisir un mécanisme de persistance, il vaut la peine de noter à quel événement le script réagit réellement : une déconnexion explicite, un délai expiré ou une erreur de transport. Seul le premier est une décision de cycle de vie ; les deux autres sont des pannes, et traiter l’une comme l’autre produit une session qui survit plus longtemps que le test ne le voulait.
La comparaison avec l’auto-hébergement est réelle, et c’est aussi celle où l’échange est le plus clair. S’auto-héberger signifie assumer le pool, les redémarrages, les montées de version et la planification de capacité. Lancer un navigateur avec un répertoire de données utilisateur explicite, et garder ce répertoire stable d’un lancement à l’autre, est ce qui rend une identité reproductible ; pièges de lancement et de profil avec Puppeteer couvre les quatre décisions de lancement qui gardent un profil faisant autorité. Sur un serveur, ce travail ne disparaît pas, il se déplace : configuration d’un serveur headless est la liste de contrôle pour l’affichage, le binaire et la boucle de reprise qu’un endpoint géré absorbe à votre place.
Ce que la facture couvre réellement
Les deux côtés se calculent sans citer le prix de personne, parce que les formes sont différentes. Un navigateur géré facture la concurrence et le temps de session ; un navigateur auto-hébergé facture des machines et les heures d’ingénierie qui les maintiennent en marche.
managed monthly   ~= peak_concurrency x hours_used x unit_price
self-hosted cost  ~= machines x amortised_hours + ops_hours_per_month x loaded_rate
Le point de bascule est donc une question d’utilisation, et la formule ci-dessus nomme les trois valeurs à mesurer : peak_concurrency, hours_used et unit_price. Si la concurrence de pointe est élevée mais la moyenne basse, un forfait à l’unité suit la moyenne et gagne, parce que vous ne payez pas pour des machines inactives. Si la charge est régulière et la concurrence modérée, une machine capable de rester inactive est facturée une fois et le second terme domine, ce qui est le cas où l’auto-hébergement gagne. Les plafonds publiés des offres décrivent directement le premier terme, d’un niveau gratuit avec deux navigateurs simultanés et une session plafonnée à deux minutes jusqu’à cent navigateurs simultanés avec un plafond de soixante minutes, ce qui suffit pour calculer le côté géré de votre propre charge sans demander de devis à personne.
Deux autres termes entrent dans la même arithmétique. Les redémarrages ne sont gratuits d’aucun côté : un endpoint géré les masque, ce qui les fait apparaître comme une queue de latence plutôt que comme une ligne de facture, et un pool auto-hébergé les montre comme de la capacité à réserver. Le stockage est l’autre, parce qu’un profil persisté consomme une allocation qu’une requête sans état ne consomme pas, et une charge qui stocke un grand état authentifié par identité paie pour cet état même le jour où elle n’ouvre pas de navigateur.
Deux coûts sont faciles à laisser hors de cette arithmétique. Le premier est le travail d’identité : si la charge a besoin d’un navigateur stable entre les sessions, cette exigence n’est encore dans aucune des deux colonnes, et la satisfaire dans une session gérée revient de toute façon à porter le profil vous-même. Le second est le plafond de session : une tâche qui dure légitimement plus longtemps que le temps de session maximal du forfait devient une autre tâche, découpée en morceaux reprenables, et cette refonte est du travail quel que soit l’hébergeur du navigateur.
Aucune des deux formes n’est un choix par défaut. Un export nocturne unique qui n’a pas besoin de connexion est moins cher et plus simple sur un endpoint géré ; une flotte d’identités de longue durée qui doivent se ressembler en mars et en avril est moins chère et plus simple sur des machines que vous contrôlez.
Conclusion pratique
Choisissez par la couche, pas par le logo. Si la tâche est une requête indépendante, une API de scraping sans état est le chemin le plus court. Si la tâche a besoin d’une vraie session mais pas d’une identité persistante, un navigateur géré supprime la surface opérationnelle et ses limites de session publiées sont les contraintes autour desquelles concevoir. Si la tâche a besoin que le même navigateur soit reconnaissablement le même la semaine suivante, cette exigence se situe sous la couche d’état, et elle doit être assumée quelque part où vous pouvez fixer le binaire, les polices et les options de lancement.
Deux vérifications rendent la décision concrète. Premièrement, notez si l’exigence porte sur l’état ou sur l’identité ; la documentation Browserless est explicite sur le fait que ses profils restaurent cookies, localStorage, IndexedDB, User-Agent et Accept-Language, et explicite sur le fait que emulationOs laisse le fuseau horaire, la langue et le viewport des personas de bureau intacts. Deuxièmement, calculez la concurrence de pointe face à la moyenne, parce que ce rapport, et non le volume mensuel, décide quelle facture croît le plus vite.
Quand une session échoue sur un endpoint géré, le diagnostic appartient toujours au client : quels sélecteurs, quels en-têtes, quel moment de navigation, quel build. Pour savoir quel build est installé et comment l’épingler, lisez l’épinglage de version avec Chrome for Testing ; pour savoir ce qu’une page peut observer sur la session elle-même, lisez la comparaison de signaux entre headless et headed.
Sources
Cet article fait partie du guide : Déploiement et livraison du navigateur : carte opérationnelle
Articles Connexes
Web Unblocker et API de scraping: usages et limites
DéploiementAutomatiser le navigateur avec Stagehand
DéploiementSignaux d'automatisation et cohérence avec Playwright
DéploiementScraping Shopify : Storefront API, Ajax ou navigateur ?
DéploiementPuppeteer MCP : configurer un build Chromium propre
DéploiementPlanifier la capacité des BrowserContext
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.