Protection des empreintes du navigateur pour la collecte web
La collecte de données web demande plus que des proxys et des en-têtes. La protection des empreintes garde cohérents canvas, WebGL, polices et signaux du profil.
Vous voulez la documentation structurée pour Déploiement ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
Pourquoi un proxy et des en-têtes ne décrivent pas tout le navigateur
Les équipes qui collectent des données web publiques avec autorisation commencent souvent par la même liste : un proxy pour la route réseau, un en-tête User-Agent raisonnable et un navigateur capable d'exécuter JavaScript. Cette liste résout de vrais problèmes, mais elle ne décrit pas le navigateur que la page voit réellement. La page reçoit tout l'environnement d'exécution : la manière dont le texte est dessiné sur un canvas, les capacités graphiques annoncées, les polices installées, la durée des opérations courantes, les langues et le fuseau horaire déclarés par le navigateur, et l'accord de ces valeurs avec la route réseau.
Quand ces valeurs divergent, le résultat est rarement spectaculaire. Une page peut s'afficher dans une autre langue que prévu, demander une confirmation supplémentaire, renvoyer une variante régionale qu'un analyste ne parvient pas à reproduire, ou se comporter différemment entre deux exécutions qui semblaient identiques dans le journal de la tâche. La cause est souvent un environnement incohérent plutôt qu'un seul en-tête erroné. Un proxy dans un pays associé à un navigateur qui annonce le fuseau horaire d'un autre est l'exemple le plus courant, mais le rendu graphique, les polices et les valeurs d'écran peuvent diverger de la même façon.
La protection des empreintes du navigateur agit sur cette couche. Dans la documentation de BotBrowser, un profil décrit un environnement précis de navigateur et d'appareil, et le navigateur annonce cet environnement de façon cohérente dans les pages, les workers et les nouveaux contextes. L'objectif est la confidentialité et la répétabilité pour un travail autorisé. Ce n'est pas une promesse d'accès à un site particulier, et les sections suivantes indiquent clairement où la responsabilité revient à l'équipe qui exploite le flux de travail.
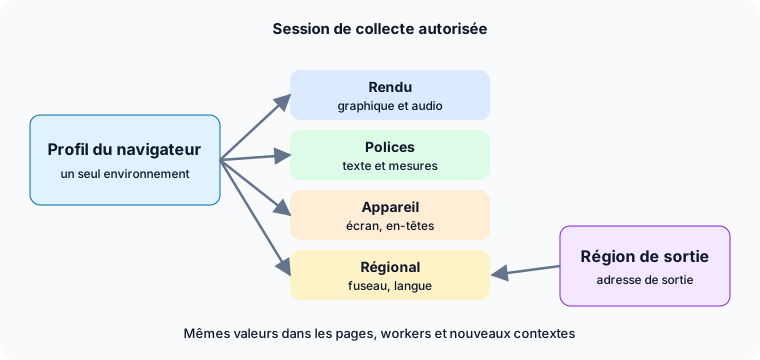
En bref :
- Le rendu, les polices et les durées doivent correspondre au profil de navigateur choisi.
- La région du proxy, le fuseau horaire, les paramètres régionaux et la langue doivent s'accorder entre eux dans la même session.
- Les modifications partielles de quelques propriétés JavaScript laissent des lacunes qu'un profil complet évite.
- Le rythme des requêtes, les défis, la politique des comptes et les conditions du site restent sous la responsabilité de l'équipe qui exploite le flux de travail.
Les familles de signaux qu'un navigateur de collecte annonce
Il est utile de nommer les familles de valeurs qu'une page peut lire, car une revue de cohérence doit toutes les couvrir. Il n'est pas nécessaire de les retenir comme une liste de propriétés. L'essentiel est que chaque famille décrive le même appareil.
- Rendu canvas. Les pages peuvent dessiner du texte et des formes puis relire la manière dont le navigateur les a rendus. L'API Canvas est standard, et les résultats varient selon le système d'exploitation, la pile graphique et les polices.
- WebGL et graphismes. L'API WebGL expose des capacités graphiques et des informations sur le moteur de rendu. Une description graphique qui ne correspond pas au système d'exploitation annoncé est une source fréquente d'incohérence.
- Traitement audio. L'API Web Audio produit une sortie qui diffère légèrement selon les plateformes et les versions.
- Valeurs de navigator et d'écran. La plateforme, les préférences de langue, les caractéristiques de l'appareil et les dimensions d'écran décrivent l'appareil annoncé.
- Polices. Les polices installées et la manière de mesurer le texte dépendent fortement du système d'exploitation. Un serveur Linux qui annonce un appareil Windows mais rend le texte avec un autre jeu de polices est incohérent en interne.
- Client Hints et en-têtes. La marque du navigateur, la plateforme et l'architecture envoyées avec les requêtes doivent correspondre à ce que les scripts voient dans la page.
- Durées et capacité. Les mesures de performance, le nombre de processeurs annoncé et la classe de mémoire décrivent la puissance apparente de l'appareil.
- Réglages régionaux. Le fuseau horaire, les paramètres régionaux et les langues indiquent où le navigateur prétend se trouver et quelle langue préfère la personne qui l'utilise.
L'exigence pour un flux de collecte est simple à énoncer : toutes les familles doivent décrire le même appareil au même endroit. La difficulté tient à ce que la plupart de ces valeurs sont produites au coeur du navigateur, si bien qu'un flux qui ne modifie que les plus faciles obtient une image mélangée.
Pourquoi les modifications partielles en JavaScript laissent des lacunes
De nombreuses configurations de collecte commencent par des scripts qui remplacent quelques propriétés du navigateur au chargement de la page. C'est compréhensible : c'est rapide à essayer et cela fonctionne pour la propriété modifiée. C'est aussi là que l'incohérence s'installe.
Un script qui s'exécute dans la page modifie les valeurs alors que la page existe déjà. Dans certains contextes, le code de la page et les cadres intégrés peuvent s'exécuter avant l'application de la modification. Les workers dédiés, les workers partagés et les service workers ont leur propre portée globale : une valeur modifiée dans la page principale peut donc différer dans un worker. Un nouvel iframe ou un nouveau contexte de navigateur repart des valeurs d'origine, sauf si la même modification y est répétée. Chacun de ces cas est une lacune que l'équipe doit suivre.
Le deuxième problème est la couverture. Changer la chaîne User-Agent ne change ni la manière dont le navigateur rend un canvas, ni les polices annoncées, ni le comportement de la sortie audio, ni la description graphique. Une seule propriété remplacée entre souvent en conflit avec d'autres laissées intactes. Par exemple, une chaîne de plateforme qui nomme un système d'exploitation à côté d'une liste de polices appartenant à un autre fait que les deux familles décrivent des appareils différents.
Le troisième problème est la maintenance. Les versions du navigateur modifient des éléments internes, et chaque correctif qui en dépend doit être revérifié. Les exécutions headless ajoutent une couche : les différences entre le mode headless et le mode avec fenêtre, comme la taille de la fenêtre, la liste des plugins ou des détails de rendu, sont souvent traitées une par une. L'équipe finit par entretenir une liste croissante d'exceptions au lieu d'une seule description de l'environnement.
Une approche fondée sur les profils inverse le modèle. Au lieu de corriger des valeurs isolées, le navigateur est lancé avec un profil qui définit l'environnement complet, et il annonce cet environnement dès le départ dans les pages, les workers et les nouveaux contextes. La documentation de BotBrowser le décrit surface par surface, y compris la cohérence entre workers pour les valeurs de navigator et l'audio. C'est l'affirmation limitée sur laquelle s'appuie ce texte : la cohérence de l'environnement annoncé, et non une garantie sur la réaction d'un site.
Région du proxy, fuseau horaire, paramètres régionaux et langue dans une même session
Parmi toutes les familles de signaux, les réglages régionaux sont les plus faciles à vérifier et les plus faciles à mal régler ; ils méritent donc une attention particulière.
Un proxy détermine la route réseau et l'adresse publique que les sites voient. Il ne décide pas du fuseau horaire annoncé par le navigateur, des paramètres régionaux qui formatent les nombres et les dates, ni des langues listées dans les préférences du navigateur. Ces valeurs viennent du navigateur. Si elles restent aux valeurs par défaut de la machine hôte, un serveur de collecte situé dans une région annoncera le fuseau horaire de cette région alors que le proxy pointe ailleurs.
Par défaut, BotBrowser déduit le fuseau horaire, les paramètres régionaux et la langue à partir de l'IP du proxy, ce que sa documentation appelle le mode auto. Les trois valeurs restent alignées avec la région du proxy et entre elles : une session qui sort en Allemagne annonce un fuseau horaire allemand, des paramètres régionaux et une liste de langues correspondants, sans autre option. Des remplacements manuels existent pour chaque valeur, en option d'un niveau de licence. Une valeur manuelle prend le dessus pour le réglage qu'elle définit, tandis que les réglages laissés en auto continuent de suivre le proxy.
Trois détails pratiques de la documentation méritent d'être retenus :
- Laissez le navigateur gérer le proxy. La détection automatique fonctionne quand le proxy est défini par l'option de proxy du navigateur lui-même au lancement. Utiliser à la place l'option de proxy du framework peut laisser le fuseau horaire à la valeur de la machine hôte.
- Les données de localisation du proxy décident du résultat. Le mode auto suit la localisation à laquelle correspond l'IP du proxy. Si les données de localisation du fournisseur sont erronées, ou si l'adresse de sortie correspond à une autre région que prévu, les valeurs déduites suivent cette correspondance. C'est une raison de vérifier, pas de deviner.
- Indiquez l'adresse de sortie au navigateur quand vous la connaissez. La documentation décrit l'option
--proxy-ip(ENT Tier1) pour déclarer l'IP publique de sortie du proxy, ce qui évite les recherches d'IP à chaque page et rend le résultat prévisible quand cette adresse est déjà connue.
Un lancement minimal qui s'appuie sur le mode auto n'a besoin que d'un profil et d'un proxy :
chromium-browser \
  --bot-profile="path/to/profile.enc" \
  --proxy-server=socks5://user:pass@de-proxy.example.com:1080
Pour l'ensemble des options et leurs niveaux de licence, lisez la documentation de BotBrowser sur le fuseau horaire, les paramètres régionaux et la langue. Pour comprendre comment la sortie du proxy est résolue, consultez notre guide de configuration du proxy.
Le DNS et WebRTC demandent la même vérification explicite. Décidez volontairement où les noms sont résolus (l'option --bot-local-dns, ENT Tier1, résout en local, et --bot-local-dns=false laisse le proxy résoudre les noms) et vérifiez que WebRTC n'expose pas d'adresse en dehors de la route du proxy ; BotBrowser fournit une protection WebRTC par défaut, et un proxy est recommandé pour une protection complète. Le guide sur la cohérence du proxy, du DNS et de WebRTC détaille cette revue.
Comment vérifier l'alignement avant de collecter des données
Ne supposez pas l'alignement : confirmez-le une fois pour chaque combinaison de route de proxy et de profil avant de lancer une tâche à grande échelle. Les vérifications ci-dessous n'utilisent que ce qu'une personne voit dans une fenêtre de navigateur ordinaire, et chacune a un résultat attendu.
- Confirmez la région du proxy. Utilisez les outils du fournisseur du proxy ou une recherche d'adresse fiable pour noter la région à laquelle correspond l'adresse de sortie. C'est la référence à laquelle toutes les autres valeurs sont comparées.
- Lisez le fuseau horaire annoncé par la page. Ouvrez la console de développement du navigateur dans la session et évaluez
Intl.DateTimeFormat().resolvedOptions().timeZone, que décrit la référence MDN sur resolvedOptions. Le résultat doit être un fuseau horaire appartenant à la région du proxy. - Lisez la liste des langues. La référence Navigator.languages décrit la liste ordonnée des langues préférées. Évaluez
navigator.languageset vérifiez que la première entrée correspond à la région prévue et que l'ordre ressemble à une liste de préférences normale. - Comparez les formats. Ouvrez une page qui affiche une date, un nombre avec séparateur décimal et un montant. Les formats doivent correspondre aux paramètres régionaux attendus.
- Recommencez dans un nouveau contexte. Ouvrez un second contexte et une page qui s'appuie sur un worker, puis répétez les quatre premières vérifications. Les valeurs doivent être identiques à celles du premier contexte, ce qui confirme que le réglage ne s'est pas appliqué à une seule page.
- Consignez le résultat. Conservez l'étiquette de la route du proxy, le nom du profil, le fuseau horaire et la première langue. Une trace brève facilite l'explication des écarts ultérieurs.
Quand une vérification échoue, modifiez une seule chose à la fois. Vérifiez que le proxy est configuré au niveau du navigateur, contrôlez la localisation associée à l'IP du proxy et comparez le profil utilisé à l'appareil prévu. Repartir d'un nouveau contexte est généralement plus clair que de modifier un contexte qui contient déjà des cookies et du stockage issus de la configuration erronée.
Passer en revue le rendu, les polices et les valeurs de l'appareil
La même habitude s'applique en dehors des réglages régionaux, même s'il n'y a pas de bonne réponse propre à une région. La question est de savoir si les familles s'accordent entre elles et avec le profil.
Un court tableau de revue garde la discussion concrète :
| Domaine | Ce qu'il faut confirmer |
|---|---|
| Rendu | Le comportement de canvas et de WebGL correspond au système d'exploitation et à la classe graphique décrits par le profil |
| Polices | Les polices disponibles et la mesure du texte correspondent au système d'exploitation annoncé |
| Appareil et écran | La plateforme, la taille d'écran et les capacités annoncées décrivent un seul appareil |
| En-têtes et scripts | Les Client Hints envoyés avec les requêtes concordent avec les valeurs lues par les scripts dans la page |
| Durées | Le processeur et la classe de mémoire annoncés correspondent au profil et à la capacité réelle de l'hôte |
| Réglages régionaux | La région du proxy, le fuseau horaire, les paramètres régionaux et la langue concordent dans chaque contexte |
| Limites de session | Les cookies et le stockage appartiennent à un profil et à une route |
Faites cette revue avec un profil par famille de système d'exploitation que vous comptez utiliser, puis réutilisez le résultat comme référence. Si une exécution ultérieure produit une page différente de la référence, vous pourrez comparer des configurations au lieu de deviner.
Deux précautions s'appliquent. D'abord, un profil cohérent ne masque pas la capacité réelle de l'hôte : un profil qui décrit un portable modeste mais s'exécute sur un très gros serveur produira quand même des durées qui reflètent l'hôte ; gardez donc des attentes mesurées et un profil réaliste. Ensuite, les exécutions headless et celles avec fenêtre doivent être examinées séparément, car un résultat valable dans un mode ne prouve pas l'autre.
Sessions, profils et variation dans les tâches de collecte
Une tâche de collecte est rarement une seule page. C'est une série de sessions, et chaque session doit avoir une identité claire. La documentation de BotBrowser décrit les profils comme des environnements complets, et les niveaux de licence ajoutent des contrôles tels que des graines de bruit déterministes et des empreintes distinctes pour des contextes de navigateur distincts.
Deux idées gardent l'ensemble gérable.
Une session, un environnement. Gardez ensemble les cookies, le stockage, le profil et la route du proxy pendant toute la durée d'une session. Si la route change, traitez la session comme une nouvelle session plutôt que de changer la route sous des cookies existants. Un historique mélangé est difficile à interpréter ensuite et provoque souvent des comportements de page déroutants.
La variation a un but. Des profils différents sont utiles quand un flux doit représenter des classes d'appareils ou des régions différentes qu'il est autorisé à représenter. La variation pour elle-même ne fait qu'augmenter le nombre d'environnements à vérifier. Quand une équipe utilise une graine pour répéter un résultat, la documentation décrit que la même graine produit la même sortie, ce qui aide à reproduire un problème et à comparer des exécutions. Traitez la graine comme une partie de la configuration consignée afin qu'une exécution ultérieure puisse reprendre la même valeur.
Chaque profil ou route ajouté augmente le coût de vérification. Commencez par le plus petit ensemble qui couvre le travail autorisé, vérifiez-le et ne l'étendez que lorsqu'un besoin documenté apparaît.
Rythme des requêtes, nouvelles tentatives et politique des comptes
La cohérence du navigateur n'est qu'un des éléments qui déterminent la réponse d'un site. Les autres relèvent de l'équipe, et aucun réglage du navigateur ne les modifie.
- Rythme des requêtes. Espacer les requêtes dans le respect des limites publiées par le site fait partie d'une collecte autorisée. Ajoutez des pauses entre les chargements de page, évitez les rafales et ralentissez quand un site renvoie une erreur ou une réponse de limite de débit.
- Nouvelles tentatives. Une boucle qui répète la même requête sans pause aggrave la situation. Utilisez des attentes croissantes et un plafond du nombre de tentatives, et arrêtez-vous quand le site continue de refuser.
- Défis interactifs. BotBrowser ne résout pas les défis interactifs. Si un flux en rencontre régulièrement, la bonne réponse est de vérifier si la collecte est autorisée, s'il existe un flux de données officiel ou une API, et si le titulaire du site peut accorder un accès.
- Politique des comptes. La collecte avec session ouverte relève des conditions du compte. Un profil de navigateur ne change pas ce que permet un contrat de compte.
- Qualité du proxy. Le fournisseur du proxy contrôle la qualité de l'adresse de sortie, les données de localisation et la disponibilité. Un navigateur bien aligné derrière un proxy mal localisé annoncera quand même la région à laquelle correspond le proxy.
Ce ne sont pas des cas marginaux. Ils expliquent surtout pourquoi deux équipes avec la même configuration de navigateur peuvent obtenir des résultats très différents.
Dimensionner la capacité sans deviner
Les équipes demandent souvent combien de sessions une machine peut exécuter. La réponse honnête est que cela dépend du matériel et des pages collectées. Une page de texte seul et une page avec des scripts lourds, de la vidéo ou de grandes images consomment des quantités très différentes de mémoire et de temps processeur. Tout chiffre cité sans description du matériel et du type de page doit être traité, au mieux, comme une estimation approximative de planification.
Une meilleure méthode consiste à mesurer sa propre charge. Lancez un petit nombre de sessions sur des pages représentatives, surveillez l'usage de la mémoire et du processeur, et augmentez progressivement en vérifiant que les chargements de page se terminent dans un délai raisonnable. La documentation de performance de BotBrowser décrit plusieurs facteurs qui influent sur le débit, notamment les recherches au démarrage, le chargement du profil, le choix du moteur graphique et l'utilisation de plusieurs contextes de navigateur dans une même instance plutôt que le lancement de nombreuses instances séparées. Servez-vous-en comme point de départ et conservez vos propres mesures à côté de votre configuration.
En conteneur, appliquez la même méthode : dimensionnez le conteneur à partir de mesures plutôt que d'un chiffre publié, et gardez les fichiers de profil sur un stockage local rapide. Notre guide de déploiement Docker détaille la configuration des conteneurs.
Questions fréquentes des équipes
La protection des empreintes garantit-elle l'accès à un site ?
Non. Elle garde l'environnement du navigateur cohérent. L'acceptation de la session par un site dépend de ses propres politiques, de votre rythme de requêtes, de la qualité du proxy et des conditions qui s'appliquent aux données. Il faut prévoir des refus et disposer d'un canal officiel pour demander l'accès lorsqu'il existe.
Pourquoi ne pas simplement définir un User-Agent et quelques propriétés ?
Parce que ces valeurs ne représentent qu'une partie de ce qu'une page peut lire. Un User-Agent modifié à côté d'un rendu, de polices et de réglages régionaux inchangés laisse plusieurs familles raconter des choses différentes. Un profil complet les décrit ensemble, et le navigateur annonce le même environnement dans les pages, les workers et les nouveaux contextes.
Dois-je définir à la main le fuseau horaire, les paramètres régionaux et la langue ?
En général non. Avec un proxy configuré au niveau du navigateur, le mode auto déduit les trois valeurs de l'IP du proxy. Les valeurs manuelles servent quand on sait que les données de localisation du proxy sont erronées ou qu'un flux a besoin d'une région précise, et elles relèvent d'une option de niveau de licence. Vérifiez dans tous les cas le résultat avec les étapes ci-dessus.
Puis-je utiliser mon code Playwright ou Puppeteer existant ?
En général oui. La documentation décrit le lancement de l'exécutable BotBrowser avec un profil et un proxy depuis l'un ou l'autre framework. Pensez à définir le proxy par les arguments de lancement du navigateur plutôt que par l'option de proxy du framework, afin que l'alignement régional fonctionne comme documenté.
Faut-il un profil différent pour chaque session ?
Pas nécessairement. Utilisez aussi peu de profils que le travail autorisé le demande, vérifiez chacun d'eux et gardez ensemble le profil, la route et le stockage pendant toute la vie d'une session. Un nouveau profil se justifie quand le flux doit représenter une autre classe d'appareil ou une autre région.
Est-il légal de collecter des données avec une protection des empreintes ?
La légalité dépend de la juridiction, du type de données, des conditions d'utilisation du site et de textes comme le RGPD ou le CCPA. BotBrowser est un outil de confidentialité, et les utilisateurs doivent s'assurer que leur collecte est autorisée et respecte les règles applicables.
Où BotBrowser s'insère
Pour vos sessions de collecte autorisées, BotBrowser peut déduire par défaut le fuseau horaire, les paramètres régionaux et la langue à partir de l'IP du proxy (mode auto) ; ils restent ainsi alignés avec la région du proxy et entre eux, et la session présente une identité géographique cohérente. Vous évitez ainsi l'écart fréquent entre un proxy situé dans un pays et un navigateur configuré pour un autre. BotBrowser ne peut pas garantir qu'un site acceptera la session ni résoudre les défis interactifs, et il ne contrôle ni la qualité ni les données de géolocalisation du proxy, ni le rythme des requêtes, ni la politique des comptes, ni les conditions du site.
Servez-vous des vérifications ci-dessus comme routine préalable, gardez la configuration consignée à côté de chaque tâche et réservez les changements plus lourds aux cas où une vérification échoue. Pour commencer avec un profil, téléchargez BotBrowser ou contactez l'équipe entreprise pour une aide à la planification de déploiements plus importants.
Pour aller plus loin, consultez Profils de navigateur multiplateformes pour planifier des profils entre systèmes d'exploitation.
Sources
Articles Connexes
Faites passer BotBrowser de la recherche à la production
Utilisez ces guides pour comprendre le modèle, puis passez à la validation multi-plateforme, aux contextes isolés et au déploiement navigateur prêt pour l'échelle.