Navigateur pour le web scraping : six critères
Choisir un navigateur pour une collecte autorisée : exactitude, état, coût, concurrence, observabilité et maintenance mesurés sur la charge réelle.
BotBrowser Team
Vous voulez la documentation structurée pour Démarrage ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
Le « meilleur navigateur pour le web scraping » dépend des pages, des enregistrements et des limites que l’équipe est autorisée à traiter. BotBrowser documente une configuration par profil et des réglages de performance ; ce sont des paramètres à évaluer ; BotBrowser ne garantit pas une victoire dans une grille ni un accès. Un classement ne dit pas si les champs nécessaires sont rendus, si l’état déclaré persiste ou si le budget est respecté. Le choix commence par un jeu d’essai fixe et six mesures répétables pour chaque candidat. Avant cela, le diagnostic de rendu décide si la charge a besoin d’un navigateur.
TL;DR
- Définir la charge autorisée et les conditions d’acceptation d’un enregistrement avant toute comparaison.
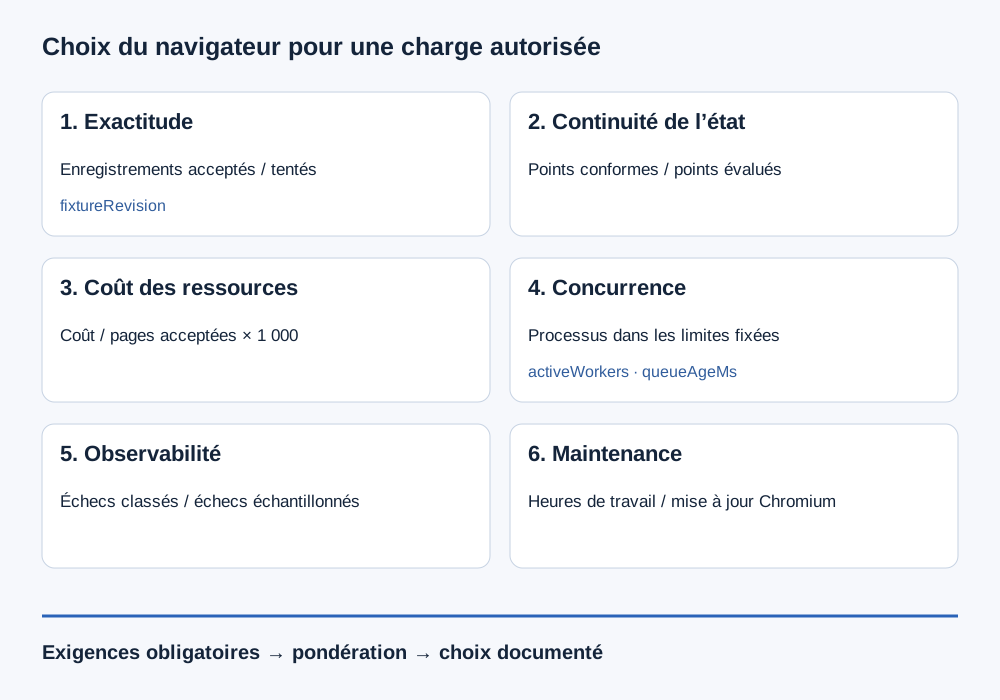
- Mesurer exactitude du rendu, continuité de l’état déclaré, coût pour 1 000 pages acceptées, concurrence soutenable, observabilité et maintenance.
- Écarter tout candidat qui échoue à une exigence obligatoire d’exactitude ou de politique ; une moyenne ne doit pas masquer cet échec.
- Fixer les poids selon les priorités opérationnelles. Les exemples sont illustratifs, sans classement universel.
- Le résultat décrit la configuration et le jeu d’essai évalués, sans promettre le résultat d’un autre site.
Sommaire
- Pourquoi un classement ne suffit pas
- Définir la charge avant la notation
- Mesurer les six critères
- Choisir les poids selon la charge
- Remplir la grille vierge
- Ce que le score ne démontre pas
- Capacité et limite de BotBrowser
- Conclusion pratique
Pourquoi un classement ne suffit pas
Les comparaisons regroupent souvent moteur, bibliothèque d’automatisation, exécutable, lancement, stockage et hébergement sous une seule étiquette. Le résultat d’une combinaison ne se transfère pas automatiquement à une autre. La documentation des navigateurs Playwright distingue installations et canaux pris en charge ; le guide de configuration Puppeteer documente des paramètres de lancement. Ces sources servent à définir les candidats, sans désigner un meilleur navigateur universel pour la collecte.
Il faut aussi définir « fonctionner ». Une page peut s’afficher sans un champ obligatoire ; une navigation peut réussir mais produire un enregistrement invalide ; une exécution peut terminer hors budget. Réduire ces résultats à un seul succès ou échec empêche d’expliquer le compromis et la prochaine action.
La grille fixe la frontière de décision. Définir d’abord le minimum acceptable et ses preuves, puis comparer les configurations sur la même charge contrôlée. Un candidat qui manque une exigence obligatoire n’est pas sauvé par son coût ou sa facilité de mise à jour. Seuls ceux qui satisfont les exigences peuvent être comparés selon les coûts opérationnels pertinents.
La méthodologie de comparaison pour les équipes produit traite la conception d’une comparaison entre produits. Pour une charge de collecte, le dossier de sélection exige des pages déclarées, des règles d’acceptation et des limites de ressources, plutôt qu’un verdict global sur une marque.
Définir la charge avant la notation
Rédiger un contrat d’une page avant de mesurer. Consigner environnement possédé ou autorisé, pages incluses, champs requis, parcours prévu et conditions d’arrêt. Donner à la révision du jeu d’essai son champ fixtureRevision pour reconnaître les mêmes pages après une mise à jour. Préciser s’il s’agit d’un environnement local, de préproduction ou d’une intégration de production autorisée. Configurer un navigateur ne donne aucun droit de collecte ni raison d’ignorer les règles du site.
Définir une page acceptée par des observations : URL canonique, titre non vide, montant assorti d’une devise et horodatage, par exemple. Distinguer les champs facultatifs de ceux dont l’absence invalide le résultat. Séparer état de navigation et acceptation des données : une réponse HTTP ou un chargement achevé ne prouvent pas la présence de l’enregistrement métier attendu.
Fixer navigateur et version, paquet d’automatisation et version, exécutable ou canal, système, viewport, langue, fuseau, stockage, route réseau et révision du jeu d’essai. Playwright et Puppeteer proposent des paramètres modifiant le lancement ; la documentation Chrome headless décrit ce mode et sa relation avec Chrome. Il ne s’agit pas d’égaliser tous les mécanismes internes, mais de noter les différences susceptibles d’expliquer les résultats.
Garder un échantillon borné et répétable : mêmes pages, répétitions, règles et fenêtre temporelle. Séparer démarrage à froid et session déjà chaude. Si un candidat demande un autre lancement pris en charge, le noter au lieu de le normaliser silencieusement. La comparaison de protection moteur et API explique pourquoi changer de couche change la comparaison ; la grille reste centrée sur l’adéquation à la charge.
Mesurer les six critères
Les six mesures utilisent un jeu d’essai fixe et des limites déclarées. Chacune produit une preuve avec unité ou dénominateur explicite. La note résume cette preuve sans la remplacer.
1. Exactitude du rendu sur le jeu d’essai
Choisir les champs minimaux d’un enregistrement utile. Comparer chaque page à une attente connue du jeu d’essai ou à une référence maintenue séparément. Exprimer la couverture par champs obligatoires valides / champs obligatoires attendus, puis l’acceptation par enregistrements acceptés / enregistrements tentés. Définir la validité en plus de la présence : un champ visible peut être mal formé.
Un catalogue local peut exiger identifiant, titre et prix dans une devise reconnue. Le sélecteur et la validation appartiennent à ce catalogue, pas au fournisseur du navigateur. Prévoir « sans objet » pour les champs inutiles. Rendre les reprises visibles : un résultat accepté après une nouvelle tentative ne doit pas être confondu avec une réussite immédiate.
Fixer un minimum obligatoire pour les champs imposés par l’exploitation ou les règles applicables. Un candidat qui ne l’atteint pas sur le même jeu d’essai échoue au critère. Une moyenne de pages correctes et incorrectes ne doit pas dissimuler cet échec. Une note de 1 à 5 peut décrire ce qui dépasse le minimum, en conservant numérateur, dénominateur, motifs d’invalidité et révision du jeu d’essai.
2. Continuité de l’état déclaré
La continuité demande si les entrées destinées à persister restent disponibles pendant le cycle déclaré : préférence d’application, consentement dans un jeu d’essai possédé, compte de test ou contexte volontairement vide. « Identité » ne remplace pas ces artefacts distincts. Configuration de profil, contexte d’automatisation et stockage applicatif ne sont pas interchangeables.
Définir les points de contrôle avant l’exécution. À chacun, noter état attendu présent, absent ou volontairement réinitialisé. Une mesure est points conformes à l’état déclaré / points évalués, avec nombre de points et politique de remise à zéro. Inclure démarrage propre et redémarrage si la charge prévoit les deux. Quand l’isolation est requise, une valeur apparue dans un autre contexte est un échec même si la page s’affiche.
Cela ne prouve ni même personne entre deux exécutions, ni anonymat, ni acceptation par un site. La mesure vérifie seulement le cycle de vie déclaré de l’état dans la configuration choisie. Expiration, déconnexion et nettoyage explicite sont des événements de ce cycle, pas automatiquement des défauts du navigateur. Si l’état n’importe pas, attribuer un poids nul plutôt qu’une note inventée.
3. Coût pour 1 000 pages acceptées
Choisir un périmètre couvrant les dépenses réelles : temps des processus et travailleurs, mémoire facturée le cas échéant, hébergement, stockage et journaux nécessaires. Ne pas comparer le navigateur seul d’un candidat au service complet d’un autre. Consigner devise, intervalle et exclusions.
Le dénominateur doit compter les pages acceptées, pas les navigations lancées :
cost per 1,000 accepted pages
= measured workload cost / accepted pages * 1,000
Pour 12 unités dépensées et 800 pages acceptées, 12 / 800 * 1,000 = 15 unités pour 1 000 pages acceptées. C’est un calcul sur des entrées illustratives, pas un résultat mesuré de navigateur. Échecs et reprises restent au numérateur puisqu’ils consomment des ressources, mais pas au dénominateur des pages acceptées.
Indiquer taille et dispersion de l’échantillon, pas seulement sa moyenne. Quelques pages lentes peuvent dominer le lot. Avec zéro page acceptée, le ratio est indéfini, pas gratuit : publier séparément coût et échecs. Comparer les coûts après les exigences d’exactitude et d’autorisation ; un résultat inutilisable à bas prix ne doit pas sembler préférable.
4. Plafond de concurrence soutenable
La concurrence ne correspond pas au nombre maximal d’onglets ouverts. C’est le niveau testé le plus élevé qui respecte ressources et limites de service en préservant l’acceptation des données. Utiliser uniquement une cible possédée ou autorisée pour cet exercice. Ne pas augmenter la pression sur un site tiers pour découvrir ses limites.
À chaque niveau prévu, relever travailleurs actifs, pages en file, mémoire, CPU si disponible, délais dépassés, reprises et enregistrements acceptés. Les champs proposés activeWorkers et queueAgeMs distinguent un nombre de travailleurs du temps d’attente, en millisecondes, de la plus ancienne page en file. Fixer à l’avance un arrêt lié à la mémoire, à la file ou à une baisse durable d’acceptation. Le plafond ne vaut que dans la fenêtre et les contraintes déclarées, pas pour tout le produit.
Séparer capacité du navigateur et politique de fréquence du site. Une capacité disponible ne relève pas une limite autorisée inférieure ; appliquer la plus restrictive. Les exigences de navigateur pour la collecte SERP traitent cette charge particulière. La concurrence reste un critère de choix, pas une permission de collecter davantage. Face à HTTP 429, le relevé de décision sur les limites de scraping distingue fréquence d’envoi et travail en cours, puis associe Retry-After à un budget fini.
5. Observabilité des échecs
La configuration doit permettre de localiser l’étape en échec : lancement, navigation, disponibilité, extraction, validation, persistance ou arrêt opérateur. Ajouter identifiant d’exécution, révision du jeu d’essai, versions, identifiant de page sans données personnelles superflues, heures de début et fin, reprises et catégorie d’erreur bornée.
Vérifier si les traces permettent de répondre à trois questions : quelle étape a échoué, quelle entrée déclarée a changé, et la page a-t-elle été acceptée ? Une mesure est échecs avec étape classée et identifiant utilisable / échecs échantillonnés, en signalant les journaux absents. Capture et trace peuvent éclairer le jeu d’essai local, mais leur conservation doit rester nécessaire à l’enquête, sans secrets ni données étrangères au cas.
Le volume de journaux n’est pas un indicateur de qualité. Plus de sortie peut créer bruit et risque de conservation. Préférer des enregistrements structurés et limités, corrélables sans exposer de secrets. La question est la présence de preuves suffisantes pour orienter une enquête, pas l’utilisation d’un produit de journalisation donné.
6. Effort par mise à jour Chromium
Mesurer le travail, pas la réputation. Pour chaque mise à jour prévue, compter revue des notes, changement d’exécutable ou canal, compatibilité du paquet, exécution du jeu d’essai possédé, correction des régressions et documentation des versions. L’unité peut être l’heure de travail par mise à jour acceptée, avec liste des tâches incluses.
Séparer routine et incident dû à l’application ou à la cible : un sélecteur changé ne doit pas être automatiquement imputé au navigateur. Garder anciennes et nouvelles versions, paquet, révision du jeu d’essai, cas exécutés et différences non résolues. En cas de report, noter l’âge de la version figée et la raison ; un faible effort immédiat ne doit pas cacher le coût du retard.
Le guide de configuration Puppeteer et la documentation d’installation Playwright décrivent une partie du cycle des paquets et exécutables. Ils ne fixent pas les heures d’une équipe, qui dépendent de sa cadence, de l’application, du support et de ses validations. Mesurer les mêmes activités sur la même fenêtre pour chaque candidat. Pour figer les versions et promouvoir une mise à jour, le guide des versions d’automatisation explique le contrat à conserver avec le suivi de maintenance.
Choisir les poids selon la charge
Classer chaque critère comme exigence obligatoire, préférence pondérée ou sans objet. Exactitude et autorisation sont généralement obligatoires : un échec exclut le candidat avant la notation. Les autres poids peuvent aller de 0 à 5, de l’absence d’effet à une priorité majeure. Ils expriment des conséquences opérationnelles, pas l’enthousiasme pour un produit.
Un petit catalogue peut privilégier exactitude et observabilité plutôt que concurrence. Un jeu d’essai possédé à fort volume peut privilégier coût et concurrence ; une équipe qui met souvent à jour peut privilégier maintenance. Ce sont des raisonnements illustratifs, pas des profils imposés. Une autre charge doit pouvoir conduire à d’autres poids.
Définir une échelle commune de 1 à 5 avant de voir les résultats : 1 manque le minimum ; 2 le respecte avec beaucoup d’intervention ; 3 le respecte dans la limite ; 4 ajoute une marge opérationnelle ; 5 dépasse une cible prédéfinie sur plusieurs échantillons. L’échec d’une exigence obligatoire reste éliminatoire quel que soit le total.
Calculer uniquement sur les préférences applicables, hors exigences éliminatoires :
weighted result = sum(criterion score * criterion weight) / sum(applicable weights)
Si tous les poids applicables sont nuls, ne pas calculer de total pondéré : comparer les mesures brutes ou définir d’abord une priorité pertinente. Présenter les mesures brutes à côté du total. Sans composantes visibles, une moyenne peut cacher une faiblesse. Conserver la raison de chaque poids et les changements qui modifieraient le choix. Si les candidats sont proches, noter une égalité selon les preuves disponibles au lieu d’inventer de la précision.
Remplir la grille vierge
La grille est un modèle, pas un benchmark prérempli. En copier une par candidat et n’y inscrire que les données du jeu d’essai déclaré. Une référence doit conduire à un artefact ou un registre vérifiable, pas à une impression sans preuve.
| Critère | Exigence ou poids | Mesure et unité |
|---|---|---|
| Exactitude | Champs requis valides ? | Enregistrements acceptés / tentés ; couverture |
| État | Poids : ___ | Points conformes / évalués |
| Coût | Poids : ___ | Coût pour 1 000 pages acceptées |
| Concurrence | Poids : ___ | Plus haut niveau dans les limites |
| Échecs | Poids : ___ | Échecs classés / échantillonnés |
| Mises à jour | Poids : ___ | Heures par mise à jour acceptée |
| Résultat | Référence | Interprétation |
|---|---|---|
| Exactitude: Jeu d’essai | Révision et données | Accepter ou exclure |
| État: Cycle de vie | Politique et contrôles | Préserver, réinitialiser ou enquêter |
| Coût: Périmètre de coût | Intervalle et pages | Après les exigences |
| Concurrence: Charge possédée | Fenêtre, file, mémoire et échecs | Cette charge seulement |
| Échecs: Journaux conservés | Identifiants et étapes | Peut-on orienter l’enquête ? |
| Mises à jour: Registre des changements | Versions, tâches et résultats | Inclure le risque du report |
Conserver la grille avec le contrat de charge, pas comme chiffre isolé dans une présentation. Garder les candidats exclus et leurs échecs pour distinguer nouvelles exigences, versions ou jeux d’essai lors d’une décision ultérieure. Retirer secrets et données personnelles inutiles avant de conserver les journaux.
Ce que le score ne démontre pas
La grille est limitée par le jeu d’essai, la configuration, la fenêtre et les règles déclarées. Elle ne démontre rien pour un autre site, compte ou balisage futur. Elle n’accorde pas d’autorisation, ne garantit pas la complétude pour tout usage métier ni la disponibilité d’un service externe.
Si la cible restreint l’accès, demande une authentification, présente un défi ou indique l’arrêt de la collecte, la grille ne donne pas une autre voie d’accès. Respecter autorisation, politique et limites de fréquence. Consigner la condition et arrêter à cette frontière. Pouvoir s’arrêter est aussi une exigence opérationnelle.
Capacité et limite de BotBrowser
Le guide de première vérification BotBrowser documente un point de départ pour confirmer une configuration ; le guide de performance aborde des choix liés aux ressources. Ils aident à identifier les réglages à consigner, sans démontrer que BotBrowser gagne la grille ni garantir un résultat tiers.
Appliquer les mêmes règles et limites à tous les candidats, en conservant lancement et profil BotBrowser comme entrées déclarées. Ne pas attribuer un résultat au produit si jeu d’essai, réseau, état, paquet ou version ont aussi changé. La note appartient à la configuration et à l’échantillon, pas à la marque isolée.
Questions fréquentes
Existe-t-il un meilleur navigateur universel ?
Ces sources ne désignent aucun gagnant indépendant de la charge. Comparer les candidats sur le même jeu d’essai autorisé, selon les contraintes de l’équipe.
Faut-il inclure le framework d’automatisation ?
Oui, s’il change lancement, exécutable, cycle des contextes ou maintenance. Consigner framework et version dans la configuration pour ne pas attribuer leur comportement au navigateur seul.
Une forte concurrence autorise-t-elle plus de requêtes ?
Non. La capacité est distincte de la permission et des limites du site. N’exécuter que la charge autorisée et s’arrêter à sa frontière déclarée.
Quand faut-il refaire la grille ?
Lorsqu’une entrée importante change : version du navigateur ou paquet, lancement, schéma du jeu d’essai, environnement, coût ou politique. Conserver les anciens dossiers pour comprendre l’historique.
Sources
- Playwright: Browsers
- Puppeteer: Configuration
- Chrome for Developers: Headless mode
- BotBrowser: First verification
- BotBrowser: Performance optimization
- Méthodologie de comparaison des navigateurs
- Comparaison de protection moteur et API
- Exigences de collecte SERP
Conclusion pratique
Le meilleur navigateur pour une charge satisfait autorisation et exactitude, puis respecte les limites mesurées d’état, de coût, de concurrence, d’observabilité et de maintenance. Remplir les six lignes avec les preuves d’une charge déclarée, garder les mesures brutes près du score et répéter la comparaison si une entrée importante change. La prochaine action sûre consiste à définir le jeu d’essai possédé et les règles d’acceptation avant d’évaluer un candidat. L’endroit où le navigateur s’exécute est un critère distinct de quel navigateur c’est, et un débloqueur hébergé face à un navigateur que vous possédez traite cette séparation pour les tâches qui ne demandent que des données.
Cet article fait partie du guide : Débuter avec l'automatisation du navigateur : carte initiale
Articles Connexes
Performance navigateur : optimisation à grande échelle
DémarrageÉpingler et mettre à jour les versions du navigateur
DémarrageScraping avec Playwright : navigateur et profil
RéseauLimites de scraping : 429, Retry-After et concurrence
DéploiementScraping SERP à grande échelle : exigences navigateur
DémarrageUndetected Chromedriver : alternative côté navigateur
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.