Empreinte du navigateur : les limites de Scrapy
Distinguez les empreintes de requête Scrapy des signaux du navigateur, les réponses HTTP des pages exécutées et les téléchargements des intégrations avec navigateur.
BotBrowser Team
Vous voulez la documentation structurée pour Démarrage ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
Le téléchargeur HTTP par défaut de Scrapy ne possède aucun environnement d’exécution JavaScript pour les pages. Son empreinte de requête, utilisée pour le filtrage des doublons et la mise en cache des réponses, diffère d’une empreinte du navigateur assemblée à partir d’observations du navigateur. BotBrowser documente le contrôle des surfaces du moteur du navigateur au moyen de profils, mais ne peut pas ajouter un moteur de rendu au téléchargeur HTTP par défaut, modifier l’identité utilisée par l’ordonnanceur de Scrapy, configurer des moteurs distants arbitraires ou garantir l’accès. Pour répondre à une question sur « Scrapy browser fingerprint », il faut commencer par déterminer si le problème relève de l’identité locale des requêtes, de leur acheminement réseau, de l’analyse des réponses ou d’un environnement de navigateur explicitement sélectionné.
Résumé
- Une empreinte de requête est un identifiant local. Ses entrées par défaut concernent la méthode, l’URL et le corps de la requête, avec un traitement des métadonnées supplémentaires qui dépend de la version.
- Les en-têtes sont exclus de l’identité de requête par défaut. Inclure certains en-têtes modifie la comparaison locale, pas le comportement des API du navigateur.
- Le HTML téléchargé et le DOM d’un navigateur après exécution peuvent contenir des données différentes. Analyser des données JavaScript intégrées n’exécute pas la page.
- Un gestionnaire de téléchargement reposant sur un navigateur modifie le chemin d’exécution. Un travail effectué directement avec le navigateur dans une fonction de rappel peut laisser de côté des composants de Scrapy.
- Diagnostiquez un environnement de test autorisé à la frontière de responsabilité concernée avant de modifier un autre composant. Ni une empreinte de hachage ni un en-tête ne prouvent l’exécution d’un navigateur.
Sommaire
- Les empreintes de requête définissent une équivalence locale
- Le téléchargeur appartient à un flux de travail plus large
- Les en-têtes HTTP ne créent pas les API du navigateur
- Le code de la réponse et le DOM exécuté sont des artefacts différents
- L’intégration d’un navigateur change la responsabilité de l’exécution
- Classez quatre défaillances de test selon leurs preuves
- Conclusion pratique
Les empreintes de requête définissent une équivalence locale
La documentation des empreintes de requête de Scrapy présente cet identifiant pour le filtrage des doublons et la mise en cache des réponses. Les composants ont besoin d’un moyen compact de comparer les requêtes selon les règles d’équivalence prévues par le projet. Il s’agit d’une décision de gestion interne. L’empreinte n’est pas automatiquement un en-tête, un identifiant produit par le navigateur ou une observation rapportée par le serveur. Le fait que deux requêtes reçoivent le même identifiant local n’établit pas que leurs échanges réseau ou les documents renvoyés sont identiques.
L’implémentation amont examinée tient compte de la méthode de requête, d’une URL canonisée et du corps de la requête. La canonisation peut rendre équivalentes, à cette fin, des URL dont les paramètres de requête sont ordonnés différemment. Les en-têtes de requête sont ignorés par défaut et les fragments d’URL sont normalement omis. L’argument include_headers permet d’inclure certains en-têtes dans le calcul ; keep_fragments modifie le traitement des fragments. Aucune de ces options ne crée de moteur de rendu. Inclure un fragment dans une clé locale n’exécute pas le code applicatif qui interprète ce fragment.
L’entrée correspondant au corps est le corps brut de la requête, représenté sous forme d’octets hexadécimaux dans les données d’empreinte de l’implémentation. Il n’est pas analysé et normalisé en tant que JSON. Deux documents JSON décrivant le même objet, mais différant par les espaces ou l’ordre des propriétés, peuvent donc produire des empreintes de requête différentes. Inversement, la canonisation des URL peut fusionner des différences que le responsable de l’application considère comme significatives. L’identité de requête doit correspondre aux exigences de la charge de travail, plutôt qu’à l’hypothèse selon laquelle toute représentation de données métier équivalentes reçoit un identifiant unique.
L’examen fourni utilise l’instantané amont e63a574c767d7a9438c21db158f605f1c44c6e6a, et non une version installée ou testée à l’exécution. Dans cette implémentation, verbatim_url conserve l’URL de la requête au lieu de la canoniser, ce qui rend keep_fragments sans objet. Une valeur de download_handler différente du schéma de l’URL entre également dans l’identité ; une valeur correspondant au schéma est omise. Le code indique que la prise en compte du gestionnaire constitue un changement de 2.20.0. Ces détails dépendent de la version et de la configuration ; ils n’affirment pas que toutes les installations déployées de Scrapy se comportent ainsi.
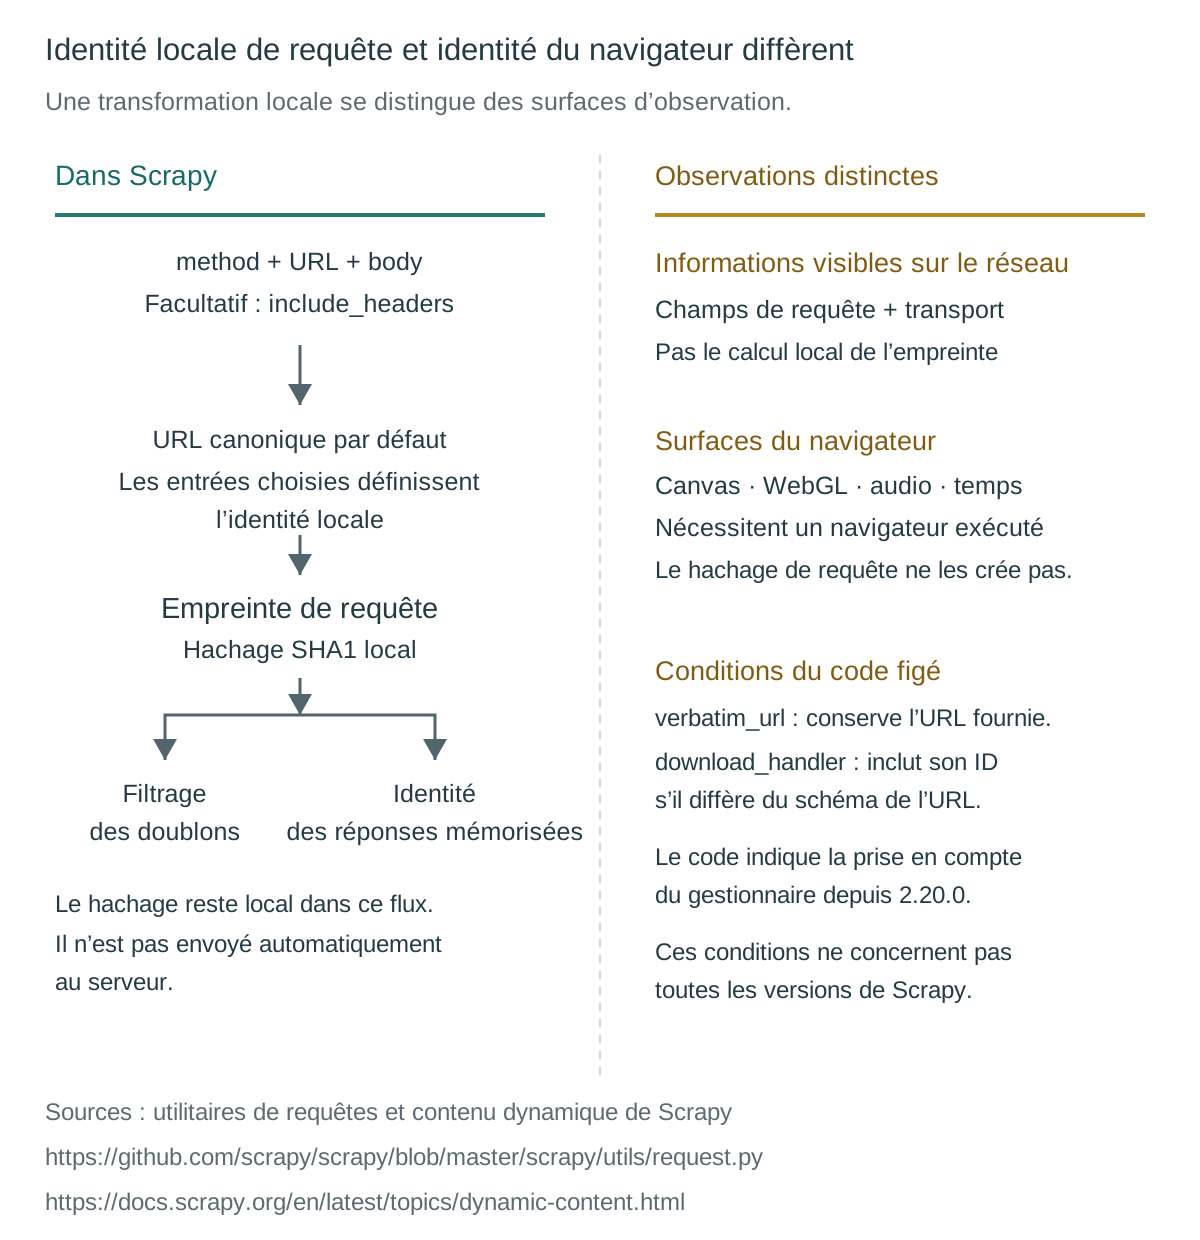
L’égalité ne garantit pas non plus l’identité sémantique des réponses. Un catalogue dont vous êtes propriétaire peut faire varier sa réponse selon la langue ou l’état autorisé de l’application, même lorsque la méthode, l’URL et le corps correspondent. Ignorer les en-têtes peut convenir à une exploration et être incorrect pour une autre. Scrapy expose REQUEST_FINGERPRINTER_CLASS parce qu’il n’existe aucune règle universelle de comparaison. La décision porte sur les requêtes que le projet entend distinguer, pas sur l’empreinte qui ressemble le plus à celle d’un navigateur. Les réponses dont le contenu dépend de l’authentification nécessitent également une politique de cache adaptée à leur périmètre ; une clé de requête partagée ne suffit pas à établir que leur réutilisation est sûre.
Le téléchargeur appartient à un flux de travail plus large
La présentation de l’architecture de Scrapy attribue des responsabilités différentes à l’ordonnanceur, au téléchargeur, au robot d’exploration et à la chaîne de traitement des éléments. Le moteur obtient les requêtes du robot et les fait passer par l’ordonnancement. Le téléchargeur obtient les réponses, avec l’intervention des intergiciels de téléchargement autour de cette frontière. Les fonctions de rappel du robot traitent les réponses et renvoient des éléments ou de nouvelles requêtes. Les chaînes de traitement des éléments prennent ensuite en charge des tâches telles que le nettoyage, la validation et la persistance. Une sortie vide peut provenir de plusieurs étapes avant ou après une requête réseau.
Cet ordre explique pourquoi modifier un en-tête de requête peut n’avoir aucun effet sur une décision de filtrage des doublons. Une requête exclue pendant l’ordonnancement peut ne jamais atteindre le téléchargeur dont le développeur souhaitait ajuster les champs sortants. De même, une réponse téléchargée peut atteindre correctement une fonction de rappel, mais produire un élément rejeté par la validation. « Rien n’a été enregistré » n’identifie ni un échec de téléchargement ni un problème de navigateur. Une preuve utile nomme la dernière étape achevée et l’entrée attendue par l’étape suivante.
Le chemin HTTP par défaut récupère le contenu des réponses sans exécuter les scripts de la page. Le guide du contenu dynamique de Scrapy distingue explicitement l’inspection du code téléchargé de l’accès au DOM actif d’un navigateur. Cette frontière n’interdit pas l’exécution d’un navigateur par un autre gestionnaire ou une autre intégration. Scrapy est un cadre logiciel aux composants configurables ; « le téléchargeur par défaut ne possède pas de moteur de rendu » est plus précis que « Scrapy ne peut jamais exécuter JavaScript ». Le chemin d’exécution sélectionné détermine quel processus peut produire un document rendu.
L’attribution du transport nécessite également de connaître la configuration effective. La documentation d’architecture décrit les communications réseau événementielles de Scrapy et sa relation avec Twisted, mais les gestionnaires personnalisés et les changements de version comptent. Il serait imprudent d’attribuer toute requête possible effectuée depuis un projet Scrapy à une seule implémentation de transport. Consignez la version installée et le gestionnaire sélectionné avant d’examiner le comportement de la connexion. Le comportement TLS relève de l’implémentation réseau et de la configuration de ce gestionnaire, pas d’un nom de navigateur inscrit dans un en-tête HTTP.
La frontière de la chaîne de traitement reste utile même lorsqu’un navigateur fournit la réponse. L’exécution du navigateur peut rendre un champ disponible, mais elle n’établit pas que la fonction de rappel a sélectionné le bon enregistrement ni que la chaîne l’a accepté. Précisez l’artefact attendu à chaque transition : requête ordonnancée, réponse reçue, élément analysé et sortie persistée. Cela permet de localiser une défaillance sur laquelle agir sans collecter chaque document ni confondre le démarrage réussi du navigateur avec la validation réussie des données.
Les en-têtes HTTP ne créent pas les API du navigateur
Le paramètre DEFAULT_REQUEST_HEADERS de Scrapy fournit des champs HTTP par l’intermédiaire de DefaultHeadersMiddleware. Ces champs décrivent une requête sortante. Une valeur Accept-Language peut influencer la réponse d’un serveur dont vous êtes propriétaire, et un champ d’agent utilisateur peut contenir une chaîne choisie, mais aucun des deux ne crée window.navigator. La référence Navigator de MDN décrit un objet exposé par un environnement de navigateur, comprenant userAgent et hardwareConcurrency. Leur existence et leurs valeurs relèvent de cet environnement d’exécution, pas d’un dictionnaire de requête Python.
La même frontière s’applique aux graphiques. MDN décrit HTMLCanvasElement.toDataURL() comme une méthode renvoyant une représentation encodée de l’image d’un canevas. Ce n’est pas une fonction intégrée de hachage de l’identité de l’appareil. L’appelant peut ensuite traiter cette sortie, mais il s’agit d’une autre opération. Le résultat dépend de l’image matricielle et de l’encodage demandé, et une image dont les pixels ne respectent pas la condition de propreté d’origine peut provoquer SecurityError. Un en-tête ne dessine pas cette image et ne fournit pas les conditions de sécurité du navigateur nécessaires pour la lire.
WebGLRenderingContext.getParameter() renvoie la valeur associée au nom de paramètre demandé. Le type et la signification de la valeur renvoyée dépendent de ce paramètre. L’appeler « l’empreinte WebGL » masque l’observation réellement demandée et l’existence éventuelle du contexte concerné. Un environnement de test de navigateur utile nomme l’API et le paramètre examinés. Il ne suppose pas que tous les environnements d’exécution exposent les mêmes capacités ni qu’une seule valeur renvoyée identifie de manière unique un appareil physique.
L’audio exige une description tout aussi précise. L’interface OfflineAudioContext de MDN représente un graphe de traitement audio qui produit son rendu dans un AudioBuffer, plutôt que directement sur le matériel audio de l’appareil. Le traitement hors ligne ne nécessite donc pas d’affirmer qu’un haut-parleur a émis un son. Le graphe, les changements planifiés et l’environnement d’exécution produisent la sortie. Aucun champ HTTP ne remplace ce calcul, et l’absence d’environnement d’exécution de page signifie que le téléchargeur par défaut n’a aucune observation de ce type, générée par la page, à renvoyer.
La mesure du temps constitue une autre surface distincte. performance.now() rapporte les millisecondes écoulées depuis performance.timeOrigin au moyen d’une horloge monotone. MDN documente aussi la réduction de précision, avec notamment des conditions de résolution différentes pour les contextes isolés entre origines. La durée d’une requête mesurée par un téléchargeur correspond à un autre intervalle, avec une autre horloge et un autre périmètre. Faire correspondre une durée de téléchargement à un horodatage de page n’établit pas un comportement temporel équivalent du navigateur, et une réponse lente n’établit pas à elle seule un problème de temporisateur JavaScript.
Ces API sont des exemples d’observations du navigateur, pas une promesse de disponibilité universelle ou d’identification unique. La prise en charge du navigateur, les conditions du document et la politique d’exécution peuvent les limiter. Par ailleurs, un serveur peut toujours observer l’activité HTTP et les connexions sans exécuter le JavaScript de la page. L’analyse de la protection contre les empreintes du navigateur explique les surfaces de confidentialité du navigateur ; son périmètre ne transforme pas la clé locale de requête de Scrapy en ces surfaces. Ni l’absence d’exécution JavaScript ni la modification d’un champ de requête n’établissent l’anonymat ou l’autorisation de collecter des données.
Le code de la réponse et le DOM exécuté sont des artefacts différents
La documentation du contenu dynamique de Scrapy décrit un décalage fréquent : les données apparaissent dans un navigateur, mais sont absentes pour les sélecteurs qui opèrent sur la réponse téléchargée. Le navigateur peut avoir exécuté des scripts, effectué des requêtes supplémentaires et mis à jour son document. Les sélecteurs de réponse de Scrapy opèrent sur le contenu qui leur est fourni. Avant de modifier les sélecteurs, établissez si le champ requis existe dans cette entrée. Un sélecteur ne peut pas retrouver un nœud que la réponse sélectionnée n’a jamais contenu.
Une page dont vous êtes propriétaire peut aussi inclure les données souhaitées dans un élément de script sans les placer dans le HTML visible. Extraire un objet sérialisé ou analyser du code JavaScript comme des données n’équivaut pas à exécuter la page. Scrapy documente l’analyse des valeurs intégrées séparément de la navigation sans interface graphique. Cette distinction importe pour la provenance : une valeur obtenue à partir du texte source ne démontre pas que l’initialisation du navigateur, le traitement des événements ou le rendu ont eu lieu. Elle établit seulement que le texte sélectionné contenait une valeur comprise par l’analyseur.
Une réponse JSON externe constitue un autre artefact possible. Si une application dont vous êtes propriétaire expose l’enregistrement requis par un point d’accès autorisé, cette représentation peut satisfaire la tâche sans exécution de navigateur. Elle peut aussi omettre un état de présentation dont la tâche a réellement besoin. La comparaison entre page rendue et point d’accès JSON explique ce choix en fonction de la sortie requise. Un point d’accès aux enregistrements et une capture d’écran répondent à des questions différentes, même lorsqu’ils proviennent de la même application.
Inversement, une API HTTP peut renvoyer un document rendu par un navigateur ailleurs. Recevoir du HTML par HTTP ne prouve pas que son producteur a évité l’exécution de JavaScript. Le consommateur doit distinguer le transport de la production : qu’est-ce qui a traversé la connexion, et quel système l’a généré ? Le contrat de réponse d’un service de rendu peut fournir un artefact issu de l’exécution, tandis qu’une réponse ordinaire du serveur d’origine peut fournir du code HTML. Ni le type de média ni l’utilisation d’un client HTTP ne résolvent à eux seuls cette distinction.
Pour l’acceptation, nommez la représentation requise avant de sélectionner un chemin d’exécution. « Contient l’identifiant de l’élément de test dans le code source renvoyé », « contient un nœud d’élément après exécution de la page » et « renvoie un enregistrement JSON valide » sont des conditions différentes. Chacune nécessite son propre producteur et son propre point de validation. Remplacer l’une par une autre peut modifier silencieusement la tâche, en particulier lorsque la présentation dépend de l’interaction ou de l’état de l’application. Un téléchargement réussi établit la livraison d’un artefact, pas la satisfaction de toutes les exigences de rendu possibles.
L’intégration d’un navigateur change la responsabilité de l’exécution
Le README de scrapy-playwright décrit un gestionnaire de téléchargement Scrapy qui effectue les requêtes par Playwright pour Python tout en préservant le flux de travail habituel de Scrapy, notamment l’ordonnancement des requêtes et le traitement des éléments. Il s’agit d’une intégration explicitement fondée sur un navigateur. Elle diffère de l’ajout d’en-têtes ressemblant à ceux d’un navigateur au téléchargeur HTTP par défaut, car un autre environnement d’exécution réalise désormais le travail du navigateur. Le cadre logiciel conserve ses responsabilités d’ordonnancement et de sortie ; l’intégration change le producteur de la réponse plutôt que de remplacer chaque composant.
Les conseils de Scrapy sur la navigation sans interface graphique distinguent également l’intégration de l’utilisation directe de Playwright dans une fonction de rappel. Ils avertissent que cette utilisation directe laisse de côté la plupart des composants de Scrapy, notamment les intergiciels et le filtrage des doublons, et recommandent scrapy-playwright pour une meilleure intégration. Il s’agit d’une distinction de flux de contrôle. Il ne faut pas supposer qu’une action réseau initiée directement par du code de navigateur hérite des décisions de l’ordonnanceur ou du comportement des intergiciels d’une requête transmise à Scrapy.
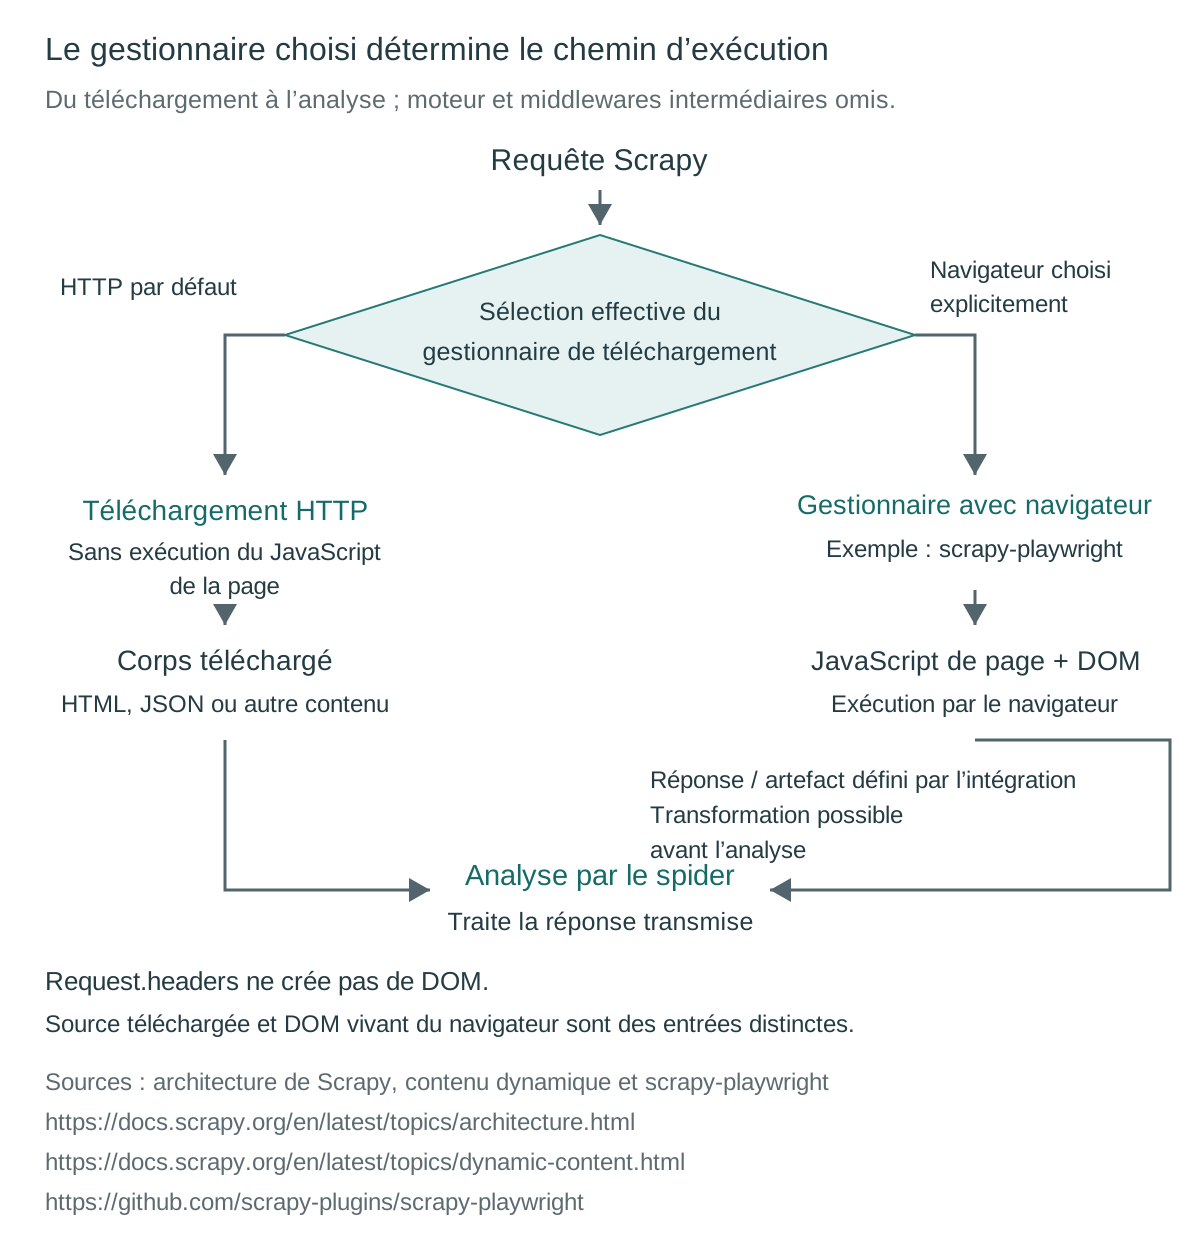
Cette provenance influe sur ce que les paramètres peuvent raisonnablement contrôler. Un paramètre de requête Scrapy, une option de gestionnaire et un paramètre du moteur de navigateur ont des consommateurs différents. Certaines actions du navigateur peuvent provenir de la page ou d’une automatisation directe, plutôt que de requêtes Scrapy ordonnancées indépendamment. Identifiez le responsable de l’action avant d’attendre qu’un point d’intervention du cadre logiciel l’observe ou la modifie. La même prudence s’applique à un navigateur distant : son exécutable et la politique du fournisseur restent soumis au contrat réel de configuration de l’environnement d’exécution.
La présentation du navigateur de BotBrowser documente le contrôle par profils des surfaces du moteur de navigateur, notamment Navigator, les graphiques, l’audio et la mesure du temps. Cette capacité appartient à un environnement BotBrowser sélectionné de manière compatible ; elle ne peut pas configurer automatiquement chaque intégration, remplacer un moteur distant arbitraire ou modifier la politique d’empreinte de requête de Scrapy. Aucun test de compatibilité du module n’est rapporté ici. La sélection de l’environnement d’exécution nécessite l’exécutable ou le mode de connexion pris en charge par l’intégration, plutôt que de déduire que tous les outils d’automatisation de navigateurs acceptent des moteurs interchangeables.
La comparaison du mode sans interface graphique concerne les modes d’exécution une fois qu’un chemin de navigateur existe. Elle n’établit pas qu’un téléchargeur HTTP a acquis un navigateur simplement parce qu’aucune fenêtre n’est visible. Établissez d’abord qui contrôle le navigateur et quel artefact est requis ; examinez ensuite le mode et la configuration documentés de l’environnement sélectionné. L’autorisation de l’application et la validation de la sortie restent des exigences indépendantes tout au long de ce choix.
Classez quatre défaillances de test selon leurs preuves
Considérez un environnement hypothétique de test d’un catalogue dont vous êtes propriétaire, avec deux variantes linguistiques, un document source et une page qui ajoute un champ d’affichage inoffensif après exécution. La matrice suivante décrit des classifications attendues, pas des résultats observés à l’exécution. Son objectif est d’attribuer chaque question à un composant capable d’y répondre. Les références Scrapy sur l’identité de requête, l’architecture et le contenu dynamique établissent ces frontières.
| Cas hypothétique | Classification attendue | Composant responsable | Preuve utile minimale |
|---|---|---|---|
| Des URL de requête équivalentes ne produisent qu’un téléchargement ordonnancé | Équivalence locale des requêtes et filtrage des doublons | Générateur d’empreintes effectif et filtre de doublons de l’ordonnanceur | Méthode, comparaison d’URL expurgées des données sensibles, politique d’empreinte et résultat de l’ordonnancement |
| Deux requêtes ne diffèrent que par un en-tête de paramètres régionaux, mais nécessitent des enregistrements séparés | Identité de requête sensible aux en-têtes face à la variation des réponses du serveur | Politique d’empreinte, en-têtes du téléchargeur et validation des enregistrements | Nom de l’en-tête sélectionné, valeur régionale inoffensive et langue attendue |
| La réponse brute ne contient pas un nœud présent après exécution du navigateur | Provenance de l’artefact et exigence de rendu | Analyseur de réponses ou gestionnaire de navigateur explicitement sélectionné | Présence du champ dans le code source, le DOM exécuté ou une réponse de données autorisée |
| La latence de requête est prise pour une mesure du temporisateur du navigateur | Décalage de périmètre de mesure | Instrumentation du téléchargeur face à l’API Performance du navigateur | Source de l’horloge, intervalle mesuré et chemin d’exécution |
Pour le cas des URL en doublon, la question d’acceptation est de savoir si le projet traite volontairement les deux requêtes comme une seule unité. Pour le cas des paramètres régionaux, il s’agit de savoir si les deux enregistrements linguistiques restent distinguables selon la politique effective d’identité et de validation. Ces questions sont différentes, même si elles se manifestent toutes deux par un élément manquant. Le simple fait de voir deux objets de requête dans le code applicatif ne prouve pas qu’ils ont tous deux franchi l’ordonnancement ni que le serveur a reçu deux requêtes distinctes.
Pour le cas du nœud manquant, l’acceptation exige la présence du champ dans l’artefact déclaré. Une tâche limitée au code source ne doit pas devenir silencieusement une tâche de navigateur interactif, et une tâche nécessitant un état exécuté ne doit pas être jugée sur le seul code source. Pour la latence, l’acceptation exige un intervalle correctement nommé. Une mesure du téléchargeur peut être utile sans représenter la précision de performance.now(), le temps d’exécution de la page ou un résultat d’API du navigateur. Une classification correcte évite d’introduire un environnement d’exécution incapable de répondre à la question initiale.
Conservez uniquement les preuves nécessaires à la décision : version effective de Scrapy, identité du gestionnaire, options d’empreinte pertinentes, caractéristiques de requête expurgées des données sensibles, type d’artefact et résultat de validation. Ne collectez ni secrets, ni cookies bruts, ni contenus de page sans rapport pour démontrer ces frontières. Un futur test réussi établirait le comportement de cette configuration et de cette application dont vous êtes propriétaire. Il n’établirait ni une empreinte de négociation de connexion, ni la compatibilité avec toutes les intégrations de navigateur, ni l’autorisation de répéter le travail sur des sites sans rapport.
Questions fréquentes
L’empreinte de requête Scrapy est-elle envoyée comme identité du navigateur ?
Pas par le calcul d’empreinte par défaut. Il fournit une identité locale de requête aux composants tels que le filtrage des doublons et la mise en cache. Les observations réseau et celles du navigateur ont des producteurs distincts.
Définir un en-tête d’agent utilisateur crée-t-il les propriétés de Navigator ?
Non. Un champ de requête ne crée pas window.navigator, Canvas, WebGL ou un graphe audio. Ceux-ci nécessitent un véritable environnement d’exécution compatible et les conditions de document applicables.
Analyser des données dans un élément de script exécute-t-il JavaScript ?
Non. Lire le texte source et extraire des valeurs intégrées relève de l’analyse de données. L’exécution du navigateur peut effectuer des calculs supplémentaires et des mises à jour du document que l’analyse du code source n’effectue pas.
Scrapy peut-il utiliser un navigateur tout en conservant son flux de travail normal ?
Le README de scrapy-playwright décrit cette intégration par gestionnaire de téléchargement. Le travail direct avec Playwright dans une fonction de rappel présente d’autres frontières d’intégration ; la participation des composants doit donc être établie pour le chemin sélectionné.
Sources
- Scrapy : Présentation de l’architecture
- Scrapy : Empreintes de requête
- Scrapy : Sélection du contenu chargé dynamiquement
- Scrapy : Paramètres
- Scrapy : Utilitaires de requête dans l’instantané amont examiné
- scrapy-playwright : README du projet
- MDN : Navigator
- MDN : HTMLCanvasElement.toDataURL()
- MDN : WebGLRenderingContext.getParameter()
- MDN : OfflineAudioContext
- MDN : Performance.now()
- BotBrowser : Présentation des empreintes du navigateur
Conclusion pratique
Classez une défaillance d’un environnement de test autorisé selon qu’elle relève de l’identité locale de requête, de la livraison du téléchargement, de l’analyse des réponses ou de l’exécution du navigateur. Choisissez ensuite le composant qui produit la preuve manquante. Vérifiez sa version et sa configuration effectives avant de modifier une autre couche : une empreinte de requête, un en-tête HTTP et un environnement de navigateur contrôlent chacun une partie différente du travail.
Cet article fait partie du guide : Débuter avec l'automatisation du navigateur : carte initiale
Articles Connexes
Navigateur de web scraping : quel type choisir ?
DémarrageWeb scraping Browserbase : qui contrôle quoi ?
DémarrageScraping headless : ce qui change vraiment
EmpreinteAPI de scraping web : ce que cache la réponse
DémarrageQu’est-ce qu’un robot d’exploration ? Cinq étapes
EmpreinteClient Hints Fingerprinting : en-têtes HTTP et identité
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.