Twitter scraping: fenêtres API et limites du navigateur
Choisir endpoint, période et authentification pour publications, mentions, recherche et accueil X. Distinguer HTML intégré, classement et données API.
BotBrowser Team
Vous voulez la documentation structurée pour Démarrage ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
Les besoins de twitter scraping échouent souvent avant le premier sélecteur: l’historique ou l’ordre demandé ne correspond pas à l’endpoint X choisi. Il faut d’abord choisir le produit de données, le contexte d’authentification et la période. BotBrowser permet d’intégrer Chromium à Playwright et Puppeteer pour des vérifications dans le navigateur autorisées séparément; il ne peut pas accorder l’accès à l’API X, ni étendre l’historique, reproduire le classement algorithmique ou supprimer les limites de la plateforme. La configuration du navigateur intervient ensuite, lorsqu’une tâche de navigateur permise reste effectivement nécessaire.
TL;DR
- Publications d’un auteur, mentions, accueil chronologique et résultats de recherche sont des ensembles différents, avec des bornes documentées distinctes.
- La recherche récente couvre les 7 derniers jours; le produit d’archives complètes remonte à mars 2006, sous réserve de ses conditions d’accès.
- L’endpoint d’accueil chronologique inversé ne reproduit pas le classement algorithmique. Une chronologie intégrée fournit du balisage d’affichage, pas un export historique.
- Expiration du jeton OAuth 2.0, décompte des requêtes et durée de session du navigateur sont des questions séparées. Multiplier les sessions ne crée aucun droit d’accès manquant.
Sommaire
- Associer le besoin à un résultat X
- Évaluer trois demandes selon leur portée historique
- Rattacher authentification et durée à la route
- Séparer limites de requêtes et observations du navigateur
- Conclusion pratique
Associer le besoin à un résultat X
La documentation des chronologies X distingue publications d’un auteur, mentions et accueil chronologique inversé de l’utilisateur authentifié. Un client qui veut les réponses mentionnant son compte ne demande pas ses propres publications. Un produit qui veut ce qu’une personne a vu dans l’accueil classé ne demande pas l’ordre de l’endpoint chronologique. Cette distinction doit figurer dans la spécification au lieu de regrouper toutes les surfaces sous le mot «tweets».
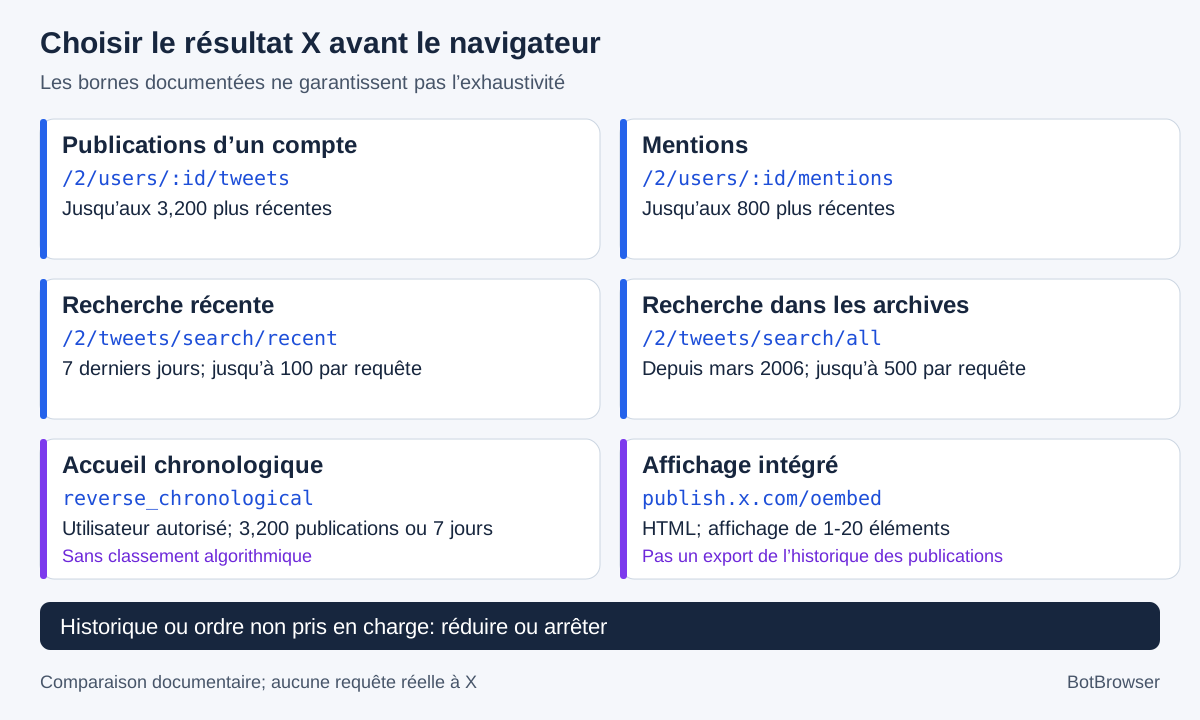
| Résultat demandé | Route officielle candidate | Borne documentée et règle de choix |
|---|---|---|
| Publications rédigées par un compte | /2/users/:id/tweets | Jusqu’aux 3,200 plus récentes; filtres et paramètres temporels ne constituent pas des archives de toute son existence |
| Publications mentionnant un compte | /2/users/:id/mentions | Jusqu’aux 800 mentions les plus récentes; ne pas remplacer par les publications de l’auteur |
| Accueil chronologique de l’utilisateur authentifié | /2/users/:id/timelines/reverse_chronological | Les 3,200 publications les plus récentes ou 7 jours; authentification utilisateur requise, classement algorithmique exclu |
| Correspondances d’une requête récente | /2/tweets/search/recent | 7 derniers jours, jusqu’à 100 par requête; vérifier accès développeur/application et prise en charge de la requête |
| Correspondances sur une période antérieure | /2/tweets/search/all | Archives depuis mars 2006, jusqu’à 500 par requête; vérifier l’accès actuel à l’usage ou Enterprise |
| Afficher une publication ou une chronologie utilisateur/liste prise en charge | https://publish.x.com/oembed | JSON contenant du HTML intégré; affichage de 1-20 éléments, pas un export historique structuré |
| Ordre algorithmique exact de l’accueil | Aucun équivalent établi par ces références | Arrêter ou réduire le besoin; la visibilité dans le navigateur ne définit pas un contrat d’extraction stable |
Ces nombres sont des plafonds ou fenêtres documentés, pas la promesse que chaque requête renverra autant d’enregistrements. Disponibilité, filtres, authentification et contrat actuel de l’endpoint restent déterminants. La présentation de la recherche annonce la recherche récente pour tous les développeurs, mais cite aussi compte développeur, application et jetons parmi les prérequis. Cela ne signifie ni endpoint public sans authentification, ni projet quelconque immédiatement prêt à l’utiliser.
La documentation doit également être lue à une date donnée. L’introduction de l’API décrit une facturation à l’usage sans abonnements. Certains textes de chronologie et de pagination parlent encore de «niveau standard». Ces étiquettes ne justifient pas une ancienne comparaison de forfaits fixes. Vérifier le produit actuellement proposé et l’accès réel de l’application avant de chiffrer une tâche: limites de requêtes et frais d’usage répondent à des questions distinctes. Aucun prix ni abonnement n’est supposé ici.
Le HTML d’affichage a un autre contrat de sortie
La référence canonique oEmbed décrit une enveloppe JSON dont le contenu d’affichage est du HTML reconnu par le JavaScript des widgets X. Les paramètres de chronologie permettent d’afficher de 1 à 20 éléments. Ce nombre règle une présentation intégrée; ce n’est pas une taille de page pour collecter l’historique d’un compte. Le format JSON ne transforme pas, à lui seul, un endpoint en API de publications structurées.
La même référence précise que le balisage peut évoluer et recommande une mise en cache conforme à la durée suggérée par la réponse. Conserver cache_age avec cette réponse d’affichage, sans considérer un fragment en cache comme une trace permanente du texte ou de la disponibilité d’une publication. L’absence documentée d’authentification et de limite de requêtes concerne cette ressource d’intégration, pas la recherche, les chronologies, toute réutilisation ou toute requête future. Aucune requête oEmbed réelle n’a été effectuée pour cette comparaison.
L’affichage de contenu X comporte aussi des conditions extérieures au schéma de réponse. La Politique développeur actuelle traite affichage public, vie privée et redistribution; ses règles d’affichage abordent l’actualisation et le retrait du contenu devenu indisponible. L’intégration ne règle pas les droits d’analyse ultérieure ou de distribution de jeux de données. Le registre de décisions sur les autorisations fournit les questions générales; la matrice résout un choix technique plus étroit.
Évaluer trois demandes selon leur portée historique
Les cas suivants sont des besoins construits, pas des appels API réussis ni des observations d’un compte X. Ils exposent des erreurs différentes: mauvais ensemble de données, historique ancien demandé à un endpoint récent, ordre visible classé confondu avec un ordre disponible par API. Le résultat utile est une décision de route et une condition restante explicite, pas une réponse fictive contenant les données demandées.
Une recherche récente exige un intervalle borné
Supposons qu’une intégration approuvée demande des publications publiques correspondantes sur un intervalle défini entièrement situé dans les 7 derniers jours, avec texte, identifiants et horodatages de création. La candidate est la recherche récente, sous réserve des opérateurs pris en charge, de l’accès de l’application et de l’usage autorisé. Le besoin précise début et fin UTC, requête exacte et champs demandés. Il ne dit pas «toute l’activité sociale récente», ce qui mélangerait résultats de recherche et autres surfaces.
Le guide des champs explique qu’une consultation de publication renvoie par défaut des propriétés minimales, notamment id, text et edit_history_tweet_ids. D’autres propriétés comme created_at nécessitent le paramètre de champs adapté. Demander un champ ne supprime pas ses exigences d’authentification; les propriétés d’un objet lié peuvent nécessiter une expansion et les champs de cet objet. Définir le schéma d’après l’endpoint choisi plutôt qu’une capture de carte de publication.
Pour une recherche, conserver requête et intervalle pendant l’utilisation de la valeur de continuation. Le guide de pagination récente décrit la lecture de next_token dans la réponse puis son envoi avec la requête suivante. Changer la requête en cours signifie que les pages ne décrivent plus la même recherche. Augmenter la taille des pages ne supprime ni l’autorisation nécessaire ni la limite historique.
Une spécification côté application rend ces distinctions copiables sans se présenter comme une réponse API:
result_kind = recent_search_matches
interval = explicit UTC start and end within the last 7 days
query = fixed throughout this pagination sequence
requested_fields = id,text,created_at
continuation = response meta.next_token
completion = no next_token within this endpoint and query
excluded_claim = complete lifetime account history
Il s’agit d’une notation de planification, pas d’une syntaxe exécutable. La condition de fin est volontairement limitée à l’endpoint et à la requête. Atteindre une page sans continuation ne prouve pas que toute publication pertinente passée est disponible, que la requête représente le concept souhaité ou que le contenu indisponible peut être récupéré. Vérifier un schéma et choisir un endpoint ne répond pas à la même question que démontrer la couverture.
Des mentions historiques ne sont pas les publications de l’auteur
Supposons maintenant qu’un client demande toutes les mentions de son compte pendant les 12 derniers mois. Le plafond documenté de /2/users/:id/mentions est celui des 800 mentions les plus récentes. Épuiser les pages ne permet pas de le renommer «archives annuelles complètes». La chronologie de l’auteur serait aussi un mauvais recours: publications rédigées par le compte et publications qui le mentionnent ont des règles d’appartenance différentes, même si certains enregistrements se recoupent.
La recherche d’archives peut être candidate pour une requête historique correctement formulée, mais il faut vérifier opérateurs, accès, intervalle et champs renvoyés. La portée remontant à mars 2006 décrit un produit, pas un certificat d’exhaustivité du jeu annuel du client. Si le projet ne peut établir de requête prise en charge et d’accès permis, le besoin annuel reste non résolu ou doit être réduit à un périmètre récent documenté.
Le même raisonnement vaut pour les publications d’auteur plus anciennes que les 3,200 enregistrements les plus récents. Ajouter des paramètres de début et de fin plus anciens ne retire pas en soi la borne de la chronologie. Inscrire la limite auprès de l’endpoint proposé pour qu’un analyste ne confonde pas «toutes les pages disponibles» avec «toute l’existence du compte». Une borne visible dans la description de l’export est plus utile qu’une étiquette d’exhaustivité sans réserve.
L’accueil classé n’est pas l’accueil chronologique
Un troisième besoin demande l’ordre algorithmique exact affiché sur l’accueil d’un compte particulier. La route chronologique inversée exclut explicitement ce classement. Elle exige l’authentification utilisateur et décrit les 3,200 publications les plus récentes ou 7 jours des comptes suivis. Cet ensemble officiel est utile, mais le choisir modifie le besoin de classement initial au lieu d’y répondre.
Si l’accueil chronologique suffit, obtenir l’autorisation appropriée et préciser cet ordre dans le contrat du consommateur. Si la présentation classée exacte demeure essentielle, ces sources n’établissent pas d’équivalent officiel stable. Une observation de navigateur autorisée séparément pourrait décrire ce qui s’affichait à un instant donné; elle ne peut établir un historique classé rejouable, un ensemble complet de recommandations ou le droit de rejouer des requêtes internes. La comparaison du rendu et de la pagination explique la distinction générale réponse/rendu sans faire du DOM un droit d’accès API.
Rattacher authentification et durée à la route
La présentation de l’authentification distingue l’accès applicatif aux informations publiques des flux avec contexte utilisateur. Un identifiant porteur d’application n’est pas interchangeable avec l’autorisation d’un utilisateur. La référence de l’accueil exige spécifiquement un contexte OAuth utilisateur. Contrôler un compte ou obtenir le consentement d’un client ne signifie pas posséder X, pouvoir demander tous les champs ou bénéficier d’une approbation pour tout usage ultérieur.
| Contexte d’identifiant | Durée ou fonction documentée | Conséquence opérationnelle |
|---|---|---|
| OAuth 2.0 Authorization Code avec PKCE | Jeton d’accès de 2 heures par défaut; offline.access délivre un jeton de renouvellement | Implémenter le renouvellement documenté lorsqu’il est autorisé; distinguer les deux jetons |
| Contexte utilisateur OAuth 1.0a | Le guide décrit l’obtention d’un jeton d’accès permanent | Ne pas appliquer ce terme à OAuth 2.0, aux identifiants applicatifs ou aux cookies; l’autorisation peut changer |
| Porteur d’application | Informations publiques si l’endpoint le permet | Vérifier la prise en charge; la présentation consultée ne définit aucune durée universelle |
| Session de navigateur connectée | Session du navigateur, pas une classe d’identifiants API X | Ces références ne définissent pas de durée universelle des cookies; ne pas l’utiliser comme identifiant API de remplacement |
Le guide PKCE indique une durée d’accès de 2 heures par défaut et le rôle de l’accès hors ligne pour obtenir un jeton de renouvellement. Celui-ci permet le flux prévu, pas une autorisation irrévocable. Le guide OAuth 1.0a emploie le terme permanent pour son propre flux. Séparer ces affirmations évite qu’un collecteur de longue durée suppose un comportement identique pour tous les modes de connexion.
Associer classe d’identifiant et permissions requises à l’endpoint avant d’estimer la continuité. L’approbation d’une opération par un utilisateur ne rend pas une requête applicative authentifiée comme cet utilisateur. Un jeton expiré ne signifie pas en soi un quota épuisé. Un renouvellement prévu résout la validité du jeton; une remise à zéro du quota concerne une fenêtre de décompte. Ces événements exigent des champs de diagnostic séparés, sans secrets dans les journaux ou traces d’examen.
La persistance du navigateur constitue une autre couche. Le flux de sessions multicomptes traite séparation et stockage de sessions autorisées, pas les autorisations API X ou la durée de ses cookies. Un état enregistré peut ne plus être accepté alors que le fichier local existe; conserver ce fichier ne prouve ni validité du jeton ni maintien des permissions.
Séparer limites de requêtes et observations du navigateur
La référence des limites attribue les plafonds selon l’endpoint et le contexte d’authentification. Les requêtes authentifiées par utilisateur peuvent être décomptées de son allocation, les requêtes applicatives de celle de l’application. Les en-têtes x-rate-limit-limit, x-rate-limit-remaining et x-rate-limit-reset indiquent plafond applicable, capacité restante et horodatage de réinitialisation. Conserver endpoint et contexte avec ces valeurs: un en-tête de recherche n’est pas un budget de mentions.
Le diagnostic sépare donc quatre éléments: route demandée, contexte utilisé, réponse et en-têtes effectivement reçus, et conditions actuelles de facturation ou d’accès de l’application. Le tableau public de limites n’est pas un relevé de solde. Un quota restant ne prouve pas l’existence de crédits d’usage, et l’accès à un produit n’établit pas l’horizon d’un autre. Vérifier la réponse réelle et le compte développeur actuel au lieu de figer un grand tableau de quotas dans les hypothèses de l’application.
L’Accord développeur interdit de dépasser ou contourner les limitations API. Changer de compte, d’identité de navigateur ou de route n’est pas un remède à un droit épuisé ou indisponible. Attente, reprises bornées et planification de concurrence figurent dans limitation et concurrence; la tâche propre à X est d’abord d’identifier le périmètre de décompte applicable.
Aucun compte X réel, appel API, solde payant, accueil de navigateur ou résultat d’intégration n’a été utilisé ici. La matrice documentaire peut écarter une conception incompatible, mais seule une requête minimale correctement autorisée établit ce qu’une application reçoit actuellement. Même ce résultat ne décrit qu’une réponse sous ses conditions enregistrées, pas une disponibilité permanente, des archives exhaustives ou une mise en page stable. Autorisation, sens de la réponse et exhaustivité doivent rester des conclusions distinctes.
Questions fréquentes
«API de twitter scraping» désigne-t-il un seul endpoint?
Non. Publications d’auteur, mentions, accueil, recherche et affichage intégré ont des ensembles et contrats de sortie différents. Un enregistrement ressemblant à une publication ne rend pas une route interchangeable avec une autre.
La pagination passe-t-elle de la recherche récente aux archives complètes?
Non. Un next_token avance la requête choisie à l’intérieur du produit. Un besoin plus ancien nécessite une route d’archives prise en charge et une décision d’accès distincte.
Une réponse vide ou courte prouve-t-elle l’absence de publications anciennes?
Non. La requête décrit une route, un intervalle, un filtre et une autorisation. Épuiser ce périmètre ne prouve pas l’absence globale et ne justifie pas d’ignorer sa borne.
Le navigateur est-il nécessaire dès que l’API ne suffit pas?
Non. Un besoin d’historique, de champ ou de classement non pris en charge peut nécessiter une réduction ou une autre source permise. Le navigateur suit un rôle établi; il n’apporte pas l’autorisation manquante de la plateforme.
Sources
- Introduction X API
- Chronologies et bornes documentées
- Recherche récente et archives
- Champs et pagination
- Authentification
- OAuth 2.0 PKCE et jetons OAuth 1.0a
- API oEmbed
- Limites de requêtes
- Politique et Accord développeur
- Cohérence de l’automatisation BotBrowser
Conclusion pratique
Choisir le résultat X avant le navigateur: publications d’auteur, mentions, accueil chronologique, recherche bornée ou affichage intégré. Inscrire intervalle, ordre, champs et contexte d’autorisation auprès de la limite documentée de l’endpoint. Si cette combinaison ne répond pas au besoin, le réduire ou l’arrêter; sinon, effectuer une requête minimale permise et décrire sa portée réelle avant d’étendre la collecte.
Cet article fait partie du guide : Débuter avec l'automatisation du navigateur : carte initiale
Articles Connexes
Scraping avec Playwright : navigateur et profil
DémarrageScraping légal et conditions : ce qu’une équipe doit décider
DémarrageNavigateur de web scraping : quel type choisir ?
DémarrageScraping Instagram : vérifier l’accès API
DémarrageWeb scraping JavaScript : rendu, pagination, scroll
DémarrageProxy Puppeteer : authentification, SOCKS5 et signaux
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.