API de scraping web : ce que cache la réponse
Distinguez les corps HTTP, le HTML rendu et les champs extraits. Découvrez quels détails d’exécution une réponse d’API de scraping web établit, et lesquels restent inconnus.
BotBrowser Team
Vous voulez la documentation structurée pour Empreinte ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
Une API de scraping web peut renvoyer un JSON valide sans résoudre les informations demandées. La distinction manquante concerne l’artefact transmis à votre application et l’exécution qui l’a produit. Un corps HTTP, un document rendu et un prix extrait étayent des conclusions différentes. BotBrowser fournit des commandes documentées pour les profils de navigateur et les proxies lorsque vous exploitez son environnement d’exécution ; il ne peut pas configurer le navigateur d’un fournisseur d’API indépendant ni reconstituer des preuves d’exécution absentes de la réponse de ce fournisseur. Pour une intégration qui renvoie des résultats, la question utile est de savoir quelles preuves accompagnent chaque champ, et non si la réponse paraît complète.
Résumé
- La réussite d’une requête à l’API ne prouve ni que la destination a renvoyé le document attendu ni que ses données sont complètes.
- Les octets de la réponse d’origine et le HTML rendu par le navigateur sont des entrées d’analyse différentes, même si JavaScript n’a rien modifié.
- Un instantané de sortie peut être renvoyé après l’interruption d’une séquence d’actions. Examinez les résultats des actions au lieu de considérer le HTML comme une preuve d’achèvement du processus.
- Les champs renvoyés, les captures réseau et les captures d’écran conservent des preuves différentes. Aucun d’eux ne suffit à établir l’ensemble de l’environnement de navigateur ou de l’historique de traitement.
- Choisissez un contrat de sortie en fonction de l’affirmation que votre application doit valider. Traitez séparément l’autorisation de collecte, les données sensibles et leur conservation ultérieure, plutôt que de les confondre avec la réussite technique.
Sommaire
- La réponse comporte plusieurs seuils de réussite
- Les octets d’origine et le HTML rendu sont des entrées différentes
- Un instantané peut subsister après une séquence d’actions incomplète
- Un champ structuré possède un historique d’extraction
- La continuité de session n’est pas celle du navigateur
- Les preuves renvoyées ne décrivent pas tous les signaux exposés
- Un contrat de réponse explicite les inconnues
- Conclusion pratique
La réponse comporte plusieurs seuils de réussite
Le premier seuil est l’appel au service. L’authentification, la validation de la requête et la transmission d’un résultat relèvent de cette interaction avec l’API. Le deuxième est la réponse obtenue de la destination. Le troisième est l’interprétation, par votre application, de l’artefact transmis. Une réponse externe réussie ne fusionne pas ces seuils. Un service peut renvoyer correctement une page d’erreur, et un analyseur peut décoder correctement cette page sans trouver de fiche. Qualifier les trois résultats de « réussite » fait disparaître les informations nécessaires au diagnostic d’un jeu de données vide.
La documentation sur la gestion des erreurs de Zyte distingue explicitement le statut de son API de celui du site cible. Un 404 de la cible peut apparaître dans un résultat API réussi au moyen de statusCode. Il s’agit d’un contrat de réponse documenté, et non d’une propriété mesurée de façon indépendante pour chaque service de scraping. Une intégration faisant appel à un autre fournisseur doit repérer le champ équivalent et déterminer sa signification. Sinon, assimiler le 200 externe au 200 de la destination peut faire passer une page manquante pour une observation valide.
Le statut de la destination ne certifie pas non plus le contenu. Une application que vous possédez peut légitimement renvoyer avec 200 une page de connexion, une recherche vide ou un avis temporaire de service. L’application doit vérifier le type de document avant l’extraction des fiches. Ce contrôle peut rechercher un titre de catalogue connu ou la structure de fiche définie par l’application dans une fixture autorisée. Son objectif est de classer la représentation renvoyée, pas de décider si un site tiers autorise l’automatisation. L’autorisation dépend des permissions et conditions applicables, indépendamment de la réponse du serveur.
Les redirections introduisent une autre distinction. La référence HTTP de Zyte indique que les requêtes HTTP suivent les redirections par défaut et expose followRedirect pour modifier ce comportement. Sa référence sur le navigateur précise que les requêtes du navigateur suivent les redirections HTTP ainsi que les changements d’URL déclenchés par HTML ou JavaScript. L’URL fournie n’identifie donc pas nécessairement le document sérialisé à la fin. Conservez l’emplacement final lorsque le contrat le fournit et distinguez une observation de redirection d’une déduction fondée uniquement sur la chaîne de la requête initiale.
La présentation des interfaces de navigateur distingue la réception d’un artefact finalisé de la poursuite du pilotage d’un navigateur. Une fois une API d’artefacts choisie, la validation du résultat devient le seuil immédiat. Une équipe n’a pas besoin d’un classement des fournisseurs pour établir qu’elle a reçu le type de document attendu. Il lui faut une spécification qui identifie le statut de la destination, la représentation et les champs applicatifs nécessaires, avec un état explicitement inconnu lorsque la réponse ne fournit pas les preuves requises.
Les octets d’origine et le HTML rendu sont des entrées différentes
Zyte documente httpResponseBody comme un corps de réponse HTTP encodé en Base64 et obtenu sans rendu par navigateur. Base64 est une représentation de transport des octets, pas une déclaration de l’encodage de caractères du document. Le décodage de cette enveloppe restitue les octets d’origine ; leur interprétation en texte est une autre opération. La documentation HTTP recommande d’appliquer les règles d’encodage HTML et de tenir compte des en-têtes de réponse lorsque c’est pertinent. Un accent corrompu dans une fiche peut donc signaler un problème de décodage du texte plutôt qu’une fonctionnalité manquante du navigateur.
À l’inverse, browserHtml représente le DOM après rendu du navigateur. Des scripts peuvent avoir inséré, supprimé ou réorganisé des éléments, mais JavaScript n’est pas la seule cause de différences. La même référence explique que le HTML du navigateur comprend une normalisation HTML5. Un analyseur qui construit un arbre différent à partir de la réponse d’origine peut obtenir des résultats de sélecteurs différents, même sur une page sans mise à jour déclenchée par script. Dire que « les deux sont du HTML » ne suffit pas à rendre leur comportement d’analyse interchangeable. Une migration nécessite des fixtures d’entrée représentatives, et pas seulement des extensions de fichier inchangées.
Il existe aussi des limites de représentation. Zyte indique une limite de 10 MB pour le corps HTTP avant son encodage Base64 et une limite de 10 MB pour le HTML du navigateur ; les sorties plus longues sont tronquées. La compression HTTP ne modifie pas la première limite. Ces limites sont propres au fournisseur, et ne sont pas des propriétés générales du HTML ou de toutes les API. Si une fiche nécessaire se trouve après la portion tronquée, l’absence de résultat de l’analyseur ne prouve pas qu’elle était absente de la destination. La limite de sortie doit rester une explication distincte.
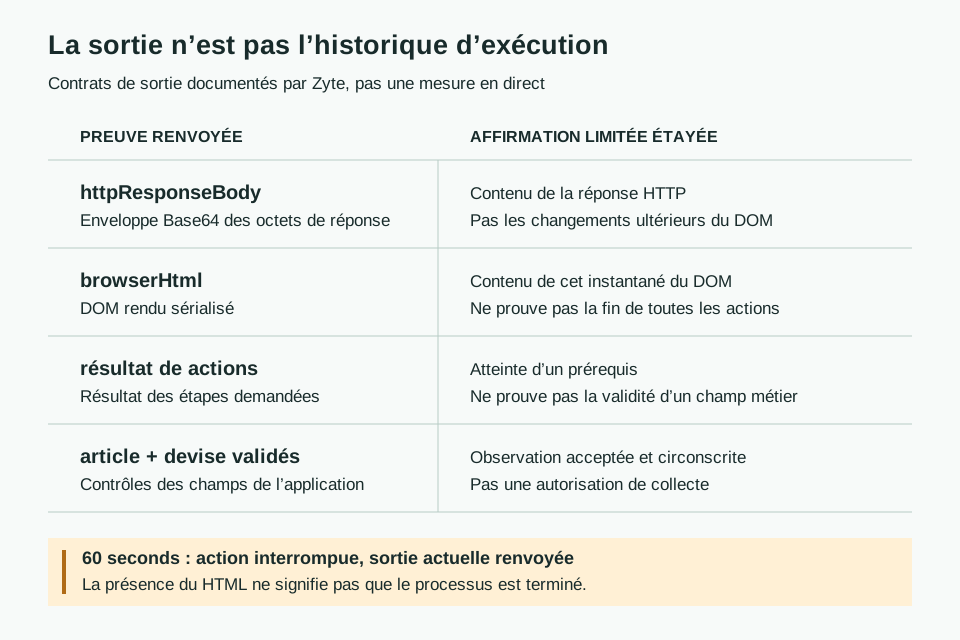
La sortie du navigateur présente également des exclusions structurelles. Zyte indique que le contenu des iframe est vide dans browserHtml par défaut, sauf si includeIframes est activé, et renvoie à un traitement distinct du contenu Shadow DOM. La sérialisation du document extérieur ne garantit donc pas que tous les composants visibles apparaissent dans la chaîne renvoyée. Une capture d’écran peut montrer un composant dont le texte manque dans cette sérialisation. Il s’agit de surfaces d’observation différentes, pas nécessairement de résultats contradictoires. Le consommateur doit savoir quelle surface son analyseur était censé utiliser.
Pour une fixture hypothétique d’un produit que vous possédez, conservez la réponse d’origine et le document rendu comme deux types de fixtures distincts. La première peut établir ce que le serveur a envoyé ; le second peut établir le DOM sérialisé à un instant donné. Après un passage de l’un à l’autre, une régression de sélecteur doit d’abord être examinée comme un changement du contrat d’entrée. L’analyse sur le scraping par navigateur sans interface traite des exigences d’exécution du navigateur ; elle ne supprime pas la nécessité d’identifier la représentation exacte remise à l’analyseur en aval.
Un instantané peut subsister après une séquence d’actions incomplète
Un service d’artefacts peut accepter une séquence ordonnée d’actions du navigateur et renvoyer une sortie après avoir tenté de les exécuter. Ce contrat n’équivaut pas à la remise d’un contrôleur de navigateur actif sans restrictions. La référence sur l’automatisation du navigateur de Zyte documente une limite totale de 60 seconds pour l’exécution du navigateur et de ces actions. Lorsque cette limite est atteinte, l’action en cours est interrompue, les actions suivantes ne sont pas exécutées et le HTML ou la capture d’écran demandés sont renvoyés tels qu’ils ont été rendus à cet instant. Un artefact peut donc être disponible alors que le processus n’est pas terminé.
Cela a une conséquence concrète pour les fiches en aval. Supposons qu’une fixture autorisée de catalogue ouvre d’abord une catégorie, attende ensuite un indicateur de devise, puis lise un article. Si l’attente est interrompue, le document renvoyé peut contenir la devise par défaut plutôt que celle demandée. L’analyseur peut tout de même produire un prix syntaxiquement valide. L’échec n’est pas nécessairement dû à un élément manquant ou à une erreur de transport de l’API ; une condition préalable peut ne pas avoir été remplie avant l’instantané. Le résultat du processus doit réunir l’issue de l’action et la preuve de la devise.
Zyte documente un champ de réponse actions qui contient des détails d’exécution, notamment les erreurs et les informations de durée. Ce champ doit être interprété selon son schéma documenté, plutôt que réduit à un simple booléen « HTML présent ». Une action qui n’a pas été exécutée après l’échéance se distingue d’une action exécutée dont le sélecteur n’a rien trouvé. Ces deux cas peuvent laisser derrière eux un document similaire. Un diagnostic utile identifie la première condition préalable de l’application qui n’a pas été remplie et conserve l’artefact renvoyé pour examen, conformément à la politique de conservation des données.
La même référence sur le navigateur distingue les actions par sélecteur des autres interfaces : les sélecteurs des actions ordinaires ne peuvent pas interagir avec le contenu des iframe ou du Shadow DOM de la même manière que les mécanismes dédiés. Un élément absent peut ainsi refléter le champ d’action pris en charge, et non une page lente. Augmenter arbitrairement le délai d’attente ne modifie pas ce champ. Avant d’incriminer le temps écoulé, comparez la surface d’action documentée à l’emplacement du composant requis. Il s’agit d’une vérification du contrat d’interface, pas d’une méthode d’accès à du contenu protégé.
Le moment de génération de la sortie fait donc partie de la signification des données. « Prix observé » devrait exiger l’identité de l’article concerné, la devise et la condition de disponibilité de l’application dans l’artefact qui a effectivement fourni le prix. Une capture d’écran provenant d’une autre étape ne peut pas ajouter discrètement le contexte manquant. Si le contrat de l’API n’expose pas suffisamment de preuves d’action, classez le résultat comme non résolu pour ce cas d’usage. Une affirmation plus limitée mais étayée est plus utile qu’une ligne apparemment complète dont les conditions préalables n’ont jamais été établies.
Un champ structuré possède un historique d’extraction
Certains services renvoient des fiches analysées au lieu de laisser tous les sélecteurs à la charge de l’appelant. La documentation sur l’extraction automatique de Zyte décrit l’extraction comme une autre capacité de sortie. Un champ structuré retire l’analyse du parcours immédiat du consommateur, mais introduit également un seuil d’interprétation. Le consommateur voit une valeur choisie ou normalisée par l’extracteur. À moins que la réponse ne fournisse la provenance pertinente, la valeur seule ne peut pas établir son texte d’origine, sa position dans le document ni son rapport avec une autre valeur visible.
Par exemple, un catalogue hypothétique contient un prix actuel, un ancien prix barré et un montant de mensualité. Ces trois valeurs peuvent être légitimes dans un même document. Un price renvoyé nécessite une définition du champ qui précise le rôle représenté. Le schéma en aval doit conserver la devise et l’identité de l’article avec la valeur, au lieu de supposer qu’elles pourront être reconstituées plus tard. Cet exemple concerne le contrat de données du consommateur ; il n’affirme pas comment un service nommé résout en interne ces valeurs concurrentes.
Le choix de la source compte également. La distinction entre HTTP et corps signifie qu’un extracteur lisant les octets de réponse peut recevoir un ensemble de valeurs candidates différent de celui d’un extracteur lisant le HTML rendu. Modifier la représentation d’entrée ou les paramètres d’extraction peut changer ce que mesure la série chronologique obtenue. Un champ normalisé peut rester bien formé tandis que son contexte de sélection change. Versionnez le contrat d’extraction du consommateur afin qu’un analyste puisse distinguer plus tard une évolution apparente du marché d’un changement dans la production des observations.
Les valeurs manquantes, vides et non vérifiées ne devraient pas être fusionnées en une seule valeur. Un champ manquant peut indiquer que l’extracteur ne l’a pas fourni. Une valeur explicitement vide peut décrire le document renvoyé. Une valeur non vérifiée peut être présente sans les preuves nécessaires à la décision du consommateur. Le schéma métier est responsable de ces distinctions, même si le fournisseur utilise une structure de réponse plus simple. Garder le résultat de validation à côté du résultat brut du fournisseur évite de faire silencieusement de chaque champ transmis un fait accepté.
Les captures d’écran et les réponses réseau capturées peuvent aider à éclaircir certaines questions, mais elles ne sont pas interchangeables avec la provenance d’un champ. Zyte décrit networkCapture comme une capture filtrée de réponses pendant le rendu du navigateur, y compris l’exécution d’actions. Le fait qu’un filtre capture une réponse pertinente ne prouve pas que toutes les requêtes ont été conservées. Une capture d’écran enregistre des pixels visibles, pas l’historique complet des requêtes. Choisissez des artefacts complémentaires pour éclaircir une ambiguïté précise et évitez de recueillir des données de compte sans rapport simplement parce que le service peut renvoyer davantage de données.
La continuité de session n’est pas celle du navigateur
L’étiquette de session d’un service peut décrire une garantie de continuité plus limitée que celle d’un navigateur persistant. La documentation des fonctionnalités partagées de Zyte décrit les fonctionnalités de session ; sa documentation CDP propose une interface distincte de navigateur actif. Les consommateurs doivent lire les règles de persistance pertinentes au lieu de déduire que des requêtes répétées s’exécutent dans le même moteur de rendu. Des cookies ou des conditions de routage partagés ne prouvent pas, à eux seuls, la persistance d’objets JavaScript en mémoire ou d’une page précédemment ouverte.
Cette distinction apparaît dans une fixture multiétape que vous possédez. Une préférence côté serveur représentée par un cookie peut persister tandis qu’une valeur temporaire conservée uniquement dans une variable de page disparaît. Les emplacements de stockage et leurs durées de vie sont différents. Si un processus exige de continuer dans la même page active, la capacité nécessaire est la continuité de page, et non la simple répétition d’un identifiant de session. Consignez cette exigence avant de choisir une interface. Une intégration pourrait sinon confondre une nouvelle page avec des cookies mémorisés et le même processus de navigation en cours.
L’identité réseau constitue une autre condition distincte. Un fournisseur peut documenter un comportement de routage associé à la session sans exposer la route réelle de chaque sous-ressource. Une chaîne d’agent utilisateur renvoyée ne prouve pas les propriétés de la connexion TLS, et un paramètre de région de l’API n’établit pas à lui seul la sortie observée par la destination. La réponse doit identifier les observations fournies et celles qui ne sont que des paramètres demandés. Si le cas d’usage concerne le trafic reçu par une application que vous possédez, ses propres journaux autorisés côté serveur peuvent apporter les preuves absentes de l’artefact renvoyé.
Les détails de cycle de vie propres aux fournisseurs ont déjà leur place dans l’analyse de la responsabilité avec Browserbase. Ses statuts terminaux et ses règles Context ne doivent pas être appliqués à un autre service sous prétexte que les deux offrent une exécution hébergée. La même prudence vaut pour les nouvelles tentatives : celles documentées pour une bibliothèque ne prouvent pas qu’un client HTTP quelconque ni toutes les requêtes de tous les backends suivent cette politique. Distinguez le comportement du fournisseur, celui du SDK et les décisions de votre ordonnanceur lorsque vous attribuez la responsabilité d’un travail répété.
Les preuves renvoyées ne décrivent pas tous les signaux exposés
Recevoir un document n’énumère pas tout ce que la destination a observé pendant sa production. Un navigateur peut exposer des propriétés lisibles par les scripts, tandis que la connexion réseau fournit d’autres informations. Une réponse d’API constitue un contrat de sortie, pas automatiquement un audit complet de ces expositions. Si elle contient browserHtml et une capture d’écran, mais aucun journal d’exécution attribué à une source, elle ne permet pas d’établir quel script a lu une API du navigateur. Une activité de rendu ordinaire et une activité d’automatisation ne doivent pas être rebaptisées preuves de collecte par un fournisseur.
La présentation du navigateur de BotBrowser documente les commandes des surfaces de navigateur liées aux profils, tandis que la configuration des proxies documente le routage de son propre environnement d’exécution. Ces commandes concernent un déploiement de navigateur que vous exploitez effectivement. Passer une option d’exécutable local à votre propre code d’automatisation ne peut pas modifier l’exécutable d’un fournisseur d’API distant, sauf si ce dernier prend explicitement en charge cette configuration. La séparation des couches reste importante même lorsque les deux intégrations emploient un vocabulaire familier d’automatisation.
L’examen de la confidentialité doit suivre le véritable parcours des données : l’URL demandée et l’état fourni entrent dans le service ; le fournisseur obtient ou rend le contenu ; des artefacts sélectionnés sont renvoyés ; votre application les stocke ou les exporte. Les cookies, le contenu des pages, les captures d’écran et les artefacts de débogage peuvent contenir des informations qui dépassent la fiche métier finale. Les conditions de conservation et de traitement pertinentes doivent couvrir explicitement ces artefacts. Supprimer un champ renvoyé ne prouve pas que le fournisseur n’a jamais traité sa source, tout comme refuser une capture d’écran n’établit pas une politique universelle de suppression.
Une fixture que vous possédez peut réduire l’exposition inutile pendant l’évaluation du contrat. Utilisez un contenu inoffensif et un état de portée limitée, puis vérifiez les artefacts requis et les résultats de validation. Cela n’établit ni l’anonymat, ni la conformité légale, ni l’acceptation par la destination. L’autorisation de collecte et la permission de transmettre du contenu à un sous-traitant restent des décisions séparées que ni un analyseur fonctionnel ni un profil de navigateur cohérent ne peuvent prendre à la place de l’opérateur.
Un contrat de réponse explicite les inconnues
Le tableau de décision ci-dessous concerne un catalogue hypothétique que vous possédez. Il associe chaque affirmation visée à un type de preuve requis. Il ne prescrit pas de requête à un fournisseur et ne rapporte pas une expérience exécutée. Le résultat attendu est une décision de validation : n’accepter l’affirmation limitée que si la preuve correspondante existe ; sinon, conserver un résultat non résolu. Le manque d’observabilité devient ainsi visible au lieu de devenir une cause supposée.
| Affirmation visée | Preuve requise | Ce qu’un artefact plus faible ne peut établir |
|---|---|---|
| Le serveur a fourni ces octets | Corps HTTP d’origine et en-têtes de réponse pertinents | Le HTML rendu peut inclure une normalisation du navigateur et des modifications ultérieures |
| Ce texte existait dans le DOM sérialisé | Instantané identifié du HTML du navigateur et contexte du document final | Les octets d’origine n’établissent pas le texte généré par un script |
| L’étape de sélection de devise s’est achevée | Résultat documenté de l’action et état de devise observé | La présence d’une capture d’écran ne certifie pas toutes les actions précédentes |
| Ce prix appartient au produit | Identité du produit, devise, rôle du champ et validation de l’application | Un champ numérique isolé ne distingue pas une mensualité du prix actuel |
| Le même processus de page s’est poursuivi | Cycle de vie documenté de la page active et preuves correspondantes du processus | Des cookies partagés ne prouvent pas la persistance du moteur de rendu ou de l’objet page |
| Un script donné a lu un signal | Événements d’exécution attribués à une source pour cette exécution | Le HTML, le nombre de requêtes et une étiquette de résultat n’identifient pas le lecteur |
Considérez trois cas synthétiques avec le même 200 externe. Dans le cas A, statusCode vaut 404 ; l’extraction de fiches n’est donc pas tentée. Dans le cas B, le HTML du navigateur contient un article, mais le résultat de l’action indique une interruption avant que la devise soit prête ; le prix reste non vérifié. Dans le cas C, la condition de l’action et les champs requis de l’article sont établis, de sorte que l’application peut accepter cette observation circonscrite. Ce sont des règles de validation proposées, et non des mesures de fiabilité du fournisseur ou des promesses sur le comportement d’une destination.
Ne conservez que les preuves nécessaires pour expliquer cette décision et reliez la fiche acceptée à sa provenance limitée. Si une limite de sortie, une iframe omise, un résultat d’action indisponible ou une exigence de persistance non prise en charge empêche la validation, consignez l’incertitude précise. Les contrats HTTP et de navigateur fournissent des distinctions concrètes qu’un champ générique « requête réussie » ne peut pas transmettre. Le consommateur peut alors rejeter ou mettre en quarantaine une fiche non résolue sans inventer d’explication pour l’exécution distante.
FAQ
Une réponse d’API avec le statut 200 signifie-t-elle que la page cible a réussi ?
Pas nécessairement. Le statut de transport de l’API et celui de la cible peuvent figurer dans des champs distincts. Le document cible nécessite également une validation propre à l’application.
Le HTML du navigateur est-il simplement le HTML d’origine après décodage ?
Non. Il représente le DOM du navigateur, avec la normalisation HTML et d’éventuelles modifications par script. Le décodage Base64 d’un corps HTTP restitue plutôt des octets.
Le HTML renvoyé prouve-t-il que toutes les actions demandées ont été exécutées ?
Non. Zyte documente des séquences d’actions interrompues qui renvoient malgré tout la sortie actuelle. Les résultats des actions et l’état requis de la page doivent être examinés séparément.
BotBrowser peut-il configurer le navigateur d’une API de scraping hébergée ?
Seule une intégration explicitement prise en charge par un fournisseur pourrait établir cette capacité. Les commandes de l’environnement d’exécution propre à BotBrowser ne configurent pas automatiquement un service distant indépendant.
Sources
- Zyte : Requêtes HTTP
- Zyte : Automatisation du navigateur
- Zyte : Extraction automatique
- Zyte : Gestion des erreurs
- Zyte : Fonctionnalités partagées
- Zyte : CDP
- BotBrowser : Présentation du navigateur
- BotBrowser : Configuration des proxies
Conclusion pratique
Choisissez la sortie d’une API de scraping web en fonction de l’affirmation que votre application doit vérifier : octets du serveur, texte rendu, action terminée ou fiche validée. Exigez les preuves correspondantes et conservez un état non résolu lorsqu’elles ne sont pas disponibles. Évaluez ce contrat avec des fixtures inoffensives et autorisées avant d’envoyer des données sensibles ou de vous appuyer sur les champs renvoyés pour des décisions opérationnelles.
Cet article fait partie du guide : Qu'est-ce qu'une empreinte de navigateur ?
Articles Connexes
Navigateur de web scraping : quel type choisir ?
DémarrageWeb scraping Browserbase : qui contrôle quoi ?
EmpreinteCorrectifs Rebrowser : une fois le proxy connecté
RéseauCloudflare et DataDome : réponses au scraping
DémarrageWeb scraping JavaScript : rendu, pagination, scroll
DémarrageScraping avec Selenium : capacités et relevés
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.