Web scraping JavaScript : rendu, pagination, scroll
Web scraping d'un site JavaScript sans donnée : sélecteur, requête XHR directe ou page à rendre, puis pagination et scroll avec une règle d'arrêt consignée.
BotBrowser Team
Vous voulez la documentation structurée pour Démarrage ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
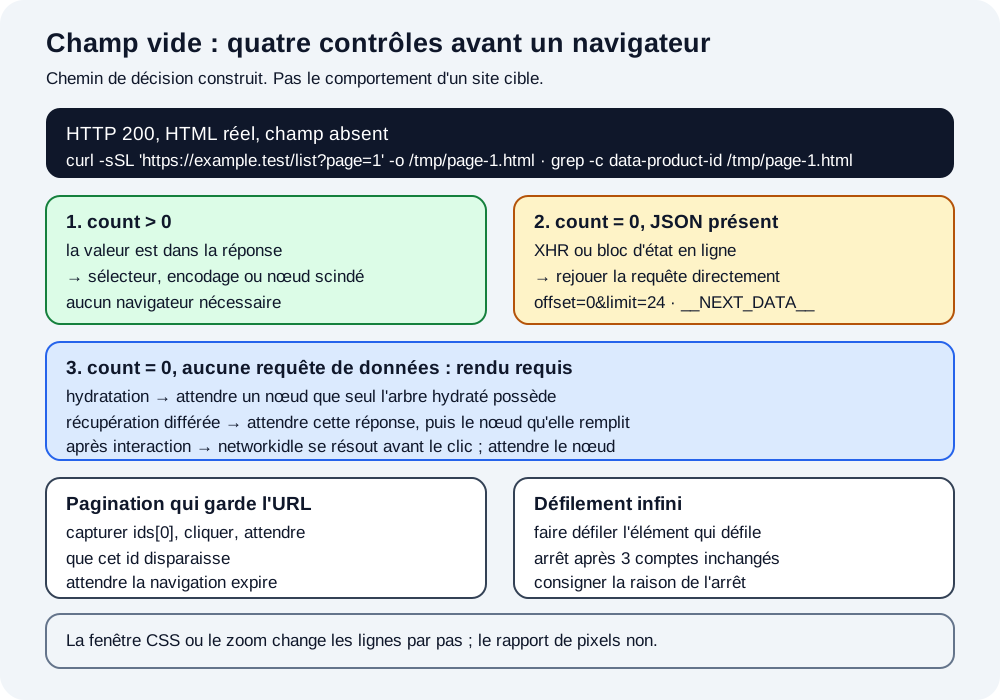
Le web scraping d'une page rendue par JavaScript commence souvent par les mêmes trois secondes de confusion : la requête a renvoyé HTTP 200, le HTML est bien réel, et le champ n'y figure pas. L'étape suivante utile n'est pas d'installer un navigateur headless, car une grande partie de ces cas se résout avec une requête que l'on peut envoyer soi-même, et un navigateur transforme une tâche rapide et stable en tâche lente. Le diagnostic suit un ordre, et c'est cet ordre qui structure la démarche. BotBrowser configure un environnement de rendu déclaré pour les cas qui ont réellement besoin d'un navigateur, afin que la mise en page calculée corresponde à celle attendue par la cible ; il ne garantit pas que le site renvoie d'autres données.
Résumé
- Lire la réponse brute avant de sortir un navigateur. Si
curlcontient déjà la valeur, le problème vient du sélecteur, pas du rendu. - Si la valeur est absente, chercher dans le journal réseau une requête JSON ou HTML qui la transporte ; appeler directement cette requête est généralement plus rapide, moins coûteux et plus stable que le rendu.
- Seul le troisième cas exige un navigateur, et il se divise en trois formes : une donnée qui apparaît après l'hydratation, une donnée récupérée par une requête que la page émet après le chargement, et une donnée qui n'apparaît qu'après une interaction. Un objet d'état sérialisé dans le HTML initial n'en fait pas partie, car il se lit sans navigateur.
- Pagination et défilement infini sont le même problème sous deux formes : le déclencheur n'est pas un changement d'URL, donc une boucle qui attend une navigation relira silencieusement la première page.
- S'arrêter sur un signal produit par la page, pas sur un nombre supposé. « Pas de bouton suivant » et « le conteneur a cessé de grandir » sont deux signaux différents et chacun peut être faux.
Sommaire
- Lire d'abord la réponse brute
- Trouver la requête qui transporte la donnée
- Quand le rendu est réellement nécessaire
- Pagination sans changement d'URL
- Défilement infini et sa règle d'arrêt
- Conclusion pratique
Lire d'abord la réponse brute
La première mesure coûte une commande et tranche la plupart des discussions. Récupérer la page avec la même URL et les mêmes en-têtes que ceux envoyés par le navigateur, puis chercher dans les octets la valeur attendue.
curl -sSL -H 'accept-language: en-US,en;q=0.9' 'https://example.test/list?page=1' -o /tmp/page-1.html
grep -c 'data-product-id' /tmp/page-1.html
Trois issues, trois tâches différentes. Un compte non nul signifie que la valeur est dans la réponse et que le parseur est en cause : bogue de sélecteur ou d'encodage, sans rapport avec le rendu. Zéro signifie que le serveur a envoyé une coquille vide, et l'étape suivante consiste à trouver ce qui la remplit. Un statut HTTP autre que 200 signifie ni l'un ni l'autre, et le corps de la réponse nomme généralement la raison.
Le même contrôle fonctionne en sens inverse pour un champ qui semble présent mais se parse mal. Une valeur arrivée échappée, encapsulée dans une chaîne JSON ou répartie sur deux nœuds adjacents passe un test de sous-chaîne naïf et échoue à un sélecteur strict, d'où l'importance du compte plutôt que de l'œil.
Trouver la requête qui transporte la donnée
Quand la coquille est vide, la valeur arrive généralement de deux endroits : une requête réseau que la page émet après le chargement, ou un objet d'état sérialisé dans le HTML initial. Les deux sont lisibles sans navigateur.
Pour le cas réseau, ouvrir la page une fois dans un navigateur ordinaire, filtrer le panneau réseau sur XHR ou fetch, et chercher une réponse dont le corps contient le champ. Copier cette requête en curl et la comparer avec la requête de la page. Les écarts sont généralement un en-tête, un cookie ou un paramètre de requête calculé à l'exécution, et chaque écart se teste.
import requests

session = requests.Session()
session.headers.update({"accept": "application/json", "accept-language": "en-US,en;q=0.9"})
listing = session.get("https://example.test/api/list?offset=0&limit=24", timeout=30)
listing.raise_for_status()
rows = listing.json()["items"]
print(len(rows), rows[0]["id"])
Pour le cas d'état, chercher dans le HTML brut une balise script qui porte un bloc JSON, souvent avec un identifiant comme __NEXT_DATA__, __NUXT__ ou un window.__STATE__ en ligne. Si le champ est dans ce bloc, la page a déjà livré la donnée et un parseur peut la lire directement.
Deux tests décident si la requête directe mérite d'être conservée. La rejouer deux fois et comparer le nombre d'octets, puis la rejouer depuis un autre emplacement réseau si la charge de travail l'exige. Une réponse qui change de forme entre deux requêtes identiques n'est pas une source stable, et une page rendue n'y remédierait pas non plus ; elle ne ferait que masquer l'instabilité derrière un pipeline plus lent.
Une quatrième issue mérite une phrase, car elle ressemble à une valeur manquante sans en être une. Certaines pages répondent différemment selon qui demande : la même URL renvoie un document complet à un navigateur qui présente un client plausible et une coquille à une requête qui n'en présente aucun. Ce n'est ni un problème de rendu ni un problème de sélecteur ; c'est une décision du serveur, et la différence observable est que le corps de la réponse change lui-même de forme au lieu de se remplir plus tard. Enregistrer la taille de la réponse et un court hachage du corps sur quelques requêtes suffit à distinguer ce cas d'une coquille qui se serait hydratée.
La distinction compte autant pour le coût que pour l'exactitude. Une tâche qui rejoue une requête JSON par page peut traiter des centaines de pages par minute sur une petite machine ; la même tâche via un navigateur passe l'essentiel de son temps au démarrage, à la navigation et au rendu. Choisir la voie navigateur pour un cas que la requête directe aurait résolu est l'erreur la plus coûteuse de toute cette démarche, et elle reste invisible parce que la version lente fonctionne aussi.
Quand le rendu est réellement nécessaire
Le troisième cas est réel, et c'est celui pour lequel un navigateur existe. Il se subdivise aussi en trois formes qui exigent des stratégies d'attente différentes, et choisir la mauvaise produit le classique « fonctionne en local, échoue en CI ».
| Forme | Où la donnée apparaît | Quoi attendre |
|---|---|---|
| Hydratation | Après le démarrage du framework, qui remplace la coquille | Un nœud que seul l'arbre hydraté contient |
| Récupération différée | Après une requête émise par la page après le chargement | La réponse de cette requête, puis le nœud qu'elle remplit |
| Déclenchée par interaction | Après un clic, un changement d'onglet ou de filtre | Le nœud que l'interaction est censée produire |
Attendre networkidle ne distingue pas du tout les formes. Playwright le définit comme l'absence de connexions réseau pendant au moins une demi-seconde, donc il se résout sur n'importe quelle page calme : une page déclenchée par interaction reste calme tant que personne n'interagit, et une récupération différée prévue pour se déclencher plus tard est elle aussi calme au début de l'attente. Sur un fixture qui programme sa requête après un court délai, l'attente s'est résolue avant que la requête n'existe et l'extraction a lu zéro ligne. Attendre un délai fixe couvre les trois sur une machine rapide et aucun sous charge, d'où le fait qu'un délai fixe soit la cause la plus fréquente d'un scraper qui passe la revue et échoue en production.
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    browser = p.chromium.launch(executable_path="/path/to/botbrowser/chrome")
    context = browser.new_context(locale="en-US", timezone_id="America/New_York")
    page = context.new_page()
    page.goto("https://example.test/list", wait_until="domcontentloaded")
    page.wait_for_selector("[data-product-id]", state="attached", timeout=30_000)
    rows = page.eval_on_selector_all(
        "[data-product-id]",
        "nodes => nodes.map(n => n.getAttribute('data-product-id'))",
    )
    print(len(rows), rows[:3])
    browser.close()
Le sélecteur de wait_for_selector doit être celui qu'utilise l'extraction. Une attente sur un conteneur générique réussit dès que la coquille existe, et l'extraction lit alors zéro ligne ; une attente sur l'attribut qui porte la valeur échoue bruyamment, ce qui est le résultat souhaité.
Une page rendue exige aussi une décision sur ce qu'il faut conserver. Le DOM après hydratation est plus volumineux que le HTML qui l'a produit, et une sauvegarde naïve de page.content() à chaque étape transforme une exécution de 40 pages en gigaoctets de balisage quasi identique. Conserver les lignes extraites plus un court enregistrement de provenance (URL, requête qui a produit la donnée, horodatage, mode de rendu) suffit à revérifier un résultat et coûte assez peu pour être gardé pour chaque page.
Cet enregistrement de provenance est aussi ce qui rend une régression diagnosticable. Quand un champ disparaît le mois suivant, la question est de savoir si la page a changé, si le rendu a changé ou si la requête a changé, et seul un enregistrement nommant les trois peut répondre. Une exécution qui ne stocke que les lignes extraites ne peut pas distinguer les trois, et la réaction habituelle est de tout re-rendre en espérant.
Pagination sans changement d'URL
Le cas du paramètre d'URL est le plus simple : incrémenter le paramètre, redemander, s'arrêter quand la réponse se répète ou que la liste d'éléments est vide. Les deux cas plus difficiles sont un curseur d'API et un bouton qui modifie le DOM sur place.
Pour un curseur, la requête suivante a besoin d'une valeur de la réponse précédente, donc la boucle doit porter un état plutôt que compter les pages. Une boucle qui incrémente page=2 sur un point d'accès à curseur renverra soit la première page, soit une erreur, et dans les deux cas cela ressemble à un échec de parsing plutôt qu'à un échec de pagination.
Pour un bouton, l'échec est inverse. L'URL ne change pas, donc une boucle qui attend un événement de navigation attend indéfiniment ou expire, et une boucle qui clique puis lit immédiatement obtient la page précédente. Le schéma fiable consiste à capturer une valeur de la page courante, cliquer, puis attendre que cette valeur disparaisse.
from playwright.sync_api import TimeoutError as PlaywrightTimeoutError

def read_ids(page):
    return page.eval_on_selector_all(
        "[data-product-id]",
        "n => n.map(x => x.getAttribute('data-product-id'))",
    )

def click_and_classify(page, previous_ids, timeout_ms=15_000, poll_ms=100, end_confirm_ms=3_000):
    """Click next, then return "changed" or "end-marker", or raise.

    "end-marker" is returned only when the page's own control reports the end and
    keeps reporting it for end_confirm_ms. A control that is disabled while the
    next page loads is not an end, and an unchanged list is not proof of an end,
    so anything else raises instead of returning a completion the page never gave.
    """
    button = page.query_selector("[data-testid=next-page]")
    if button is None or button.is_disabled():
        return "end-marker"
    button.click()
    budget = timeout_ms
    marker_for = 0
    while budget > 0:
        page.wait_for_timeout(poll_ms)
        budget -= poll_ms
        if read_ids(page) != previous_ids:
            return "changed"
        button = page.query_selector("[data-testid=next-page]")
        if button is None or button.is_disabled():
            marker_for += poll_ms
            if marker_for >= end_confirm_ms:
                return "end-marker"
        else:
            # Re-enabled without repainting: the next page is still loading.
            marker_for = 0
    raise PlaywrightTimeoutError(
        f"no list change and no end marker for {end_confirm_ms} ms within {timeout_ms} ms"
    )

seen = set()
reason = "loop guard"
for _ in range(200):
    ids = read_ids(page)
    new_ids = [i for i in ids if i not in seen]
    if not new_ids:
        reason = "no new ids"
        break
    seen.update(new_ids)
    if click_and_classify(page, ids) == "end-marker":
        reason = "end marker held"
        break
print(len(seen), reason)
La règle d’arrêt est la partie qui échoue discrètement. « Pas de bouton suivant » n’équivaut pas à « plus de résultats » : un bouton désactivé et un bouton absent se manifestent tous deux par un query_selector qui renvoie None ou par is_disabled() qui renvoie vrai, et les deux se ressemblent à moins que le motif ne soit consigné. Un conteneur à défilement infini qui garde un bouton suivant masqué bouclera indéfiniment, ce qui explique pourquoi la boucle a besoin d’une borne dure en plus d’un signal souple.
La classification est la partie facile à rater, et le piège est que l'inactivité se ressemble dans trois situations différentes : la liste s'est terminée, la page suivante est encore en cours de chargement, et le clic n'a pas été enregistré du tout. Une dernière page désactive souvent son propre bouton au lieu de rendre un nouvel ensemble, c'est pourquoi un contrôle désactivé est traité comme un marqueur de fin plutôt que comme une absence de changement ; mais une page qui désactive son contrôle pendant qu'elle récupère la page suivante produit le même état pendant toute la durée de la requête. La fenêtre de confirmation est ce qui les sépare, et elle doit être plus longue que le réaffichage le plus lent observé sur la tâche, pas plus longue que le plus rapide. Cette fenêtre est aussi la limite de la méthode et non un détail : un chargement plus lent que la fenêtre se lit encore comme une fin, et le correctif consiste à mesurer le réaffichage le plus lent sur la cible avant de choisir le nombre, au lieu de reprendre une valeur par défaut de la page de quelqu'un d'autre. Quand ni un réaffichage ni un marqueur maintenu n'apparaît, l'appel lève une exception, car une liste inchangée ne prouve pas que la liste s'est terminée, et une exécution qui rapporte un achèvement sur cette preuve se trompe dans la direction que personne ne remarque : elle paraît terminée.
Une autre forme de pagination revient assez souvent pour être nommée : une liste qui pagine par soumission de formulaire plutôt que par lien. L'URL peut changer, mais la page est repeinte à partir d'une réponse POST, donc une boucle qui suit les liens ne trouve rien à suivre. Le correctif suit le même principe que le cas du bouton : soumettre, puis attendre la disparition d'une valeur du jeu de résultats précédent, et consigner la requête qui a produit le nouveau.
Le tri interagit avec tout cela. Une liste triée sur un champ qui change pendant l'exécution, comme le prix ou la récence, peut se réordonner entre les pages, ce qui produit des doublons et des sauts même quand la logique de pagination est correcte. Enregistrer un identifiant stable par ligne et dédupliquer dessus transforme une exécution réordonnée en ensemble correct plutôt qu'en résultat plausible percé de trous.
Défilement infini et sa règle d'arrêt
Le défilement infini remplace le bouton par une sentinelle. Deux mécanismes le pilotent, et ils échouent différemment : un écouteur de défilement qui compare scrollTop à scrollHeight, et un IntersectionObserver qui se déclenche quand une sentinelle entre dans la fenêtre d'affichage. La version observateur livre toujours un rappel initial, donc une sentinelle hors écran signale une entrée non intersectante avec un ratio de 0, puis reste silencieuse jusqu'à ce que la sentinelle entre dans le root. C'est pourquoi un script qui fait défiler la fenêtre d'un nombre fixe de pixels peut ne rien charger sur une mise en page où c'est le conteneur qui défile, pas la fenêtre : l'observateur continue de signaler que la sentinelle n'est jamais entrée.
La boucle fiable fait défiler l'élément qui possède réellement le défilement, attend que le nombre d'éléments change, et s'arrête quand ce nombre reste inchangé pendant plusieurs tentatives consécutives.
stable_rounds = 0
last_count = page.eval_on_selector_all("[data-product-id]", "n => n.length")
while stable_rounds < 3:
    count = page.eval_on_selector_all("[data-product-id]", "n => n.length")
    if count == last_count:
        stable_rounds += 1
    else:
        stable_rounds = 0
        last_count = count
    page.eval_on_selector("[data-scroll-root]", "el => el.scrollBy(0, el.clientHeight * 2)")
    page.wait_for_timeout(600)
print("rows:", last_count, "stopped after", stable_rounds, "unchanged rounds")
Trois tours consécutifs inchangés relèvent d'une heuristique, pas d'une preuve, et l'enregistrement doit le dire. Un backend lent peut produire trois tours inchangés alors qu'un quatrième aurait chargé davantage, donc le compte appartient à la sortie, à côté de la raison d'arrêt.
La mémoire est la seconde limite. Une liste qui dépasse quelques milliers de lignes ralentit chaque eval_on_selector_all suivant, et la page peut commencer à écarter les nœuds hors écran, ce qui fait qu'une lecture ultérieure renvoie moins de lignes que la page n'en contient. Écrire chaque lot sur disque à son arrivée garde l'exécution bornée et rend un résultat partiel inspectable.
L'environnement de rendu change le contenu présent dans la fenêtre d'affichage, et cela compte pour exactement une des formes ci-dessus. Une liste chargée paresseusement déclenche son observateur quand une sentinelle entre dans la fenêtre d'affichage, donc une fenêtre plus petite que celle attendue par la cible charge moins à chaque défilement, et une fenêtre plus grande charge davantage. La mise en page est calculée en pixels CSS, donc le device pixel ratio seul ne change pas le nombre de lignes qui tiennent dans une fenêtre fixe ; ce qui change cet ajustement, c'est la taille de la fenêtre CSS, un niveau de zoom ou une échelle d'émulation d'appareil qui modifie la fenêtre de mise en page plutôt que seulement la densité de rastérisation. BotBrowser documente et fournit les dimensions d'écran et le device pixel ratio fournis par le profil parmi les valeurs qu'un profil porte, ce qui rend ces entrées déclarables plutôt qu'incidentes, et il ne décide pas si une page a besoin de rendu, et il ne fait pas renvoyer à une cible des données qu'elle retient.
C'est le seul endroit où « le scraper est cassé » et « l'environnement de rendu diffère » se ressemblent vus de l'extérieur. Une exécution qui s'arrête tôt sur une machine et se termine sur une autre, avec le même code et la même cible, relève généralement d'une différence de fenêtre CSS, de niveau de zoom ou de fenêtre de mise en page plutôt que d'une réponse de détection, et le moyen de le savoir est d'enregistrer ensemble la fenêtre et le nombre de lignes. Quand la fenêtre est identique et que les comptes diffèrent encore, l'explication restante est une cible qui se comporte autrement pour cette session, ce qui constitue une autre investigation.
Deux habitudes opérationnelles gardent une exécution rendue honnête dans le temps. La première est d'échouer sur une extraction à zéro ligne plutôt que d'écrire un fichier vide : une exécution qui produit un fichier avec des en-têtes et aucune ligne paraît réussie dans un tableau de bord, tandis qu'une exécution qui lève une erreur ressemble à un bogue. La seconde est de conserver une page enregistrée par exécution, sauvegardée avec son corps de réponse et ses lignes extraites, afin qu'un lecteur ultérieur puisse reproduire l'écart entre ce que le serveur a envoyé et ce que l'extraction a produit sans rejouer toute la tâche.
Aucune des deux habitudes n'exige un navigateur. Toutes deux gagnent en valeur quand un navigateur est dans le chemin, car l'écart entre la réponse et le DOM est la partie qui change sans aucune modification de code de votre côté. Une équipe qui enregistre la réponse brute, le mode de rendu et le nombre de lignes pour chaque page peut répondre à « est-ce la page qui a changé ou nous » d'une seule consultation, et une équipe qui n'enregistre que les lignes ne peut pas y répondre du tout.
Conclusion pratique
Diagnostiquer avant de rendre : lire la réponse brute, puis le journal réseau, et seulement ensuite ouvrir un navigateur. Quand le rendu est nécessaire, attendre le nœud qui porte la valeur plutôt que la coquille ou une horloge. Pour la pagination et le défilement, capturer une valeur de la page courante et attendre qu'elle change ou disparaisse, puis consigner la raison de l'arrêt pour qu'une exécution tronquée soit visible comme telle. Les critères de choix du navigateur expliquent comment comparer les candidats sur ces charges de travail, et le guide de planification du débit SERP couvre ce qui change quand la même boucle tourne à l'échelle.
Une dernière note sur la concurrence, car elle modifie la logique de pagination plus qu'on ne l'attend. Deux workers qui paginent la même liste voient chacun une fenêtre mouvante, et un point d'accès à curseur leur remettra des tranches qui se chevauchent ou sautent selon son implémentation. La pagination est une marche avec état sur une séquence qui peut changer sous la marche, donc les formes sûres sont un seul marcheur par séquence ou une requête partitionnée qui donne à chaque worker une tranche disjointe. Enregistrer quel worker a produit quelle page transforme un chevauchement en observation au lieu d'un mystère.
Sources
Cet article fait partie du guide : Débuter avec l'automatisation du navigateur : carte initiale
Articles Connexes
Scraping headless : ce qui change vraiment
DéploiementScraping d’offres d’emploi : limites du navigateur
DémarrageScraping avec Playwright : navigateur et profil
DéploiementScraping Indeed : champs, pages et doublons
DémarrageDébuter avec l'automatisation du navigateur : carte initiale
DémarrageNavigateur pour le web scraping : six critères
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.