Web scraping Browserbase : qui contrôle quoi ?
Distinguez statuts Browserbase, Contexts sauvegardés, routage réseau et éléments conservés des résultats et responsabilités de votre application de scraping.
BotBrowser Team
Vous voulez la documentation structurée pour Démarrage ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
Le web scraping avec Browserbase déplace l’exécution du navigateur chez un fournisseur, mais votre application peut rester responsable de la navigation, de l’extraction et de la validation des enregistrements. Les changements importants concernent la fin des sessions, l’état sauvegardé, l’emplacement réseau et les éléments conservés. BotBrowser documente des contrôles du navigateur fondés sur son moteur et ses profils, ainsi qu’une configuration de proxy pour une couche d’exécution choisie ; il ne peut pas configurer le stockage du fournisseur ou l’environnement d’exécution distant de Browserbase, ni garantir qu’un site autorise la collecte. La frontière utile consiste à déterminer quelle partie contrôle chaque réglage et quelles preuves établissent la fin du travail demandé. Valider l’artefact renvoyé est distinct du choix du cycle de vie hébergé ; voir ce qu’établit une réponse d’API de scraping.
Résumé
- Une session Browserbase
COMPLETEDne prouve pas qu’une tâche de scraping est terminée. Un plantage du client suivi d’une déconnexion peut produire ce statut. - Les sessions commencent avec des données utilisateur neuves par défaut. Un Context sauvegardé, sa politique d’écriture et la validité de l’authentification applicative sont des décisions distinctes.
- L’inactivité de connexion, la limite de durée de session et l’échéance de votre tâche sont des horloges différentes.
keepAlivepermet une reconnexion pendant la durée de vie restante de la session. - La région du navigateur et la sortie du proxy sont des propriétés réseau distinctes. La localisation du proxy relève du meilleur effort, pas d’une frontière nationale garantie.
- Les contrôles des journaux et des enregistrements ne suppriment pas tous les éléments. Les Contexts, transferts, métadonnées opérationnelles et traitements tiers exigent leur propre gestion.
Sommaire
- Le statut de session n’est pas le résultat de l’application
- Les Contexts sauvegardés ont un cycle de vie distinct
- L’inactivité de connexion n’est pas l’échéance de la tâche
- La région du navigateur ne détermine pas la sortie du proxy
- Les contrôles d’enregistrement ne couvrent pas tous les éléments
- Un environnement de test propre sépare les responsabilités
- Conclusion pratique
Le statut de session n’est pas le résultat de l’application
La documentation de gestion des sessions de Browserbase décrit une session passant de PENDING à RUNNING, puis atteignant COMPLETED, TIMED_OUT ou ERROR. Les statuts finaux ne peuvent plus changer. Ils décrivent la session du fournisseur, pas la production de l’enregistrement métier requis par votre analyseur. Un client peut récupérer le mauvais document, rejeter un enregistrement incomplet ou échouer avant d’écrire sa sortie tandis que le navigateur se termine normalement. Votre application a donc besoin de son propre état de résultat à côté du statut fournisseur, au lieu de déduire la réussite de l’étiquette du tableau de bord.
La distinction est particulièrement importante pour COMPLETED. Browserbase indique qu’un client se déconnectant sans maintien en activité termine normalement la session, y compris lorsque son script plante et se déconnecte. Libérer une session, terminer une Function ou arrêter une session avant son démarrage peut aussi produire COMPLETED. Même une session maintenue en activité atteignant sa limite de durée reçoit ce statut selon les règles documentées. L’étiquette identifie une voie de terminaison ; elle ne certifie ni la fin de l’extraction, ni l’exécution du nettoyage dans votre programme, ni l’existence du document demandé.
ERROR a une attribution plus étroite : Browserbase n’a pas pu démarrer la session ou une défaillance interne l’a terminée. Une exception de votre automatisation ne produit pas ce statut côté fournisseur. Un dossier d’incident doit donc conserver séparément l’exception client et la dernière étape applicative validée. Sans cette distinction, une équipe peut considérer à tort une exécution client échouée comme une infrastructure saine et la comptabiliser accidentellement comme une sortie utile. Inversement, un échec de validation applicative n’établit pas, à lui seul, une défaillance interne de Browserbase.
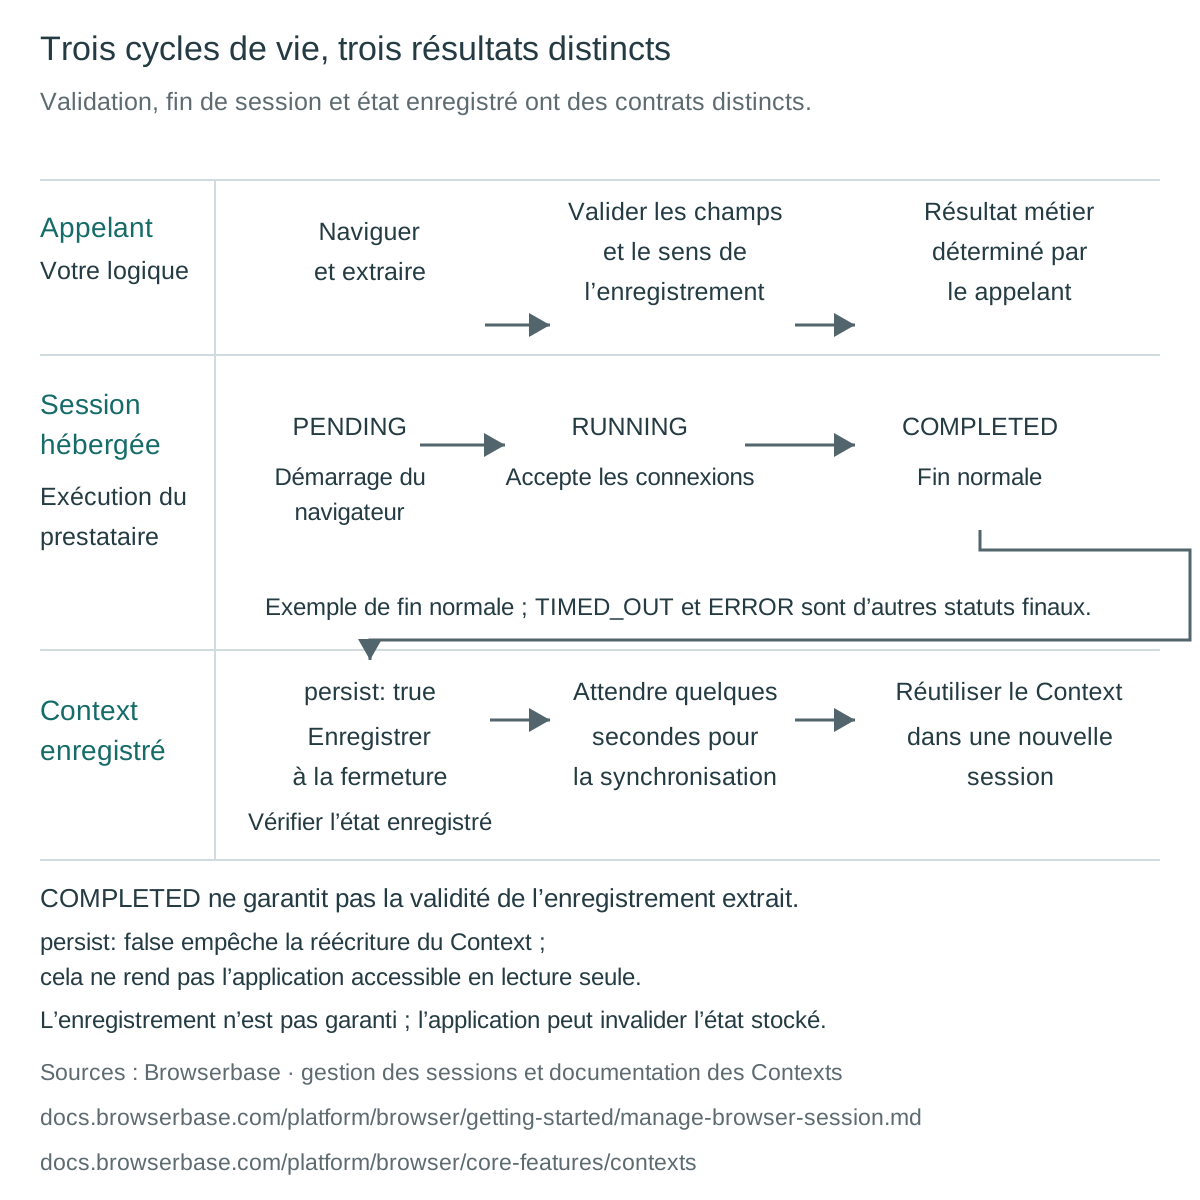
La comparaison des interfaces de navigateur distingue le contrôle continu du navigateur de la réception d’un résultat terminé. Une fois une interface de contrôle hébergée choisie, l’appelant doit toujours identifier son document final, valider les champs requis et consigner si la sortie a été définitivement enregistrée. Browserbase exploite la session distante ; cela ne transfère pas implicitement ces obligations applicatives. Un relevé de fin utile associe l’identifiant de session à un résultat client et à un motif de validation, sans copier de contenu sensible de la page dans les journaux opérationnels généraux.
Les Contexts sauvegardés ont un cycle de vie distinct
La documentation des Contexts de Browserbase indique que chaque session commence par défaut avec un nouveau répertoire de données utilisateur. Réutiliser un état applicatif exige un choix explicite de Context ; ce n’est pas une conséquence de la reconnexion au même compte fournisseur. Un Context possède une identité de ressource distincte. Une préférence absente dans une session neuve diffère donc d’un échec de restauration d’un Context sélectionné. Avant de diagnostiquer une perte d’état, établissez si la session prévue devait être neuve, consommer un état sauvegardé ou le mettre à jour.
Un Context peut conserver les cookies, localStorage, IndexedDB, le stockage de session, les service workers, les données de formulaire sauvegardées et les préférences du navigateur issues du répertoire de données utilisateur de Chromium. Browserbase distingue cet ensemble du cache HTTP du navigateur : les ressources ordinaires des pages sont récupérées à nouveau, même si les service workers conservés et leurs caches peuvent affecter les chargements ultérieurs. Ces différences comptent lorsqu’un responsable attend à la fois une préférence mémorisée et un comportement identique des ressources. Un « état de navigateur sauvegardé » ne promet ni un cycle de vie identique pour chaque mécanisme de stockage ni que toute réponse ultérieure provient du réseau.
La condition d’écriture est persist: true. Browserbase indique que les modifications sont sauvegardées à la fermeture de la session et demande d’attendre quelques secondes avant de réutiliser le Context afin de laisser la synchronisation se terminer. Un enregistrement extrait avant la fermeture et un Context prêt pour une autre session constituent donc des jalons distincts. L’application ne doit pas interpréter une extraction réussie comme la preuve que sa dernière modification de préférence est déjà devenue un état durable chez le fournisseur. La consigne d’attente impose un ordre, pas une garantie précise de latence de synchronisation.
persist: false empêche la réécriture des modifications dans le Context. Cela ne rend pas l’application cible accessible uniquement en lecture. Une session pourrait toujours soumettre une action applicative autorisée dont l’effet côté serveur subsiste, même si ses modifications locales du navigateur sont abandonnées. Cette distinction importe pour concevoir et examiner les tests : la politique d’écriture du Context du fournisseur contrôle une destination de stockage, pas toutes les conséquences de l’activité du navigateur. Un environnement de test réellement sans modification exige des restrictions applicatives en plus d’un choix approprié de persistance.
Selon la documentation, les Contexts subsistent indéfiniment, mais l’authentification stockée peut devenir invalide. Les cookies applicatifs peuvent expirer, les mots de passe changer, les jetons être révoqués ou le site invalider les sessions à distance. Browserbase donne 30 jours comme exemple d’expiration d’un cookie applicatif, pas comme durée universelle d’un Context. La suppression explicite d’un Context, la suppression du projet et les changements de compte affectent aussi son utilisation. Une connexion devenue obsolète exige donc un diagnostic de l’état applicatif, pas l’hypothèse qu’un stockage durable chez le fournisseur garantit une autorisation durable.
L’inactivité de connexion n’est pas l’échéance de la tâche
La référence de gestion décrit une expiration pour inactivité du WebSocket CDP après 10 minutes sans données dans aucun des deux sens. Les commandes envoyées par le client comptent, mais les événements CDP qui lui sont livrés aussi. Un client n’émettant aucune commande peut donc rester connecté au-delà de 10 minutes si des événements continuent d’arriver. « Mon code était inactif » et « la connexion ne transportait aucune donnée » sont des observations différentes. Aucune ne dit seule à l’opérateur si l’application progressait utilement ou recevait simplement une activité de page sans rapport avec la tâche.
La limite de durée de session constitue une autre frontière. Browserbase décrit une valeur par défaut du projet et une valeur propre à la session choisie à sa création. Sans maintien en activité, atteindre la limite de session produit TIMED_OUT. La voie documentée d’expiration d’une session maintenue en activité produit au contraire COMPLETED. Comparer ces étiquettes sans la configuration de session peut masquer le même événement sous-jacent d’épuisement de la durée. Le relevé d’intégration a besoin de la limite effective et du réglage de maintien en activité si l’équipe veut distinguer déconnexion précoce, fin naturelle et épuisement de la durée autorisée.
keepAlive: true signifie qu’une session déconnectée reste disponible pour une reconnexion jusqu’à sa limite de durée ou sa libération. Il ne prolonge pas cette limite à lui seul, ne renouvelle pas une connexion applicative et n’établit pas que l’appelant peut reprendre sa transaction métier en toute sécurité. Un programme qui se reconnecte peut rencontrer un état de page différent du dernier état consigné. L’application doit déterminer si la fin de sa dernière opération est connue avant de la répéter. La disponibilité du navigateur distant n’est pas un accusé de transaction de l’application que vous exploitez.
L’échéance de votre tâche relève du client ou de l’ordonnanceur. Elle peut arriver alors que le navigateur reste disponible, ou la session fournisseur peut se terminer avant la durée allouée à la tâche du client. Consignez ces événements indépendamment et définissez quel responsable libère les ressources restantes. La discussion de capacité des contextes de navigateur concerne les unités de charge et la responsabilité des ressources ; les sessions hébergées continuent de consommer de la capacité tant qu’elles restent actives. Un contrôleur déconnecté ne prouve pas que la ressource distante a été libérée, surtout lorsque le maintien en activité a été activé volontairement.
Cette séparation améliore aussi la classification des nouvelles tentatives. Une interruption de connexion, une limite de session atteinte et une échéance applicative peuvent exiger des décisions de récupération différentes. Un ordonnanceur ne doit pas qualifier les trois d’extraction vide et lancer un travail de remplacement identique. La documentation de gestion des sessions établit l’horloge fournisseur, tandis que l’application définit la progression et la fin. La reconnexion doit préserver cette distinction plutôt que traiter l’accès continu au navigateur comme la preuve que la tâche initiale reste valide.
La région du navigateur ne détermine pas la sortie du proxy
La documentation des régions de Browserbase énumère us-west-2, us-east-1, eu-central-1 et ap-southeast-1, avec us-west-2 par défaut. Le réglage region sélectionne le lieu d’exécution du navigateur. Il peut compter pour la connexion entre le contrôleur et le navigateur distant, mais ne déclare pas l’adresse IP vue par une application. Une étiquette de région ne suffit pas non plus à établir l’emplacement de chaque élément stocké ou de toute activité de traitement ultérieure.
La configuration des proxies est séparée. La référence des proxies indique que proxies vaut false par défaut. Activer l’option intégrée tente, au mieux des disponibilités, d’utiliser un proxy situé aux États-Unis ; des pays voisins comme le Canada peuvent être utilisés si les proxies américains appropriés ne sont pas disponibles. La localisation de proxy demandée relève également du meilleur effort, le proxy le plus proche étant utilisé lorsque l’emplacement demandé est indisponible. Un responsable ne peut transformer ces conditions en sortie garantie dans un pays précis simplement en consignant le réglage demandé.
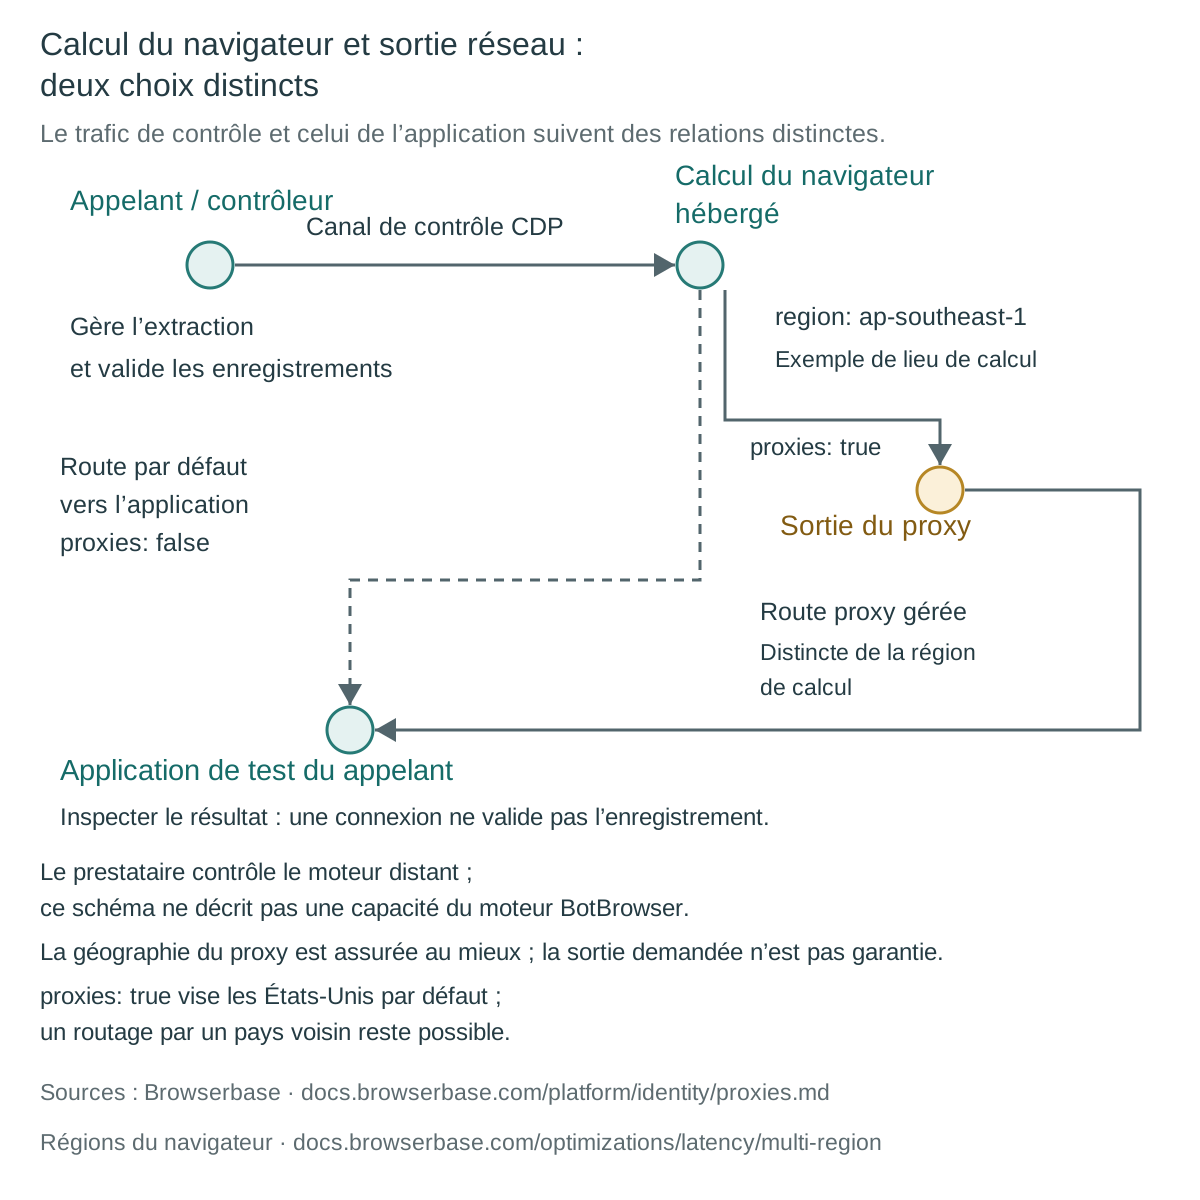
Pour un environnement de test propre sensible à la localisation, conservez la région demandée, la route demandée et les informations de connexion observées par l’application dans des champs séparés. L’observation peut établir ce que cet environnement a reçu pendant cette exécution, pas la géographie de toutes les requêtes ou du stockage. Browserbase documente aussi des règles de routage propres aux domaines ; la route d’une requête ne décrit donc pas nécessairement chaque destination. Lorsque la résidence des données ou les traitements ultérieurs sont une exigence contractuelle, une région de navigateur et une observation de géolocalisation ne remplacent pas l’accord fournisseur applicable.
La documentation de configuration de proxy de BotBrowser décrit des contrôles de routage et une configuration géographique fondée sur la sortie pour sa propre couche d’exécution du navigateur. Sa présentation du navigateur décrit des contrôles fondés sur des profils pour les propriétés exposées par le navigateur. Ce sont des capacités du produit, pas des réglages configurant l’environnement distant de Browserbase. La comparaison entre hébergement et exploitation propre traite du choix opérationnel ; ni cette comparaison ni une bibliothèque d’automatisation commune n’établissent que BotBrowser peut remplacer l’exécutable dans une session Browserbase.
Les contrôles d’enregistrement ne couvrent pas tous les éléments
La documentation d’observabilité de Browserbase indique que les sessions font l’objet de journaux et d’enregistrements par défaut. Elle décrit les événements CDP, la sortie de console du navigateur, les informations réseau et la relecture vidéo comme ressources de diagnostic. Ces éléments peuvent exposer davantage que l’enregistrement final extrait. La conservation documentée des relectures va jusqu’à 30 jours après la fin pour les projets sans BYOS et 24 heures pour les projets BYOS. Ces durées concernent les enregistrements vidéo, pas une expiration universelle des Contexts, des enregistrements applicatifs ou de chaque élément fournisseur.
À la création d’une session, logSession: false et recordSession: false excluent cette session de la journalisation et de l’enregistrement. Les deux valent true par défaut, et la documentation indique que ces choix fonctionnent avec toutes les offres. Désactiver l’un ou l’autre est définitif pour cette session : il ne peut être réactivé après son démarrage. L’observabilité devient ainsi une décision sur les données à la création, pas un interrupteur de nettoyage à utiliser après l’enregistrement de contenu sensible. Une relecture absente peut donc refléter la configuration prévue plutôt qu’un navigateur défaillant.
L’offre de compte Enterprise nommée Zero Data Retention est distincte de la disponibilité de ces paramètres individuels. La documentation ZDR limite cette offre aux formules Enterprise tout en décrivant séparément l’exclusion par session pour toutes les offres. Elle indique que les journaux et relectures ne sont pas conservés dans le stockage Browserbase avec la configuration couverte. Une organisation ayant besoin d’une confirmation écrite de ZDR pour son compte doit l’obtenir dans le cadre de son accord, plutôt que d’assimiler deux paramètres de création à toutes les caractéristiques contractuelles de l’arrangement Enterprise.
ZDR ne supprime pas intégralement toutes les données liées. Les téléchargements, téléversements, Contexts et extensions sont des types d’éléments distincts. La documentation décrit l’association de ZDR et BYOS pour placer ces éléments dans un stockage S3 contrôlé par le client. Les métadonnées opérationnelles restent présentes, notamment l’identité de session, les horaires et les informations de projet et de région. Live View continue pendant l’exécution du navigateur, car il diffuse la session au lieu de stocker une relecture. Les données envoyées à un LLM tiers relèvent des arrangements de ce fournisseur ; le contrôle du stockage Browserbase ne les couvre pas à lui seul.
Choisir une observabilité réduite modifie aussi la gestion des incidents. Browserbase indique que son assistance ne disposera pas des journaux et relectures de ces sessions, tandis que les points d’accès d’enregistrement peuvent renvoyer 404 Not Found et que l’API de journaux ne fournit aucune entrée. Les diagnostics appartenant à l’application exigent un substitut volontairement limité, tel qu’un résultat de validation et un marqueur d’étape, pas une duplication indiscriminée du contenu sensible. Le réglage fournisseur réduit la conservation spécifiée ; le client reste responsable de ses exports, de sa télémétrie locale et de tout traitement ultérieur qu’il déclenche.
Un environnement de test propre sépare les responsabilités
Considérons un environnement de test hypothétique d’un catalogue que vous exploitez, avec une préférence d’affichage inoffensive et un enregistrement contenant un identifiant d’article, un prix et une devise. C’est un scénario d’acceptation, pas un test Browserbase dont les résultats seraient rapportés. La condition de réussite de l’application est un enregistrement validé issu de cet environnement. Une condition d’état distincte vérifie si la préférence commence à neuf ou revient depuis le Context prévu. Une condition réseau distincte consigne la route observée par le serveur propre. Aucune ne dépend de l’interprétation de COMPLETED comme résultat métier.
| Symptôme hypothétique | Première distinction | Preuves à fournir par le responsable |
|---|---|---|
La session est COMPLETED, mais aucun enregistrement valide n’existe | Terminaison fournisseur contre résultat client | Exception client, étape de validation et enregistrement définitif de la sortie |
| Une préférence modifiée manque la fois suivante | Choix du Context, politique d’écriture et synchronisation | Context prévu, valeur de persist et ordre de fermeture |
| L’état sauvegardé ouvre une page déconnectée | Context durable contre authentification applicative valide | Validité de la session applicative et règles de révocation |
| La connexion distante disparaît | Inactivité CDP contre limite de session ou échéance de tâche | Activité de connexion, limite effective et événement de l’ordonnanceur |
| Le pays observé diffère de la région demandée | Emplacement du navigateur contre sortie du proxy | Route demandée et observation du serveur propre |
| La relecture est indisponible | Configuration délibérée de conservation contre échec de capture | Réglages de création et contrat d’observabilité applicable |
La condition d’acceptation de la persistance doit nommer la fermeture et l’attente de synchronisation documentée. Une exécution avec persist: true ne doit pas être considérée comme prête à être réutilisée simplement parce que le client a émis son enregistrement final. Une comparaison avec persist: false porte sur la réécriture des modifications, pas sur la possibilité de modifier le serveur de test. Garder la préférence inoffensive permet au responsable d’examiner ces distinctions sans importer un état de navigation sans rapport ni traiter l’authentification de production comme un matériau de test jetable.
Consignez uniquement ce qu’exige la décision : résultat de validation client, statut fournisseur, politique prévue du Context, limites effectives de durée et observation de route du dispositif de test. Ajoutez la politique d’enregistrement choisie pour expliquer une relecture absente. Les contrats de gestion des sessions et de ZDR donnent des significations différentes à ces relevés. Un futur test réussi établirait la compatibilité de cette configuration ; il n’établirait ni autorisation du site, ni fonctionnement anonyme, ni promesse concernant des sites sans rapport.
Questions fréquentes
COMPLETED signifie-t-il que la tâche de scraping a réussi ?
Non. Browserbase documente des voies de terminaison normales comprenant un plantage client suivi d’une déconnexion. L’application a besoin d’une validation indépendante des enregistrements et de preuves de finalisation de la sortie.
persist: false rend-il une session accessible uniquement en lecture ?
Il empêche la sauvegarde des modifications dans le Context sélectionné. Il n’empêche pas les actions du navigateur de modifier l’état côté serveur de l’application cible.
Le maintien en activité préserve-t-il la connexion à une application ?
Il préserve la disponibilité pour une reconnexion pendant la durée de vie restante de la session. L’authentification peut toujours expirer ou être révoquée par l’application, indépendamment de la disponibilité du navigateur.
Choisir une région de navigateur sélectionne-t-il le pays du proxy ?
Non. La région du navigateur et le routage proxy sont des réglages séparés. Browserbase documente une géographie de proxy au meilleur effort, avec un routage possible par un pays voisin, plutôt qu’un pays de sortie garanti.
Désactiver l’enregistrement supprime-t-il toutes les données détenues par le fournisseur ?
Non. Journaux, relectures, Contexts, téléversements, téléchargements, extensions et métadonnées opérationnelles ont des périmètres distincts. Le traitement par des LLM tiers reste lui aussi hors des contrôles de stockage Browserbase.
Sources
- Browserbase : gestion d’une session de navigateur
- Browserbase : Contexts
- Browserbase : régions de navigateur
- Browserbase : proxies
- Browserbase : observabilité
- Browserbase : conservation nulle des données
- BotBrowser : présentation du navigateur
- BotBrowser : configuration de proxy
Conclusion pratique
Attribuez des responsables distincts au résultat client, à la session fournisseur, au cycle de vie du Context, à la route réseau et aux éléments conservés. Avant d’adopter un parcours hébergé, vérifiez ces frontières avec un environnement de test propre autorisé et les conditions applicables du fournisseur. La configuration du navigateur peut régir ses surfaces documentées ; elle ne remplace ni la validation applicative, ni les décisions de stockage du fournisseur, ni l’autorisation de collecter les données.
Cet article fait partie du guide : Débuter avec l'automatisation du navigateur : carte initiale
Articles Connexes
Navigateur de web scraping : quel type choisir ?
EmpreinteAPI de scraping web : ce que cache la réponse
DémarrageScraping avec Playwright : navigateur et profil
DémarrageIntégrer un profil de navigateur avec Selenium
EmpreinteRebrowser Proxy : trajets, profils et confidentialité
DémarrageScraping avec Selenium : capacités et relevés
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.