FingerprintJS Pro : données et vie privée
Distinguez corrélation par workspace, IP pseudonymisée, historique et livraison chiffrée dans FingerprintJS Pro des contrôles du navigateur.
BotBrowser Team
Vous voulez la documentation structurée pour Empreinte ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
FingerprintJS Pro ne se résume pas au hash de FingerprintJS open source auquel on aurait ajouté des propriétés du navigateur. Le service commercial, actuellement documenté sous le nom Fingerprint Identification, traite les demandes au moyen d'un système client-serveur. Ses conséquences pour la vie privée dépendent du workspace, de la région de traitement, des informations retournées et des copies conservées par l'entreprise intégratrice. BotBrowser fournit des contrôles des surfaces du navigateur fondés sur des profils dans les chemins natifs ; il ne peut pas modifier les identifiants d'un autre service, effacer les exports du client ou déterminer une finalité licite de traitement.
La différence essentielle sépare la réduction d'un champ exposé de la fin de toute corrélation. Fingerprint documente un mode d'IP pseudonymisée dans lequel l'IP de réponse devient 0.0.0.0, alors que les identifiants de visiteur existants peuvent subsister. Il décrit aussi des identifiants différents pour des clients distincts, mais une identification commune entre plusieurs domaines contrôlés par une entreprise. Aucune de ces affirmations ne signifie que toutes les observations deviennent impossibles à relier. La limite pertinente tient à la configuration et à la finalité déclarée, pas seulement au nom d'hôte dans la barre d'adresse.
Résumé
- Identification commercial repose sur un service sous-traitant. L'empreinte calculée localement par la bibliothèque OSS n'en décrit pas tout le parcours de données.
- Les identifiants de visiteur sont délimités par workspace. Plusieurs domaines d'une entreprise peuvent partager ce périmètre ; des clients distincts reçoivent des identifiants distincts.
- La pseudonymisation modifie les informations IP stockées et retournées et limite plusieurs produits. Elle ne réinitialise pas nécessairement les identifiants existants.
- Les durées publiées de 7, 30 et 90 jours décrivent des fenêtres de consultation. Les copies reçues par webhook ont un cycle de vie distinct.
- Sealed Client Results chiffre la livraison via le client jusqu'au backend. Cela ne signifie pas que le sous-traitant ou le backend ne traite jamais l'événement.
Sommaire
- Traitement commercial et empreinte OSS
- Périmètre du workspace entre domaines contrôlés
- Pseudonymisation IP et corrélation conservée
- Choix de région et garde des données
- Consultation de l'historique et copies en aval
- Livraison chiffrée et visibilité côté client
- Contrôles du navigateur et limites du service
- Conclusion pratique
Traitement commercial et empreinte OSS
La documentation de confidentialité de Fingerprint distingue la bibliothèque ouverte de l'API commerciale client-serveur. Cette distinction change la première question d'une évaluation. Pour une bibliothèque locale, un ingénieur peut examiner les données collectées par une révision précise et la manière dont elle produit une empreinte. Pour un service, il faut aussi connaître le destinataire, le périmètre de l'identifiant, la configuration du compte, la livraison des réponses et le stockage du client. Un nom de paquet ne répond pas à ces questions.
L'analyse existante de FingerprintJS OSS porte sur les états des composants, l'ordre des sources et la provenance du calcul différé à un commit fixé. Ces faits n'établissent ni l'implémentation ni le traitement des données du produit commercial. Une valeur dérivée localement et un résultat retourné à distance peuvent notamment avoir des historiques différents, même si les deux sont appelés empreintes. Les confondre efface la frontière du service avant même le début de l'évaluation.
Fingerprint décrit le site intégrateur comme responsable du traitement et son propre service comme sous-traitant. Ce sont les rôles déclarés dans son modèle documenté, pas une conclusion sur chaque déploiement. Le site décide pourquoi demander une identification et comment utiliser la réponse. Le sous-traitant reçoit et traite les informations pour fournir le service. L'entreprise doit encore évaluer sa finalité, sa configuration, ses contrats et ses obligations ; une déclaration de conformité du produit ne décide pas de ces questions à sa place. L’analyse de confidentialité de hCaptcha distingue également fournisseur, intégrateur et utilisateur selon leur politique ; ces conditions ne sont pas le contrat Identification.
La même page de confidentialité et de conformité distingue attribution et personnalisation de prévention de la fraude et de sécurité. Elle donne des indications sur le consentement et l'intérêt légitime, sans constituer une autorisation universelle de collecte. La conséquence technique est plus précise : le moment de l'identification et sa finalité doivent être explicites. Une intégration de sécurité et une autre d'attribution des achats ne devraient pas reprendre silencieusement leurs hypothèses de collecte au seul motif qu'elles utilisent le même logiciel.
Selon cette documentation, l'agent JavaScript ne stocke cookies et autres métadonnées dans le navigateur que pendant la demande d'identification. Charger l'agent et demander une identification méritent donc deux entrées dans le descriptif des flux. La documentation permet un déclenchement explicite dans les circonstances appropriées, plutôt que de supposer que chaque chargement de page doit produire un événement. Il s'agit d'un choix de collecte de l'application, non d'un réglage de confidentialité déductible de l'installation d'un paquet.
Une analyse utile distingue au moins trois enregistrements : la décision de demander une identification, l'événement du service et l'utilisation ultérieure du résultat par l'application. Ils sont liés sans être identiques. Un enregistrement applicatif peut survivre à la demande initiale. Une réponse peut influencer une décision sans être conservée comme copie complète de l'événement. Cette distinction permet de demander quelles données sont nécessaires à une finalité précise, au lieu de considérer l'intégration comme une opération indivisible.
La documentation sur les régions et la conservation décrit la configuration du service ; celle des résultats scellés explique une option de livraison. Aucune ne prouve qu'un navigateur précis a exécuté une API précise. Aucun journal d'événements V8 attribuable à une source n'est présenté ici. Une réponse réseau ou une ancienne correspondance de champs ne peut établir quelles interfaces l'agent commercial actuel a lues, dans quel frame ou à quelle étape.
Cette limite de preuve laisse intacte la décision centrale de confidentialité. Une entreprise peut comparer les périmètres de workspace, les copies conservées et les options documentées sans reconstruire un collecteur propriétaire. À l'inverse, une trace d'API en exécution ne prouverait pas à elle seule comment le sous-traitant stocke ou supprime les données. L'observation du navigateur et la gouvernance du service répondent à des questions différentes. Elles peuvent se rejoindre, mais ne doivent pas se remplacer lorsque la preuve requise manque.
Périmètre du workspace entre domaines contrôlés
Fingerprint indique que les identifiants de visiteur sont propres au workspace, plutôt que partagés universellement entre ses clients. Deux clients identifiant le même navigateur ou appareil recevraient des identifiants différents. C'est une limite documentée significative pour une catégorie de corrélation. Ce n'est pas une promesse qu'une entreprise ne peut pas relier l'activité de ses propriétés, ni une description de ses associations avec ses propres données de compte.
La même source autorise explicitement l'identification entre plusieurs domaines contrôlés par une entreprise. La condition indiquée est l'emploi d'une clé publique d'API issue du même workspace. Frontière d'origine et frontière de workspace répondent donc à des questions différentes. Deux sites peuvent avoir des origines distinctes tout en participant au même périmètre documenté. Un avis de confidentialité limité au domaine courant peut omettre cette relation organisationnelle, même lorsque l'intégration fonctionne conformément à sa configuration.
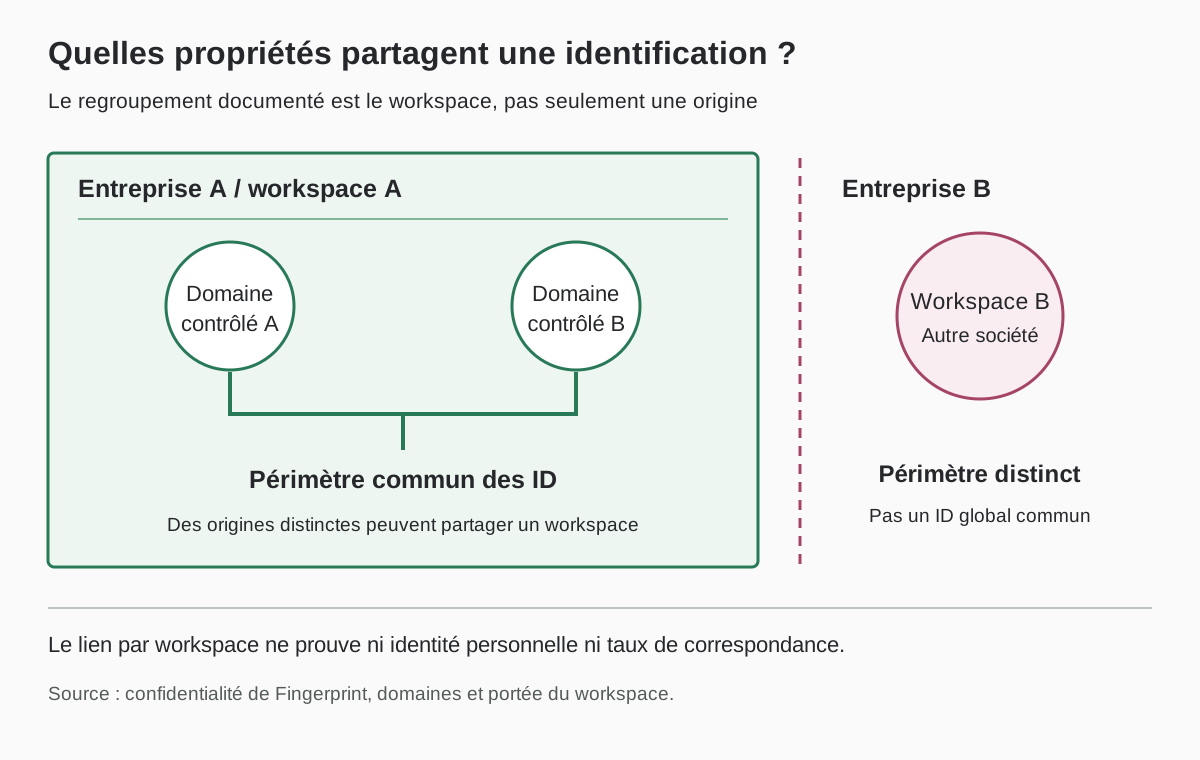
Le schéma représente le modèle de contrôle déclaré par le fournisseur, pas un taux de correspondance mesuré. Les domaines du même workspace indiquent une association permise entre propriétés contrôlées. Le workspace séparé indique la limite documentée entre clients.
Pour une entreprise disposant d'un site public et d'une application, ce partage peut servir une finalité d'attribution explicitement choisie. Une autre peut préférer séparer des contextes de produit indépendants pour respecter ses objectifs de minimisation. Ce sont des choix de finalité et d'architecture, pas des instructions pour modifier un résultat de détection. L'explication interdomaines établit que l'association est prise en charge, non que toute combinaison soit appropriée ou juridiquement justifiée.
Il faut également distinguer le workspace d'une personne. La documentation parle de navigateurs et d'appareils. L'application peut conserver séparément des comptes, achats ou dossiers de support. Si elle associe un événement à ces enregistrements, l'exposition comprend cette association applicative et pas uniquement le champ d'identifiant. Qualifier le résultat initial de pseudonyme ne décrit pas tout ce que la base du client peut en savoir après cette association.
La différence générale entre signature du navigateur et personne figure dans les empreintes du navigateur et Canvas Fingerprinting. S'ajoute ici la portée organisationnelle. Qui exploite chaque domaine ? Quel workspace utilise chaque intégration ? Quelle finalité autorise le rapprochement des événements ? Ces réponses dessinent une frontière plus utile que l'affirmation selon laquelle un identifiant serait simplement de première partie ou créé sans cookie tiers.
La documentation de confidentialité indique que le service ne convient pas à un graphe global entre sites indépendants, car les clients reçoivent des identifiants différents. Cette réserve doit rester visible. Un identifiant global partagé entre clients et l'identifiant interdomaines d'une entreprise ne désignent pas le même arrangement. Nier le premier ne nie pas le second. L'existence du second ne prouve pas non plus que des clients indépendants reçoivent un ID commun ou partagent un historique.
L'inventaire d'intégration devrait donc indiquer les origines et les relations de workspace qui les relient. C'est particulièrement utile lorsqu'une équipe maintient le site public et une autre l'application authentifiée. Chacune peut décrire correctement son frontend tout en oubliant une configuration commune du service. La documentation justifie cette vérification ; seule la configuration réelle peut établir si la relation existe dans le déploiement concerné.
Pseudonymisation IP et corrélation conservée
La documentation de l'IP pseudonymisée décrit un choix entre traitement ordinaire et représentation alternative. Dans le mode ordinaire, Fingerprint dit stocker en clair l'adresse IP de l'événement et l'utiliser pour l'identification. Dans l'autre mode, l'IP est combinée à des métadonnées puis convertie cryptographiquement avant utilisation par les algorithmes. Ce sont des descriptions du modèle du fournisseur, pas des observations indépendantes de son infrastructure.
La différence de réponse est concrète : le mode ordinaire expose l'IP originale, le mode pseudonymisé retourne 0.0.0.0. Cette valeur représente un champ de réponse, pas une nouvelle adresse réseau du navigateur. Elle ne signifie ni que la demande part d'une adresse nulle ni qu'aucune infrastructure n'a traité une connexion réelle. Confondre le champ affiché et la connexion convertirait une option de traitement en affirmation de transport non étayée.
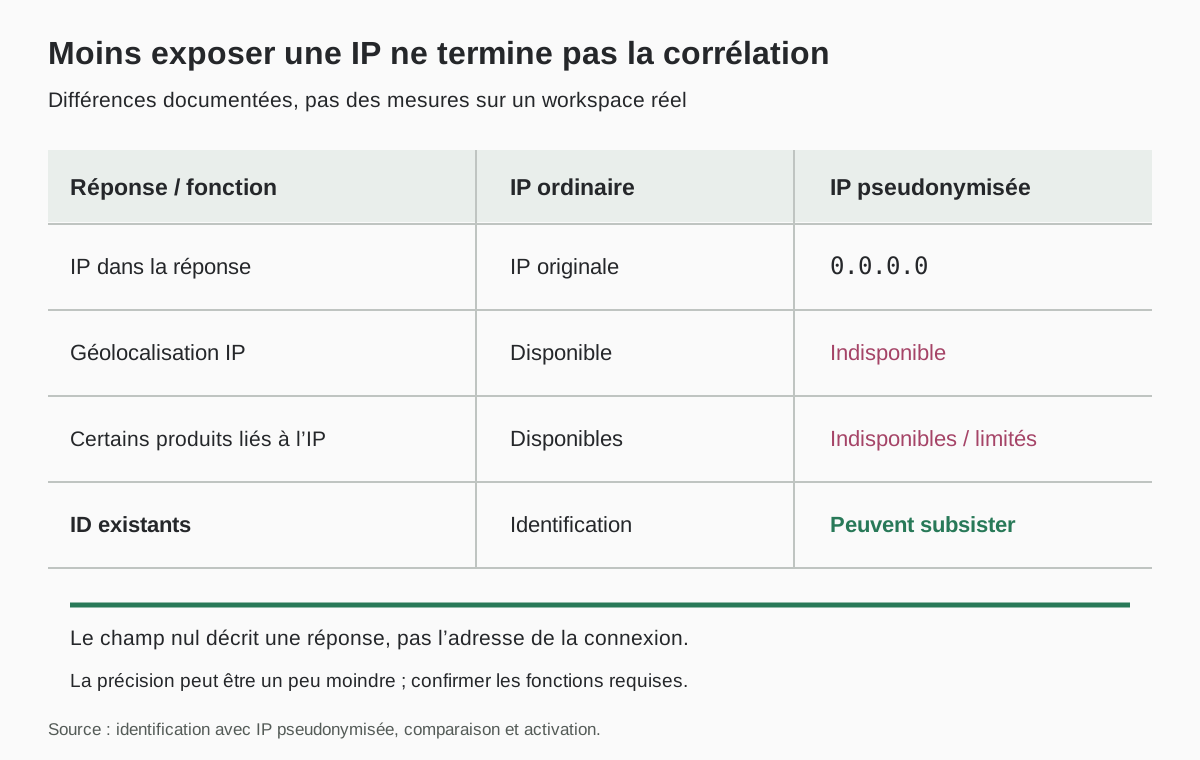
Le tableau comparatif décrit des compromis fonctionnels. La géolocalisation IP devient indisponible, tout comme plusieurs Smart Signals dépendant de l'IP. La détection de bots dans le navigateur a une disponibilité limitée. La question n'est donc pas de faire disparaître un champ sans conséquence. Il faut déterminer si l'application a besoin de ces résultats pour sa finalité et si réduire l'exposition de l'IP justifie les limitations documentées.
La section d'activation apporte la réserve essentielle : le workspace existant peut rester et les utilisateurs peuvent continuer à recevoir le même identifiant de visiteur. Une application qui cesse seulement d'enregistrer une IP visible ne cesse pas nécessairement de relier les visites par un autre identifiant. Cela ne rend pas la pseudonymisation inutile. L'amélioration doit être décrite au niveau du champ et du traitement modifiés, sans devenir une promesse d'absence complète de liens.
La même source nuance aussi la précision. L'introduction présente favorablement l'alternative, alors que la section d'activation indique une précision possiblement légèrement inférieure au mode standard. Une décision d'achat ou d'implémentation doit préserver cette réserve précise. Sans pourcentage ni comparaison contrôlée, ni l'amplitude du changement ni une précision inchangée ne peuvent être affirmées pour le trafic d'une entreprise particulière.
| Besoin de l'application | Conséquence documentée | Limite de décision |
|---|---|---|
| Ne pas exposer l'IP originale dans la réponse | Le mode pseudonymisé retourne 0.0.0.0 | Évaluer les autres champs et copies du client |
| Utiliser la géolocalisation IP du service | Indisponible dans ce mode | Déterminer si la finalité exige cette fonction |
| Conserver la continuité d'identification | Les identifiants existants peuvent subsister | Ne pas présenter le changement comme une remise à zéro |
| Conserver tous les produits dépendant de l'IP | Plusieurs deviennent indisponibles ou limités | Confirmer le produit nécessaire auprès du fournisseur |
Le tableau aide à choisir à partir des différences documentées ; il ne mesure pas un workspace configuré. La première ligne concerne la divulgation dans une réponse, la troisième la continuité d'un autre identifiant. Les séparer évite une erreur fréquente : considérer que le retrait d'un champ reconnaissable prouve que tous les autres enregistrements ont perdu leur valeur de rapprochement. La continuité annoncée par le service contredit directement cette déduction.
Le client doit aussi séparer la représentation convertie par le sous-traitant de ses propres données. Si l'application enregistre ailleurs des adresses réseau ou des événements de compte, changer une option du service ne réécrit pas ces enregistrements indépendants. La source décrit Identification, pas tous les serveurs de l'architecture cliente. La question pertinente porte sur les copies et associations qui changent, et celles qui restent parce qu'une autre partie du système les produit.
Choix de région et garde des données
La documentation des régions énumère Global en Northern Virginia, EU à Frankfurt et Asia à Mumbai. US est la région par défaut. Elle indique aussi que la région du workspace ne peut plus être modifiée ensuite. C'est donc un choix initial aux conséquences durables, pas une préférence visuelle supposée suivre la position du visiteur ou l'adresse postale de l'entreprise.
Un nom de région identifie la configuration décrite par le fournisseur. Il ne faut pas le confondre avec le système cible d'un profil, la sortie d'un proxy ou la langue d'une interface. Ces propriétés peuvent affecter une session sans changer le lieu où le sous-traitant déclare conserver les données. Une page en langue européenne ne prouve pas un workspace EU. Une connexion par proxy régional ne prouve pas le déplacement d'un workspace existant.
Fingerprint affirme que les données ne quittent pas la région choisie. C'est son engagement déclaré de résidence pour le service. Il ne situe pas l'entrepôt analytique, les journaux du backend ou les copies webhook de l'entreprise intégratrice. Si elle reçoit puis stocke un événement ailleurs, le parcours comprend une destination supplémentaire contrôlée par le client. La cartographie complète doit montrer région du sous-traitant et lieux de réception ou conservation choisis par le client.
Pour une région non standard, la documentation demande de la préciser dans l'agent JavaScript et d'utiliser l'URL de base correspondante du Server API. Ce sont deux configurations liées au même choix. Un frontend et un backend gérés par des équipes différentes peuvent nécessiter une coordination. L'exigence documentée est utile à l'inventaire ; elle ne démontre pas qu'une configuration incohérente s'est produite et ne prédit pas l'erreur d'un déploiement précis.
La page de confidentialité place les décisions de l'entreprise à côté des obligations du sous-traitant. La région est donc nécessaire, mais insuffisante pour l'évaluation complète. L'équipe doit encore connaître la finalité, les propriétés reliées au workspace, les réponses conservées et les personnes ou services autorisés à les consulter. Choisir une région nommée ne répond automatiquement à aucune de ces questions.
Prenons une entreprise qui choisit EU et envoie les événements reçus vers un système de rapports qu'elle exploite séparément. L'engagement régional du fournisseur décrit son côté du service. Le système de rapports ajoute une décision cliente à évaluer indépendamment. Cet exemple n'affirme ni transfert précis ni résultat juridique ; il montre pourquoi la région du sous-traitant et la destination en aval doivent figurer sur deux lignes distinctes plutôt que sous une seule étiquette régionale.
Les sections de conservation et de suppression ajoutent une frontière indépendante. Une destination indique où un enregistrement est traité ou gardé. Une fenêtre de consultation décrit l'ancienneté accessible dans une interface. Une procédure de suppression concerne son retrait. Aucune ne remplace les deux autres. Connaître la région ne démontre pas la durée de vie de chaque copie ; connaître une fenêtre ne situe pas les exports du client.
Le choix régional doit précéder les hypothèses de déplacement. La source qualifie explicitement ce choix d'immuable, sans fournir dans cette phrase une promesse générale de migration. Une entreprise ayant besoin d'un autre dispositif doit confirmer la procédure prise en charge et ses conséquences auprès du fournisseur. Modifier un réglage du navigateur, un argument régional ou un nom d'hôte ne suffit pas à établir un changement de l'engagement du workspace existant. L'évaluation doit porter sur l'accord réel.
Consultation de l'historique et copies en aval
Le titre de la section de conservation est large, mais le texte et le tableau définissent une capacité précise : l'ancienneté consultable dans Dashboard et Server API. Les fenêtres publiées sont de 7 jours pour Free, 30 pour les offres payantes en libre-service, et 90 ou davantage pour Enterprise selon contrat. Toute citation doit conserver l'interface et l'offre auxquelles ces chiffres s'appliquent.
Accès et effacement sont deux événements différents. Un enregistrement absent d'une interface ne prouve pas, à lui seul, l'effacement de toutes les copies sous-jacentes ou en aval. Le tableau ne prouve pas non plus une conservation indéfinie. Il établit la disponibilité annoncée. Les questions de suppression effective demandent l'accord applicable, la procédure prise en charge et des preuves adaptées, non une extrapolation à partir d'une limite de consultation.
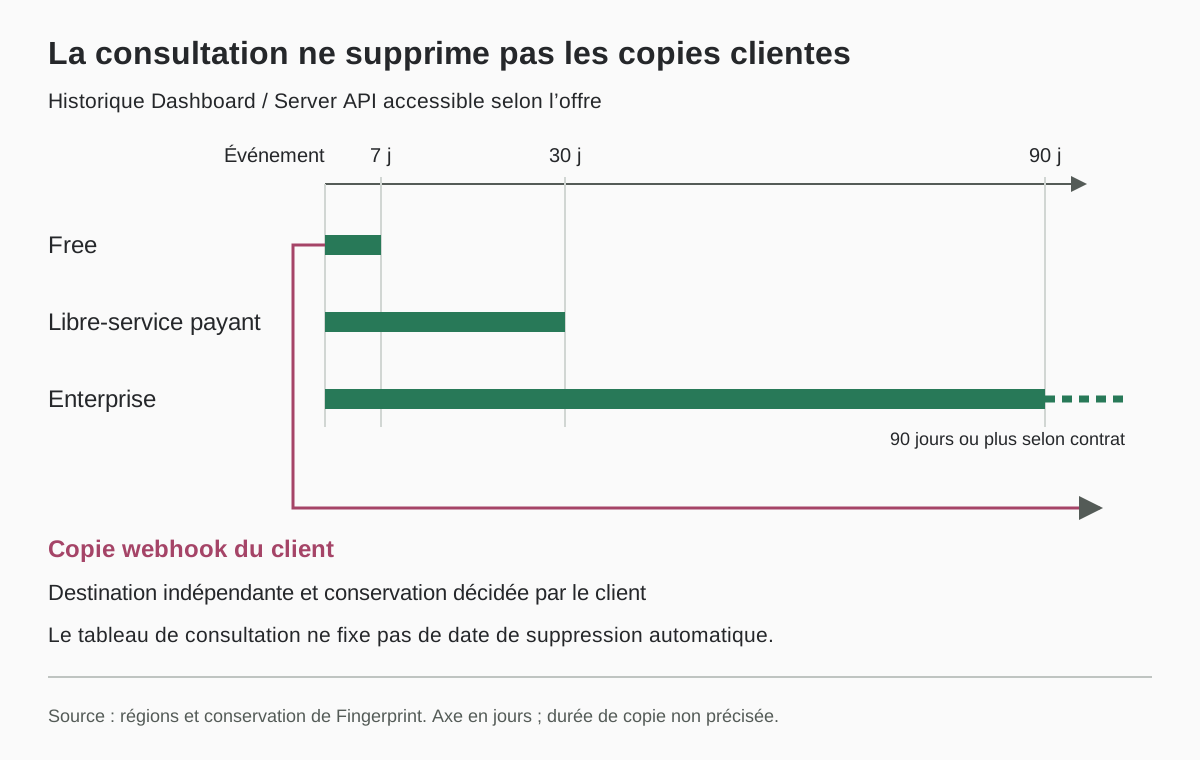
La même documentation propose explicitement des webhooks pour un stockage plus long ou personnalisé. Chaque réponse peut être envoyée vers un endpoint puis conservée dans la base du client. Cela prouve directement que la période de consultation et une copie cliente peuvent avoir des cycles différents. Le schéma place donc cette copie sur une branche séparée plutôt que de prolonger la barre du fournisseur en calendrier universel inventé.
Le client qui choisit cette option doit décider combien de temps les données reçues lui sont utiles et qui peut y accéder. Cette décision ne dépend pas automatiquement des 7 ou 30 jours du plan. Le tableau ne démontre pas le nettoyage de sa base. Décrire toute la conservation avec la seule fenêtre de l'offre peut représenter fidèlement l'interface tout en omettant la copie que les systèmes de l'entreprise maintiennent encore.
La section de suppression indique que Fingerprint, comme sous-traitant, supprimera les informations d'un navigateur ou appareil à la demande du responsable et renvoie au support. C'est une procédure documentée avec répartition des rôles. Ce n'est ni un test de suppression en production, ni un délai garanti, ni la preuve de l'effacement simultané des exports indépendants. Ces affirmations demanderaient leurs propres engagements et vérifications.
L'inventaire du responsable peut distinguer trois situations : consulter seulement lorsque nécessaire sans garder une copie complète ; conserver des champs choisis pour une finalité définie ; ou stocker toute la réponse dans un autre système. Ce sont des choix illustratifs du client, pas des comportements par défaut. Ils créent des responsabilités d'accès et de nettoyage différentes, même avec une offre et une région identiques.
Selon l'explication des fenêtres, passer de Free à une offre payante porte la consultation à 30 jours. C'est un changement d'accès, pas une base pour affirmer qu'un effacement historique aurait été inversé ou que toutes les données précédemment indisponibles redeviendraient récupérables. La déclaration étaye le changement de fenêtre. L'historique effectivement accessible à un compte doit être confirmé par son fonctionnement pris en charge et ses termes contractuels.
La décision de confidentialité doit donc séparer une fonction du service d'un engagement de conservation de bout en bout. La fonction possède une interface, une offre et une période. L'engagement complet doit inclure les destinations réelles du sous-traitant et du client. Une fenêtre courte peut coexister avec une copie plus longue ; une réponse chiffrée peut être conservée après déchiffrement. Ni un petit chiffre dans une grille tarifaire ni le chiffrement du transport ne décrivent la vie de tous les enregistrements résultants.
Livraison chiffrée et visibilité côté client
Sealed Client Results constitue une autre livraison des informations normalement disponibles par Server API. Le dispositif documenté retourne un résultat chiffré via l'agent client, destiné au déchiffrement et à l'utilisation sur le backend intégrateur. Sa propriété de confidentialité concerne les lecteurs possibles le long du trajet. Elle ne supprime ni le traitement initial du service ni la capacité du backend à recevoir un événement exploitable.
Dans le dispositif Server API ordinaire, le backend récupère l'événement auprès du service. Dans le dispositif scellé, le navigateur transporte le résultat chiffré puis le backend le déchiffre. La livraison et la visibilité cliente changent, mais les deux parcours impliquent service et backend. La comparaison pertinente n'est pas « données ou absence de données ». Elle porte sur la représentation lisible ou chiffrée reçue par chaque partie, puis sur l'usage du destinataire autorisé.
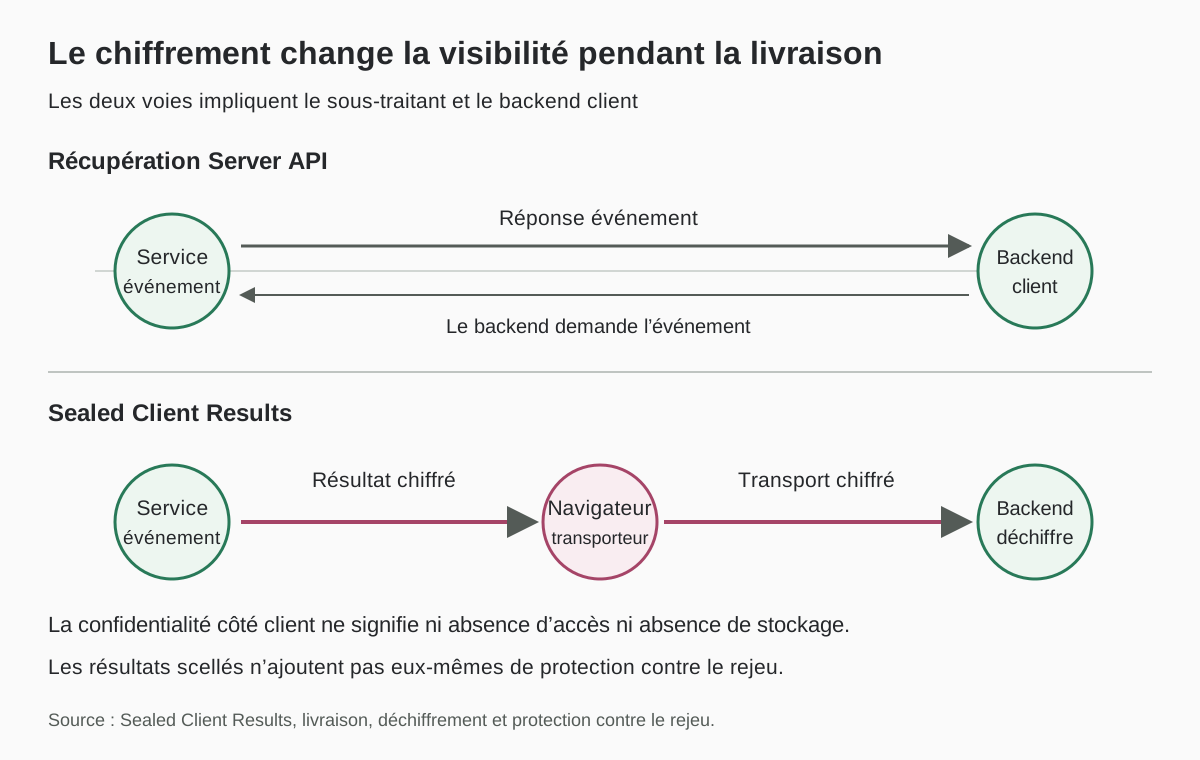
Fingerprint décrit le résultat scellé comme contenant les informations de son endpoint d'événements. Chiffrer cet ensemble n'établit pas en soi la minimisation. Cela peut réduire l'exposition aux lecteurs côté client sans réduire les informations disponibles au backend. Le choix des champs nécessaires doit donc être pris indépendamment du choix de chiffrer la livraison.
La documentation de configuration situe le déchiffrement sur le backend. La clé et l'événement déchiffré ne sont donc pas destinés à devenir un état normalement lisible par la page. C'est une architecture documentée, non la preuve que chaque intégration la réalise correctement. Évaluer un déploiement demande de vérifier où l'application expose réellement le résultat et où elle enregistre les informations déchiffrées.
Le chiffrement ne doit pas non plus devenir une promesse de fraîcheur. La section de protection contre le rejeu dit explicitement que les résultats scellés n'apportent pas eux-mêmes cette protection. Livraison authentique et acceptation applicative sont distinctes. Un événement chiffré peut encore exiger une décision sur sa pertinence et son ancienneté. Aucune interaction avec un service protégé ni procédure d'acceptation n'est fournie ; un mécanisme ne doit pas recevoir des garanties que son fournisseur lui refuse.
Le rôle de transporteur du navigateur peut induire en erreur. Dire que le résultat passe par lui ne signifie pas que la page peut tout lire. Dire que la page ne lit pas le contenu chiffré ne signifie pas que le sous-traitant ne l'a jamais traité. Ces phrases concernent des parties et étapes différentes. Un schéma doit réunir partie, représentation et destination, au lieu de qualifier toute la transaction de privée ou de traitement côté client.
La documentation de l'historique reste pertinente après le choix de livraison. Dès qu'un backend reçoit un événement utilisable, tout stockage client entre dans l'inventaire des copies, que l'événement arrive par Server API, webhook ou résultat scellé. La livraison scellée ne fixe pas le calendrier de suppression du client. Une fenêtre de consultation n'empêche pas non plus de conserver un événement déjà reçu par une intégration autorisée.
Contrôles du navigateur et limites du service
La documentation des empreintes de BotBrowser décrit des contrôles fondés sur des profils dans les chemins natifs du navigateur, plutôt qu'une injection de JavaScript dans la page. Cela concerne la surface exposée au contenu. Un correctif de page intervient dans une autre couche. Aucune ne détermine seule l'organisation des workspaces du sous-traitant, l'usage client d'un identifiant ou le cycle d'informations déjà reçues ailleurs.
Séparer ces sujets évite une comparaison de produits peu utile. La cohérence des surfaces natives est une question technique distincte de celle du partage d'un périmètre d'identification entre propriétés. Un réglage de navigateur n'est pas une demande de suppression. Une surface cohérente ne prouve ni un score du fournisseur ni l'autorisation d'une action par un site. Ces résultats nécessitent leur propre autorité et leurs preuves, non une déduction liée à la couche d'action d'un outil de confidentialité.
L'explication générale des empreintes du navigateur décrit la contribution des propriétés exposées à la corrélation. La décision commerciale ajoute les parties et configurations entourant la collecte. Les contrôles du navigateur traitent leurs surfaces documentées ; l'entreprise choisit encore si elle demande une identification, où réside le workspace, quelles propriétés le partagent et quels champs entrent dans ses propres dossiers. Les responsabilités restent distinctes même si une organisation évalue les deux simultanément.
Le tableau suivant attribue chaque question à la preuve capable d'y répondre. Aucune n'exige la reconstruction d'un collecteur propriétaire. Un inventaire d'API nécessiterait d'autres preuves, dont des événements attribuables pour les affirmations d'exécution. Une affirmation de conservation demanderait des enregistrements du service et du client. Cette distinction évite de collecter des sorties sensibles du navigateur pour répondre seulement à une question contractuelle de stockage ou de corrélation.
| Question | Preuve pertinente | Ce qu'elle n'établit pas |
|---|---|---|
| Les domaines contrôlés partagent-ils l'identification ? | Configuration du workspace et portée documentée | Identité d'une personne ou graphe universel entre clients |
| Que change la pseudonymisation IP ? | Tableau actuel et option réelle du workspace | Absence totale de liens ou précision inchangée |
| Jusqu'où consulter l'historique ? | Conditions Dashboard et Server API selon l'offre | Suppression de toutes les copies du sous-traitant et du client |
| Qui lit un résultat scellé ? | Architecture de livraison et application réelle | Absence de traitement, conservation ou protection automatique de fraîcheur |
| Quelles API ont été exécutées ? | Événements attribuables dans la capture concernée | Stockage, suppression ou acceptation par un tiers |
Questions fréquentes
Un identifiant limité au workspace signifie-t-il un identifiant distinct par domaine ?
Non. Le modèle déclaré permet l'identification entre domaines d'une entreprise utilisant le même workspace. Portée du domaine et portée du workspace doivent être documentées séparément.
0.0.0.0 dans la réponse signifie-t-il qu'aucune IP d'origine n'existait ?
Non. C'est la représentation documentée du mode pseudonymisé, pas une affirmation d'absence d'adresse sur la connexion initiale. La continuité de l'identifiant peut demeurer.
La fenêtre de consultation fixe-t-elle la durée d'une copie webhook ?
Non. La documentation de conservation propose ce stockage comme option séparée. Le client doit définir accès et nettoyage de ce destinataire, plutôt que convertir la durée de consultation en promesse de suppression non étayée.
Sources
- Confidentialité et conformité de Fingerprint
- Régions et conservation des données
- Identification avec une adresse IP pseudonymisée
- Sealed Client Results
- Vue d'ensemble des empreintes du navigateur de BotBrowser
Conclusion pratique
Évaluez FingerprintJS Pro selon ses limites documentées : corrélation du workspace, région du sous-traitant, représentation IP, livraison et copies conservées. Choisissez chaque paramètre pour la finalité réelle. Une IP nulle, un résultat chiffré et une courte fenêtre de consultation décrivent trois propriétés différentes ; aucune ne prouve la fin de toute corrélation ou conservation. Avant intégration ou modification, cartographiez domaines contrôlés et destinations clientes, puis confirmez conditions et configuration actuelles auprès du fournisseur.
Cet article fait partie du guide : Qu'est-ce qu'une empreinte de navigateur ?
Articles Connexes
FingerprintJS OSS : collecte et provenance du condensat
EmpreinteAkamai Bot Manager : données du capteur et vie privée
EmpreinteVie privée hCaptcha : signaux et limites des preuves
EmpreinteVie privée reCAPTCHA : signaux et limites des preuves
EmpreinteAWS WAF CAPTCHA : jetons, signaux et vie privée
EmpreinteKasada : signaux des défis et confidentialité
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.