Données financières : exigences du navigateur
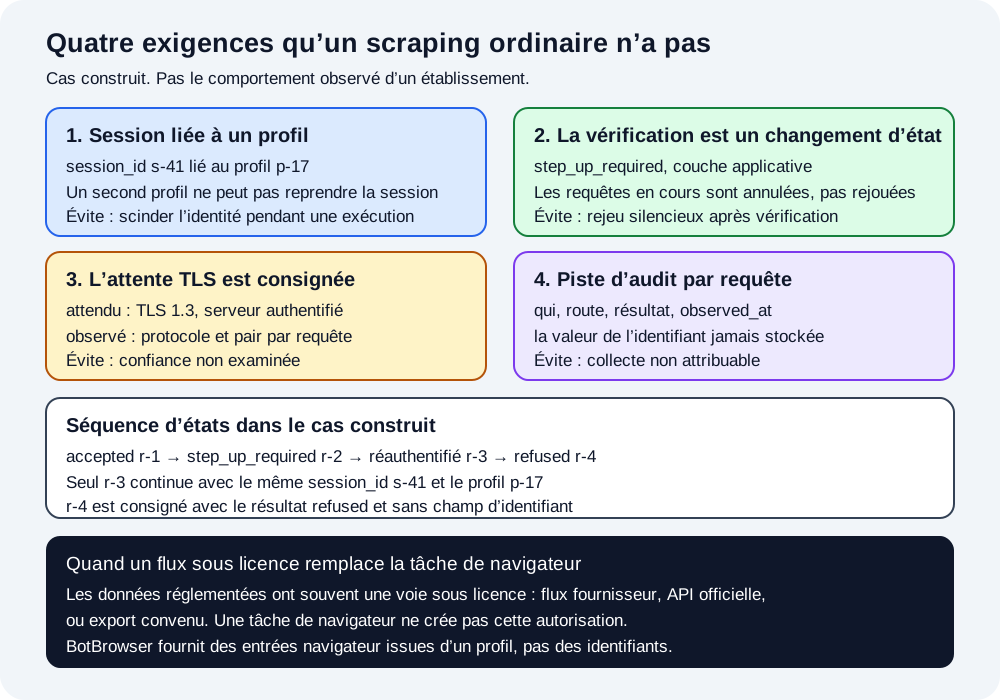
Quatre exigences qu’une collecte réglementée ajoute à un scraping ordinaire : session liée, vérification renforcée comme changement d’état, canal TLS consigné et piste d’audit.
BotBrowser Team
Vous voulez la documentation structurée pour Identité ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
Collecter des données financières n’est pas une version plus difficile d’un scraping de pages ordinaire ; c’est un problème différent, car la source a généralement un compte, une session, une demande d’authentification renforcée et un accord de données derrière elle. BotBrowser documente des ensembles d’empreintes par contexte et des valeurs de navigateur issues d’un profil, de sorte qu’une session de collecte peut rester liée à une identité déclarée. Il ne s’authentifie pas auprès d’un établissement, ne stocke pas d’identifiants, ne résout pas une authentification multifacteur et ne remplace pas un flux sous licence. Confirmez une voie autorisée avant même de concevoir la tâche.
Résumé
- Les données financières réglementées disposent généralement d’une voie sous licence. Identifiez d’abord le flux du fournisseur, l’API officielle ou l’export convenu, et traitez la tâche de navigateur comme un recours qui doit être justifié.
- Liez une session authentifiée à un profil. Une exécution qui reprend la même session sous un second profil a déjà perdu la capacité de dire qui elle était.
- Une authentification renforcée est une transition d’état. Les requêtes en cours antérieures sont annulées et ne peuvent pas être rejouées.
- Consignez l’attente TLS sur laquelle vous vous appuyez et les propriétés du canal réellement observées. « La connexion a réussi » n’est pas une affirmation d’audit.
- Tenez une piste d’audit par requête qui nomme la route, le résultat et l’heure, et qui ne stocke jamais la valeur de l’identifiant.
Sommaire
- Quatre exigences qu’un scraping ordinaire n’a pas
- Lier une session à un profil
- Traiter l’authentification renforcée comme un changement d’état
- Consigner l’attente TLS et le canal observé
- Construire la piste d’audit par requête
- Quand le flux sous licence est la réponse
- Conclusion pratique
Quatre exigences qu’un scraping ordinaire n’a pas
Un scraping de pages ordinaire se décrit par une URL, un analyseur et une périodicité. Une tâche sur des données réglementées doit en plus répondre à qui elle était, ce qu’elle avait le droit de faire et ce qui s’est produit lorsque la source l’a interrompue. Ces questions n’apparaissent pas dans une liste de contrôle générique, et les omettre produit un jeu de données que personne ne pourra défendre ensuite.
| Exigence | Défaillance évitée | Champ de l’enregistrement |
|---|---|---|
| Session liée à un profil | Une session reprise silencieusement sous une seconde identité | session_id, profile_id |
| Authentification renforcée comme état | Requêtes en cours rejouées après une demande de vérification | auth_state, voided_at |
| Attente TLS consignée | La supposition non examinée d’un canal authentifié | expected_channel, observed_channel |
| Piste d’audit par requête | Une collecte non attribuable à une exécution autorisée | request_id, outcome, observed_at |
Chaque ligne répond à une défaillance précise plutôt qu’à un principe général. La première empêche une exécution de scinder son identité en cours de route. La seconde empêche un client de traiter une demande de vérification comme une erreur passagère méritant une nouvelle tentative. La troisième empêche « la requête a réussi » de tenir lieu de « le canal était celui que je supposais ». La quatrième empêche un jeu de données dont la provenance n’existe que dans la mémoire de quelqu’un.
Lier une session à un profil
MDN décrit l’en-tête Authorization comme un moyen pour un agent utilisateur de fournir des identifiants qui l’authentifient auprès d’un serveur, généralement après que le serveur a répondu à une première requête par 401 Unauthorized et un en-tête WWW-Authenticate. Cette description porte sur un échange d’une requête et d’une réponse. Une session de collecte est un objet plus long : elle couvre de nombreuses requêtes, peut être liée à un cookie ou à un jeton, et le serveur décide si elle reste valide.
La conséquence pour une tâche de navigateur est que la session et l’identité du navigateur doivent être liées et consignées ensemble. Si une exécution démarre sous un profil, rencontre un problème et reprend sous un autre, les données obtenues proviennent d’une session dont l’identité déclarée a changé en cours de route. Même si chaque requête a réussi, l’exécution ne peut plus dire qui elle était.
L’analyse de la continuité de session sépare la conservation côté client de l’acceptation côté serveur : garder un cookie n’équivaut pas à ce que le serveur l’honore. Cette distinction compte davantage ici, car une source financière lie généralement la session à plus qu’un cookie. Consignez la liaison explicitement, sous forme de paire, et refusez de continuer dès que l’une des deux moitiés change.
La documentation BotBrowser sur l’empreinte par contexte décrit l’attribution d’un ensemble d’empreintes à un BrowserContext, chaque contexte portant son propre fichier de profil, agent utilisateur, fuseau horaire, paramètres régionaux et proxy. C’est le mécanisme par lequel une tâche de collecte peut garder stable l’identité déclarée d’un contexte pendant toute une session. C’est une entrée côté navigateur ; elle n’autorise pas la session et n’indique pas si le serveur la considère encore valide.
Deux habitudes opérationnelles permettent à la liaison de survivre à une exécution réelle. La première consiste à attribuer l’identifiant de session avant de créer le contexte et à refuser de créer un second contexte pour la même session. Cet ordre compte, car un contexte créé en premier acceptera sans difficulté une session qui existe déjà ailleurs, et le doublon n’est découvert que lorsque la source invalide l’un des deux. Attribuer d’abord transforme une invalidation tardive et confuse en erreur immédiate et locale.
Un dossier de profil avec proxy rotatif couvre la même discipline d’attribution pour un changement de route, et un parcours passkey montre pourquoi l’identifiant et la session qu’il ouvre doivent rester des objets distincts. La seconde habitude consiste à consigner la liaison au moment où elle est faite plutôt qu’à la reconstituer ensuite depuis les journaux. Un enregistrement écrit à l’attribution peut inclure l’identifiant d’exécution, celui du profil et les arguments de lancement du contexte, qui sont exactement les faits dont un relecteur a besoin et exactement les plus difficiles à retrouver. Les reconstituer depuis un journal suppose de recouper des horodatages entre deux systèmes, et ce recoupement échoue précisément dans le cas intéressant.
La liaison a aussi un versant de terminaison. Quand une exécution se termine, le contexte doit être fermé et la session marquée comme fermée dans le même enregistrement. Une session laissée ouverte dans la comptabilité alors que son navigateur a disparu finira par être reprise par une exécution ultérieure qui croit poursuivre quelque chose, et les données obtenues couvriront deux identités différentes sans le dire. Fermer les deux moitiés ensemble est une petite discipline qui supprime toute une classe de questions de provenance.
Enfin, distinguez la liaison de l’identifiant. La liaison indique quel profil a porté une session. L’identifiant est la matière qui prouve la session. Un enregistrement d’exécution peut porter la première sans risque et ne devrait jamais porter la seconde, car la première est un identifiant et la seconde un secret. Garder cette frontière explicite dans le schéma empêche une fonction ultérieure, comme un export de débogage, d’expédier des identifiants dans un jeu de données.
Traiter l’authentification renforcée comme un changement d’état
Une authentification renforcée est le point où la source exige davantage de preuves que la session n’en porte alors. Elle est courante dans les interfaces financières et souvent mal traitée par le code de collecte, car elle arrive sous la forme d’une réponse HTTP d’apparence ordinaire.
La RFC 8446 décrit le canal TLS et ses propriétés d’authentification, dont le fait que le côté serveur est toujours authentifié tandis que le client l’est facultativement. Une authentification renforcée se situe à un autre niveau : c’est une exigence applicative que le client prouve de nouveau quelque chose. Les deux se confondent facilement lorsqu’elles apparaissent pendant une même requête en échec, et l’erreur conduit à un code qui réessaie la requête au lieu de changer l’état de la session.
Le modèle d’état ci-dessous est construit et non observé auprès d’un établissement. Il existe pour rendre la transition explicite afin qu’un client ne puisse pas continuer silencieusement.
| Événement | État de la session ensuite | Ce qu’il advient du travail en cours |
|---|---|---|
| Requête acceptée | authenticated | Continue |
| Vérification renvoyée | step_up_required | Annulé ; chaque requête est reclassée séparément |
| Réauthentification terminée | authenticated de nouveau | Travail neuf uniquement ; rien n’est rejoué |
| Requête refusée par la politique | refused | Consignée comme résultat, non réessayée |
La troisième ligne est celle que le code de collecte rate le plus souvent. Après la réauthentification la session redevient utilisable, ce qui incite à rejouer tout ce qui a échoué pendant la vérification. Ces requêtes ont été émises sous un état que la source avait déjà rejeté ; les rejouer produit des observations non attribuables à l’autorisation en cours. Annulez-les, consignez l’annulation et commencez un travail neuf.
La quatrième ligne couvre le cas où la source refuse pour des raisons de politique plutôt que de demander davantage de preuves. Ce n’est pas une défaillance technique et réessayer n’y changera rien. Consignez le refus avec son motif, arrêtez l’exécution et revenez à la question de la voie autorisée au lieu de le traiter comme une erreur passagère.
Une vérification a également une dimension temporelle que le tableau d’états ne capture pas. Les requêtes émises avant la vérification peuvent avoir été acceptées par la source, et leurs réponses peuvent encore être en vol quand la vérification arrive. Ces réponses ne sont pas invalides parce qu’elles arrivent tard ; elles sont invalides comme preuve de l’état courant, car l’état auquel elles appartiennent n’existe plus. Le client doit classer chacune selon l’état sous lequel elle a été émise, non selon celui qui prévaut à son achèvement.
Cette règle a une conséquence pratique pour le traitement par lots. Une tâche qui envoie cent requêtes puis traite les résultats dans l’ordre d’achèvement entrelacera des observations de deux états sans aucun marqueur. Une tâche qui envoie par groupes bornés et vérifie l’état entre les groupes garde la frontière visible. La taille du groupe est une décision de débit, mais la vérification de la frontière est une décision de correction et ne doit pas être relâchée pour économiser un aller-retour.
La politique de nouvelle tentative relève du même modèle. Un délai d’attente sous un état authenticated peut raisonnablement être réessayé une fois avec un nouvel identifiant de requête, car l’état n’a pas changé. Un délai d’attente pendant step_up_required ne le peut pas, car la nouvelle tentative porterait une requête dans un état déjà rejeté. Écrire cette distinction dans la fonction de nouvelle tentative plutôt que dans la prose alentour est ce qui garde le modèle vrai après le prochain refactor.
Consigner l’attente TLS et le canal observé
Dans une tâche sur des données réglementées, les attentes TLS sont généralement énoncées par la contrepartie, pas par le client. Le rôle du client est de consigner ce sur quoi il s’appuyait et ce qu’il a réellement vu, afin qu’un relecteur puisse dire si les deux concordaient.
L’analyse de la confiance de connexion couvre la validation des certificats et les signaux qu’un navigateur expose sur une connexion. Ce dont une tâche de collecte a besoin en plus est bien plus modeste : une attente déclarée, une valeur observée et une règle de décision en cas de désaccord. L’attente peut être une version de protocole, l’exigence que le serveur soit authentifié ou une politique précise de la contrepartie. La valeur observée est ce que le client peut réellement lire pour cette requête.
Deux modes de défaillance méritent d’être nommés car tous deux ressemblent à un succès. Le premier est une dégradation silencieuse : la connexion aboutit, les données arrivent et personne ne vérifie si le canal négocié était celui que supposait l’accord. Le second est une erreur de portée : un opérateur vérifie le canal une fois au démarrage puis suppose qu’il s’est maintenu pour chaque requête ultérieure. Consignez par requête, ou au minimum par connexion avec une frontière explicite, et indiquez laquelle des deux vous avez retenue.
// Constructed fixture: four requests in one run, one channel expectation.
const EXPECTED_CHANNEL = { protocol: 'TLSv1.3', serverAuthenticated: true };
const RUN = { runId: 'run-7', sessionId: 's-41', profileId: 'p-17' };
const requests = [
  {
    requestId: 'r-1',
    route: 'positions',
    protocol: 'TLSv1.3',
    serverAuthenticated: true,
    outcome: 'accepted',
    observedAt: '2026-11-10T09:00:00Z',
  },
  {
    requestId: 'r-2',
    route: 'balances',
    protocol: 'TLSv1.3',
    serverAuthenticated: true,
    outcome: 'step_up_required',
    observedAt: '2026-11-10T09:00:04Z',
  },
  {
    requestId: 'r-3',
    route: 'balances',
    protocol: 'TLSv1.3',
    serverAuthenticated: true,
    outcome: 'accepted',
    observedAt: '2026-11-10T09:03:10Z',
  },
  {
    requestId: 'r-4',
    route: 'statements',
    protocol: 'TLSv1.2',
    serverAuthenticated: true,
    outcome: 'refused',
    observedAt: '2026-11-10T09:03:12Z',
  },
];

const rows = requests.map(r => ({
  request_id: r.requestId,
  run_id: RUN.runId,
  session_id: RUN.sessionId,
  profile_id: RUN.profileId,
  route: r.route,
  outcome: r.outcome,
  observed_at: r.observedAt,
  channel_matches:
    r.protocol === EXPECTED_CHANNEL.protocol && r.serverAuthenticated === EXPECTED_CHANNEL.serverAuthenticated,
}));

const lines = rows.map(
  r =>
    `request_id=${r.request_id} run_id=${r.run_id} session_id=${r.session_id} profile_id=${r.profile_id} ` +
    `route=${r.route} outcome=${r.outcome} channel_matches=${r.channel_matches} observed_at=${r.observed_at}`
);
console.log(lines.join('\n'));
La sortie construite enregistre une requête acceptée, une transition de vérification, une continuation acceptée et une requête refusée, et montre que r-4 diverge sur le canal :
request_id=r-1 run_id=run-7 session_id=s-41 profile_id=p-17 route=positions outcome=accepted channel_matches=true observed_at=2026-11-10T09:00:00Z
request_id=r-2 run_id=run-7 session_id=s-41 profile_id=p-17 route=balances outcome=step_up_required channel_matches=true observed_at=2026-11-10T09:00:04Z
request_id=r-3 run_id=run-7 session_id=s-41 profile_id=p-17 route=balances outcome=accepted channel_matches=true observed_at=2026-11-10T09:03:10Z
request_id=r-4 run_id=run-7 session_id=s-41 profile_id=p-17 route=statements outcome=refused channel_matches=false observed_at=2026-11-10T09:03:12Z
Cette ligne justifie l’enregistrement. Une requête acceptée sur un canal que la tâche n’attendait pas n’est pas une observation propre, et le jeu de données doit pouvoir le montrer sans que personne ne relise les journaux.
Décider que faire d’une ligne divergente est une question de politique, et la réponse doit être apportée avant la première exécution, pas pendant un incident. Trois options sont défendables : rejeter la ligne et s’arrêter, l’accepter en la marquant pour que l’analyse aval puisse l’exclure, ou l’accepter en consignant l’écart comme avis. Le bon choix dépend de ce que dit l’accord avec la contrepartie, et c’est pourquoi la décision appartient à la base écrite de l’exécution plutôt qu’au code qui a remarqué l’écart.
Le mécanisme d’observation a lui aussi besoin d’une limite déclarée. Un script au niveau de la page ne peut pas lire le protocole négocié de sa propre connexion ; la valeur doit venir de l’instrumentation réseau du navigateur ou du client qui a émis la requête. Consigner un champ de canal rempli par une supposition est pire que le laisser vide, car un champ vide provoque une question tandis qu’un champ supposé la referme. Lorsque la valeur n’est réellement pas disponible, consignez qu’elle ne l’était pas et pourquoi.
La dérive de version est la dernière pièce. Une exécution qui dure des semaines peut voir la contrepartie changer ses protocoles pris en charge, et une attente écrite au départ deviendra fausse peu à peu. Rattachez l’attente à une date et vérifiez-la de nouveau lorsque l’exécution est prolongée. Une attente sans date se lit comme si elle était toujours en vigueur, et c’est la même défaillance de dégradation silencieuse sous une forme plus lente.
Construire la piste d’audit par requête
Une piste d’audit répond à quatre questions par requête : quelle exécution l’a faite, sous quelle identité, ce que la source a renvoyé et quand. Tout le reste est un détail de soutien. L’enregistrement ci-dessous est un artefact applicatif et ne porte délibérément aucune valeur d’identifiant.
| Champ | Contenu | Pourquoi il figure dans l’enregistrement |
|---|---|---|
request_id | Identifiant opaque de cette requête | Relie l’enregistrement à une ligne de journal sans exposer le contenu |
run_id | Identifiant de l’exécution autorisée | Attribue la requête à une autorisation |
session_id | Identifiant de session, jamais un jeton | Montre l’identité qui a émis la requête |
profile_id | Profil avec lequel le contexte a été lancé | Montre l’identité déclarée du navigateur |
route | Classe de point de terminaison, pas l’URL complète | Décrit la requête sans stocker de paramètres |
outcome | accepted, step_up_required, refused | Rend explicite la transition d’état |
observed_at | Heure en UTC | Ordonne les requêtes et borne l’exécution |
channel | Protocole et résultat d’authentification | Consigne à quoi l’attente TLS a abouti |
Deux champs méritent une note. session_id n’est pas le jeton. Stocker un jeton porteur dans une table d’audit transforme la piste d’audit en magasin d’identifiants, ce qui est un problème pire que celui que l’enregistrement devait résoudre. Consignez un identifiant opaque et un condensat si vous devez comparer deux enregistrements de la même session. Le même raisonnement vaut pour route : consignez la classe de point de terminaison plutôt qu’une URL complète avec paramètres de requête, car ceux-ci portent souvent des identifiants de compte ou d’instrument dont l’audit n’a pas besoin.
Le cycle de vie de session sur poste partagé applique une règle voisine à la réutilisation entre utilisateurs : la trace de qui a détenu une session compte autant que la session. Une tâche de collecte avec un profil par exécution est plus simple, mais elle a besoin de la même attribution.
L’enregistrement a aussi besoin d’une décision de conservation distincte de l’exécution. Une piste d’audit effacée avec les données de travail ne peut pas répondre à une question posée un trimestre plus tard, et une piste conservée indéfiniment accumule des données personnelles dont la tâche n’a jamais eu besoin. Fixez la durée à partir de l’accord et de la question à laquelle l’enregistrement doit répondre, écrivez-la, et faites de la suppression une action planifiée explicite plutôt qu’un accident de nettoyage.
L’accès à la piste d’audit est une seconde décision. Elle contient souvent des identifiants de compte et des classes de point de terminaison qui, ensemble, décrivent l’activité d’un client plus en détail que le jeu de données lui-même. Restreignez-la aux personnes qui doivent répondre aux questions de provenance, et journalisez aussi les lectures, pas seulement les écritures. Un système de provenance incapable de dire qui l’a inspecté a la même faiblesse que celle qu’il devait supprimer. La vérifiabilité n’est pas une autorisation : une piste d’audit montre qu’une exécution a eu lieu et n’a pas été modifiée ensuite, et elle ne prouve pas que l’exécution était autorisée.
Enfin, rendez l’enregistrement vérifiable. Un enregistrement avec chaîne de condensats, ou avec un résumé périodique écrit ailleurs que chez l’auteur, peut montrer qu’il n’a pas été modifié après coup. Cette propriété compte surtout dans la situation pour laquelle il existe : un litige sur ce qu’a fait une exécution. Une simple table vaut mieux que rien, mais une table que l’auteur peut réécrire silencieusement est une preuve plus faible que ne le suggère son contenu.
Quand le flux sous licence est la réponse
La plupart des données financières réglementées disposent d’une voie sans navigateur. Un fournisseur de données de marché, une API officielle, un export agrégé ou un flux contractuel donnent les mêmes valeurs avec un schéma défini, une cadence de mise à jour déclarée et une licence qui précise ce que vous pouvez en faire. Quand une telle voie existe, une tâche de navigateur est généralement le mauvais instrument : elle produit un jeu moins stable, avec plus d’exposition juridique, pour une source qui offrait déjà un chemin pris en charge.
La règle de décision honnête n’est donc pas « un navigateur peut-il y accéder » mais « existe-t-il une voie autorisée et, sinon, qu’est-ce qui autorise précisément celle-ci ». Si la réponse à la seconde moitié est le souvenir d’un courriel, ce n’est pas une autorisation. Écrivez la voie et sa base dans l’enregistrement d’exécution pour que la personne suivante hérite de la réponse plutôt que de la supposition.
Le type FinancialProduct de schema.org illustre bien la frontière. Il définit un vocabulaire pour décrire un produit financier, avec des propriétés telles que annualPercentageRate et interestRate, et précise que le taux annuel effectif diffère du taux d’intérêt calculé. Ce vocabulaire indique comment nommer les champs ; il ne dit rien de la publication par une source, de l’actualité d’une valeur publiée ou de votre droit de la collecter.
Questions fréquentes
Une connexion réussie signifie-t-elle que la collecte est autorisée ?
Non. L’authentification établit qui est la session, pas ce que l’opérateur peut faire des données. L’autorisation vient des conditions de l’établissement ou d’un accord distinct, et une session qui fonctionne ne remplace ni l’un ni l’autre.
La même session peut-elle continuer après une authentification renforcée ?
Elle le peut une fois la réauthentification terminée, mais le travail effectué pendant la vérification ne fait pas partie de cette continuation. Annulez ces requêtes, consignez l’annulation et commencez un travail neuf sous le nouvel état.
La piste d’audit doit-elle stocker le jeton d’accès ?
Non. Conservez un identifiant de session opaque et, si nécessaire, un condensat. Un jeton dans une table d’audit transforme la piste en magasin d’identifiants.
BotBrowser s’authentifie-t-il auprès d’un établissement financier ?
Non. Il fournit des entrées de navigateur documentées issues d’un profil, dont des ensembles d’empreintes par contexte, afin qu’une session reste liée à une identité déclarée. Les identifiants, les vérifications et les licences de données restent hors de son périmètre.
Sources
- En-tête Authorization sur MDN
- RFC 8446 TLS 1.3
- schema.org FinancialProduct
- Empreinte par contexte dans BotBrowser
- Panorama des empreintes dans BotBrowser
Conclusion pratique
Partez de la voie autorisée. Si un flux sous licence ou une API officielle existe, utilisez-le et gardez la tâche de navigateur hors de la conception. Lorsque la tâche de navigateur est la voie prise en charge, liez une session à un profil, modélisez l’authentification renforcée comme une transition qui annule le travail en cours, consignez l’attente TLS à côté du canal observé pour chaque requête, et tenez une piste d’audit qui nomme l’exécution, l’identité, le résultat et l’heure sans stocker d’identifiants. Ces quatre exigences sont ce qui rend un jeu de données réglementées défendable une fois l’exécution terminée.
Cet article fait partie du guide : Surfaces d’identité du navigateur : vue de cohérence pratique
Articles Connexes
CAPTCHA pendant le scraping : diagnostiquer le changement
IdentitéPasskeys et WebAuthn : le parcours de connexion dans le navigateur
RéseauCloudflare et DataDome : réponses au scraping
RéseauRotation de proxy : limites de session en scraping
DéploiementScraping Amazon : données et limites du navigateur
RéseauScraper bloqué : erreurs DNS, TLS, HTTP et de page
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.