CAPTCHA pendant le scraping : diagnostiquer le changement
Un CAPTCHA en cours de scraping demande une chronologie des requêtes. Distinguez routage, session et charge avant toute reprise autorisée.
BotBrowser Team
Vous voulez la documentation structurée pour Réseau ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
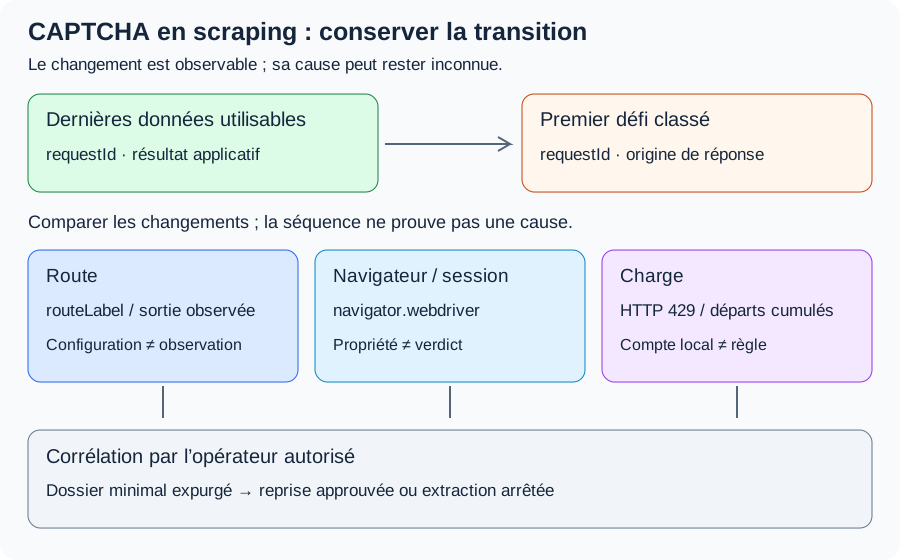
Un CAPTCHA apparaissant au milieu du scraping modifie le résultat observable du traitement ; il n’identifie pas la cause du changement. Une modification de route, un nouveau contexte de navigateur et une charge différente peuvent coïncider avec le premier défi. BotBrowser documente des contrôles du navigateur fondés sur un profil et la configuration du proxy, mais n’accorde aucun accès, n’identifie aucune règle privée du site et ne garantit pas une exécution sans défi. Pour une collecte autorisée, conservez la transition entre la dernière réponse applicative exploitable et le premier défi, arrêtez l’extraction dépendante et demandez à l’opérateur de corréler les requêtes réelles.
Résumé
- Un défi classe une réponse ; il ne prouve pas qu’un signal précis du navigateur a changé.
- Comparez les requêtes exactes autour de la transition ; une page précédemment accessible n’autorise pas toutes les opérations suivantes.
- Examinez les changements de route, de session et de charge comme des explications possibles, sans en faire une liste exhaustive des causes.
- HTTP
429documente un refus lié au débit ; un403générique ou un défi HTML n’identifie pas la règle qui l’a produit. - Gardez un dossier minimal expurgé, respectez le budget de charge existant et reprenez uniquement selon la procédure approuvée par le site.
Sommaire
- Un défi est une transition, pas une cause
- Trois pistes et leurs observations
- Reconstituer l’intervalle entre données et défi
- Interpréter une décision de charge sans inventer un débit sûr
- Conserver un dossier d’incident minimal
- Configuration du navigateur et condition d’arrêt
- Conclusion pratique
Un défi est une transition, pas une cause
Les concepts WAF de Cloudflare distinguent détection et atténuation. La détection fournit des informations ; l’atténuation configurée peut bloquer, présenter un défi ou limiter les requêtes. La référence décrit aussi plusieurs familles de règles et leur ordre d’exécution. Un défi visible constitue donc une preuve d’action à la frontière observée, sans expliquer complètement les entrées de détection ou la politique ayant sélectionné cette action.
Commencez par classer le document effectivement reçu. L’analyse des réponses Cloudflare et DataDome distingue un marqueur de défi documenté d’un refus générique, et sépare les décisions d’intégration serveur des réponses reçues. Une page HTML inattendue peut aussi être une connexion, une erreur applicative ou une réponse d’intermédiaire. Gardez une classification inconnue en l’absence de marqueur précis ou de dossier fourni par un opérateur autorisé.
Repérez la dernière réponse satisfaisant le contrat de données déclaré par l’application et la première qui ne le satisfait plus. HTTP 200 ne constitue pas ce contrat : un statut de succès accompagné d’une connexion ne contient pas le catalogue attendu. De même, une exception du parseur JSON décrit un échec de traitement en aval ; elle n’établit pas une modification du schéma du site. Arrêtez le parseur dépendant avant qu’il publie un résultat vide ou supprime des enregistrements déjà collectés.
Le diagnostic par couches d’un scraper bloqué sépare DNS, TLS, HTTP et exécution de page. Conservez ces distinctions dans le dossier de transition. Si la requête n’a jamais obtenu de réponse HTTP, une capture d’un ancien défi n’explique pas la panne réseau actuelle. Rattachez chaque observation à l’opération qui l’a produite plutôt que d’attribuer un verdict unique à tout l’onglet.
Ne considérez pas la réponse exploitable antérieure comme un certificat d’accès permanent. L’autorisation du compte, les routes applicatives et la politique de l’opérateur peuvent différer selon la requête. Une tâche approuvée pour une ressource ne l’est pas automatiquement pour une destination de redirection ou les données d’un autre compte. La classification indique au pipeline ce qu’il a reçu ; l’autorisation dépend toujours de la méthode et du périmètre d’accès convenus avec le site.
Trois pistes et leurs observations
Ces pistes organisent les preuves autour de la transition. Ce sont des explications candidates, pas trois causes établies ou exhaustives. Une règle du site peut changer sans changement du navigateur, et un problème d’autorisation applicative peut ressembler à une réponse de protection. Plusieurs variables du traitement peuvent également avoir changé avant le premier défi observé.
| Piste | Observation à conserver | Autre explication | Vérification par l’opérateur autorisé |
|---|---|---|---|
| Route réseau | Libellé expurgé et changement de sortie vérifié indépendamment pour la requête correspondante | Route applicative différente, dossier de routage périmé ou règle serveur sans rapport | Corréler la requête exacte avec les journaux périphériques et d’origine autorisés |
| Navigateur ou session | Création du contexte/processus, profil prévu et transition de session applicative | Autorisation expirée ou autre requête utilisant un contexte différent | Comparer le contrat de lancement approuvé et le dossier de session applicatif |
| Charge | Total des requêtes démarrées et en cours dans l’intervalle de comptage du traitement | Autre worker, compte ou route partageant la clé de comptage de l’opérateur | Comparer la règle correspondante et son périmètre réel de comptage |
Pour le routage, distinguez configuration et observation. La référence proxy de BotBrowser documente l’entrée --proxy-server et exige un service proxy fourni. Un point de connexion configuré n’est pas une adresse de sortie observée pour chaque requête. Des changements chez le fournisseur et des requêtes déjà en cours compliquent l’attribution. Consignez les informations réellement disponibles pour la transaction en échec, sans attribuer à une ancienne requête une vérification de sortie actuelle.
Pour l’état du navigateur, la référence MDN de navigator.webdriver décrit un signal coopératif indiquant le contrôle d’un agent utilisateur par WebDriver. Cette propriété n’est pas un verdict complet du fournisseur. Une valeur différente peut servir d’observation de configuration sur une application de test maîtrisée, mais n’identifie pas pourquoi un site externe a présenté un défi. Ne transformez pas un écart de propriété en cause attribuée au fournisseur sans preuve opérateur applicable.
Pour la charge, conservez les comptes comme observations du traitement avec leur périmètre. Un compteur local peut compter les navigations mais omettre les images, nouvelles tentatives, redirections ou autres workers. Inversement, une règle serveur peut ne compter que les requêtes correspondant à une expression. Les compteurs du traitement et de l’opérateur ne décrivent pas nécessairement le même ensemble. Un défi après un certain nombre de pages est une observation de séquence, pas la preuve d’un quota public de pages acceptées.
Reconstituer l’intervalle entre données et défi
Commencez par l’identité et l’heure des requêtes, pas l’ordre d’arrivée des lignes de journal. Avec la concurrence, une réponse tardive peut appartenir à une requête antérieure. Distinguez le démarrage de la requête et l’observation de la réponse lorsque les deux sont disponibles. Précisez la base temporelle pour ne pas assimiler silencieusement un horodatage local à l’heure serveur de l’opérateur. Si les horloges ne sont pas synchronisées, conservez cette incertitude plutôt que d’imposer un ordre causal exact.
Associez les identifiants de contexte et de tâche à la même transaction. Un nouveau processus, un contexte nouvellement créé ou une session applicative restaurée peuvent apparaître pendant qu’un autre worker termine des opérations plus anciennes. Un libellé global déclarant l’utilisation d’un profil ne prouve pas quel contexte a envoyé la requête défiée. La question utile est le respect du contrat de lancement et de session prévu par cette requête, pas l’apparence correcte d’une autre page du processus.
Conservez les changements approuvés dans l’intervalle. Une modification du routage possède un début et une fin ; une connexion applicative son propre résultat ; un ordonnanceur peut démarrer des tâches supplémentaires indépendamment. Si plusieurs changements se chevauchent, consignez-les ensemble et laissez la cause non résolue. Reconstituer l’intervalle n’autorise pas à répéter une requête refusée sous des identités successives pour découvrir laquelle est acceptée.
Vérifiez la provenance de la réponse avant de corréler les identifiants. Un défi HTML en cache peut rester visible après une modification de configuration par le traitement ou l’opérateur. Une capture ne prouve alors que le contenu affiché. Indiquez réponse en cache, nouvellement reçue ou provenance inconnue lorsque l’instrumentation permet cette distinction. N’associez pas un ancien identifiant de corrélation à l’heure actuelle simplement parce que le navigateur montre toujours l’ancien document.
Les redirections demandent la même attention. Conservez la route demandée, la route finale et l’historique autorisé sans les valeurs signées des paramètres. Un HTTP 200 final peut correspondre à une connexion atteinte après redirection de la requête initiale. Si la destination sort du périmètre autorisé, arrêtez plutôt que de la suivre pour terminer la trace. Le dossier doit décrire la limite de visibilité plutôt qu’étendre silencieusement les permissions du traitement.
Limitez l’échantillon de réponse. Gardez le statut, le type de contenu et le marqueur documenté disponible, avec seulement le fragment autorisé nécessaire à la classification. Un corps 403 peut encore contenir des données de compte ou des URL signées. Le but est de localiser un échec autorisé et de permettre la corrélation opérateur, pas de constituer une capture de session réutilisable ou l’empreinte du navigateur d’une autre personne.
Interpréter une décision de charge sans inventer un débit sûr
La référence MDN des statuts HTTP décrit HTTP 429 comme un excès de requêtes sur une période donnée. Cela permet une classification liée au débit à la frontière observée. Ce statut ne révèle pas toute la clé de comptage, l’expression correspondante ou la relation entre le compteur de tâches et les mesures serveur. Un HTTP 403 générique renseigne encore moins sur une règle particulière de charge.
La référence Cloudflare de limitation de débit décrit la sélection des requêtes par expression et d’une action lorsqu’une limite configurée est atteinte. Les caractéristiques de comptage et fonctions disponibles dépendent de l’offre applicable. Un défi peut donc être une action configurée, mais sa seule apparition ne dit pas quelle règle a correspondu. Demandez à l’opérateur autorisé d’inspecter le dossier pertinent plutôt que d’inventer un nombre de requêtes supposé acceptable.
L’analyse du débit et de la concurrence distingue fréquence de démarrage et requêtes en cours. Rattachez le budget au même objectif applicatif autorisé, quels que soient les routes et workers. Démarrer un autre navigateur, changer d’adresse ou répartir le traitement entre contextes ne crée pas une permission et ne réinitialise pas la charge convenue. Consignez le travail total planifié, y compris les nouvelles tentatives bornées, avant de diagnostiquer une différence de présentation du navigateur.
Si l’opérateur confirme une décision de politique de charge, appliquez ses instructions de reprise approuvées. Une pause locale peut réduire le nouveau travail, sans prouver que les compteurs serveur sont effacés ou qu’une tentative différée sera autorisée. Ne laissez pas un groupe de workers envoyer des requêtes dépendantes parce que le défi n’était pas du JSON valide. Arrêtez la nouvelle extraction dépendante et conservez les données déjà reçues séparément du résultat de l’incident.
Un défi inattendu peut aussi coïncider avec un changement de déploiement ou d’intégration. Comparez, si ces informations existent, la période de politique applicable et le contexte de version applicative avec l’intervalle des requêtes. La séquence des réponses ne tranche pas entre une nouvelle règle et un trafic modifié. L’absence de preuve opérateur doit laisser une cause non résolue dans le dossier, pas produire une formule de débit inventée.
Conserver un dossier d’incident minimal
Définissez le dossier par la fonction des champs, la source d’observation et les limites de visibilité. Le tableau décrit les besoins d’un diagnostic autorisé ; ce n’est pas un journal d’exécution fabriqué. Omettez les secrets et champs hors périmètre, et marquez les observations requises indisponibles au lieu de les deviner. Une absence d’observation renseigne utilement sur ce que l’enquête ne peut pas établir.
| Champ | Ce qu’il établit | Limite à conserver |
|---|---|---|
requestId | Transaction décrite par chaque observation | Un identifiant local exige une correspondance explicite avec l’identifiant de corrélation opérateur |
startedAt et observedAt | Ordre du démarrage et de l’observation de réponse | Base temporelle et limites de synchronisation explicites |
taskId et contextId | Tâche planifiée et contexte ayant envoyé la requête | Un libellé de contexte n’est ni permission de compte ni reçu de chargement du profil |
routeLabel | Route approuvée prévue, sans identifiants secrets | La configuration seule n’établit pas la sortie observée de cette requête |
| Statut HTTP et type de contenu | Classe de réponse visible | Un statut de succès n’établit pas le succès des données applicatives |
| Dossier de changement | Changements locaux approuvés survenus dans l’intervalle | Un changement antérieur n’est pas automatiquement la cause du défi |
| Corrélation opérateur | Règle applicable ou décision d’intégration, si fournie | Preuve interne indisponible tant que l’opérateur autorisé ne la fournit pas |
Séparez configuration prévue et résultats mesurés dans le schéma de stockage. Par exemple, routeLabel relève de la configuration sauf observation indépendante établissant la sortie. La référence du profil prévu pour un contexte appartient au contrat de lancement ; une autre valeur du navigateur ne prouve pas le chargement du profil complet. Cette distinction garde le dossier exploitable lorsque certaines vérifications n’ont jamais été exécutées.
Conservez les dossiers de la dernière réponse de données exploitable et du premier défi classé sans recopier toutes les pages antérieures. Leur relation importe davantage qu’un gros ensemble indifférencié. Lorsque la collecte est permise, gardez le plus petit fragment de classification et le résultat applicatif. Excluez cookies, en-têtes d’autorisation, identifiants proxy, URL signées et données de compte des diagnostics partagés. La corrélation opérateur doit employer des identifiants expurgés, sans demander la divulgation d’une configuration de détection privée.
La sortie du traitement doit préciser si l’extraction est terminée, arrêtée ou non résolue. Ne publiez pas une liste de prix vide et ne supprimez pas les anciennes données parce qu’un défi HTML remplace JSON. C’est une décision d’intégrité des données du consommateur, distincte de la classification du fournisseur. L’incident peut rester non résolu tout en préservant les données valides déjà collectées selon les règles de conservation de l’application.
Configuration du navigateur et condition d’arrêt
La référence BotBrowser de cohérence d’automatisation documente les comportements dépendant du profil et les responsabilités du dispositif d’automatisation. Son contrôle de navigator.webdriver exige un profil chargé ; les liaisons créées par le framework et le moment de sa configuration restent des questions distinctes. Les chemins CDP protégés de console et d’exécution relèvent de la limite documentée ENT Tier1. Ces contrôles décrivent la configuration du navigateur, pas une règle privée du site ni une exemption de sa politique d’accès.
Utilisez une application de test maîtrisée et autorisée pour inspecter la configuration prévue. Séparez cette observation du dossier de réponse du site protégé. Une vérification locale de propriété peut identifier un écart dans le contrat de lancement local ; elle ne mesure pas un score caché du fournisseur et ne prouve pas la cause d’un défi ultérieur. Corriger un défaut de configuration maîtrisé est donc un résultat distinct d’établir la permission de reprendre la collecte.
Appliquez la même séparation au réseau. Une configuration --proxy-server exige un service fourni valide et la prise en charge de la destination applicable. Le routage n’accorde pas d’accès au nom du site. Les contrôles du produit rendent une configuration déclarée inspectable, sans éliminer tous les changements réseau possibles, remplacer l’autorisation de session serveur ni promettre un changement de décision. Laissez inconnues les observations de route et d’application indisponibles.
Définissez la condition d’arrêt avant le démarrage : un défi classé, un refus d’autorisation ou une réponse non résolue incompatible avec le contrat de données arrête l’extraction dépendante. Conservez le dossier minimal et utilisez l’assistance ou la voie d’accès aux données approuvée par le propriétaire. Il n’est pas nécessaire d’automatiser une énigme, de rejouer des jetons de défi ou de changer d’identité pour rendre ce diagnostic utile.
Questions fréquentes
Un CAPTCHA après plusieurs pages prouve-t-il une limitation de débit ?
Non. La séquence indique quand le défi a été observé. Une règle opérateur correspondante ou une autre preuve applicable est nécessaire pour attribuer la cause ; HTTP 429 permet une classification liée au débit sans révéler toute la politique de comptage.
Une configuration inchangée exclut-elle un défi ?
Non. L’autorisation applicative, la charge et la politique opérateur peuvent changer indépendamment des propriétés du navigateur. Une configuration stable est une observation, pas une promesse d’accès.
Une application de test maîtrisée révèle-t-elle le score caché du fournisseur ?
Non. Elle enregistre les comportements du navigateur et des requêtes qu’elle peut observer. Un score privé ou une décision du fournisseur exige sa propre preuve autorisée applicable.
Quand reprendre la collecte ?
Uniquement par la procédure de reprise approuvée de l’application, après résolution de la condition d’accès ou d’intégration concernée. Un délai ou un nouveau contexte ne fournit pas en soi de permission.
Sources
- Cloudflare : concepts WAF
- MDN : codes de statut HTTP
- BotBrowser : cohérence d’automatisation
- BotBrowser : configuration proxy
- MDN : Navigator.webdriver
- Cloudflare : règles de limitation de débit
Conclusion pratique
Traitez un nouveau CAPTCHA comme une transition au niveau d’une requête. Classez le document reçu, comparez les requêtes voisines et examinez les changements de route, de session et de charge sans transformer corrélation en cause. Écartez les secrets du dossier, préservez les données valides et arrêtez l’extraction dépendante. L’étape suivante est une décision opérateur approuvée, pas un score deviné ni la promesse qu’un réglage supprimera le défi.
Cet article fait partie du guide : Vue d’ensemble de la configuration proxy : carte des décisions réseau
Articles Connexes
Limites de scraping : 429, Retry-After et concurrence
RéseauScraper bloqué : erreurs DNS, TLS, HTTP et de page
RéseauCloudflare et DataDome : réponses au scraping
RéseauRotation de proxy : limites de session en scraping
DéploiementScraping d’offres d’emploi : limites du navigateur
RéseauCookies de scraping : état entre deux exécutions
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.