curl-impersonate et curl_cffi : les limites de parité TLS
Trois clients, un écouteur : ce qu’un client HTTP imitant TLS reproduit, pourquoi il diffère sur une extension, et la couche de page qu’il n’atteint jamais.
BotBrowser Team
Vous voulez la documentation structurée pour Empreinte ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
Un client HTTP peut être réglé pour envoyer une poignée de main très proche de celle d’un navigateur, et la ressemblance s’arrête à la première surface qui exige un document. BotBrowser fournit un profil déclaré qui garde cohérentes entre elles les surfaces qu’une page peut lire, y compris celles visibles depuis JavaScript, et il ne remplace pas un navigateur lorsqu'un document est requis. La mesure place trois clients devant un même écouteur local : le binaire curl, un client Python qui imite Chrome, et Chrome. La différence entre les deux derniers est la partie utile, parce qu’elle est assez petite pour passer inaperçue.
TL;DR
- Trois clients ont envoyé trois poignées de main différentes au même écouteur : curl
t13i4906h2, Nodet13i521000, Chromet13d1517h2. - Un client chargé d’imiter Chrome a produit
t13d1516h2, qui correspond à Chrome sur le nombre de suites de chiffrement et diffère d’une extension. - La différence d’extension est le point intéressant : une quasi-coïncidence qui omet une seule extension reste une valeur distincte.
- Le
iopposé auddans ces préfixes est l’indicateur de nom de domaine ; se connecter par adresse et se connecter par nom donnent deux empreintes différentes. - Sur cette machine, curl est lié à SecureTransport plutôt qu’à OpenSSL, donc ses ensembles de suites et d’extensions viennent d’une bibliothèque TLS autre que celle que supposent la plupart des guides.
- Un client HTTP n’a ni DOM, ni canvas, ni WebGL, donc chaque signal issu de ces surfaces est simplement absent au lieu d’être incohérent.
- Fixer un en-tête user agent change ce que lit le serveur et ne change pas ce que dit la poignée de main.
- Aligner la couche de connexion et aligner la couche de page sont deux tâches distinctes avec deux boîtes à outils distinctes.
Sommaire
- Trois clients sur un même écouteur, et ce que l’imitation reproduit
- La bibliothèque sous-jacente décide de la valeur
- La couche qu’un client HTTP n’a pas
- Ce que coûte une quasi-coïncidence, et la conclusion pratique
Trois clients sur un même écouteur, et ce que l’imitation reproduit
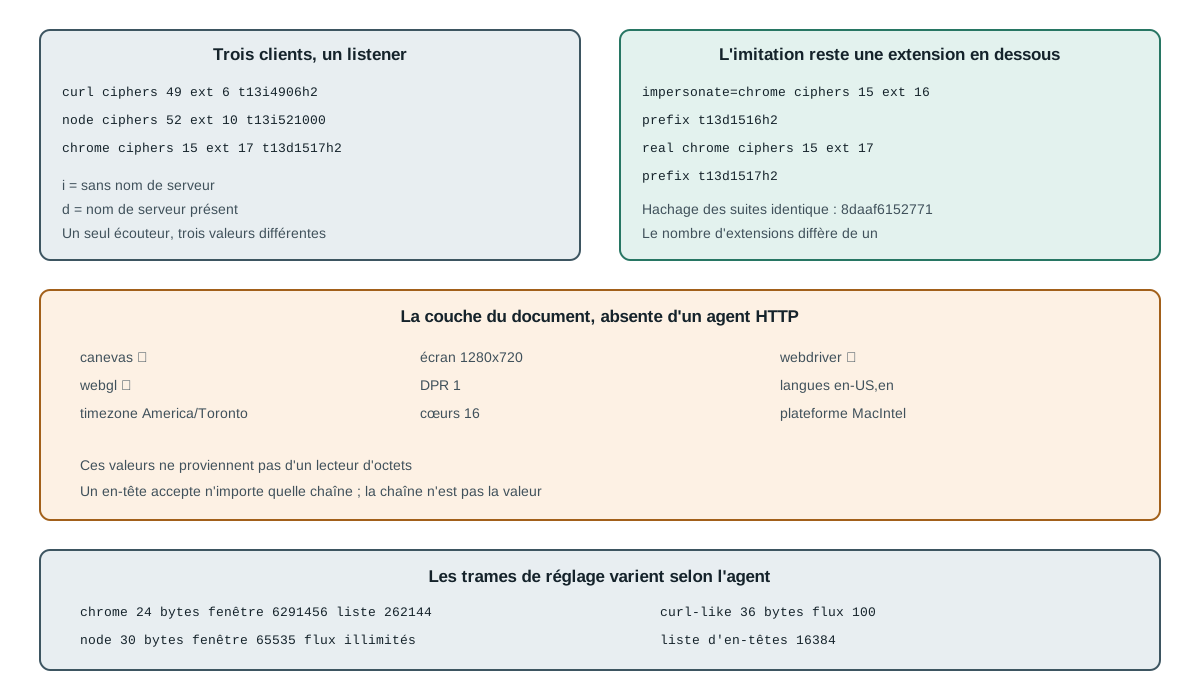
La mesure est volontairement réduite. Un écouteur TCP sur l’interface de bouclage accepte une connexion, enregistre le premier enregistrement puis ferme ; la poignée de main ne se termine jamais, donc aucun certificat de serveur n’intervient et aucune décision de confiance ne perturbe le résultat. Chaque client est dirigé vers cette adresse à son tour.
curl:   bytes=301  alpn=h2,http/1.1 ciphers=49 exts=6  versions=0x0304,0x0303,0x0302,0x0301
        ja4=t13i4906h2_0d8feac7bc37_7395dae3b2f3
node:   bytes=1566 alpn=(none)     ciphers=52 exts=10 versions=0x0304,0x0303
        ja4=t13i521000_b262b3658495_8e6e362c5eac
chrome: bytes=1917 alpn=h2,http/1.1 ciphers=15 exts=17 versions=0x0304,0x0303
        ja4=t13d1517h2_8daaf6152771_cb7bf5808d99
Lire les trois valeurs côte à côte fait apparaître immédiatement la forme du problème. Elles diffèrent sur trois positions indépendantes : le nombre de suites de chiffrement, le nombre d’extensions et l’étiquette de protocole. Un client qui ne corrige que les deux premières continue de s’annoncer dans la troisième, et un client qui n’en corrige aucune se sépare sans effort.
L’entrée Node affiche 521000 pour ses comptes, et ses quatre derniers caractères valent 1000 au lieu d’une étiquette de protocole. Cela vient d’une connexion TLS Node sans configuration, qui n’offre aucun protocole : l’étiquette retombe donc sur des zéros pendant que les comptes continuent. Un client HTTP qui ne négocie jamais HTTP/2 possède ainsi une empreinte qui le déclare, sans qu’aucune logique de détection n’intervienne.
Le i des deux premières valeurs face au d de Chrome est l’indicateur de nom de domaine. curl et Node visaient une adresse nue dans cette exécution et n’ont envoyé aucun server name ; Chrome visait un nom. Ce caractère unique n’est pas un jugement subtil sur l’intention, c’est une déclaration sur ce que le client a mis dans le message. Pointer curl et l’agent imitant vers un nom d’hôte plutôt qu’une adresse a fait basculer leurs marqueurs vers d et augmenté le compte d’extensions de un, donc le marqueur et le compte sont deux lectures de la même décision. Node n’a pas suivi : il est resté à t13i521000 avec dix extensions jusqu’à ce que servername soit passé explicitement, et il est alors devenu t13d521100 avec onze. La bibliothèque décide si le nom voyage, et l’appelant décide si la bibliothèque en est informée.
curl-impersonate et curl_cffi procèdent en remplaçant ou en reconfigurant la couche TLS et HTTP/2 pour que les octets ressemblent à ceux d’un navigateur choisi. L’affirmation est étroite et mérite d’être vérifiée plutôt que supposée, donc le même écouteur a servi avec un client Python chargé d’imiter Chrome :
default: bytes=517  ciphers=28 exts=12 alpn=h2,http/1.1
         ja4=t13d2812h2_257f3020b3a2_cbb9361b6bf9
chrome:  bytes=1815 ciphers=15 exts=16 alpn=h2,http/1.1
         ja4=t13d1516h2_8daaf6152771_d8a2da3f94cd
La deuxième ligne est le résultat qui compte. Chargé d’imiter Chrome, le client a produit quinze suites de chiffrement et seize extensions, et son ensemble de suites haché 8daaf6152771 est identique à celui du vrai navigateur. Sur l’axe des suites, l’imitation est exacte.
Le nombre d’extensions ne l’est pas. Chrome en a envoyé dix-sept et le client qui imite en a envoyé seize, donc les préfixes affichent t13d1516h2 face à t13d1517h2. Un chiffre d’écart, et ce chiffre est exactement le genre de différence pour laquelle une valeur est stockée.
Ce n’est pas une critique de l’un ou l’autre projet. Un navigateur embarque des extensions qu’une bibliothèque cliente n’a aucune raison d’envoyer, et reproduire la liste complète reviendrait à suivre une cible mouvante sans gain fonctionnel. Le point est plus précis : une quasi-coïncidence n’est pas une coïncidence, et une comparaison qui ne vérifie que la première partie du hachage annoncera un succès là où le préfixe diverge déjà.
La bibliothèque sous-jacente décide de la valeur
Les chiffres curl du début de la mesure paraissent inhabituels pour une raison sans rapport avec l’imitation. La compilation locale indique son moteur TLS :
curl 8.7.1 (x86_64-apple-darwin24.0) libcurl/8.7.1 (SecureTransport) LibreSSL/3.3.6 zlib/1.2.12 nghttp2/1.64.0
curl_has_http2=true
SecureTransport, pas OpenSSL. Un curl compilé contre SecureTransport tire sa liste de suites et son ensemble d’extensions de cette bibliothèque, donc son empreinte est une propriété de la compilation et non du programme curl. Deux machines avec la même version de curl et des moteurs différents produisent des valeurs différentes, et aucune n’est fausse.
Cela a une conséquence pratique pour qui compare des empreintes sur un parc de machines. Enregistrer « curl » comme client ne suffit pas, parce que cela ne nomme pas la bibliothèque TLS, et c’est la bibliothèque que la valeur décrit. Le même raisonnement vaut pour les clients qui imitent : la version de la bibliothèque sous-jacente compte plus que la version de l’enveloppe.
Une seconde trame montre la même séparation au niveau HTTP/2. La connexion s’ouvre sur une trame de paramètres, et les entrées de cette trame font partie de ce qu’un pair voit avant même qu’une requête existe :
chrome_like: bytes=24 HEADER_TABLE_SIZE=65536 ENABLE_PUSH=0 INITIAL_WINDOW_SIZE=6291456 MAX_HEADER_LIST_SIZE=262144
node_like:   bytes=30 HEADER_TABLE_SIZE=4096 ENABLE_PUSH=0 INITIAL_WINDOW_SIZE=65535 MAX_FRAME_SIZE=16384 MAX_CONCURRENT_STREAMS=4294967295
curl_like:   bytes=36 HEADER_TABLE_SIZE=4096 ENABLE_PUSH=0 MAX_CONCURRENT_STREAMS=100 INITIAL_WINDOW_SIZE=65535 MAX_FRAME_SIZE=16384 MAX_HEADER_LIST_SIZE=16384
Trois clients, trois longueurs de trame, et la différence n’est pas décorative. Le navigateur déclare une grande fenêtre initiale et une grande liste d’en-têtes ; le client Node ne déclare aucune limite de liste d’en-têtes et laisse la fenêtre à sa valeur par défaut ; le client de forme curl déclare un plafond de flux simultanés que les deux autres omettent. Un pair qui lit la trame sait à laquelle de trois architectures il parle avant d’analyser la ligne de requête.
La trame montre aussi pourquoi « imiter le navigateur » est plus difficile que d’aligner une liste de suites. L’ordre des suites est une propriété fixe d’une compilation de bibliothèque ; la trame de paramètres est un ensemble de choix de réglage qu’un client fait pour sa propre charge de travail. Faire ressembler les deux à un navigateur suppose d’adopter aussi le réglage du navigateur, y compris les parties qui servent un moteur de rendu que ce client n’a pas.
Les bibliothèques d’imitation traitent bien ce point, et la mesure ci-dessus montre qu’elles s’en approchent. Ce qu’elles ne peuvent pas changer, c’est l’existence du réglage : un client dont le seul travail est de récupérer des octets a des réglages naturels différents de ceux d’un client dont le travail est de rendre une page, et la trame enregistre la différence même quand le code a été ajusté.
Un client qui réutilise une connexion rend cela visible à un second endroit. La reprise de session et la réutilisation de connexion servent toutes deux le débit, et toutes deux font que la seconde requête ne répète pas la poignée de main. Un pair qui compte les poignées de main voit donc une empreinte pour dix requêtes au lieu de dix, tandis qu’un client qui ouvre une connexion neuve à chaque requête en montre dix. Aucun des deux comportements n’est une tromperie ; ce sont deux conceptions normales, et les comptes diffèrent parce que les conceptions diffèrent.
La couche qu’un client HTTP n’a pas
Tout ce qui précède concerne la connexion. La couche de page est un autre ensemble de valeurs et un client HTTP n’en possède aucune, au sens où un éditeur de texte n’a pas de résolution d’écran.
page_layer: ua=header-only  languages=en-US,en  platform=MacIntel
            hardwareConcurrency=16  deviceMemory=null
            canvas=true  webgl=true  timezone=America/Toronto
            screen=1280x720  dpr=1  webdriver=true
Ces valeurs viennent de l’évaluation d’un document dans un navigateur. Aucune ne peut être produite par un client qui analyse des octets, parce que chacune est calculée par un moteur JavaScript ou un système de rendu que le client n’exécute pas. Il n’y a ici ni crédit partiel ni contournement habile : un en-tête peut recevoir n’importe quelle chaîne, et la chaîne n’est pas la valeur.
La dernière entrée mérite d’être séparée des autres. webdriver=true est rapporté par le navigateur parce qu’il a été lancé sous automatisation, et un client HTTP n’a aucun champ équivalent à rapporter. Une comparaison qui traite « champ absent » comme « champ propre » lit l’absence à l’envers, et c’est pourquoi un rapport d’empreinte doit dire quelles surfaces ont été évaluées et pas seulement quelles valeurs ont été trouvées.
En réunissant les deux couches, le coût d’une quasi-coïncidence devient concret. Un client qui atteint t13d1516h2 a dépensé un effort réel sur la couche de connexion et diffère encore du navigateur qu’il imite d’une extension. Il n’a rien gagné non plus sur la couche de page, où il reste un client sans document.
Cette combinaison est le pire des deux postes dans un sens précis : elle invite à une comparaison qu’elle ne peut pas gagner. Un client simple qui ne cherche pas la ressemblance n’est manifestement pas un navigateur, et les outils le traitent comme tel. Un client qui ressemble beaucoup à un navigateur sur la couche de connexion crée une attente que la couche de page ne remplit ensuite pas.
plain_client      -> clearly not a browser on both layers
impersonated      -> close on connection, absent on page
browser           -> both layers present and consistent
La question utile n’est donc pas « jusqu’où la poignée de main peut-elle se rapprocher » mais « de quelle couche cette tâche a-t-elle réellement besoin ». Une requête JSON derrière une vérification simple a besoin de la première ligne. Une requête vers une liste rendue derrière une connexion a besoin de la troisième. Choisir la deuxième ligne revient à payer pour une ressemblance qui n’arrive qu’à moitié.
Une troisième raison maintient les deux couches séparées en pratique, et elle tient à la forme sous laquelle une comparaison peut être énoncée. Une affirmation sur la couche de connexion prend la forme « cette poignée de main a offert ces paramètres », qu’un seul message enregistré peut étayer. Une affirmation sur la couche de page prend la forme « cet environnement a rapporté ces valeurs », qui exige une évaluation à l’intérieur d’un document et une trace de ce que cette évaluation pouvait atteindre. Les deux affirmations ont des exigences de preuve différentes, donc un rapport qui les fusionne en une note unique doit abandonner le champ qui dit laquelle il produit.
Cela compte surtout quand une divergence apparaît. Si un client correspond sur la couche de connexion et que la couche de page est absente, le rapport devrait dire « couche de page non évaluée » et non « couche de page propre ». La première affirmation est vraie et exploitable ; la seconde porte sur une mesure que personne n’a faite. La même discipline vaut en sens inverse : une session de navigateur dont la poignée de main n’a jamais été capturée ne peut pas répondre à une question sur la connexion, aussi minutieux soit son rapport côté page.
Le coût suit la même division. Une correspondance de la couche de connexion se paie une fois, à la compilation, en choisissant une bibliothèque et une version puis en les épinglant. Une correspondance de la couche de page se paie en continu, parce que les valeurs qu’un document rapporte dépendent du moteur de rendu, des polices, de l’écran et du profil utilisé, et que chacun peut dériver entre deux exécutions. Les équipes budgétisent souvent la première et sont surprises par la seconde, et c’est pourquoi une bibliothèque TLS épinglée paraît terminée alors qu’un environnement de page cohérent ne l’est jamais tout à fait.
Une dernière note opérationnelle appartient ici plutôt qu’à un tutoriel, parce que c’est la partie qui casse en silence. Quand une bibliothèque cliente est mise à jour, la liste de suites et l’ensemble d’extensions bougent avec elle, et l’empreinte enregistrée cesse de correspondre pour une raison sans rapport avec la configuration. Quand un navigateur est mis à jour sous une installation d’automatisation épinglée, les valeurs de la couche de page peuvent bouger de la même façon. Les deux sont des événements de version, les deux apparaissent dans un diff si la valeur est stockée à côté de la version, et les deux sont invisibles si la valeur est stockée seule.
Ce que coûte une quasi-coïncidence, et la conclusion pratique
Repère de comparaison : t13d1516h2 face à t13d1517h2, avec le même nombre de suites des deux côtés.
Mesurer avant de supposer la parité : capturez le ClientHello de votre propre client et comparez le nombre d’extensions, pas seulement un hachage. Le client qui imite mesuré ici a reproduit exactement l’ensemble de suites de Chrome et différé d’une extension, et le préfixe énonce clairement cet écart. Nommez aussi la bibliothèque TLS en plus du programme, parce que des compilations SecureTransport et OpenSSL de la même version de curl produisent des valeurs différentes. Et gardez les deux couches séparées dans toute comparaison : un client sans DOM peut approcher la couche de connexion, et aucun ne peut approcher la couche de page. Pour la construction de la valeur de connexion, lisez JA3, JA4 et la trame de paramètres HTTP/2 ; pour savoir quelles règles de détection exigent une valeur réseau, lisez les règles de bord qu’un script de page ne peut pas évaluer. Une page rendue exige un navigateur, et la configuration d’un navigateur pour le scraping couvre ce chemin.
La frontière mérite d’être énoncée sans ornement. Un profil déclaré peut garder cohérentes entre elles les valeurs qu’une page expose ; il ne fait pas correspondre une poignée de main à un autre client, et il ne donne pas à un client HTTP un document à rendre. Aligner la connexion et aligner la page sont deux résultats distincts obtenus avec des outils distincts, et une tâche a généralement besoin de l’un des deux plutôt que des deux.
Une courte note sur ce que ces mesures ne disent pas, car un lecteur peut le demander à juste titre. Elles ne disent pas qu’une quasi-coïncidence est inutile : pour un point d’accès JSON derrière une note simple, la couche de connexion est presque tout ce qui est examiné, et un client qui réussit les suites est dans une position différente d’un client qui échoue. Elles ne disent pas non plus qu’un navigateur est nécessaire pour chaque page rendue, puisqu’une page qui livre ses données dans un objet d’état initial peut être lue par un client sans moteur de rendu.
Ce qu’elles disent, c’est que les deux couches ne forment pas un dégradé. Aucun réglage ne place un client à mi-chemin entre « pas de DOM » et « rend une page », et aucun en-tête ne fait passer la poignée de main d’un navigateur à une autre valeur. Une tâche qui exige les deux couches exige un navigateur ; une tâche qui exige la couche de connexion peut souvent être servie par un client qui ne charge jamais de document. Décider laquelle de ces deux tâches est devant soi, et l’écrire dans le registre, voilà toute la discipline.
Le montage de la mesure mérite un paragraphe, parce qu’un lecteur qui veut vérifier ces chiffres a besoin des mêmes conditions. L’écouteur doit accepter la connexion et fermer sans terminer de poignée de main ; s’il présente un certificat, le client peut envoyer un second message différent et la comparaison se déplace. La capture doit se faire du côté client de tout proxy, sinon les octets enregistrés appartiennent à ce qui a terminé TLS et non au client étudié. Et l’analyse doit écarter les valeurs grease avant de compter, parce qu’un client qui tire un nouvel espace réservé à chaque connexion semble faire croître et diminuer sa liste de suites entre deux exécutions. Aucune de ces étapes n’est difficile, et chacune, sautée, produit un chiffre qui change pour une raison étrangère au client.
Sources
Cet article fait partie du guide : Qu'est-ce qu'une empreinte de navigateur ?
Articles Connexes
Empreintes TLS : JA3, JA4 et la trame HTTP/2
EmpreinteRègles de couche réseau qu’une page ne peut pas évaluer
EmpreinteClient Hints Fingerprinting : en-têtes HTTP et identité
RéseauScraper bloqué : erreurs DNS, TLS, HTTP et de page
EmpreinteCe que les suites de détection publiques testent vraiment
EmpreinteSource aléatoire de crypto-js : quelle branche
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.