Tests instables : quatre causes et leurs preuves
Attribuez un test instable à l’état, au timing, au réseau ou à la dérive d’environnement grâce à la preuve qui les sépare, et faites des relances un enregistrement.
BotBrowser Team
Vous voulez la documentation structurée pour Documentation ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
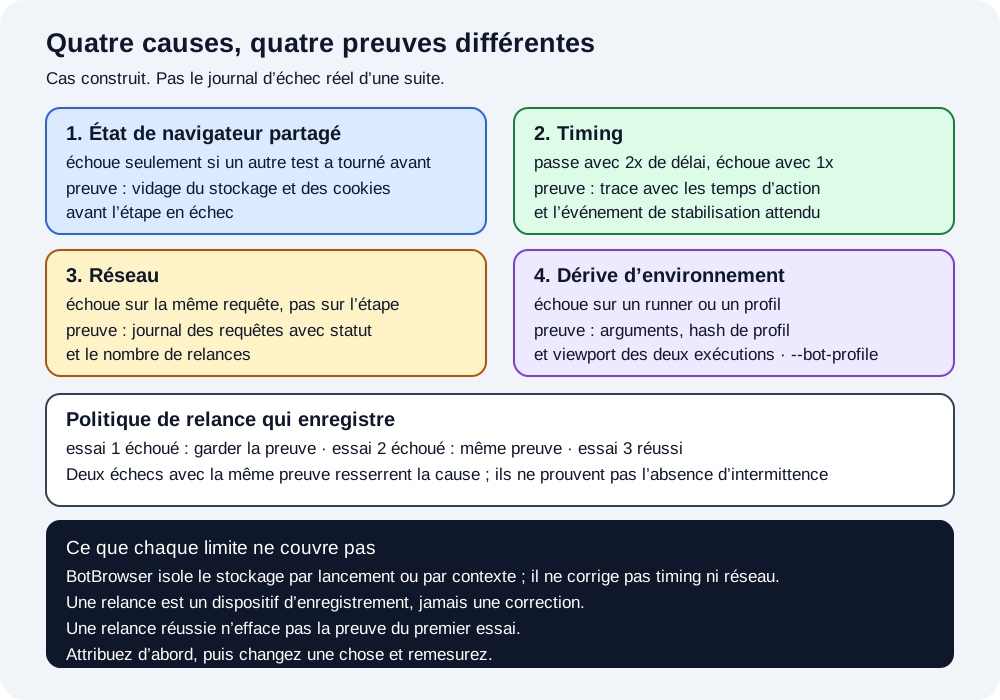
Un test instable n’est pas un test qui échoue parfois ; c’est un test dont l’échec n’a pas encore été attribué. Relancer jusqu’à ce que ça passe produit une exécution verte et détruit la preuve qui aurait dit laquelle des quatre causes agissait. BotBrowser documente l’isolation du stockage par lancement et par contexte, qui supprime un mécanisme derrière la cause d’état partagé plutôt que la cause en général. Il ne corrige pas les causes de timing, de réseau ou de conception de test, et ne rend pas une suite déterministe à lui seul.
Résumé
- Capturez le premier essai en échec avant toute nouvelle tentative. Une relance qui l’écrase a supprimé la seule preuve disponible.
- Attribuez l’échec à l’une de quatre causes : état de navigateur partagé, timing, réseau ou dérive d’environnement. Chacune laisse une preuve différente.
- Deux échecs avec la même signature sont une observation reproductible. Elle resserre la cause sans prouver que l’échec n’est pas intermittent.
- Gardez les relances comme dispositif d’enregistrement. Enregistrez chaque essai, corrigez la cause, puis retirez la relance de ce test.
- BotBrowser élimine un mécanisme d’état partagé en isolant le stockage par contexte ou par lancement. Il ne corrige pas les trois autres causes.
Sommaire
- Quatre causes et la preuve de chacune
- Pourquoi une relance efface la preuve
- Une politique de relance qui enregistre
- Une liste d’isolation d’état
- Conclusion pratique
Quatre causes et la preuve de chacune
La première question utile n’est pas « à quelle fréquence échoue-t-il » mais « à quoi ressemble l’échec quand il survient ». Chacune des quatre causes laisse une signature, et chaque signature exige une preuve précise pour être confirmée. Une preuve propose une hypothèse ; la confirmer demande une comparaison témoin, et collecter la mauvaise preuve produit une attribution assurée et fausse.
| Cause | Signature | Preuve qui la confirme |
|---|---|---|
| État partagé | Échoue seulement si un autre test a tourné avant | Vidage du stockage, des cookies et du cache avant l’étape |
| Timing | Passe avec un délai plus long, échoue avec le normal | Trace avec les temps d’action et l’événement attendu |
| Réseau | Échoue sur la même requête, pas sur la même étape | Journal des requêtes avec statuts et nombre de relances |
| Dérive d’environnement | Échoue sur un seul runner, profil ou viewport | Arguments de lancement, hash de profil et viewport des deux exécutions |
La cause d’état est celle qu’une suite de navigateur sous-déclare, car la preuve est invisible dans le message d’échec. La pratique d’hygiène des données de test et de l’état du navigateur explique comment empêcher cet état de s’accumuler. Un test qui échoue seulement après qu’un autre a tourné échoue généralement sur une assertion de contenu, et le message pointe l’assertion plutôt que le stockage résiduel. Vider le stockage et les cookies juste avant l’étape en échec transforme cela en attribution.
La cause de timing est celle qui est le plus souvent « corrigée » sans diagnostic, et l’analyse des attentes et des tests stables précise ce qu’une attente correcte attend. Un test qui passe avec un délai plus long a démontré que l’attente était trop courte, ce qui est une preuve utile et non une réparation. La trace montre si l’élément est apparu tard, si le réseau était lent ou si l’action s’est déclenchée avant que la page se stabilise, et ces trois réponses mènent à des corrections différentes.
Les causes de réseau et de timing se confondent facilement car toutes deux apparaissent comme « l’élément n’était pas là ». La distinction est qu’une cause réseau se reproduit sur la même requête tandis qu’une cause de timing se reproduit sur la même étape avec une requête différente. Enregistrer le statut de la requête et le nombre de relances les sépare sans deviner.
La cause d’environnement est celle qui ressemble à un bug du framework. Un test qui échoue sur un runner et passe sur un autre échoue généralement parce que les deux exécutions avaient des arguments de lancement, des valeurs de profil ou un viewport différents. Enregistrer les trois pour les deux exécutions est peu coûteux, et c’est la preuve qui rend la comparaison possible.
Une cinquième signature mérite une note car elle est souvent lue comme l’une des quatre : le test dépend de données qui changent avec le temps. Une assertion de prix contre une constante, une assertion de date qui suppose aujourd’hui, ou une assertion de liste qui suppose un nombre fixe échouent selon un calendrier plutôt qu’intermittemment. La preuve est la donnée d’entrée et son horodatage, et la correction appartient au fixture, pas au navigateur. La traiter comme une cause d’état ou de timing mène à des relances qui passent certains jours et échouent d’autres, l’issue la plus coûteuse.
L’ordre d’investigation compte autant que le tableau. Commencez par la cause la moins coûteuse à écarter et à corriger, presque toujours l’état, car un contexte neuf reproduit l’échec ou non. Vérifiez ensuite l’environnement, car comparer deux configurations de lancement enregistrées est un diff et non une expérience. Timing et réseau viennent en dernier, car diagnostiquer l’un ou l’autre exige une trace et un journal de requêtes qui coûtent du temps réel.
Il existe aussi un point d’hygiène qui s’applique aux quatre. Une preuve n’est utile que si elle a été capturée au moment de l’échec et non reconstituée après. Une capture prise après que le framework a déjà navigué ailleurs, un vidage pris après le hook de nettoyage, ou un journal filtré aux erreurs seulement ressembleront à des preuves sans en contenir. Capturez au hook d’échec, avant tout teardown, et consignez quel hook a produit la preuve.
Pourquoi une relance efface la preuve
Playwright documente les relances comme une fonction du runner qui réexécute les tests en échec, et documente les fixtures et l’exécution parallèle comme des fonctions distinctes avec leurs propres règles de portée. Aucun de ces documents n’affirme que les relances rendent une suite fiable. La fonction réexécute un test ; ce qu’il advient de la preuve du premier essai dépend entièrement de la configuration d’enregistrement de la suite.
Le mode d’échec par défaut est subtil, et il se voit dans un champ : status=passed avec retries=1. Playwright rapporte un test relancé qui finit par passer comme flaky, avec testInfo.status égal à passed, si bien qu’un rapport qui ne lit que le champ de statut final voit une réussite et rien d’autre. Le problème plus fort est que le premier essai n’a souvent aucune trace : la valeur par défaut trace: 'off' n’enregistre rien, et on-first-retry ne commence à enregistrer qu’au démarrage d’une relance. La preuve manque plutôt que d’être écrasée, sauf si un chemin de sortie personnalisé réutilise un même nom de fichier entre essais.
C’est pourquoi une relance est un dispositif d’enregistrement et non une correction. Bien utilisée, elle indique quels tests sont instables et donne une seconde observation du même échec. Mal utilisée, elle transforme un défaut réel en build verte et déplace la découverte en production, où la preuve n’existe plus.
Il y a aussi un piège statistique. Un test qui échoue une fois sur dix passera une relance unique neuf fois sur dix, si bien qu’une suite avec relances paraît bien plus stable qu’elle ne l’est. Le taux d’échec n’a pas changé ; seul le rapportage a changé. Deux échecs consécutifs avec la même signature constituent le signal le plus fort disponible, mais cela reste une hypothèse : une cause réseau peut produire deux fois la même signature et rester intermittente, donc l’attribution exige une comparaison de contrôle.
Une politique de relance qui enregistre
Une politique qui enregistre est petite : conserver chaque essai, nommer la preuve par essai, et refuser de résumer le premier échec jusqu’à le faire disparaître. Le constructeur ci-dessous est un cas construit montrant ce que l’enregistrement devrait contenir.
// Constructed fixture: three attempts of one test, two failures with a matching artifact prefix.
const attempts = [
  { n: 1, status: 'failed', artifact: 'storage-dump:t1.json', at: '2026-11-10T09:00:12Z' },
  { n: 2, status: 'failed', artifact: 'storage-dump:t2.json', at: '2026-11-10T09:00:48Z' },
  { n: 3, status: 'passed', artifact: 'trace:t3.zip', at: '2026-11-10T09:01:30Z' },
];

const failures = attempts.filter(a => a.status === 'failed');
const sameArtifact = failures.length > 1 && failures[0].artifact.split(':')[0] === failures[1].artifact.split(':')[0];
const verdict = sameArtifact ? 'repeated_signature' : failures.length ? 'single_failure' : 'clean';

const lines = [
  `attempts=${attempts.length} failures=${failures.length}`,
  ...attempts.map(a => `attempt=${a.n} status=${a.status} artifact=${a.artifact} at=${a.at}`),
  `verdict=${verdict}`,
];
console.log(lines.join('\n'));
La sortie construite est le point : le troisième essai a réussi, et l’enregistrement dit toujours que la signature s’est répétée.
attempts=3 failures=2
attempt=1 status=failed artifact=storage-dump:t1.json at=2026-11-10T09:00:12Z
attempt=2 status=failed artifact=storage-dump:t2.json at=2026-11-10T09:00:48Z
attempt=3 status=passed artifact=trace:t3.zip at=2026-11-10T09:01:30Z
verdict=repeated_signature
Trois règles rendent la politique applicable. Nommez la preuve par cause et non par fichier, afin que storage-dump et trace se distinguent d’un coup d’œil. Gardez les essais dans l’ordre avec leurs horodatages, afin qu’un relecteur voie si l’échec était immédiat ou tardif. Et faites du verdict un champ dérivé plutôt qu’un jugement humain, afin que le rapport ne puisse pas qualifier silencieusement d’instable un échec répété.
Deux règles supplémentaires relèvent du rapport et non du constructeur. D’abord, publiez le nombre d’échecs à côté du nombre de réussites, car une suite qui ne rapporte que les statuts finaux cache les échecs relancés jusqu’à disparition. Ensuite, conservez la preuve de chaque essai et pas seulement du dernier, car le premier essai a tourné avant tout nettoyage propre à la relance, et une suite qui remet l’état à zéro dans un hook de relance a déjà changé les conditions qui ont produit l’échec.
La portée de la relance est une troisième considération. Une relance au niveau du test donne des observations répétées d’un test ; une relance au niveau du fichier ne réexécute que les tests en échec, tandis qu’une relance configurée pour un groupe sérialisé réexécute tout le groupe, y compris les tests qui n’ont pas échoué, ce qui change quels tests partagent l’état et peut faire du second essai une expérience différente. Playwright documente aussi une relance par groupe ou par groupe sérialisé, où tous les tests du groupe sont relancés ensemble, si bien que le second essai exécute un autre ensemble de tests. Préférez la portée la plus étroite qui reproduit l’échec, et consignez la portée dans l’enregistrement de l’essai.
Une politique de relance a aussi besoin d’un responsable et d’une condition de sortie. Le responsable est celui qui peut corriger la cause, et la condition de sortie est une date avant laquelle la relance doit être retirée ou le test mis en quarantaine. Sans les deux, une relance ajoutée pendant un incident devient une infrastructure permanente que personne ne revoit, et la suite se remplit de tests dont le statut réel est inconnu.
La quarantaine est l’alternative honnête à relancer indéfiniment. Retirer un test connu comme cassé de l’ensemble obligatoire, avec sa preuve jointe et un responsable nommé, garde le signal de la suite intact pendant l’investigation. C’est un échec visible et non caché, et les échecs visibles sont corrigés.
La politique a enfin besoin d’une règle d’arrêt. Si deux essais échouent avec la même signature, cessez de relancer et changez une variable : la signature est reproductible, donc un essai supplémentaire dans la même configuration n’apporte aucune information. L’étape suivante est la comparaison témoin du tableau, pas une troisième relance. Continuer après ce point dépense du temps à produire une preuve qui existe déjà, et pousse la suite vers l’état vert par relance que la politique existe pour empêcher.
Une liste d’isolation d’état
La cause d’état mérite d’être vérifiée en premier car elle est la moins coûteuse à éliminer et la plus facile à confondre avec autre chose. Chaque élément produit une observation et non une croyance, si bien que la liste peut être parcourue avant tout diagnostic des trois autres causes.
| Vérification | Observation produite |
|---|---|
| Contexte neuf par test | Si l’échec survit à un contexte vide |
| Stockage vidé avant navigation | Si le stockage local ou de session résiduel comptait |
| Cookies vidés, pas seulement expirés | Si un cookie persistant a changé le résultat |
| Aucun profil partagé entre workers | Si deux workers ont écrit dans un même profil |
| Viewport et valeurs d’appareil fixés | Si des différences de mise en page ont changé le résultat |
| Arguments de lancement consignés | Si deux exécutions étaient configurées à l’identique |
Le modèle de fixtures et d’isolation décrit la portée qui rend un contexte neuf par test praticable. La première ligne est décisive. Si un test échoue dans un contexte partagé et passe dans un contexte neuf, la cause est l’état, et aucun ajustement de délai ne la résoudra. S’il échoue dans les deux, la cause d’état est improbable et les deux suivantes méritent l’effort.
La quatrième ligne est celle que l’exécution parallèle rend urgente. Playwright documente l’exécution parallèle comme des tests dans des workers séparés, et un worker qui réutilise un profil entre tests peut laisser de l’état au test suivant de ce worker tout en laissant les autres propres. Le résultat est un motif d’échec qui semble aléatoire selon le nombre de workers plutôt que selon le test.
La réutilisation de worker produit un second signal plus subtil : l’échec se déplace. Si le même test passe en série et échoue seulement en parallèle, et que l’assertion en échec change entre les exécutions, la cause est presque certainement un état partagé traversant une frontière de worker. Consigner l’identifiant de worker avec chaque essai transforme cela de soupçon en motif, car les essais en échec se regrouperont sur un worker.
Vider le stockage n’est pas la même chose que vider les cookies, et ni l’un ni l’autre n’équivaut à démarrer un contexte neuf. Le stockage local, le stockage de session, IndexedDB, le cache du service worker et le cache HTTP survivent à des réinitialisations différentes, et un test qui dépend de l’un continuera d’échouer après avoir vidé les autres. La réinitialisation complète la moins coûteuse est un contexte de navigateur neuf par test, qui est aussi l’observation produite par la première ligne.
Les service workers méritent leur propre ligne car ils survivent à un rechargement et peuvent servir une réponse obsolète longtemps après le stockage que le test croit avoir vidé. Un test qui échoue à la première exécution après un déploiement et passe ensuite lit souvent une réponse en cache d’un worker enregistré par un test précédent. Consigner si un service worker était enregistré au moment de l’échec est la preuve qui sépare cela d’une cause réseau.
Le dernier élément de la liste est celui qui rend les cinq autres reproductibles. Deux exécutions avec des arguments différents ne sont pas la même expérience, et un échec qui n’apparaît que dans l’une peut être une différence de configuration plutôt que de code. Consigner ensemble les arguments, le hash de profil et le viewport donne au relecteur une seule chaîne comparable, et comparer deux de ces chaînes est un diff et non un débat.
La documentation de gestion des profils de BotBrowser documente que chaque lancement utilise son propre user-data-dir, ses cookies et ses réglages de session, et qu’au sein d’un processus le stockage, les cookies et les réglages de contexte sont isolés par BrowserContext. Sa documentation de configuration des profils énumère les entrées d’environnement qu’un profil porte, comme les paramètres régionaux, le fuseau horaire, l’écran et WebGL. Ensemble, elles éliminent un mécanisme d’état entre tests : un contexte ou un lancement neuf ne peut pas hériter du stockage du test précédent. C’est plus étroit qu’éliminer la cause d’état en général, et cela ne dit rien du timing, du réseau ou de la conception de test, si bien qu’une suite avec un problème de timing reste instable avec un profil parfait.
Questions fréquentes
Un test qui passe à la relance est-il un test instable ?
C’est un test avec un échec non attribué. La relance a changé le résultat, pas la cause. Conservez la preuve du premier essai et attribuez l’échec avant de conclure que le test est sain.
Peut-on supprimer l’instabilité en augmentant les délais ?
Seulement si la cause est le timing, et seulement après que la trace montre que l’attente était le facteur limitant. Augmenter un délai pour une cause d’état ou de réseau cache l’échec plus longtemps sans le changer.
Pourquoi un test échoue-t-il sur un seul runner ?
Cette signature indique une dérive d’environnement : arguments de lancement, profil ou viewport différents. Consignez les trois pour les deux exécutions et comparez-les avant de chercher un bug du framework.
BotBrowser rend-il une suite instable déterministe ?
Non. Il documente l’isolation du stockage par lancement et par contexte, qui supprime un mécanisme derrière la cause d’état partagé. Les causes de timing, de réseau et de conception de test demeurent, et aucune configuration de navigateur ne rend une suite déterministe à elle seule.
Sources
- Relances de test Playwright
- Fixtures Playwright
- Exécution parallèle Playwright
- Gestion des profils BotBrowser
- Configuration des profils BotBrowser
- Cohérence d’automatisation BotBrowser
Conclusion pratique
Capturez le premier essai en échec avant toute relance, attribuez l’échec à l’état, au timing, au réseau ou à l’environnement grâce à la preuve qui les sépare, et ne changez qu’une chose ensuite. Gardez les relances comme dispositif d’enregistrement : chaque essai avec sa preuve et son horodatage, un verdict dérivé et une règle d’arrêt dès que deux essais échouent de la même manière. Testez d’abord le mécanisme d’état partagé car c’est le moins coûteux à vérifier, et rappelez-vous que l’isolation du stockage par contexte ne traite que ce mécanisme.
Articles Connexes
Selenium Grid : pourquoi deux nœuds divergent
ComparaisonProtection du moteur et de l’API : comparaison reproductible
DémarrageCycle de vie et état de stockage de BrowserContext avec Playwright
EmpreinteCe que les suites de détection publiques testent vraiment
DémarrageFiabiliser les tests de transfert de fichiers dans le navigateur
IdentitéHygiène des données et de l’état pour l’automatisation du navigateur
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.