Scraper bloqué : erreurs DNS, TLS, HTTP et de page
Localisez un scraper bloqué à la dernière couche établie : DNS, TLS, HTTP ou exécution. Conservez la réponse sans inventer une cause antibot.
BotBrowser Team
Vous voulez la documentation structurée pour Réseau ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
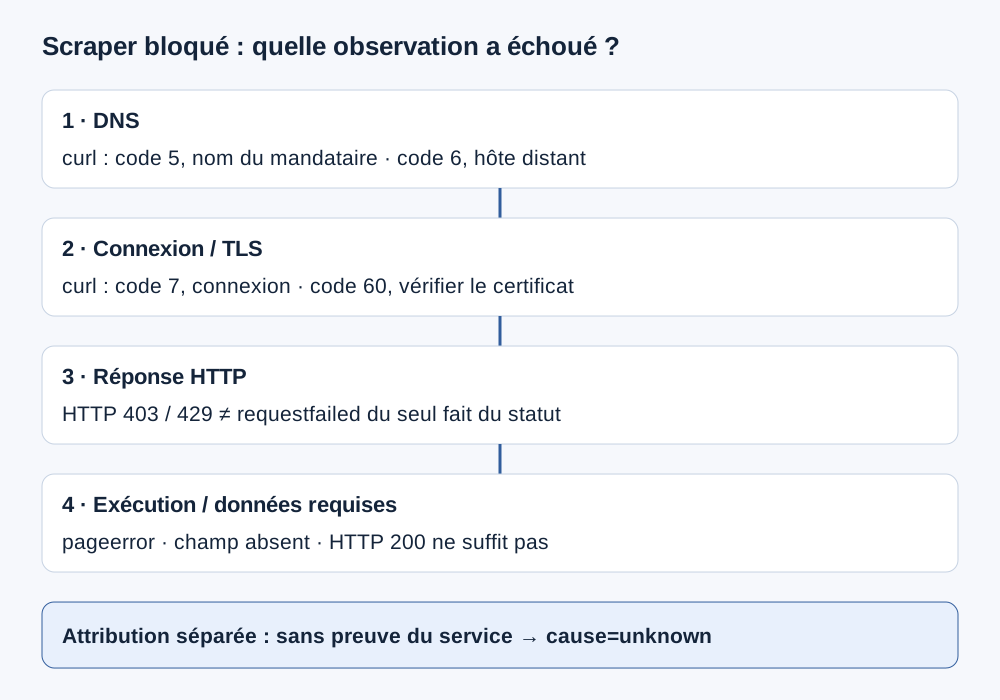
Un message de scraper bloqué désigne un incident, pas un diagnostic. Une résolution impossible, une erreur de certificat, un HTTP 403 et un panneau vide établissent des faits différents. BotBrowser documente les surfaces du navigateur pilotées par profil et la configuration d’automatisation, mais ne garantit pas l’accès et ne supprime pas la politique du serveur. Avant de modifier navigateur, proxy ou charge, localisez la dernière étape étayée par la requête défaillante. Le résultat utile peut rester une panne localisée dont la cause serveur est inconnue. guide de continuité entre exécutions distingue rétention des cookies, couverture de capture et acceptation serveur après un nouveau contexte ou processus. Pour une réponse HTTP de ces fournisseurs, les signaux de réponse Cloudflare et DataDome distinguent les marqueurs documentés des décisions internes inconnues.
Lorsque les données exploitables laissent place à un défi pendant le même traitement, le diagnostic d’un CAPTCHA pendant le scraping relie la dernière réponse utile au premier défi sans transformer la séquence en cause.
Résumé
- Identifiez la requête défaillante, pas seulement la page apparemment bloquée. Document et requête de données peuvent avoir des résultats différents.
- Distinguez absence de réponse et refus reçu. HTTP 403 ou 429 reste une réponse.
- Séparez DNS, connexion/TLS et exécution ; aucun de ces échecs n’identifie seul un modèle antibot.
- Une requête en terminal observe un autre client, pas une copie de la session du navigateur.
- Respectez l’accès documenté. Une règle exige la documentation du service ou des journaux serveur autorisés.
Sommaire
- Identifier la requête et la fenêtre d’observation
- DNS : nom et répondant HTTP sont distincts
- Connexion et TLS : conserver l’erreur réelle
- HTTP : un refus reste une réponse
- Exécution de page et acceptation des données
- Cinq lignes diagnostiques et une limite d’attribution
- La configuration BotBrowser n’est pas un verdict serveur
- Conclusion pratique
Identifier la requête et la fenêtre d’observation
Partez d’un incident autorisé : révision de l’intégration, versions du navigateur et du framework, rôle de la requête, heure et référence de route expurgée. Un identifiant opaque comme requestId relie l’événement navigateur au journal de votre serveur sans divulguer les identifiants secrets. Document principal, requête de données et image ne sont pas des preuves interchangeables. Notez l’élément défaillant et l’acceptation des données requises avant d’attribuer un résultat à toute la page. Le modèle de suivi des positions sépare localisation, langue ou appareil configurés du contexte effectif du moteur et garde l’ordinal de la source distinct de la position moyenne Search Console.
Par exemple, un document HTTP 200 peut charger l’interface alors que sa requête de données reçoit 403. Une capture de l’interface n’identifie pas la requête refusée. À l’inverse, une image décorative absente n’invalide pas nécessairement les données. Ces cas sont illustratifs, pas des échanges capturés. Définissez le champ ou résultat requis à l’avance, puis reliez-le à la requête et à la réponse précises au lieu de juger uniquement la capture finale.
Limitez la fenêtre d’observation et conservez la première défaillance pertinente. Les nouvelles tentatives d’une bibliothèque ne doivent pas remplacer l’événement initial par un succès ultérieur ou un timeout générique. Distinguez requête non envoyée, envoyée sans réponse, réponse reçue et résultat applicatif accepté. Ce sont des états d’incident proposés, pas des codes HTTP supplémentaires. lastEstablishedStage classe localement ; ce champ ne constitue pas une explication donnée par le serveur.
Consignez les changements entre observations. Si proxy, version, état applicatif et concurrence changent ensemble, un autre résultat ne désigne pas la variable responsable. Conservez la configuration autorisée initiale et la panne, puis examinez une question bornée. N’augmentez pas répétitivement le trafic et ne changez pas de compte pour découvrir les limites du service. L’absence de preuve impose de laisser la cause ouverte, pas de choisir une étiquette plus affirmative.
DNS : nom et répondant HTTP sont distincts
Le glossaire DNS de MDN décrit le système associant noms de domaine et ressources, notamment adresses IP. Un échec de résolution précède l’établissement d’une réponse HTTP de cette destination. Il ne prouve pas à lui seul un rejet du navigateur par l’application. Gardez nom d’hôte, contexte du résolveur et catégorie d’erreur ensemble : faute de saisie, résolveur indisponible et réponse de politique nécessitent des preuves distinctes.
La référence des erreurs curl distingue l’erreur 5, nom du proxy non résolu, de l’erreur 6, hôte distant non résolu. Avec un proxy, une erreur sur son extrémité ne prouve pas l’échec du nom de destination. Conservez client et configuration réellement employés. Une résolution réussie dans un autre terminal n’établit pas quel résolveur le navigateur ou le proxy utilisait pour la requête défaillante.
Une adresse déjà en cache n’équivaut pas à une nouvelle résolution observée. Notez si le diagnostic a réellement effectué une recherche, sans supposer que toute connexion réussie a sollicité DNS. Une durée isolée ne révèle pas l’état interne du résolveur. Sur votre service, corrélez les journaux de résolution ou de passerelle dans la même fenêtre ; sur un service externe, conservez l’erreur visible sans affirmer une décision d’infrastructure non observée.
L’action bornée consiste à vérifier le nom et le chemin de résolution configurés dans l’environnement autorisé. Préservez l’entrée originale avant de corriger une faute évidente. Si la panne ne se reproduit pas hors du navigateur, décrivez cette différence au lieu d’accuser son empreinte. Un incident DNS n’établit encore ni contenu, ni statut, ni politique d’une réponse HTTP.
Connexion et TLS : conserver l’erreur réelle
Résolution et connexion sont des observations différentes. Une adresse résolue ne prouve pas la connexion à la destination ou au proxy. L’erreur curl 7 indique un échec de connexion, la 28 un délai d’opération dépassé ; cette dernière ne localise pas seule une étape du protocole. Conservez la catégorie du client et tout relevé spécifique au lieu de transformer chaque panne de connexion en blocage du site.
Le glossaire TLS de MDN décrit la protection des communications. Une erreur de validation de certificat établit un problème de confiance observé par ce client, pas une réponse HTTP d’autorisation. Curl distingue l’erreur TLS 35 de la vérification du certificat du pair 60. L’analyse de confiance des connexions navigateur détaille certificats et confiance ; tout échec TLS ne doit pas devenir une preuve de détection d’empreinte.
Pour une destination diagnostique propre ou explicitement autorisée, cette commande consigne l’observation d’un client distinct. Affectez d’abord l’URL permise à DIAGNOSTIC_URL. Elle effectue un GET, abandonne le corps, maintient la validation du certificat, limite la durée et ne suit ni redirection ni nouvelle tentative automatique. La sortie est un format proposé, pas le résultat d’une exécution réussie :
code=0
curl --disable --silent --show-error --max-time 20 --output /dev/null \
  --write-out 'http_code=%{http_code}\ntime_namelookup=%{time_namelookup}\ntime_connect=%{time_connect}\ntime_appconnect=%{time_appconnect}\n' \
  "${DIAGNOSTIC_URL:?Set an owned or authorized diagnostic URL}" || code=$?
printf 'curl_exit=%s\n' "$code"
Les durées sont des entrées diagnostiques, pas la preuve que chaque étape nommée a été exécutée à nouveau. Réutilisation des connexions et route choisie influencent leur interprétation. Cookies, résolveur, proxy et comportement TLS du terminal peuvent différer du navigateur. Un accord peut corroborer un symptôme et un désaccord orienter l’enquête ; aucun ne reproduit la session navigateur. Utilisez la même fenêtre déclarée et gardez l’identité du client dans le relevé.
N’ajoutez pas d’option désactivant la sécurité du certificat pour afficher un succès. Sur votre infrastructure, examinez validité, noms attendus et confiance configurée avec l’opérateur responsable. Pour un tiers, conservez la panne et utilisez l’intégration prise en charge. Une connexion TLS achevée n’implique ni autorisation de la prochaine requête HTTP ni acceptation des données applicatives.
HTTP : un refus reste une réponse
La référence HTTP de MDN distingue les classes de réponse, dont erreurs client et serveur. Un HTTP 403 observé établit un refus de cette requête ; il n’identifie ni détecteur, ni incohérence d’empreinte, ni règle de compte sans preuve supplémentaire. Un 429 est une réponse de limitation de débit, à classer séparément. Le relevé de décision de limitation explique Retry-After facultatif et planification à budget fini sans déduire la clé de comptage.
La documentation Playwright de requestfailed distingue défaillance réseau et réponse HTTP d’erreur. Un 404 ou 503 reçu reste une réponse : son statut seul ne déclenche pas requestfailed. Cette distinction évite aussi de perdre un 403 dans une catégorie trompeuse d’erreur réseau. Installez les écouteurs avant l’action autorisée et séparez statut reçu et requête défaillante.
Cet enregistreur se rattache à un Page Playwright fourni. Il ne lance pas de navigateur, ne navigue pas, ne réessaie pas et ne modifie aucun réglage. L’appelant contrôle emit et doit expurger les erreurs sensibles avant conservation. La référence pageerror décrit l’événement séparé d’exception non interceptée :
export function attachDiagnosticListeners(page, emit) {
  page.on('response', response =>
    emit({
      event: 'response',
      status: response.status(),
      role: response.request().resourceType(),
    })
  );
  page.on('requestfailed', request =>
    emit({
      event: 'requestfailed',
      role: request.resourceType(),
      error: request.failure()?.errorText ?? null,
    })
  );
  page.on('pageerror', error =>
    emit({
      event: 'pageerror',
      name: error.name,
    })
  );
}
Les événements omettent volontairement URL et secrets. Le dispositif appelant doit encore ajouter une association de requête expurgée et un horodatage ; le type de ressource ne distingue pas plusieurs appels de données. L’ordre d’événements de requêtes indépendantes ne forme pas une chaîne causale. Un événement de réponse établit son arrivée, pas la réception complète du contenu ni son acceptation applicative. Conservez séparément ces résultats ultérieurs.
Exécution de page et acceptation des données
La réponse du document n’est pas un verdict d’exécution. Exception non interceptée, ressource défaillante et champ absent sont des observations distinctes. Localisez-les avec pageerror, requestfailed et les réponses, puis vérifiez la condition de données déclarée. Une exception peut interrompre une opération pertinente ou être sans rapport ; sa présence seule ne prouve pas qu’un script antibot a arrêté la collecte.
Pour une fixture propre, définissez une condition de disponibilité stable et un petit résultat attendu avant observation. Pour une intégration externe, utilisez son contrat de résultat documenté plutôt qu’un titre visible érigé en succès. Un document HTTP 200 peut contenir connexion au compte, erreur de service ou autre état. Gardez classification du contenu et statut HTTP ensemble, sans réécrire ce dernier pour exprimer le résultat applicatif.
Conservez le contexte reliant le champ absent à sa requête productrice ou à l’étape de script. La requête peut ne jamais être partie, avoir reçu un refus ou avoir renvoyé des données non appliquées par la page. Les investigations diffèrent. Un timeout de sélecteur n’est pas un refus serveur observé : il établit seulement que la condition n’a pas été satisfaite dans la fenêtre configurée. Notez attente bornée et condition réellement attendue.
Comparer exige mêmes révision applicative, état initial et séquence permise. Si une observation démarre connectée et l’autre sans cet état, la différence ne prouve pas une détection de navigateur. Vérifiez la session ou l’opération autorisée requise avant d’attribuer un panneau vide à un signal matériel. Excluez les données privées des comptes des journaux publics ; une référence opaque peut relier l’incident aux relevés opérationnels protégés.
Cinq lignes diagnostiques et une limite d’attribution
Les quatre premières lignes décrivent des étapes observables côté client. La cinquième concerne l’attribution à une politique, notamment une prétendue règle comportementale ; ce n’est pas un cinquième échange protocolaire visible pour chaque requête. Seuls documentation du service, support autorisé ou relevé de décision de votre serveur peuvent établir la règle de cet incident. Une page de défi inconnue ou un résultat différent ne remplace pas cette preuve.
| Ligne diagnostique | À conserver | Décision suivante bornée |
|---|---|---|
| DNS | Client, nom configuré, contexte du résolveur et erreur | Vérifier la résolution ; aucune cause HTTP établie |
| Connexion/TLS | Référence de route, erreur de connexion ou confiance | Examiner l’étape sans désactiver la confiance |
| HTTP | Requête répondue, statut et en-têtes choisis | Appliquer la politique documentée ; ne pas nommer de détecteur |
| Script/données | Exception, résultat de ressource et champ requis | Localiser la condition absente sans renommer la réponse |
| Politique du service | Règle documentée ou cause=unknown | Consulter l’opérateur ; arrêter sans permission |
Séparez champs observés et interprétations. httpStatus=403 est observé ; cause=unknown peut rester correct après localisation de la réponse. « Probablement un score comportemental » est une hypothèse non confirmée, pas un fait. Si une preuve serveur identifie ensuite une règle d’accès, ajoutez sa référence et son heure sans modifier l’observation originale du navigateur.
Même votre journal serveur doit correspondre à l’incident. Corrélez identifiants, fenêtre, ressource et composant répondant ; refus de passerelle et d’application peuvent découler de décisions différentes. Un document général expose des règles possibles ; un relevé associé explique une réponse précise. Sans ce relevé chez un tiers, limitez la conclusion et passez par l’accès ou le support pris en charge, sans sonder une décision invisible.
La configuration BotBrowser n’est pas un verdict serveur
La documentation de cohérence d’automatisation BotBrowser décrit réglages par profil et configuration du framework. La présentation des empreintes décrit les surfaces du moteur contrôlées par profils. Ce sont des capacités de configuration, pas l’explication d’un refus serveur. Gardez binaire, référence du profil et réglages du framework, sans confondre intention de configuration et résultat distant vérifié.
Modifier une surface ne démontre pas à soi seul qu’un DNS est réparé, qu’un certificat est fiable ou qu’un quota autorise une requête supplémentaire. Le proxy modifie la route déclarée ; une différence après changement n’explique pas le refus initial. Préservez l’observation et cherchez la preuve à la couche localisée. Configurer le navigateur ne fournit ni autorisation ni garantie de données acceptées.
FAQ
Un 403 prouve-t-il une détection d’empreinte ?
Non. C’est un refus HTTP. La règle nécessite une preuve du service ou une explication documentée liée à la requête, pas un nom de détecteur supposé.
Une erreur HTTP est-elle une requête échouée dans Playwright ?
Pas uniquement à cause du statut. Playwright distingue réponse reçue et échec d’obtention d’une réponse. Conservez les deux événements et leur association à la requête.
Un succès curl prouve-t-il que le navigateur devrait fonctionner ?
Non. Curl est un autre client avec ses propres état et configuration. Il peut corroborer une observation, sans reproduire la session navigateur.
Un défi visible suffit-il à identifier une règle comportementale ?
Non. Gardez état visible, réponse et séquence. La cause de politique reste inconnue sans preuve du service responsable.
Sources
- MDN : statuts de réponse HTTP
- MDN : DNS
- MDN : TLS
- curl : codes d’erreur
- curl : options de ligne de commande
- Playwright : événement requestfailed
- Playwright : événement pageerror
- BotBrowser : cohérence d’automatisation
- BotBrowser : présentation des empreintes
- Confiance des connexions navigateur
- Décisions de limitation du scraping
Conclusion pratique
Localisez la requête défaillante et préservez la dernière étape étayée. Distinguez panne DNS ou TLS, refus HTTP et condition de données non satisfaite avant de modifier les réglages. Sans source responsable, laissez inconnue l’attribution à une politique. Conservez réponse ou erreur et examinez cette étape dans l’intégration autorisée, sans transformer un vague blocage en verdict inventé de détecteur.
Cet article fait partie du guide : Vue d’ensemble de la configuration proxy : carte des décisions réseau
Articles Connexes
CAPTCHA pendant le scraping : diagnostiquer le changement
RéseauCloudflare et DataDome : réponses au scraping
RéseauLimites de scraping : 429, Retry-After et concurrence
RéseauRotation de proxy : limites de session en scraping
RéseauDNS sur TLS : confidentialité, déploiement et pannes
RéseauCertificats TLS et confiance de la connexion du navigateur
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.