Navegador para web scraping: ¿qué tipo necesitas?
Elige entre controlar un navegador, usar una API de resultados o una extensión según el control de página, el estado, los permisos y la responsabilidad ante fallos.
BotBrowser Team
Quieres la documentación estructurada de Primeros pasos?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
Un navegador para web scraping puede ser un navegador que controla tu código, un servicio que devuelve un resultado solicitado o una extensión que extrae información de un documento en tu navegador. Son interfaces distintas, aunque las tres utilicen Chromium en algún punto. BotBrowser documenta un ejecutable controlado mediante Playwright cuya configuración parte del perfil; no sustituye una API de extracción alojada ni una extensión, y no garantiza que un sitio permita recopilar datos. La primera elección útil es el control que necesita tu tarea, no el nombre del navegador en una lista comparativa. Validar el artefacto devuelto es distinto de elegir la interfaz del navegador; consulta qué demuestra una respuesta de API de scraping.
Resumen
- Elige el control del navegador cuando tu aplicación deba seguir interactuando con una página y decidir la siguiente acción a partir de su estado.
- Elige un punto de acceso de resultados cuando su respuesta documentada sea suficiente; una API HTTP también puede ejecutar un navegador y devolver HTML renderizado.
- Elige una extensión cuando la extracción forme parte de un flujo de navegación permitido y su acceso a documentos, permisos y salida se ajusten a la tarea.
- Un navegador alojado puede seguir bajo el control de tu código de automatización. Alojar el proceso no transfiere automáticamente la lógica de extracción al proveedor.
- Mantén separados el acceso del navegador, la autorización de la aplicación y el permiso para utilizar los datos recopilados. Ninguno se deriva de una conexión o exportación satisfactoria.
Contenido
- Tres significados, cuatro modalidades operativas
- Controlar el navegador significa decidir la siguiente acción
- Una API de resultados tiene otro contrato
- Una extensión opera dentro de un límite de permisos
- Investigar un resultado vacío desde el primer límite que falla
- Elegir la interfaz mínima suficiente
- Conclusión práctica
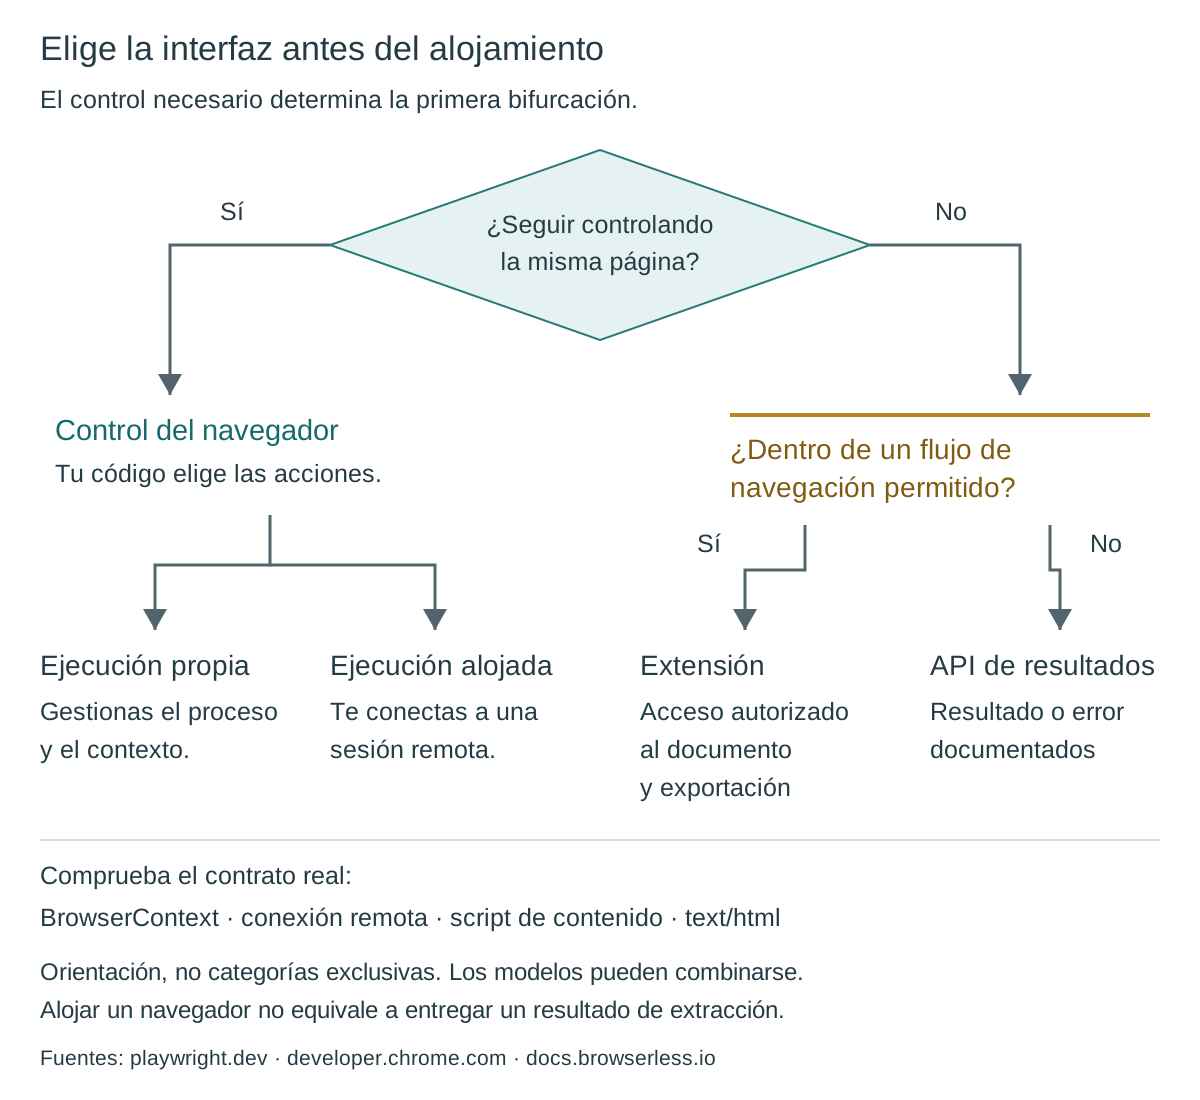
Tres significados, cuatro modalidades operativas
La expresión mezcla una capacidad con su forma de ofrecerse. Un navegador ejecuta un documento y permite interactuar con él. Una biblioteca de automatización controla un navegador. Un servicio puede ofrecer control del navegador o un resultado terminado. Una extensión puede leer un documento permitido y proporcionar una exportación. Un mismo proveedor puede ofrecer más de una modalidad, por lo que la página principal del producto no basta para identificar el contrato. Examina la interfaz concreta que utilizará la integración. La referencia de conexión del navegador de Playwright describe el control de un navegador existente; un punto de acceso que devuelve text/html tiene un límite de salida diferente.
La distinción práctica es qué ocurre después de la primera respuesta. ¿Puede tu código examinar una página y seguir haciendo clic o navegando en la misma sesión controlada? ¿Recibe un documento HTML terminado o registros y después realiza otra solicitud para continuar el trabajo? ¿O una función opera sobre el documento ya abierto en un perfil de navegador permitido? Estas preguntas separan interacción, entrega de resultados y acceso a documentos sin establecer una clasificación de calidad. Una tarea puede combinarlos, pero cada transición necesita un responsable explícito.
| Modalidad | Qué recibe tu aplicación | Quién ejecuta el navegador o la tarea | Primera pregunta sobre responsabilidad |
|---|---|---|---|
| Control de navegador operado por tu equipo | Un navegador, un contexto y una página controlables | Tu equipo de ejecución | ¿Quién mantiene el ejecutable, el contexto y el cierre? |
| Control de navegador alojado | Una conexión remota a una sesión de navegador | El proveedor del servicio; tu código sigue dirigiendo la página | ¿Qué contrato de conexión y sesión utiliza el cliente? |
| API de resultados alojada | El resultado o error documentado del punto de acceso | El proveedor del servicio detrás de ese punto de acceso | ¿Es suficiente el elemento devuelto y quién valida sus campos? |
| Extensión del navegador | El acceso a documentos y la exportación que admite la extensión | El operador del navegador o perfil junto con la implementación de la extensión | ¿Qué documentos y acciones tienen acceso concedido? |
Esta matriz precede a los seis criterios para elegir un navegador. Esa tabla de evaluación compara configuraciones candidatas una vez elegido el control del navegador como interfaz. No sustituye la decisión de si hace falta una sesión de navegador. Del mismo modo, la comparación del modo sin interfaz visible trata del ejecutable y del modo de inicio después de elegir la vía del navegador. Que un navegador funcione sin una ventana visible no lo convierte, por ese hecho, en un servicio alojado ni en una API de extracción.
Las filas no son categorías de productos excluyentes. Una extensión puede llamar a un servicio remoto y un navegador alojado puede admitir un punto de acceso de resultados separado. Un programa operado por tu equipo puede envolver su propio navegador en un servicio HTTP interno. Describe el límite que consume tu aplicación en lugar de suponer que todo el sistema pertenece a una sola fila. Así también se mantiene visible la responsabilidad cuando un componente que funciona correctamente entrega un elemento incompleto al siguiente.
Controlar el navegador significa decidir la siguiente acción
El control del navegador resulta útil cuando la extracción depende de estados sucesivos de una página. Una aplicación propia podría mostrar un panel de detalles solo después de una acción del usuario, recorrer un flujo de trabajo o actualizar una tabla tras cambiar un ajuste. Con una interfaz de control del navegador, tu código elige la acción, observa el documento resultante y decide si hace falta otra acción. La biblioteca Playwright proporciona contextos de navegador y páginas para estos flujos. No elige el registro de negocio necesario ni decide qué campo ausente es aceptable.
En un proceso operado por tu equipo, el equipo de ejecución es responsable de la disponibilidad del navegador. El ejecutable debe existir, disponer de las dependencias necesarias y arrancar con la cuenta prevista. Su ciclo de vida también necesita un final deliberado: cerrar una pestaña no sustituye la definición de cómo se gestionan el proceso, los contextos y el estado temporal. La configuración de Playwright de BotBrowser describe la selección de su ejecutable y de las entradas del perfil. Esos pasos de configuración dejan la navegación de la aplicación, la extracción, la validación de registros y la programación de tareas en manos de quien realiza la llamada.
El estado necesita su propia decisión. Playwright distingue los contextos de navegador limpios de un contexto persistente iniciado con un userDataDir. Su documentación indica que el inicio persistente devuelve el único contexto y que cerrar ese contexto cierra el navegador. También advierte contra automatizar el perfil habitual de usuario de Chrome y recomienda un directorio de automatización separado. Por tanto, un operador no debe esperar que un proceso de scraping recién iniciado herede el estado de inicio de sesión cotidiano de una persona. Utiliza el contrato documentado del contexto persistente en lugar de tratar como intercambiables todas las carpetas llamadas perfil.
Un contexto limpio también es una elección deliberada. La guía de aislamiento de Playwright describe cookies y almacenamiento separados para sus contextos de prueba. Playwright Test crea esos contextos automáticamente, mientras que quienes utilizan la biblioteca pueden crearlos explícitamente. Este límite de almacenamiento mejora la reproducibilidad, pero no convierte los contextos en máquinas físicas separadas ni demuestra anonimato. Si una aplicación propia necesita un idioma seleccionado o el estado de una cuenta de prueba permitida, registra si el contexto debe comenzar vacío o conservar ese estado. La ausencia de una preferencia en un contexto intencionadamente limpio no es necesariamente un defecto de inicio.
El alojamiento cambia al operador del entorno de ejecución sin cambiar necesariamente la interfaz de control. Playwright puede conectarse a un navegador que se ejecuta remotamente, y su método connectOverCDP se conecta mediante Chrome DevTools Protocol. La documentación limita esa conexión CDP a navegadores basados en Chromium y señala una fidelidad menor que la conexión mediante el protocolo de Playwright. Esto importa cuando la conexión remota funciona, pero una función concreta de automatización se comporta de otra manera. Comprueba el método de conexión y las versiones admitidos antes de atribuir un problema de extracción a la página. Un punto de acceso remoto sigue siendo un canal de control, no un registro de datos terminado.
La lógica de quien realiza la llamada sigue siendo importante después de conectarse. Si tu programa elige los selectores, espera un estado del documento y construye el registro, el proveedor no asume esas responsabilidades por el simple hecho de ejecutar el proceso. A la inversa, un proveedor puede ofrecer tareas gestionadas adicionales bajo otro contrato. Mantén esos productos separados en el diseño de la integración. Para esta elección inicial, pregunta si tu código necesita controlar la página de forma continuada y si tu equipo quiere operar el entorno de ejecución. Las cuestiones detalladas sobre estado del proveedor, redes regionales y adopción corresponden a la siguiente decisión de implementación, no a una afirmación de que todos los entornos alojados quedan fuera del control del cliente.
Una API de resultados tiene otro contrato
Un punto de acceso de resultados acepta una solicitud documentada y devuelve un elemento documentado. Ese elemento puede ser HTML de origen, HTML renderizado, una imagen o campos estructurados; no son intercambiables. La documentación de Content API de Browserless ofrece un ejemplo concreto: su punto de acceso /content describe cómo renderiza una URL o HTML proporcionado en un navegador y devuelve text/html, incluido contenido renderizado mediante JavaScript. Por tanto, que quien llama utilice una solicitud HTTP no demuestra que el servicio haya prescindido de ejecutar un navegador.
La pregunta útil es si esa respuesta contiene todo lo que necesita la siguiente etapa. Si un analizador posterior solo requiere el documento renderizado en un estado definido, una interfaz de resultados puede ser suficiente. Si quien llama debe examinar un diálogo intermedio y decidir la siguiente acción, una respuesta HTML sencilla no proporciona por sí sola control continuado de la página. Algunos servicios ofrecen esperas configurables o tareas adicionales, pero hay que comprobarlo en el contrato actual del punto de acceso elegido. No lo deduzcas del uso de la palabra navegador por parte del proveedor.
El renderizado y la extracción también son servicios distintos. Devolver HTML no significa que el servicio haya seleccionado los identificadores correctos de los artículos, interpretado una moneda o comprobado que existen todos los registros necesarios. Un punto de acceso de extracción estructurada puede asumir algunas de esas funciones, pero solo en los términos especificados. El responsable de la integración sigue necesitando validar la salida conforme al esquema de la aplicación. En un registro hipotético de catálogo, recibir un documento y obtener un valor price válido son resultados distintos. La falta de información sobre la moneda no se repara calificando de satisfactoria la solicitud HTTP.
Un error del punto de acceso no es el único resultado incompleto posible. Una respuesta puede llegar con el tipo de medio esperado y contener, sin embargo, un documento de inicio de sesión, un mensaje de elemento no encontrado, un error de la aplicación o una página cuyo contenido necesario todavía no ha aparecido. Trata el elemento devuelto según su significado antes de analizarlo como si fueran los datos de negocio solicitados. El diagnóstico de renderizado y paginación aborda la preparación del contenido; pasar de una biblioteca de navegador a una API no elimina la necesidad de definir qué significa que un documento esté terminado.
El estado y la conservación también son cuestiones contractuales aquí. Una interfaz HTTP no demuestra una ejecución sin estado, persistencia automática ni eliminación después de responder. Pregunta qué funciones de sesión ofrece realmente el punto de acceso y qué datos cubren sus condiciones de tratamiento. La misma cautela se aplica a los reintentos: una segunda solicitud puede repetir la tarea en lugar de reanudar una página anterior. No dependas de ninguno de esos comportamientos sin documentación. Se trata de una distinción de interfaces, no de afirmar que las API de resultados ofrecen menos control o privacidad en todas las implementaciones.
Las API de resultados pueden reducir la cantidad de código de gestión del ciclo de vida del navegador en la aplicación que las utiliza, pero no eliminan la responsabilidad sobre el alcance de las entradas, el tratamiento permitido de los datos o la clasificación de fallos posteriores. Un equipo que elija esta vía debe poder nombrar el tipo de respuesta necesario, el punto en que la tarea se considera terminada y el responsable de gestionar salidas mal formadas o incompletas. Esos requisitos constituyen el límite de aceptación; los nombres de proveedores y la comodidad del punto de acceso no los determinan.
Una extensión opera dentro de un límite de permisos
Una extensión de scraping es software que funciona mediante las capacidades de las extensiones del navegador. Puede leer un documento abierto, ofrecer una interfaz de selección, organizar registros o exportar datos, según su implementación. La documentación de scripts de contenido de Chrome describe scripts capaces de leer y modificar el DOM de una página y comunicarse con la extensión. Eso hace pertinente una extensión cuando la tarea pertenece a un flujo de navegación existente y permitido, en lugar de a un proceso de automatización iniciado por separado.
El acceso a documentos está limitado. Chrome exige permisos de host adecuados para la inyección programática de scripts de contenido; el acceso temporal mediante activeTab es una opción documentada. Las reglas de coincidencia, los marcos y el momento de inyección también determinan dónde se ejecutan los scripts. Un permiso del navegador concede a una extensión una capacidad dentro del navegador. No demuestra que el sitio web permita automatizar la recopilación ni que exista una finalidad lícita para reutilizar los datos. Que un usuario pulse una acción de la extensión no puede fusionar estas decisiones separadas en una sola aprobación.
Una extensión no tiene por qué ser exclusivamente manual. Chrome admite scripts de contenido que se ejecutan automáticamente en las páginas que coinciden con sus reglas, además de inyección dinámica y programática. Que una extensión concreta admita tareas programadas, navegación o funcionamiento desatendido depende de su implementación y entorno operativo. No elijas ni descartes toda la categoría suponiendo que cada registro necesita un clic separado. Examina, en cambio, el desencadenante admitido por la función, el alcance documental y el ciclo de vida de la salida.
El entorno de ejecución no es idéntico al entorno JavaScript de la página. Los scripts de contenido suelen ejecutarse en un mundo aislado: comparten el acceso al documento, pero no comparten automáticamente las variables de la página. Una tabla visible puede estar disponible mediante acceso al DOM mientras que un objeto interno de la aplicación no es directamente accesible desde ese contexto aislado. Esta distinción ayuda a explicar la importancia del contrato de extracción que admite una extensión. No es una receta para acceder al estado privado de la página ni ampliar el acceso más allá de los permisos concedidos.
El trabajo en segundo plano tiene otro ciclo de vida. La guía de service workers de extensiones de Chrome describe la terminación normal del worker tras un período de inactividad y su reactivación mediante eventos posteriores. Advierte que las variables globales se pierden cuando el worker se detiene y recomienda almacenamiento persistente para valores duraderos. Esto no significa que una extensión deje de funcionar cada vez que su worker queda inactivo. Significa que una tarea de varios pasos no debe suponer que un mismo proceso de segundo plano en memoria permanecerá activo durante todo el flujo. Un reinicio y una extensión desinstalada son diagnósticos diferentes.
El perfil del navegador también forma parte del límite de privacidad. Una extensión puede operar junto al estado de navegación permitido de una persona, pero hay que revisar el acceso que solicita y los destinos de los datos. Determina si los registros permanecen localmente o se envían a otro lugar a partir de la documentación y la política de la extensión concreta; ni la etiqueta de extensión ni un botón de exportación local responden a esa pregunta. Limita el alcance documental y de datos a la tarea. Si un flujo requiere un entorno desatendido aislado por separado, compara ese requisito con el control del navegador en lugar de ampliar permisos hasta que una extensión se parezca a otro modelo operativo.
Investigar un resultado vacío desde el primer límite que falla
Una exportación vacía es un síntoma compartido por todas las modalidades. La ausencia de registros no permite distinguir un problema de inicio de una denegación de acceso al documento. Un proceso de navegador podría no llegar a iniciarse; una conexión remota podría utilizar una combinación de protocolos no admitida; una API podría devolver el documento equivocado; una extensión podría carecer de acceso al marco pertinente. Solo después de comprobar esos límites tiene sentido investigar selectores o esquemas. La referencia de conexión de Playwright y las reglas de permisos de Chrome describen contratos distintos, por lo que requieren comprobaciones iniciales diferentes.
| Modalidad y síntoma hipotético | Primer límite que debe comprobarse | Siguiente comprobación y responsable |
|---|---|---|
| Una tarea operada por tu equipo no tiene página | Inicio del ejecutable y creación del contexto | El responsable del entorno comprueba el binario configurado y el resultado de inicio |
| El navegador alojado se conecta y después falla una acción | Protocolo admitido, sesión y página real | El responsable de la integración distingue la capacidad de conexión de la preparación del documento |
| El punto de acceso de resultados devuelve HTML, pero no registros | Elemento solicitado, documento recibido y campos necesarios | El responsable de la API comprueba el contrato de respuesta; el responsable de datos valida su significado |
| La exportación de la extensión está vacía en un documento | Acceso concedido, coincidencia o marco y momento de ejecución del script | El responsable del navegador o de la extensión comprueba el acceso antes de cambiar las reglas de extracción |
| La extensión pierde una tarea sin terminar después de quedar inactiva | Estado duradero de la tarea frente a variables globales del worker | El responsable de la extensión comprueba el almacenamiento y el comportamiento de reanudación por eventos |
Son ejemplos de diagnóstico, no incidentes observados ni afirmaciones sobre proveedores concretos. La tabla asigna la primera comprobación, no la causa final. Un inicio satisfactorio del navegador puede conducir aun así a un fallo en la aplicación, y un permiso válido de extensión no garantiza que una página contenga los campos esperados. Mantén suficientemente separados los resultados de cada etapa para que el éxito de una no certifique de forma implícita la siguiente.
Lo mismo se aplica al coste de recursos. Una navegación terminada, una respuesta de API recibida y un registro válido exportado tienen denominadores distintos. Compara costes solo después de definir la unidad que acepta tu aplicación. La tabla existente de evaluación de navegadores proporciona medidas de carga de trabajo una vez elegida la interfaz. Reutilizar esa tabla como clasificación universal entre salidas diferentes ocultaría quién realizó el trabajo y qué contenía realmente el resultado.
Elegir la interfaz mínima suficiente
Empieza por el elemento necesario y la siguiente decisión. Para un catálogo propio hipotético que solo requiere un documento terminado para un analizador separado, puede bastar un punto de acceso de resultados documentado. Para un flujo propio en el que el código deba elegir entre estados de página y seguir interactuando, el control del navegador es el contrato pertinente. Para un usuario autorizado que revisa un conjunto pequeño de documentos en un flujo de navegador existente, una extensión puede ser adecuada si el acceso concedido y la exportación admiten los datos necesarios. Estos ejemplos eligen interfaces, no productos ni estrategias de acceso.
Después decide dónde debe residir el estado. Un contexto limpio, un directorio de automatización explícitamente persistente, un contexto gestionado por un proveedor y el almacenamiento de una extensión tienen ciclos de vida diferentes. Registra qué estado debe sobrevivir y cuál debe aislarse. Evita importar datos ajenos del perfil cotidiano para que una tarea parezca completa. En la integración de Playwright de BotBrowser, la configuración del ejecutable y del perfil sigue siendo distinta de los registros de la aplicación; el programa de automatización continúa determinando cómo empieza y termina su tarea.
Por último, verifica un pequeño caso de prueba autorizado en el límite elegido. Comprueba que llegue el documento o registro necesario, que el estado previsto se comporte según lo declarado y que un resultado incompleto llegue al responsable correspondiente. Aquí no se informa de ninguna comparación de rendimiento ni prueba de servicio. El resultado de ese futuro caso de prueba establecería compatibilidad para la configuración examinada, no anonimato, permiso ni una promesa general de que un sitio remoto aceptará tráfico automatizado.
Preguntas frecuentes
¿Un navegador para web scraping es lo mismo que una extensión del navegador?
No. Una extensión proporciona sus funciones implementadas dentro de los permisos del navegador y del alcance documental. El software de control del navegador dirige una sesión de navegador. Ambos pueden examinar un documento, pero difieren en la interacción disponible, el ciclo de vida y las responsabilidades sobre el estado.
¿Una API HTTP de scraping significa que no se ejecuta JavaScript?
No. Un punto de acceso de resultados documentado puede ejecutar un navegador y devolver HTML renderizado. Comprueba el contrato de respuesta y de preparación del punto de acceso concreto en lugar de deducir su modelo de ejecución del transporte HTTP.
¿Alojar un navegador transfiere la lógica de extracción al proveedor?
No automáticamente. Cuando tu cliente dirige páginas mediante una conexión remota, sigue siendo responsable de su lógica de navegación y extracción, salvo que un contrato separado de tareas gestionadas asigne ese trabajo al servicio.
¿Puede una extensión ejecutarse sin hacer clic en cada página?
Algunas sí. Chrome admite scripts de contenido que se ejecutan automáticamente según reglas de coincidencia, pero el comportamiento desatendido de una extensión concreta depende de su implementación, permisos, ciclo de vida en segundo plano y entorno del navegador.
¿BotBrowser sustituye a una API de scraping o a un programador de tareas?
Su documentación citada describe la ejecución del navegador y la integración con Playwright. Eso no proporciona un esquema de extracción, una cola ni un contrato de servicio alojado. La aplicación sigue siendo responsable de esos componentes y del uso autorizado.
Una vez elegido el control de un navegador alojado, los límites de sesión y estado de Browserbase distinguen el fin de la sesión de un registro válido, la escritura del Context guardado del estado de la aplicación y la región del navegador de la salida del proxy. Esos contratos específicos del proveedor determinan qué pruebas necesita después quien mantiene la integración.
Fuentes
- Playwright: contextos de navegador y aislamiento
- Playwright: BrowserType y contratos de conexión
- Chrome: scripts de contenido
- Chrome: ciclo de vida de los service workers de extensiones
- Browserless: Content API
- BotBrowser: integración con Playwright
Conclusión práctica
Elige la interfaz necesaria antes que la marca del navegador: control continuado de la página, un resultado documentado o acceso permitido de una extensión. Si necesitas controlar el navegador, decide por separado quién opera el entorno de ejecución. Mantén explícitas las responsabilidades sobre estado, validación y fallos para que el éxito de un componente no sustituya a un registro válido ni al permiso para recopilarlo.
Este artículo forma parte de la guía: Primeros pasos con automatización de navegador: mapa inicial
Artículos Relacionados
API de scraping web: lo que oculta la respuesta
Primeros pasosWeb scraping con Browserbase: ¿quién controla qué?
Primeros pasosScraping con Playwright: navegador y perfil
Primeros pasosWeb scraping con JavaScript: render, paginar y scroll
Primeros pasosHuella del navegador en Scrapy: qué no puede configurar
Primeros pasosTwitter scraping: ventanas de API y límites del navegador
Ejecuta la misma comprobación en BotBrowser
Carga un perfil, mantén dentro del navegador las señales que acabas de leer y confirma el resultado en tu propia máquina antes del despliegue.