Twitter scraping: ventanas de API y límites del navegador
Elige el endpoint, período y autenticación para publicaciones, menciones, búsquedas e inicio de X. Distingue el HTML incrustado de los datos de API.
BotBrowser Team
Quieres la documentación estructurada de Primeros pasos?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
Los proyectos de twitter scraping suelen fallar antes del primer selector: el historial o el orden solicitado no coincide con el endpoint de X elegido. Primero hay que elegir el producto de datos, el contexto de autenticación y el período. BotBrowser permite integrar Chromium con Playwright y Puppeteer para comprobaciones de navegador autorizadas por separado; no puede conceder acceso a la API de X, ampliar el historial de los endpoints, reproducir la clasificación algorítmica ni eliminar los límites de la plataforma. El flujo de configuración del navegador corresponde a una etapa posterior, cuando realmente queda una tarea de navegador permitida.
TL;DR
- Las publicaciones de una cuenta, las menciones, el inicio cronológico y los resultados de búsqueda son conjuntos distintos con límites documentados diferentes.
- La búsqueda reciente cubre los últimos 7 días; el archivo completo se remonta a marzo de 2006, sujeto a sus requisitos de acceso.
- El endpoint de inicio cronológico inverso no reproduce la clasificación algorítmica. Una cronología incrustada devuelve marcado de presentación, no una exportación histórica de publicaciones.
- La caducidad del token de OAuth 2.0, el cómputo de solicitudes y la duración de la sesión del navegador son cuestiones separadas. Más sesiones no resuelven la falta de derechos de acceso a datos.
Contenido
- Relacionar la necesidad con un resultado de X
- Resolver tres solicitudes según el alcance histórico
- Vincular autenticación y duración con cada ruta
- Separar límites de solicitudes y observaciones del navegador
- Conclusión práctica
Relacionar la necesidad con un resultado de X
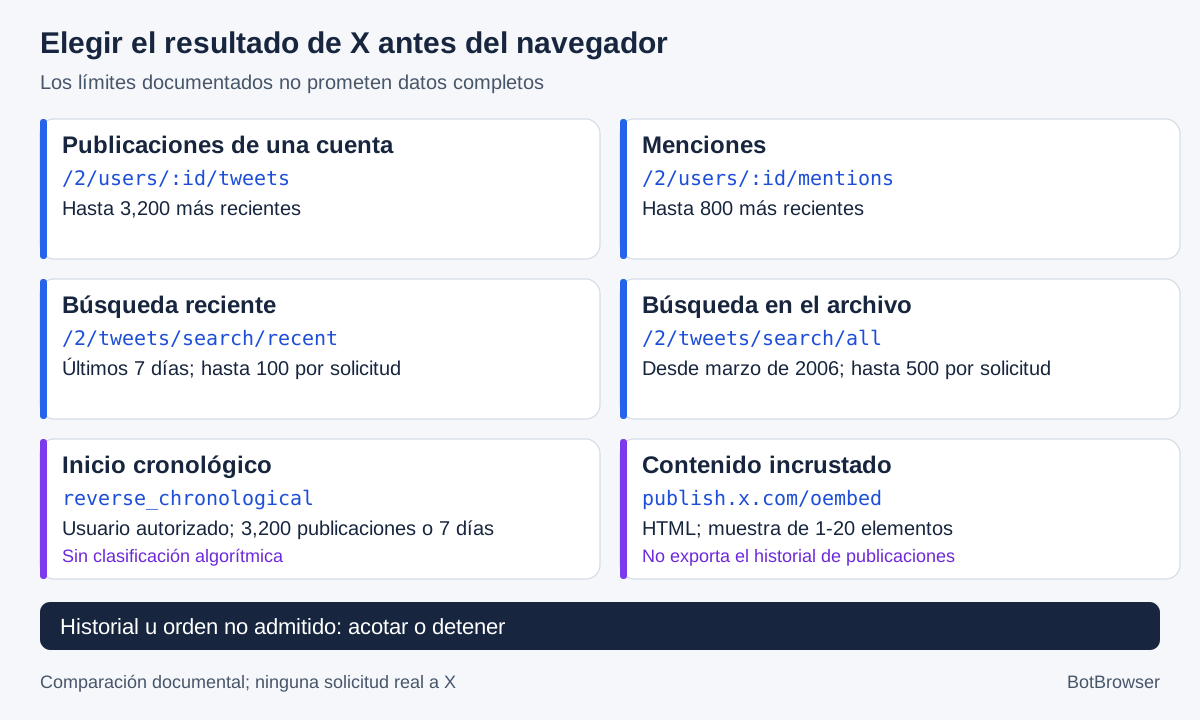
La documentación de cronologías de X distingue las publicaciones del autor, las menciones y el inicio cronológico inverso del usuario autenticado. Un cliente que necesita respuestas que mencionan su cuenta no está solicitando sus propias publicaciones. Un producto que necesita lo que una persona vio en el inicio clasificado no solicita el mismo orden que el endpoint cronológico. Esa distinción debe quedar en la especificación, en lugar de llamar «tuits» a todas las superficies.
| Resultado requerido | Ruta oficial candidata | Límite documentado y regla de elección |
|---|---|---|
| Publicaciones escritas por una cuenta | /2/users/:id/tweets | Hasta las 3,200 más recientes; los filtros y parámetros temporales no establecen un archivo de toda su existencia |
| Publicaciones que mencionan una cuenta | /2/users/:id/mentions | Hasta las 800 menciones más recientes; no sustituirlas por las publicaciones del autor |
| Inicio cronológico del usuario autenticado | /2/users/:id/timelines/reverse_chronological | Las 3,200 publicaciones más recientes o 7 días; requiere autenticación de usuario y excluye la clasificación algorítmica |
| Coincidencias de una consulta reciente | /2/tweets/search/recent | Últimos 7 días, hasta 100 por solicitud; comprobar el acceso de desarrollador y aplicación, y la consulta admitida |
| Coincidencias en un período anterior | /2/tweets/search/all | Archivo desde marzo de 2006, hasta 500 por solicitud; comprobar el acceso actual de pago por uso o Enterprise |
| Mostrar una publicación o cronología de usuario/lista admitida | https://publish.x.com/oembed | JSON con HTML de inserción; muestra de 1-20 elementos de cronología, no una exportación histórica estructurada |
| Orden algorítmico exacto del inicio | Ningún equivalente establecido por estas referencias | Detener o acotar; la visibilidad en el navegador no establece un contrato estable de extracción |
Estas cifras son máximos o períodos documentados, no promesas de devolver esa cantidad de registros. Siguen importando la disponibilidad, los filtros, la autenticación y el contrato actual del endpoint. La introducción a la búsqueda presenta la búsqueda reciente como disponible para todos los desarrolladores, pero exige cuenta de desarrollador, aplicación y tokens. «Todos los desarrolladores» no significa acceso público sin autenticación ni que cualquier proyecto esté listo para usarla.
También hay que leer la documentación con su fecha en mente. La introducción de la API describe pago por uso sin suscripciones. Algunos textos de cronologías y paginación todavía mencionan un «nivel estándar». Esas etiquetas no justifican recuperar una comparación antigua de planes fijos. Antes de presupuestar, hay que comprobar el producto ofrecido y el acceso real de la aplicación; los límites de solicitudes y los cargos por uso responden a preguntas diferentes. Aquí no se presupone ningún precio ni plan de suscripción.
El HTML de presentación tiene otro contrato de salida
La referencia canónica de oEmbed describe un contenedor JSON cuyo contenido de presentación es HTML reconocido por el JavaScript de widgets de X. Los parámetros de cronología permiten mostrar de 1 a 20 elementos. Esa cifra controla la presentación incrustada; no es el tamaño de página para recopilar el historial de una cuenta. El formato JSON no convierte por sí solo un endpoint en una API de datos estructurados de publicaciones.
La misma referencia advierte que el marcado puede cambiar y recomienda almacenarlo según la duración de caché sugerida por la respuesta. Hay que mantener cache_age asociado a esa respuesta de presentación, sin tratar el fragmento almacenado como registro permanente del texto o la disponibilidad. La ausencia documentada de autenticación y limitación de solicitudes corresponde a ese recurso de inserción, no a la búsqueda, las cronologías, la reutilización sin restricciones ni todas las solicitudes futuras. No se realizó ninguna solicitud real a oEmbed para esta comparación.
Mostrar contenido de X también tiene condiciones ajenas al esquema de respuesta. La Política para Desarrolladores vigente cubre presentación pública, privacidad y redistribución; sus reglas abordan la actualización del contenido y su retirada cuando deja de estar disponible. La inserción no resuelve los derechos de análisis posterior ni de distribución de conjuntos de datos. El registro de decisiones sobre permisos contiene las preguntas generales de autorización; la matriz de endpoints resuelve una elección técnica más concreta.
Resolver tres solicitudes según el alcance histórico
Los siguientes casos son requisitos construidos, no llamadas exitosas ni observaciones de una cuenta de X. Exponen fallos diferentes: elegir el conjunto incorrecto, pedir historia antigua a un endpoint reciente y confundir una vista clasificada visible con un orden disponible por API. Su resultado útil es una decisión de ruta y una condición pendiente explícita, no una respuesta inventada con los datos solicitados.
Una consulta reciente necesita un intervalo delimitado
Supongamos que una integración aprobada necesita publicaciones públicas coincidentes en un intervalo definido, completamente incluido en los últimos 7 días, con texto, identificadores y fecha de creación. La candidata es la búsqueda reciente, sujeta a los operadores admitidos, el acceso de la aplicación y la finalidad permitida. El requisito define inicio y fin en UTC, consulta exacta y campos. No dice «toda la actividad social reciente», que mezclaría coincidencias de búsqueda con otras superficies.
La guía de campos explica que la consulta predeterminada de una publicación devuelve propiedades mínimas, incluidas id, text y edit_history_tweet_ids. Propiedades como created_at requieren el parámetro de campos apropiado. Pedir un campo no elimina sus requisitos de autenticación, y las propiedades de un objeto relacionado pueden exigir tanto una expansión como los campos de ese objeto. Hay que definir el esquema con el endpoint elegido, no con una captura de una tarjeta de publicación.
En la búsqueda se conserva la consulta y el intervalo al seguir el valor de continuación. La guía de paginación de búsqueda reciente documenta cómo leer next_token de la respuesta y enviarlo en la solicitud posterior. Cambiar la consulta a mitad significa que las páginas ya no describen la misma búsqueda. Aumentar el tamaño de página no elimina la necesidad de permiso ni la restricción histórica.
Una especificación del lado de la aplicación permite copiar estas distinciones sin hacerse pasar por una respuesta de API:
result_kind = recent_search_matches
interval = explicit UTC start and end within the last 7 days
query = fixed throughout this pagination sequence
requested_fields = id,text,created_at
continuation = response meta.next_token
completion = no next_token within this endpoint and query
excluded_claim = complete lifetime account history
Es una notación de planificación, no sintaxis ejecutable. La condición de finalización queda limitada deliberadamente al endpoint y la consulta. Llegar a una página sin continuación no demuestra que esté disponible cada publicación pertinente de toda la historia, que la consulta represente el concepto buscado ni que pueda recuperarse contenido no disponible. Comprobar un esquema y elegir un endpoint responde a preguntas distintas de demostrar cobertura.
Las menciones históricas no son publicaciones del autor
Ahora el cliente pide todas las menciones de su cuenta durante los últimos 12 meses. El máximo documentado de /2/users/:id/mentions son las 800 menciones más recientes. Agotar las páginas no permite llamarlo archivo anual completo. La cronología del autor tampoco es una alternativa válida: las publicaciones escritas por una cuenta y las que la mencionan tienen criterios de pertenencia diferentes, aunque algunos registros coincidan.
El producto de búsqueda en el archivo puede ser candidato para una consulta histórica expresada adecuadamente, pero exige comprobar operadores admitidos, acceso, intervalo y campos devueltos. Que el archivo llegue a marzo de 2006 describe su alcance, no certifica la exhaustividad del conjunto anual del cliente. Si no se puede establecer una consulta admitida y un acceso permitido, el requisito anual queda sin resolver o se reduce a un alcance reciente documentado.
El mismo razonamiento sirve para publicaciones del autor anteriores a los 3,200 registros más recientes. Añadir parámetros de inicio y fin antiguos no elimina por sí solo el límite de la cronología. Hay que registrar el límite junto al endpoint propuesto para que el analista no confunda «todas las páginas disponibles» con «toda la existencia de la cuenta». Un límite visible en la descripción de exportación resulta más útil que una etiqueta de integridad sin condiciones.
El inicio clasificado no es el inicio cronológico
Un tercer requisito pide el orden algorítmico exacto que una cuenta vio en su pantalla de inicio. La ruta cronológica inversa documentada excluye expresamente esa clasificación. Requiere autenticación de usuario y describe las 3,200 publicaciones más recientes o 7 días de cuentas seguidas. Es un conjunto oficial útil, pero elegirlo cambia el requisito de clasificación, no lo satisface.
Si basta el inicio cronológico, se obtiene la autorización correcta y se especifica ese orden en el contrato del consumidor. Si la presentación clasificada exacta sigue siendo esencial, estas fuentes no establecen un equivalente oficial estable. Una observación de navegador permitida por separado podría describir lo mostrado en un momento concreto; no establece un historial clasificado reproducible, recomendaciones completas ni permiso para repetir solicitudes internas. La comparación entre renderizado y paginación explica la diferencia general entre respuesta y representación sin convertir el DOM en un derecho de acceso a API.
Vincular autenticación y duración con cada ruta
La introducción a la autenticación distingue el acceso de aplicación a información pública de los flujos con contexto de usuario. Una credencial de portador de aplicación no es intercambiable con la autorización de usuario. La referencia del inicio exige expresamente contexto OAuth de usuario. Controlar una cuenta u obtener consentimiento del cliente tampoco significa ser propietario de X, poder solicitar todos los campos o tener aprobación para cualquier uso posterior.
| Contexto de credencial | Duración o finalidad documentada | Consecuencia operativa |
|---|---|---|
| OAuth 2.0 Authorization Code con PKCE | Token de acceso de 2 horas por defecto; offline.access emite un token de renovación | Implementar la renovación documentada cuando esté autorizada; distinguir ambos tokens |
| Contexto de usuario OAuth 1.0a | La guía describe la obtención de un token de acceso permanente | No trasladar ese término a OAuth 2.0, credenciales de aplicación o cookies; la autorización puede cambiar |
| Portador de aplicación | Información pública cuando el endpoint lo admite | Comprobar compatibilidad; la introducción consultada no establece una duración universal |
| Sesión de navegador iniciada | Sesión del navegador, no una clase de credencial API de X | Las referencias no establecen una duración universal de cookies; no usarla como credencial alternativa de API |
La guía de PKCE indica 2 horas por defecto y explica la función del permiso de acceso sin conexión para renovar. Un token de renovación permite el flujo admitido; no vuelve irrevocable la autorización. La guía de OAuth 1.0a utiliza la terminología de token permanente para su propio flujo. Separar ambas afirmaciones evita asumir que cualquier método de inicio produce tokens idénticos en una recopilación prolongada.
Antes de estimar continuidad, se asocian clase de credencial y permisos al endpoint. Que un usuario apruebe una operación no autentica como usuario una solicitud de aplicación. Un token caducado no implica por sí solo agotamiento del cupo. La renovación admitida resuelve validez del token; el restablecimiento del cupo resuelve una ventana de cómputo. Deben ser campos de diagnóstico distintos, sin secretos en registros ni revisiones.
La persistencia del navegador es otra capa. El flujo de sesiones multicuenta trata la separación y el almacenamiento de sesiones autorizadas, no los permisos de API de X ni la duración de sus cookies. Un estado guardado puede dejar de aceptarse aunque el archivo local exista; conservarlo no demuestra validez del token ni permisos intactos.
Separar límites de solicitudes y observaciones del navegador
La referencia de límites asigna cupos según endpoint y contexto de autenticación. Las solicitudes de usuario pueden contar contra su asignación; las de aplicación, contra la de esta. Las cabeceras x-rate-limit-limit, x-rate-limit-remaining y x-rate-limit-reset identifican límite aplicable, capacidad restante y fecha de restablecimiento. Hay que conservar endpoint y contexto junto a esos valores; una cabecera de búsqueda no es presupuesto para menciones.
El diagnóstico separa cuatro datos: ruta solicitada, contexto utilizado, respuesta y cabeceras efectivas, y condición actual de facturación o acceso de la aplicación. La tabla pública de límites no es un estado de saldo. Un cupo restante no demuestra crédito de uso, y acceder a un producto no establece el alcance histórico de otro. Se comprueba la respuesta real y la cuenta de desarrollador actual, sin fijar una gran tabla de cupos como supuesto de la aplicación.
El Acuerdo para Desarrolladores prohíbe superar o eludir las limitaciones de API. Cambiar de cuenta, identidad de navegador o ruta no remedia un derecho agotado o no disponible. La espera, los reintentos acotados y la planificación de concurrencia están en límites y concurrencia; la tarea específica de X es identificar antes qué ámbito de cómputo corresponde.
Aquí no se utilizó ninguna cuenta real de X, solicitud API, saldo de pago, cronología de navegador ni respuesta incrustada. La matriz documental puede rechazar un diseño incompatible, pero solo una solicitud mínima debidamente autorizada establece qué recibe una aplicación concreta ahora. Incluso ese resultado describe una respuesta con condiciones registradas, no disponibilidad permanente, archivo exhaustivo ni diseño estable del navegador. Permiso, semántica de respuesta e integridad de recopilación deben seguir siendo conclusiones separadas.
Preguntas frecuentes
¿«API de twitter scraping» significa un solo endpoint?
No. Publicaciones del autor, menciones, inicio, búsqueda y presentación incrustada tienen conjuntos y salidas distintos. Devolver un registro con forma de publicación no hace que un endpoint sustituya automáticamente a otro.
¿La paginación pasa de búsqueda reciente al archivo completo?
No. Un next_token avanza la consulta elegida dentro de su producto. Los períodos anteriores necesitan una ruta de archivo admitida y una decisión de acceso propia, no más páginas recientes.
¿Una respuesta vacía o corta demuestra que no hay publicaciones anteriores?
No. La solicitud describe una ruta, intervalo, filtro y autorización. Agotar ese alcance no demuestra ausencia global ni justifica ignorar su límite.
¿Siempre hace falta navegador si la API no satisface el requisito?
No. Un historial, campo o clasificación no admitido puede exigir acotar la necesidad u otra fuente permitida. El navegador se elige después de definir su función; no aporta autorización de plataforma.
Fuentes
- Introducción a X API
- Cronologías y límites
- Búsqueda reciente y archivo
- Campos y paginación
- Autenticación
- OAuth 2.0 PKCE y tokens OAuth 1.0a
- API oEmbed
- Límites de solicitudes
- Política y Acuerdo para Desarrolladores
- Coherencia de automatización de BotBrowser
Conclusión práctica
Antes del navegador se elige el resultado de X: publicaciones del autor, menciones, inicio cronológico, búsqueda delimitada o presentación incrustada. Se escriben intervalo, orden, campos y contexto de autorización junto al límite del endpoint. Si esa combinación no satisface la tarea, se acota o se detiene; si encaja, se hace una solicitud mínima permitida y se describe su alcance real antes de ampliar la recopilación.
Este artículo forma parte de la guía: Primeros pasos con automatización de navegador: mapa inicial
Artículos Relacionados
Scraping con Playwright: navegador y perfil
Primeros pasosScraping legal y términos: qué debe decidir un equipo primero
Primeros pasosNavegador para web scraping: ¿qué tipo necesitas?
Primeros pasosScraping de Instagram: requisitos de la API
Primeros pasosWeb scraping con JavaScript: render, paginar y scroll
Primeros pasosProxy en Puppeteer: autenticación, SOCKS5 y señales
Ejecuta la misma comprobación en BotBrowser
Carga un perfil, mantén dentro del navegador las señales que acabas de leer y confirma el resultado en tu propia máquina antes del despliegue.