API de scraping web: lo que oculta la respuesta
Distingue cuerpos HTTP, HTML renderizado y campos extraídos: qué demuestra la respuesta de una API de scraping web y qué detalles siguen siendo desconocidos.
BotBrowser Team
Quieres la documentación estructurada de Huella digital?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
Una API de scraping web puede devolver JSON válido sin resolver la información solicitada. La distinción que falta es la que existe entre el artefacto entregado a tu aplicación y la ejecución que lo produjo. Un cuerpo HTTP, un documento renderizado y un precio extraído respaldan conclusiones distintas. BotBrowser ofrece controles documentados para perfiles de navegador y proxies cuando operas su entorno de ejecución; no puede configurar el navegador de un proveedor de API ajeno ni reconstruir pruebas de ejecución ausentes de la respuesta de ese proveedor. En una integración que devuelve resultados, la pregunta útil es qué pruebas acompañan a cada campo, no si la respuesta parece completa.
Resumen
- Que una solicitud a la API tenga éxito no demuestra que el destino devolviera el documento previsto ni que sus datos estén completos.
- Los bytes de la respuesta original y el HTML renderizado por el navegador son entradas distintas para el analizador, incluso cuando JavaScript no introduce cambios.
- Una instantánea de salida puede llegar después de que se interrumpiera una secuencia de acciones. Inspecciona los resultados de las acciones en vez de tratar el HTML como prueba de que el flujo terminó.
- Los campos devueltos, las capturas de red y las capturas de pantalla conservan tipos distintos de evidencia. Ninguno demuestra por sí solo todo el entorno del navegador ni el historial de procesamiento.
- Elige un contrato de salida que corresponda a la afirmación que tu aplicación debe validar. Mantén por separado el permiso de recopilación, los datos sensibles y la conservación posterior frente al éxito técnico.
Contenido
- La respuesta tiene más de un límite de éxito
- Los bytes originales y el HTML renderizado son entradas distintas
- Una instantánea puede sobrevivir a una secuencia de acciones incompleta
- Un campo estructurado tiene un historial de extracción
- La continuidad de sesión no es continuidad del navegador
- La evidencia devuelta no describe todas las señales expuestas
- Un contrato de respuesta hace explícito lo desconocido
- Conclusión práctica
La respuesta tiene más de un límite de éxito
El primer límite es la llamada al servicio. La autenticación, la validación de la solicitud y la entrega de un resultado pertenecen a esa interacción con la API. El segundo es la respuesta obtenida del destino. El tercero es la interpretación que hace tu aplicación del artefacto entregado. Una respuesta externa satisfactoria no fusiona esos límites. Un servicio puede entregar correctamente una página de error y un analizador puede descodificarla correctamente sin encontrar ningún registro. Llamar «éxito» a los tres resultados elimina la información necesaria para diagnosticar un conjunto de datos vacío.
La documentación de gestión de errores de Zyte distingue expresamente el estado de su API del estado del sitio de destino. Un 404 del destino puede aparecer en un resultado correcto de la API mediante statusCode. Se trata de un contrato de respuesta documentado, no de una propiedad medida de manera independiente para todos los servicios de scraping. Una integración con otro proveedor debe identificar el campo equivalente y su significado. De lo contrario, tratar el 200 externo como si fuera el 200 del destino puede convertir una página ausente en una observación que parece válida.
El estado del destino tampoco certifica el contenido. Una aplicación propia puede devolver legítimamente una pantalla de inicio de sesión, una búsqueda vacía o un aviso temporal del servicio con 200. La aplicación necesita comprobar el tipo de documento antes de extraer registros. Esa comprobación puede buscar un encabezado de catálogo conocido o una estructura de registro definida por la aplicación en un recurso de prueba autorizado. Su objetivo es clasificar la representación devuelta, no decidir si un sitio de terceros permite la automatización. El permiso depende de la autorización y los términos aplicables, con independencia de lo que haya devuelto el servidor.
Las redirecciones añaden otra distinción. La referencia HTTP de Zyte indica que las solicitudes HTTP siguen las redirecciones de forma predeterminada y expone followRedirect para cambiar ese comportamiento. Su referencia de navegador indica que las solicitudes del navegador siguen las redirecciones HTTP y los cambios de URL activados por HTML o JavaScript. Por tanto, la URL proporcionada no tiene por qué identificar el documento serializado al final. Conserva la ubicación final cuando el contrato la proporcione y distingue una observación de redirección de una inferencia basada únicamente en la cadena de la solicitud original.
La descripción general de interfaces de navegador separa recibir un artefacto finalizado de seguir controlando un navegador. Una vez elegida una API de artefactos, validar el resultado pasa a ser el límite inmediato. Un equipo no necesita clasificar proveedores para determinar si recibió el tipo de documento previsto. Necesita una especificación que identifique el estado del destino, la representación y los campos requeridos de la aplicación, con un estado explícito de desconocido cuando la respuesta omita las pruebas necesarias.
Los bytes originales y el HTML renderizado son entradas distintas
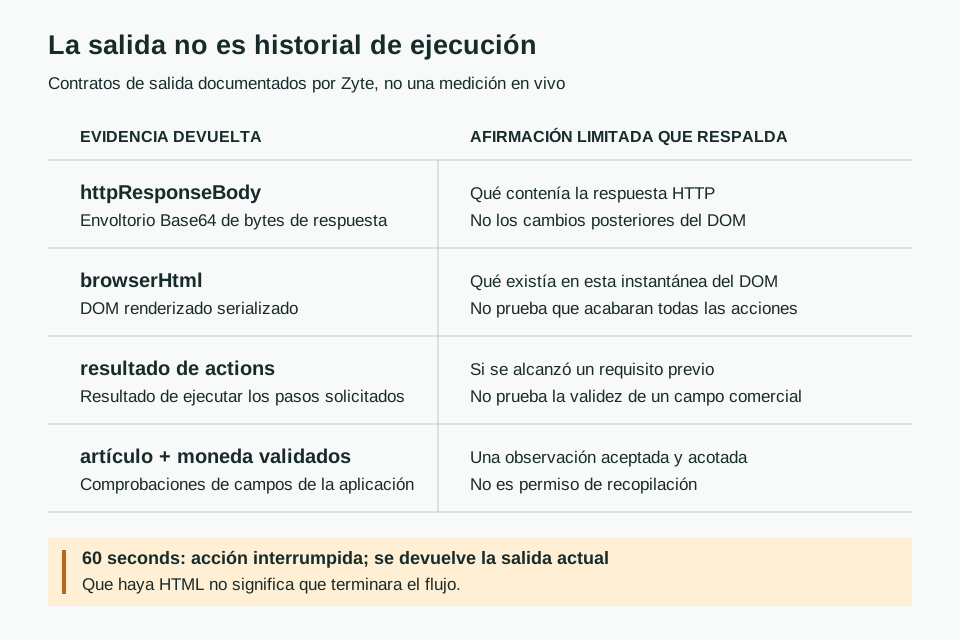
Zyte documenta httpResponseBody como un cuerpo de respuesta HTTP codificado en Base64 que se obtiene sin renderizado del navegador. Base64 es una representación de transporte de bytes, no una declaración de la codificación de caracteres del documento. Decodificar el envoltorio devuelve los bytes originales; interpretarlos como texto es otra operación. La documentación HTTP recomienda aplicar las reglas de codificación HTML y las cabeceras de respuesta cuando corresponda. Por tanto, que un acento aparezca corrupto en un registro podría ser un problema de decodificación de texto, no una función ausente del navegador.
En cambio, browserHtml representa el DOM después del renderizado del navegador. Los scripts pueden haber insertado, eliminado o reorganizado elementos, pero JavaScript no es la única fuente de diferencias. La misma referencia explica que el HTML del navegador incluye normalización HTML5. Un analizador que construye un árbol distinto a partir de la respuesta original puede producir resultados diferentes para los selectores incluso en una página sin actualizaciones impulsadas por scripts. La afirmación «ambos son HTML» no basta para que su comportamiento al analizarlos sea intercambiable. Una migración necesita recursos de entrada representativos, no solo extensiones de archivo sin cambios.
También existen límites de representación. Zyte documenta un límite de 10 MB para el cuerpo HTTP antes de codificarlo en Base64 y un límite de 10 MB para el HTML del navegador; las salidas más largas se truncan. La compresión HTTP no cambia el primer límite. Son límites específicos del proveedor, no propiedades generales de HTML ni de todas las API. Si un registro necesario queda después de una salida truncada, que el analizador no devuelva resultados no demuestra que el destino careciera del registro. El límite de salida debe seguir siendo una explicación independiente.
La salida del navegador también presenta exclusiones estructurales. Zyte indica que el contenido de los iframe está vacío en browserHtml de forma predeterminada, salvo que se active includeIframes, y remite a un tratamiento independiente para el contenido de Shadow DOM. Por ello, que se serialice el documento externo no garantiza que todos los componentes visibles aparezcan en la cadena devuelta. Una captura de pantalla puede mostrar un componente cuyo texto no está en esa serialización. Son superficies de observación distintas, no necesariamente resultados contradictorios. El consumidor debe saber qué superficie debía usar su analizador.
Para un recurso hipotético de un producto propio, conserva la respuesta original y el documento renderizado como tipos de recursos de prueba distintos. El primero puede demostrar lo que envió el servidor; el segundo puede demostrar el DOM serializado en un momento concreto. Si un selector falla tras cambiar de uno a otro, lo primero que se debe investigar es un cambio en el contrato de entrada. El análisis sobre scraping con navegadores sin interfaz aborda los requisitos de ejecución del navegador; no elimina la necesidad de identificar la representación precisa que se entregó al analizador posterior.
Una instantánea puede sobrevivir a una secuencia de acciones incompleta
Un servicio de artefactos puede aceptar una secuencia ordenada de acciones del navegador y devolver resultados tras intentar ejecutarlas. Ese contrato no equivale a entregar un controlador de navegador activo y sin restricciones. La referencia de automatización de navegador de Zyte documenta un límite total de 60 seconds de ejecución del navegador para estas acciones. Al alcanzarlo, la acción en curso se interrumpe, las acciones posteriores no se ejecutan y se devuelve el HTML o la captura de pantalla solicitados tal como se habían renderizado en ese momento. Por tanto, puede existir un artefacto disponible junto a un flujo de trabajo sin terminar.
Esto tiene una consecuencia concreta para los registros posteriores. Supongamos que un recurso de prueba de catálogo autorizado abre primero una categoría, espera después un indicador de moneda y finalmente lee un artículo. Si la espera se interrumpe, el documento devuelto podría contener la moneda predeterminada en vez de la solicitada. El analizador aún puede producir un precio sintácticamente válido. El fallo no tiene por qué ser un elemento ausente o un error de transporte de la API; puede deberse a que no se cumplió una condición previa antes de la instantánea. El resultado del flujo necesita tanto el resultado de la acción como la evidencia de la moneda.
Zyte documenta un campo de respuesta actions que contiene detalles de ejecución, incluidos errores e información de tiempos. Ese campo debe interpretarse según su esquema documentado, no reducirse a un único indicador booleano de «hay HTML». Que una acción no se ejecute después de alcanzar el límite es distinto de que se ejecute pero no encuentre el selector. Ambos casos pueden dejar un documento parecido. Un diagnóstico útil identifica la primera condición previa de la aplicación que no se cumplió y conserva el artefacto devuelto para inspeccionarlo, de acuerdo con la política de retención de datos.
La misma referencia de navegador distingue los selectores de acción de otras interfaces: los selectores de acciones ordinarias no pueden interactuar con contenido de iframe o Shadow DOM del mismo modo que los mecanismos específicos. Por tanto, un elemento ausente puede reflejar el alcance admitido por la acción, no una página lenta. Aumentar una espera arbitraria no cambia ese alcance. Antes de atribuirlo al tiempo transcurrido, compara la superficie de acciones documentada con la ubicación del componente requerido. Es una comprobación del contrato de interfaz, no una receta para acceder a contenido protegido.
Por consiguiente, el momento de generar la salida forma parte del significado de los datos. «Precio observado» debería exigir la identidad del artículo pertinente, la moneda y la condición de preparación de la aplicación en el artefacto que realmente proporcionó el precio. Una captura de pantalla de otra etapa no puede aportar en silencio el contexto ausente. Si el contrato de la API no expone pruebas de acciones suficientes, clasifica el resultado como no resuelto para ese caso de uso. Una afirmación más limitada pero respaldada es más útil que una fila aparentemente completa cuyos requisitos previos nunca se establecieron.
Un campo estructurado tiene un historial de extracción
Algunos servicios devuelven registros analizados en lugar de dejar todos los selectores a cargo del consumidor. La documentación de extracción automática de Zyte describe la extracción como otra capacidad de salida. Un campo estructurado elimina el trabajo de análisis de la ruta inmediata del consumidor, pero también introduce un límite de interpretación. El consumidor ve un valor elegido o normalizado por el extractor. Salvo que la respuesta proporcione la procedencia pertinente, el valor por sí solo no puede demostrar el texto original, la posición en el documento ni la relación con otro valor visible.
Por ejemplo, un catálogo hipotético contiene un precio actual, un precio anterior tachado y un importe de pago a plazos. Los tres pueden ser números legítimos en un mismo documento. Un price devuelto necesita una definición de campo que explique qué función representa. El esquema posterior debe conservar la moneda y la identidad del artículo junto al valor, en vez de suponer que se podrán reconstruir después. Este ejemplo describe un contrato de datos del consumidor, no cómo resuelve internamente esos valores en conflicto un servicio concreto.
La selección de la fuente también importa. La distinción HTTP/cuerpo significa que un extractor que lee los bytes de respuesta puede recibir un conjunto de valores candidatos distinto al de otro que lee el HTML renderizado. Cambiar la representación de entrada o los ajustes de extracción puede cambiar lo que mide la serie temporal resultante. Un campo normalizado puede mantener una estructura válida mientras cambia el contexto de selección. Versiona el contrato de extracción del consumidor para que un analista posterior pueda distinguir un cambio aparente del mercado de un cambio en la forma de producir las observaciones.
Los valores ausentes, vacíos y sin verificar no deberían reducirse a un único valor. Un campo ausente puede indicar que el extractor no lo proporcionó. Un valor explícitamente vacío puede describir el documento devuelto. Un valor sin verificar puede estar presente sin las pruebas que necesita el consumidor para decidir. El esquema de negocio debe conservar estas distinciones, incluso si el proveedor usa una estructura de respuesta más simple. Mantener un resultado de validación junto al resultado original del proveedor evita convertir silenciosamente cada campo entregado en un hecho aceptado.
Las capturas de pantalla y las respuestas de red capturadas pueden ayudar a resolver algunas preguntas, pero no son intercambiables con la procedencia de un campo. Zyte documenta networkCapture como una captura filtrada de respuestas durante el renderizado del navegador, incluida la ejecución de acciones. Que un filtro capture una respuesta pertinente no demuestra que se conservaran todas las solicitudes. Una captura de pantalla registra píxeles visibles, no el historial completo de solicitudes. Elige artefactos complementarios para resolver una ambigüedad concreta y evita recopilar contenido ajeno de una cuenta solo porque el servicio permita devolver más datos.
La continuidad de sesión no es continuidad del navegador
La etiqueta de sesión de un servicio puede describir una garantía de continuidad más acotada que la de un navegador persistente. La documentación de funciones compartidas de Zyte describe las funciones de sesión; su documentación de CDP ofrece una interfaz independiente de navegador activo. Los consumidores deben leer las reglas de persistencia pertinentes en vez de inferir que las solicitudes repetidas se ejecutan en el mismo motor de renderizado. Compartir cookies o condiciones de enrutamiento no demuestra, por sí solo, que sobrevivan los objetos JavaScript en memoria ni una página previamente abierta.
La distinción se hace visible en un recurso de prueba propio con varios pasos. Una preferencia del lado del servidor representada por una cookie puede persistir mientras desaparece un valor temporal guardado solo en una variable de la página. Son ubicaciones de almacenamiento y duraciones distintas. Si un flujo requiere continuar dentro de la misma página activa, la capacidad necesaria es la continuidad de la página, no solo un identificador de sesión repetido. Registra ese requisito antes de elegir una interfaz. De lo contrario, una integración podría confundir una página nueva con cookies recordadas con el mismo flujo de navegador en curso.
La identidad de red es otra condición independiente. Un proveedor puede documentar un comportamiento de enrutamiento asociado a la sesión sin exponer la ruta real de cada subrecurso. Una cadena de agente de usuario devuelta no demuestra las propiedades de la conexión TLS, y un parámetro de región de API no demuestra por sí mismo cuál fue la salida observada por el destino. La respuesta debería identificar qué observaciones proporciona y cuáles son solo ajustes solicitados. Cuando el caso de uso se refiere al tráfico recibido por una aplicación propia, sus registros autorizados del lado del servidor pueden aportar pruebas que falten en el artefacto devuelto.
Los detalles específicos del ciclo de vida de cada proveedor ya tienen su espacio en el análisis de responsabilidad en Browserbase. Sus estados terminales y reglas de Context no deben trasladarse a otro servicio porque ambos ofrezcan ejecución alojada. La misma cautela se aplica a los reintentos: los reintentos documentados de una biblioteca no demuestran que un cliente HTTP arbitrario o todas las solicitudes de cualquier backend sigan esa política. Distingue el comportamiento del proveedor, el del SDK y las decisiones de tu planificador al asignar la responsabilidad por un trabajo repetido.
La evidencia devuelta no describe todas las señales expuestas
Recibir un documento no enumera todo lo que observó el destino mientras se producía. Un navegador puede exponer propiedades legibles por scripts mientras la conexión de red aporta otra información. Una respuesta de API es un contrato de salida, no una auditoría exhaustiva y automática de esas exposiciones. Si contiene browserHtml y una captura de pantalla, pero no un registro de ejecución atribuido a una fuente, no puede demostrar qué script concreto leyó una API del navegador. La actividad de renderizado ordinaria y la actividad de automatización no deben etiquetarse como pruebas de recopilación por parte de un proveedor.
La descripción general del navegador de BotBrowser documenta controles de superficies del navegador respaldados por perfiles, mientras que la configuración de proxy documenta el enrutamiento de su propio entorno de ejecución. Estos controles corresponden a una implementación de navegador que realmente operas. Pasar una opción de ejecutable local a tu propio código de automatización no puede cambiar el ejecutable de un proveedor de API remoto, salvo que ese proveedor admita expresamente tal configuración. El límite entre capas sigue siendo importante aunque ambas integraciones usen términos de automatización conocidos.
La revisión de privacidad debe seguir el flujo de datos real: la URL solicitada y el estado suministrado entran en el servicio; el proveedor obtiene o renderiza el contenido; se devuelven artefactos seleccionados; tu aplicación los almacena o exporta. Las cookies, el contenido de páginas, las capturas de pantalla y los artefactos de depuración pueden contener información que vaya más allá del registro comercial final. Los términos de conservación y tratamiento pertinentes deben cubrir esos artefactos explícitamente. Quitar un campo devuelto no demuestra que el proveedor nunca procesara su fuente, igual que rechazar una captura de pantalla no establece una política universal de eliminación.
Un recurso de prueba propio puede reducir la exposición innecesaria al evaluar el contrato. Usa contenido inocuo y un estado de alcance limitado; después comprueba los artefactos requeridos y los resultados de validación. Esto no demuestra anonimato, cumplimiento legal ni aceptación por el destino. La autorización para recopilar y el permiso para remitir contenido a un encargado del tratamiento siguen siendo decisiones independientes que ni un analizador satisfactorio ni un perfil de navegador coherente pueden tomar por el operador.
Un contrato de respuesta hace explícito lo desconocido
La siguiente tabla de decisiones se refiere a un catálogo hipotético propio. Asigna cada afirmación prevista a un tipo de evidencia requerido. No prescribe una solicitud a un proveedor ni informa de un experimento ejecutado. Su resultado esperado es una decisión de validación: aceptar la afirmación limitada solo cuando exista la evidencia correspondiente; de lo contrario, conservar un resultado sin resolver. Así, la falta de observabilidad se hace visible en vez de transformarse en una causa supuesta.
| Afirmación prevista | Evidencia requerida | Lo que no puede demostrar un artefacto más débil |
|---|---|---|
| El servidor proporcionó estos bytes | Cuerpo HTTP original y cabeceras de respuesta pertinentes | El HTML renderizado puede incluir normalización del navegador y cambios posteriores |
| Este texto existía en el DOM serializado | Instantánea identificada del HTML del navegador y contexto del documento final | Los bytes originales no demuestran texto generado por scripts |
| Se completó el paso de selección de moneda | Resultado documentado de la acción más el estado de moneda observado | Que exista una captura de pantalla no certifica todas las acciones anteriores |
| Este precio corresponde al producto | Identidad del producto, moneda, función del campo y validación de la aplicación | Un único campo numérico no distingue el pago a plazos del precio actual |
| Continuó el mismo flujo de página | Ciclo de vida documentado de página activa y evidencia coincidente del flujo | Compartir cookies no demuestra que persistiera el motor de renderizado o el objeto de página |
| Un script concreto leyó una señal | Eventos de ejecución atribuidos a una fuente de esa ejecución | El HTML, el número de solicitudes y una etiqueta de resultado no identifican quién leyó la señal |
Considera tres casos sintéticos con el mismo 200 externo. En el caso A, statusCode es 404, así que no se intenta extraer registros. En el caso B, el HTML del navegador contiene un artículo, pero el resultado de la acción indica una interrupción antes de que la moneda estuviera lista; el precio sigue sin verificar. En el caso C, se establecen la condición de la acción y los campos requeridos del artículo, por lo que la aplicación puede aceptar esa observación acotada. Son reglas de validación propuestas, no mediciones de fiabilidad del proveedor ni promesas sobre el comportamiento de un destino.
Conserva solo las pruebas necesarias para explicar esa decisión y vincula el registro aceptado con la procedencia limitada que lo respalda. Si un límite de salida, un iframe omitido, un resultado de acción no disponible o un requisito de persistencia no admitido impide validar, registra la incertidumbre específica. Los contratos HTTP y de navegador proporcionan distinciones concretas que un campo genérico de «solicitud correcta» no puede transmitir. Así, un consumidor puede rechazar o poner en cuarentena un registro no resuelto sin inventar una explicación para la ejecución remota.
Preguntas frecuentes
¿Una respuesta de API con estado 200 significa que la página de destino se cargó correctamente?
No necesariamente. El estado del transporte de la API y el estado del destino pueden estar en campos distintos. El documento de destino también necesita validación específica de la aplicación.
¿El HTML del navegador es simplemente el HTML original después de descodificarlo?
No. Representa el DOM del navegador, incluida la normalización HTML y posibles cambios de scripts. En cambio, descodificar en Base64 un cuerpo HTTP devuelve bytes.
¿El HTML devuelto demuestra que se ejecutaron todas las acciones solicitadas?
No. Zyte documenta secuencias de acciones interrumpidas que aun así devuelven la salida actual. Los resultados de las acciones y el estado requerido de la página necesitan una inspección independiente.
¿Puede BotBrowser configurar el navegador de una API de scraping alojada?
Solo una integración admitida expresamente por un proveedor podría ofrecer esa capacidad. Los controles del entorno de ejecución propio de BotBrowser no configuran automáticamente un servicio remoto ajeno.
Fuentes
- Zyte: Solicitudes HTTP
- Zyte: Automatización del navegador
- Zyte: Extracción automática
- Zyte: Gestión de errores
- Zyte: Funciones compartidas
- Zyte: CDP
- BotBrowser: Descripción general del navegador
- BotBrowser: Configuración de proxy
Conclusión práctica
Elige la salida de una API de scraping web según la afirmación que deba verificar tu aplicación: bytes del servidor, texto renderizado, acción completada o registro validado. Exige la evidencia correspondiente y conserva un estado sin resolver cuando no esté disponible. Evalúa ese contrato con recursos de prueba inocuos y autorizados antes de enviar datos sensibles o depender de los campos devueltos para decisiones operativas.
Este artículo forma parte de la guía: ¿Qué es la huella digital del navegador?
Artículos Relacionados
Navegador para web scraping: ¿qué tipo necesitas?
Primeros pasosWeb scraping con Browserbase: ¿quién controla qué?
Huella digitalParches Rebrowser: cuando el proxy ya funciona
RedCloudflare y DataDome: señales durante el scraping
Primeros pasosWeb scraping con JavaScript: render, paginar y scroll
Primeros pasosScraping con Selenium: capacidades y registros
Ejecuta la misma comprobación en BotBrowser
Carga un perfil, mantén dentro del navegador las señales que acabas de leer y confirma el resultado en tu propia máquina antes del despliegue.