Akamai Bot Manager: datos del sensor y privacidad
Distingue las declaraciones sobre sensores de Akamai, las observaciones del navegador y los datos del edge. Conoce la exposición, los roles y los límites de los controles.
BotBrowser Team
Quieres la documentación estructurada de Huella digital?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
Akamai Bot Manager combina información disponible en el extremo de la red con observaciones de un script en las páginas supervisadas. Akamai menciona públicamente el análisis del comportamiento y la identificación por huella del navegador, pero esas declaraciones no establecen una lista universal de lecturas de JavaScript. Para comprender la exposición de la privacidad hay que separar la recopilación en el navegador, la transmisión y el tratamiento posterior.
BotBrowser permite realizar comprobaciones repetibles de las superficies del motor del navegador mediante ajustes de perfil declarados. No determina la finalidad de recopilación de Akamai, la conservación, el historial de cuentas ni la clasificación, y no garantiza el anonimato ni el acceso.
Resumen
- Akamai describe tanto un componente de script de página como la evaluación de solicitudes en el edge. Un ajuste de privacidad del navegador solo afecta a una parte de ese sistema.
- Un evento V8 atribuido a su fuente puede demostrar una operación del navegador en una ejecución concreta. Una captura de solicitudes, la descarga de un script o una puntuación sin explicar no pueden demostrar el mismo hecho.
- La declaración de privacidad de Akamai distingue roles de tratamiento y contextos de servicio. Sus amplios ejemplos de registros de servicio no especifican cada mensaje del sensor.
- En un despliegue propio, elige las reglas de recopilación y conservación según la finalidad y la configuración reales. Comprueba por separado la exposición del navegador y el tratamiento en el servidor.
Contenido
- El sensor de página y el edge
- Qué demuestra la evidencia disponible
- Superficies del navegador y exposición de la privacidad
- Transmisión, registros y roles de tratamiento
- Qué pueden cambiar los controles del motor del navegador
- Decisiones para un despliegue propio
- Conclusión práctica
El sensor de página y el edge
Un sitio no necesita un script de página para observar todas las propiedades relevantes de una solicitud. Un servicio en el extremo de la red recibe el tráfico antes de que el documento llegue al navegador. La solicitud y la conexión ya proporcionan información sobre dónde llegó el tráfico, qué recurso se solicitó y cuándo se produjo el intercambio. Esa visibilidad corresponde a un responsable distinto del de un valor generado por JavaScript después de cargar la página.
La descripción del producto Bot Manager de Akamai incluye explícitamente ambas partes. Su descripción de la configuración indica que la detección de anomalías de comportamiento utiliza un script inyectado en las páginas supervisadas. Su descripción de la supervisión indica que el servicio ve el tráfico en el edge y asigna un Bot Score a las solicitudes. Esas afirmaciones establecen una arquitectura declarada. No revelan qué operación del navegador produjo una puntuación concreta ni qué observaciones habilitó un cliente determinado.
La distinción importa cuando una página parece funcionar de forma diferente tras cambiar un ajuste del navegador. Una diferencia en el navegador puede coexistir con un historial del servidor sin cambios. Un cambio de ruta de red puede coexistir con el mismo comportamiento de renderizado. Una respuesta diferente puede deberse a la configuración de la aplicación sin demostrar que se haya recopilado una nueva señal del navegador. Cada explicación se refiere a una parte distinta del sistema.
La introducción a las huellas del navegador separa por el mismo motivo las capas de solicitudes, navigator, renderizado y aplicación. La descripción del producto de Akamai añade una declaración específica del proveedor sobre la participación de la supervisión de páginas y la evaluación en el edge. No reduce esas capas a una única propiedad del navegador que un ajuste pueda activar o desactivar.
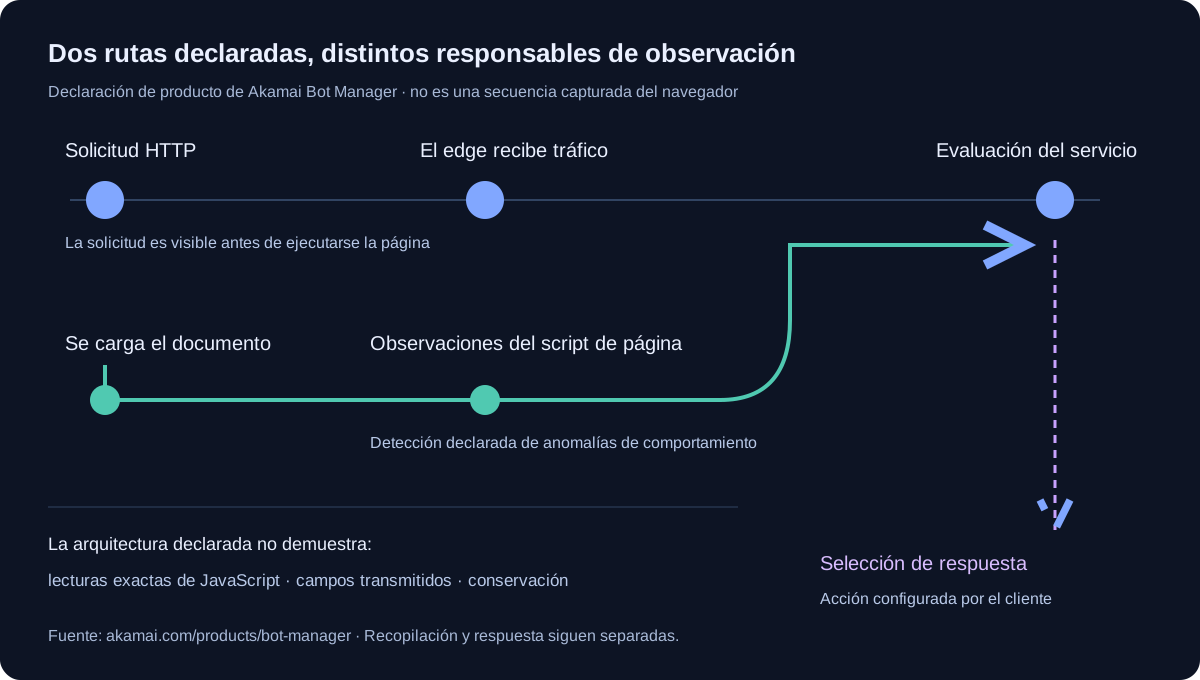
Un sensor es solo un contexto de recopilación
La palabra sensor suele hacer pensar en un único cuestionario fijo. Sin embargo, un componente de navegador desplegado se ejecuta dentro de una página con un origen, un orden de carga, un ciclo de vida y un conjunto de recursos disponibles concretos. Lo disponible antes de una interacción puede diferir de lo disponible después de una navegación o una decisión sobre permisos. Eso no demuestra qué oportunidades utiliza realmente el componente.
La guía de respuestas de Cloudflare y DataDome trata otro límite observable: lo que recibe un cliente. Una clasificación de respuesta puede describir un documento, una redirección o un desafío. No reconstruye lo que otro proveedor recopiló antes ni revela cómo configuró un cliente su política de respuestas. Aplicar estos límites de forma coherente evita convertir un resultado visible en un historial de recopilación inventado.
La recopilación y la respuesta tienen finalidades distintas
El operador de una aplicación puede utilizar la gestión de bots para proteger la disponibilidad, investigar la automatización no deseada o distinguir categorías de solicitudes automatizadas. Esas finalidades pueden conducir a decisiones de despliegue distintas. Una página pública de producto describe capacidades disponibles para distintos clientes. Cada despliegue tiene su propia configuración, flujo de aplicación y responsabilidades operativas.
Para evaluar la privacidad, la pregunta útil es qué necesita el despliegue real para su finalidad declarada. La existencia de una capacidad opcional no demuestra que todos los visitantes la encuentren. A la inversa, una consola del navegador sin actividad no demuestra que el edge no haya recibido información. Las observaciones de red y de aplicación siguen siendo relevantes aunque un script no produzca una interfaz visible evidente.
Las orientaciones del W3C sobre huellas del navegador distinguen las características pasivas disponibles a través de las solicitudes de las observaciones activas obtenidas mediante contenido ejecutable. Estas categorías ayudan a localizar la recopilación. No asignan una base jurídica, demuestran proporcionalidad ni determinan cómo utiliza el resultado una empresa concreta. Esas decisiones requieren información sobre el despliegue y el tratamiento de las organizaciones responsables.
Un Bot Score es una evaluación seguida de una elección de respuesta
Las preguntas frecuentes del producto de Akamai describen una puntuación de 0, etiquetada como humano, a 100, etiquetada como bot. Indican que la evaluación comienza con la primera solicitud y que la puntuación puede aumentar al acumularse solicitudes del mismo bot. Son descripciones del servicio por parte del proveedor, no mediciones de una sesión del navegador. Los extremos de la escala son etiquetas, no probabilidades publicadas de identidad humana o intención maliciosa.
Esa precisión sobre el historial de solicitudes es relevante para la privacidad. Un servicio que evalúa una secuencia necesita alguna base para tratar las solicitudes como relacionadas. Las preguntas frecuentes no identifican el mecanismo exacto de vinculación ni cuánto dura cada asociación. Respaldan preguntar por las relaciones entre solicitudes, sin establecer un identificador, un método de almacenamiento ni una relación entre sitios concretos. Una lectura del navegador atribuida a su fuente seguiría sin responder cómo combina el servidor el historial.
La declaración sobre la estrategia de respuesta nombra tres segmentos configurables: Cautious Response, Strict Response y Aggressive Response. Describe la observación, los desafíos y la mitigación del tráfico, y permite a los clientes ajustar las acciones y los límites de puntuación. Esas elecciones se sitúan después de la evaluación. Por tanto, un desafío visible refleja tanto la evaluación del servicio como la respuesta seleccionada en el despliegue; no muestra directamente una observación concreta del navegador.
Para el operador de una aplicación, esa separación afecta a la rendición de cuentas. El proveedor aporta una capacidad de evaluación, mientras que el cliente elige cómo participa en el flujo de la aplicación. Un visitante que sufra una interrupción inesperada necesita que se revise la decisión desplegada y su contexto, incluidas las diferencias ordinarias de accesibilidad o navegación. Cambiar una regla de respuesta no prueba que haya cambiado la recopilación subyacente, y recopilar un valor adicional del navegador no explica por sí solo por qué se aplicó una regla de respuesta.
La explicación de la capa del edge describe por qué una página no puede inspeccionar todas las condiciones del servicio. Las preguntas frecuentes de Akamai ofrecen un ejemplo concreto: la evaluación por solicitud y la respuesta configurable son operaciones relacionadas, pero tienen responsables y evidencia distintos. No se ha medido ninguna puntuación ni acción concreta para los controles del navegador tratados más adelante.
Qué demuestra la evidencia disponible
Tres tipos de evidencia responden a preguntas distintas: una declaración del proveedor describe una capacidad ofrecida, una traza del navegador registra operaciones durante una ejecución y un registro de red describe un intercambio. Ninguno contiene automáticamente la información aportada por los otros dos. Una afirmación sobre recopilación resulta engañosa cuando un informe cruza esos límites sin evidencia adicional.
La investigación local inspeccionada contiene una configuración de captura de solicitudes y una utilidad de atribución a la fuente, pero no establece una medición V8 actual atribuida a su fuente. Por tanto, las lecturas concretas del navegador siguen sin verificarse. La captura de solicitudes puede localizar un intercambio; el código de análisis existente no prueba que se haya emitido el evento que esperaba.
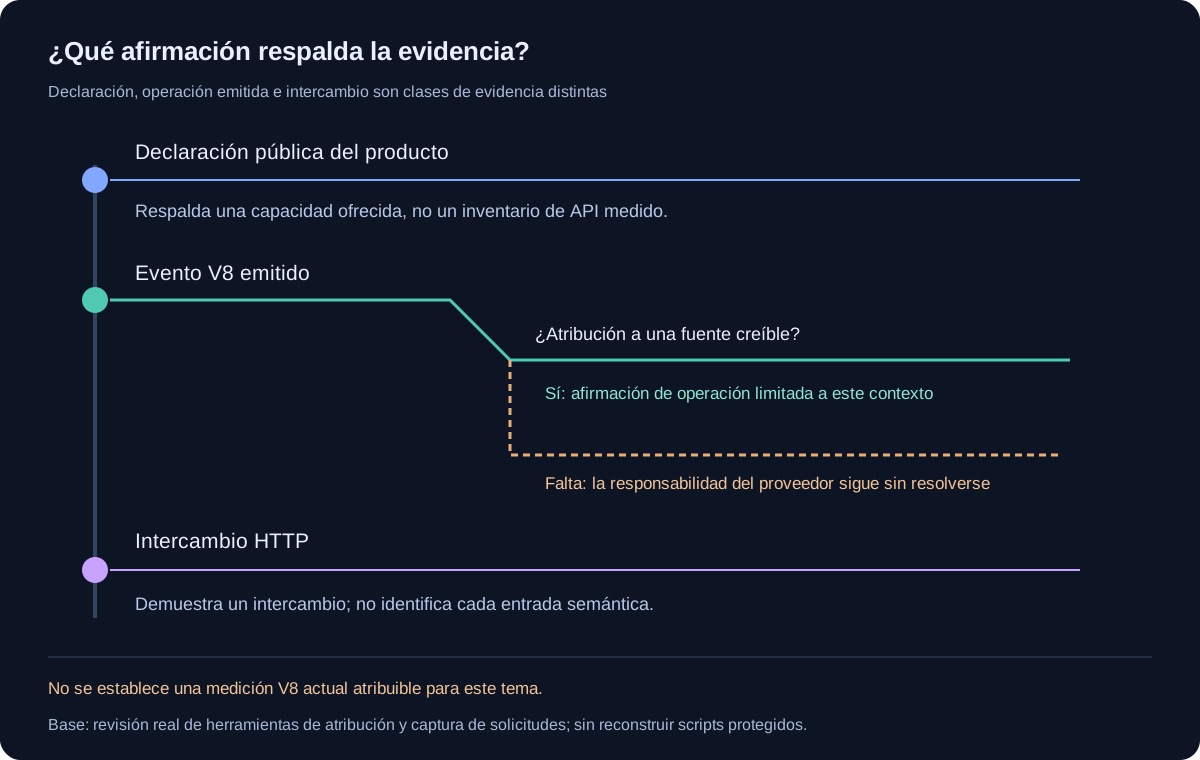
Por qué la atribución a la fuente cambia la conclusión
Una página moderna ejecuta scripts de aplicación, analítica, contenido incrustado y herramientas de diagnóstico. Una llamada a una API registrada durante esa carga de página podría proceder de cualquiera de ellos. Que haya gestión de bots instalada no asigna todas las operaciones del navegador a su sensor. La atribución necesita una conexión entre el evento y el código responsable.
Un registro V8 es una herramienta de observación de la actividad de las interfaces del navegador. Un evento que identifique la operación y una fuente de script creíble puede respaldar una afirmación sobre esa ejecución. La falta de fuente, un contexto que solo identifica el documento o una etiqueta de blob de la misma ejecución no asignan por sí solos la operación a Akamai. Los scripts de aplicación y las herramientas de diagnóstico pueden producir sus propios eventos durante la misma visita.
El análisis de privacidad entre superficies explica por qué el contexto importa en páginas y workers. Una medición debe conservar el contexto que realmente observó. Trasladar un evento sin atribución a una columna de proveedor pierde ese contexto y puede exagerar tanto la recopilación como el efecto de un control del navegador.
Leer, enviar y conservar son hechos separados
Un evento del navegador emitido puede demostrar que ocurrió una operación. No demuestra necesariamente que el resultado se incluyera en una solicitud. Un intercambio de red puede demostrar que los datos cruzaron un límite, pero un cuerpo opaco no revela de forma independiente sus entradas semánticas. Ninguno demuestra un plazo de conservación ni la finalidad del tratamiento posterior en el servidor.
Estos límites importan tanto para los hallazgos positivos como para los negativos. La ausencia de un evento puede reflejar un registro incompleto, una fase de ejecución distinta o instrumentación no disponible. No prueba que no se produjera una lectura. Un valor del navegador coincidente tampoco prueba que el sitio lo ignorase. Las observaciones del navegador describen valores devueltos; su uso por el servicio requiere evidencia independiente.
| Evidencia disponible | Conclusión respaldada | Evidencia adicional aún necesaria |
|---|---|---|
| Declaración de producto del proveedor | El proveedor ofrece la capacidad de tratamiento mencionada | Configuración y recopilación del despliegue real |
| Evento emitido con una fuente creíble | Esa fuente realizó la operación del navegador registrada en ese contexto | Si el resultado se transmitió o conservó |
| Solicitud saliente | Se produjo un intercambio de red | Significado del contenido y finalidad del tratamiento responsable |
| Registro de tratamiento del cliente | La finalidad y las reglas de manejo documentadas | Si la implementación desplegada cumple esas reglas |
La tabla ofrece al equipo de un sitio propio una regla de decisión: utilizar la fila que corresponda a la evidencia realmente disponible. Si la pregunta pertenece a la siguiente columna, hay que obtener esa información del responsable del sistema correspondiente en lugar de convertir la incertidumbre en una afirmación segura. Las orientaciones del W3C aportan el modelo general de recopilación; el despliegue real aporta los detalles que faltan.
Superficies del navegador y exposición de la privacidad
La exposición a la identificación por huella incluye cómo pueden vincularse las observaciones, cuánto tiempo sigue siendo útil esa relación y qué organización controla la combinación. No hace falta un nombre para reconocer a alguien.
Las orientaciones del W3C describen cómo contribuyen las características activas y pasivas a la identificación por huella. La información de compatibilidad del navegador, las diferencias de renderizado y las propiedades de las solicitudes pueden tener distinta estabilidad y coste de recopilación. Una familia compartida por muchos usuarios puede aun así reducir una población al combinarse con otra. La página del producto de Akamai menciona explícitamente la «identificación por huella del navegador»; eso respalda examinar esta categoría sin inventar su implementación.
La guía general de huellas distingue un patrón reconocible de una prueba de identidad. La misma distinción se aplica a Akamai. Una clasificación del navegador no establece una identidad jurídica, el propietario de un dispositivo ni la intención de una persona. Tratarla como tal añade conclusiones que la observación subyacente puede no respaldar.
La información de compatibilidad puede servir para correlacionar
Las aplicaciones web utilizan información del navegador para elegir contenido compatible, dar formato al texto o adaptar el diseño. Recopilarla para esas finalidades no implica por sí mismo identificación por huella. La exposición de la privacidad cambia cuando una aplicación combina las respuestas para reconocer o las asocia con actividad continuada. La finalidad y la combinación importan junto con cada superficie individual del navegador.
Por ejemplo, navigator.language puede servir para la localización. Un recurso instalado puede afectar al renderizado. Un área de visualización describe el espacio de presentación actual. Estos ejemplos ilustran la exposición normal del navegador, no afirman que Akamai lea cada valor. El análisis del idioma y la localización explica que una preferencia funcional y una inferencia de seguimiento son usos distintos de información relacionada.
La evaluación de un sitio propio debería distinguir la decisión mínima de compatibilidad de un registro más persistente. Si una página solo necesita elegir un diseño adecuado, conservar un historial duradero de las observaciones utilizadas necesita su propia justificación. El navegador no puede determinar esa finalidad empresarial. Los responsables de la aplicación y del servicio deben poder explicarla.
El renderizado expone diferencias de implementación
El renderizado de gráficos y texto puede variar según las fuentes, la implementación del navegador y el entorno de renderizado. Por eso la salida renderizada resulta relevante para el análisis general de huellas. También significa que puede cambiar por motivos de mantenimiento ordinario. Una salida diferente no equivale automáticamente a otra persona, una sesión sospechosa o una prueba de manipulación deliberada.
El análisis de WebGL y el análisis de canvas explican esas superficies por separado.
Los datos de renderizado pueden generar exposición incluso sin un nombre legible por una persona. Su valor puede estar en distinguir una configuración o correlacionar visitas. Las preguntas pertinentes sobre su manejo son si se necesita la salida en bruto, si una categoría menos precisa respondería a la cuestión operativa y si el resultado se asocia con otra actividad. Una traza del navegador por sí sola no puede responder a la última pregunta sobre la asociación.
La interacción y los tiempos necesitan un límite temporal
Akamai describe explícitamente el análisis del comportamiento del usuario.
Las observaciones del comportamiento describen actividad durante un intervalo. Su significado depende de la página, de las oportunidades de interacción y del contexto de accesibilidad. Un visitante que navega con teclado puede generar un patrón de interacción distinto del de otro que usa una pantalla táctil. Una pestaña en segundo plano puede tener tiempos distintos de los de una pestaña en primer plano. Esas diferencias requieren contexto del despliegue antes de poder explicar una clasificación.
El análisis de los tiempos de rendimiento muestra por qué una medición transitoria no debe tratarse como una propiedad permanente. El mismo rigor se aplica al revisar una declaración del proveedor sobre el comportamiento. La declaración, el intervalo registrado y la decisión resultante del servicio siguen siendo piezas de evidencia separadas.
Transmisión, registros y roles de tratamiento
Una explicación de la privacidad del navegador queda incompleta si termina cuando un script devuelve un valor. La información puede pasar a una aplicación, un servicio en el edge o un registro operativo conservado. La organización que controla el tratamiento posterior puede tener finalidades y responsabilidades distintas de las del componente de página que realizó la observación inicial.
La declaración de privacidad de Akamai, actualizada el 18 de agosto de 2026, introduce al principio una distinción importante de alcance. Cubre el tratamiento de Akamai como responsable o en un rol equivalente. Indica que el tratamiento realizado por cuenta de los clientes como encargado se aborda mediante el acuerdo de tratamiento de datos disponible en su Trust Center. No deben fusionarse ambos contextos en un aviso universal.
La declaración también trata circunstancias en las que Akamai procesa registros de servicio como responsable o empresa. Por eso sería demasiado amplio decir simplemente que el proveedor siempre es encargado del tratamiento. El rol depende de la actividad de tratamiento y de los acuerdos aplicables. El nombre del producto por sí solo no resuelve esa cuestión para todos los conjuntos de datos.
Las finalidades de los registros de servicio van más allá de una respuesta
La declaración sobre registros de servicio enumera el análisis de tráfico y seguridad, la facturación a clientes, la mejora del servicio, la planificación de capacidad y despliegue, la resolución de problemas y los informes agregados como finalidades del tratamiento propio de Akamai. Ofrece como ejemplo de mejora del servicio una inteligencia de amenazas mejorada. Estas finalidades describen lo que puede ocurrir después de entregar la página; no son simplemente otros nombres para la decisión de devolver un desafío.
La distinción cambia lo que un sitio necesita explicar. Un registro utilizado para calcular cargos del servicio responde a una pregunta distinta de la de un registro utilizado para investigar un incidente de seguridad. Un informe agregado de tráfico es distinto de una observación del navegador asociada con una solicitud individual. Identificar la finalidad ayuda a determinar el detalle necesario y quién puede justificar el acceso, en lugar de suponer que cada elemento conservado sigue siendo necesario porque la solicitud original requería evaluación.
La declaración también menciona colaboraciones con terceros para analizar el tráfico y la seguridad de los registros de servicio, algunas de las cuales incluyen analizar datos de tráfico y seguridad del colaborador. Es una relación de tratamiento declarada, no una prueba de que cada observación de Bot Manager se comparta con todos los colaboradores. En un despliegue propio, la descripción del servicio y los acuerdos aplicables deben identificar qué relación corresponde. La presencia de un script del navegador por sí sola no puede responder a esa pregunta.
En la misma sección, Akamai describe análisis de seguridad que pueden contrastar credenciales de los registros de servicio con listas de credenciales robadas para reconocer accesos maliciosos e intentos de apropiación de cuentas. Es un ejemplo que abarca varios servicios y cuya aplicabilidad depende del servicio contratado y de los datos pertinentes. No debe convertirse en la afirmación de que todos los scripts de página de Bot Manager leen credenciales o de que todas las visitas ordinarias las transmiten. El análisis de DataDome también mantiene las declaraciones de tratamiento de un proveedor vinculadas al componente y a la finalidad que describen.
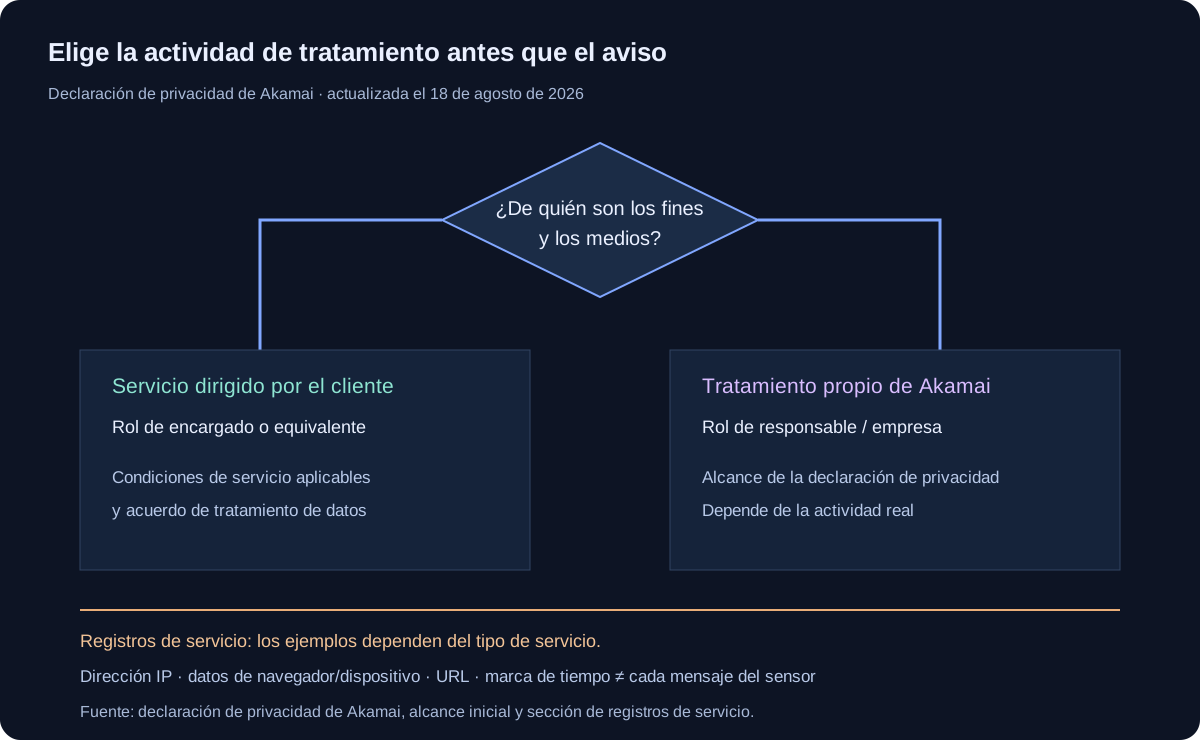
Los ejemplos de registros de servicio son condicionales
La sección de registros de servicio ofrece ejemplos como la dirección IP del usuario final, los datos del navegador y del dispositivo, las URL visitadas y las marcas de tiempo. También enumera otras categorías que pueden aplicarse según el servicio utilizado. El alcance es el funcionamiento de los servicios de Akamai en general. Estos ejemplos no deben presentarse como campos presentes en todos los mensajes del sensor de Bot Manager.
Esa distinción tiene una consecuencia concreta para el inventario de un despliegue. Un equipo debería identificar qué servicio contrató, qué rutas de datos habilitó y qué dicen los documentos aplicables sobre esas rutas. Copiar todas las categorías de una declaración que abarca varios servicios exageraría la recopilación observada. Eliminar categorías solo porque no aparecen en el JavaScript del navegador subestimaría la visibilidad independiente del edge.
La explicación de red frente a navegador ofrece un punto de partida útil. Un servidor puede observar una dirección de solicitud sin pedírsela a una API de página. Una página puede obtener un resultado de renderizado que el servidor no puede leer directamente hasta que se transmita alguna representación. Por tanto, las preguntas sobre la ubicación de los datos necesitan tanto el lado del navegador como el del servicio.
Las visitas directas a Akamai son otro contexto
La declaración de privacidad trata por separado los datos de dispositivo y uso recopilados mediante interacciones con los propios sitios de Akamai. Entre los ejemplos figuran la información del navegador y del sistema operativo, las páginas vistas y la información de uso. Ese contexto es distinto del de un cliente que utiliza Bot Manager en otra aplicación.
Una persona que lee una página de producto de Akamai no encuentra automáticamente la misma configuración que un visitante del proceso de pago de un cliente. La analítica, las tecnologías promocionales y los flujos de cuentas de un sitio pueden tener sus propios avisos y finalidades. Separar estos contextos evita presentar una declaración general de privacidad del sitio como una especificación precisa del sensor.
En un despliegue propio, el aviso del cliente y las condiciones contractuales del servicio deben describir la relación real. La declaración del proveedor aporta información sobre su propio tratamiento. Una medición del navegador aporta información sobre el comportamiento observable. Ninguna sustituye la responsabilidad del cliente de comprender qué habilitó y cómo encaja con su finalidad declarada.
El calendario de conservación publicado tiene varios alcances
La tabla de conservación de Akamai ofrece plazos concretos para los registros de servicio relativos a personas que acceden a sitios web, aplicaciones o sistemas corporativos de sus clientes, excluidos los servicios de Cloud Computing. Para los análisis de seguridad, indica que en la mayoría de los casos los datos se conservan hasta 90 días. Cuando incidentes de seguridad concretos requieren actualizar un algoritmo existente, especifica hasta 180 días. Para los análisis de tráfico y los datos forenses agregados, especifica hasta 3 años.
| Contexto publicado de los registros de servicio | Plazo declarado | Límite de la declaración |
|---|---|---|
| Análisis de seguridad en la mayoría de los casos | Hasta 90 días | El contexto indicado de registros de servicio de sitios de clientes |
| Incidentes de seguridad concretos que requieren actualizar algoritmos | Hasta 180 días | Una excepción declarada, no todas las solicitudes |
| Análisis de tráfico y datos forenses agregados | Hasta 3 años | Las finalidades especificadas de análisis y datos agregados |
Son declaraciones dentro del alcance de responsable o empresa de la declaración. No son una promesa universal de conservación para todos los mensajes del sensor de Bot Manager, todos los conjuntos de datos tratados como encargado por instrucciones del cliente ni todos los servicios ofrecidos con el nombre de Akamai. La fila independiente de Cloud Computing tiene una formulación distinta. El equipo de un sitio propio debe relacionar la actividad de tratamiento real con la fila y el acuerdo contractual aplicables antes de utilizar uno de estos plazos en el aviso a sus visitantes.
La expresión hasta también importa. Describe un plazo máximo en el contexto indicado, sin demostrar que un registro concreto permanezca almacenado durante todo el intervalo. A la inversa, una cookie de corta duración no demuestra que los registros asociados del servicio desaparezcan cuando caduque. El estado local del navegador, los análisis de seguridad y un conjunto de datos forenses agregados son objetos distintos con diferentes preguntas sobre su manejo.
Para evaluar la privacidad, la diferencia práctica está entre el detalle por solicitud y un registro agregado posterior. La declaración menciona ambas finalidades, pero una respuesta del navegador no puede verificar su implementación ni la transformación exacta entre ellas. Un equipo que solicite eliminación, revisión del acceso o una explicación de conservación necesita al responsable del tratamiento y el conjunto de datos pertinente, no solo la duración de la cookie visible en las herramientas del navegador.
El análisis de privacidad de DataDome también distingue la duración del estado del navegador del tratamiento en el servidor. Aquí, los plazos publicados de Akamai ofrecen un punto de partida concreto. Las condiciones contractuales específicas del despliegue y el manejo real de los datos siguen determinando qué respuesta se aplica a una aplicación propia.
Qué pueden cambiar los controles del motor del navegador
La capa del motor del navegador opera donde el navegador genera el comportamiento visible para el contenido web. La documentación de huellas de BotBrowser describe controles de superficies del navegador como gráficos, fuentes y tiempos. Un contexto declarado puede facilitar la interpretación de comparaciones autorizadas repetidas porque se pueden registrar las entradas pertinentes del perfil.
Esa capacidad tiene un límite de responsabilidad definido. No reescribe las solicitudes recibidas previamente por un servicio en el edge, elimina el historial de cuentas de la aplicación ni altera la finalidad de tratamiento del proveedor. Tampoco establece que un sistema remoto vaya a clasificar una sesión de una manera concreta. Esos resultados dependen de información y reglas ajenas a la capa del navegador.
La comparación entre motor y parche distingue el alcance de un parche de biblioteca del entorno del navegador que hay detrás. La comparación útil es qué capa controla un valor y con qué coherencia se comporta en distintos contextos. La tasa de aceptación de un proveedor es una cuestión aparte y esa distinción arquitectónica no la establece.
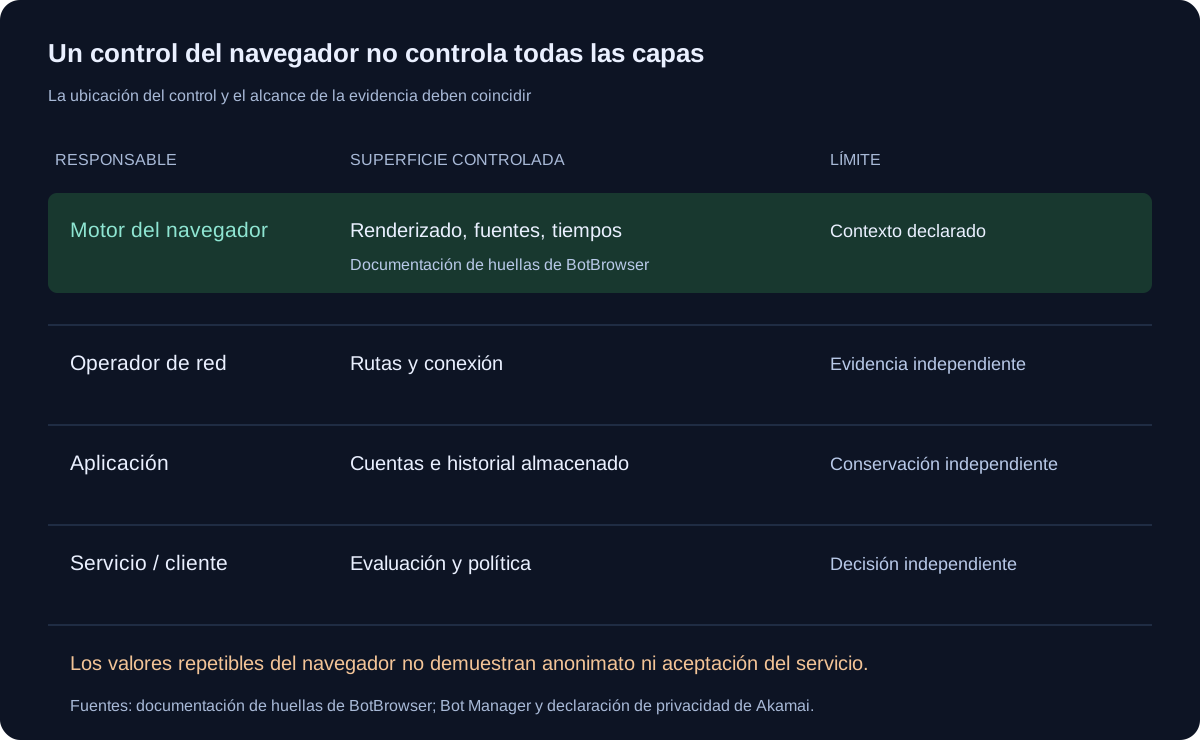
Un parche de API cambia el comportamiento en su límite parcheado; un control del motor tiene una ubicación de implementación distinta. Ninguna etiqueta prueba la cobertura de todos los contextos de documento, marco o worker. El análisis de privacidad entre superficies explica por qué esos contextos requieren sus propias comprobaciones. Los valores repetibles pueden respaldar una comparación sin demostrar la imposibilidad de vinculación ni un cambio medido en el Bot Score.
Decisiones para un despliegue propio
El equipo de un sitio propio puede revisar la recopilación sin reunir un expediente completo del dispositivo. Debe partir de una pregunta operativa concreta: ¿qué problema requiere esta observación, dónde se utiliza el resultado y qué alternativa menos detallada respondería a la misma pregunta? Una etiqueta amplia como seguridad no explica por sí sola todos los campos ni los plazos de conservación.
Utiliza la configuración del servicio desplegado y las condiciones aplicables para identificar la actividad de tratamiento responsable. Utiliza evidencia del navegador para establecer qué hace realmente el cliente. Utiliza evidencia de red y del servidor para establecer qué resultados salen de la página y qué ocurre después. Las orientaciones del W3C respaldan minimizar la exposición a la identificación por huella; no sustituyen a un inventario del despliegue.
| Decisión | Evidencia que obtener | Acción resultante |
|---|---|---|
| ¿Una supuesta lectura del navegador es realmente atribuible? | Evento emitido y contexto de fuente creíble | Mantener la atribución sin resolver si falta cualquiera de los dos |
| ¿Una lectura se convierte en datos transmitidos? | Comparación autorizada con el intercambio pertinente y el registro de implementación | No inferir la transmisión solo a partir de la disponibilidad |
| ¿Qué rol de privacidad se aplica? | Finalidad, configuración del servicio y condiciones contractuales aplicables | Utilizar el aviso que rige esa actividad de tratamiento |
| ¿Es necesaria la salida en bruto? | Necesidad operativa y una alternativa menos detallada | Preferir el mínimo detalle que responda a la pregunta |
| ¿Durante cuánto tiempo se necesita el resultado? | Regla de conservación específica de la finalidad y responsable de la eliminación | Alinear el acceso y la eliminación con esa regla |
La recopilación de diagnóstico debe ser menor que el problema
Un registro de diagnóstico puede crear su propia exposición de la privacidad. Los registros del navegador en bruto pueden incluir ubicaciones de recursos, identificadores o valores innecesarios para una explicación pública. Conserva los detalles sensibles solo cuando los necesite una investigación autorizada, con acceso restringido y una regla de conservación. Un informe público a menudo puede describir la categoría y la limitación sin reproducir el registro.
Para las observaciones del navegador, registra la compilación, el contexto, la fecha de la evidencia y la configuración pertinente. Estas condiciones permiten interpretar una comparación sin exponer scripts protegidos ni mensajes en bruto. La introducción a las huellas muestra cómo una comparación pequeña con entradas declaradas puede seguir siendo útil sin afirmar que identifica al propietario de un dispositivo.
Las cookies del servicio son distintas del aviso de cookies de un sitio propio
La sección Cookies en los servicios de Akamai describe cookies de sesión y persistentes utilizadas por determinados servicios encontrados a través de aplicaciones de clientes. Sus ejemplos incluyen determinar si una interacción corresponde a un humano o a un bot e identificar dispositivos que ya se han autenticado. Son declaraciones sobre la funcionalidad del servicio, no un inventario de cookies verificadas en un despliegue concreto de Bot Manager.
Akamai también afirma que esas cookies siguen los principios de privacidad desde el diseño y no identifican ni rastrean a personas. Es la caracterización del proveedor. La declaración por sí sola no es una medición independiente de la capacidad de vinculación, y reconocer un dispositivo autenticado es un concepto más limitado que identificar legalmente a una persona. Una explicación de privacidad debería conservar ambas descripciones en lugar de interpretar la ausencia del nombre de una persona como ausencia de toda relación entre solicitudes.
El mismo párrafo incluye ejemplos de rendimiento web y análisis de medios. Describen otras funciones del servicio y no deben trasladarse a Bot Manager como prueba de su recopilación. En particular, una declaración sobre un servicio identificado de análisis del rendimiento no establece qué envía un sensor de seguridad ni qué conserva el extremo de un servicio. El ejemplo específico del servicio y la descripción general de las cookies tienen alcances distintos.
Para las cookies de servicios de seguridad, la declaración de Akamai indica que las clasifica como estrictamente necesarias para el servicio solicitado y que no tiene que ofrecer un mecanismo de exclusión. Es una posición atribuida al proveedor, no una conclusión de que todas las cookies sean jurídicamente necesarias en todas las jurisdicciones o implementaciones de clientes. La declaración trata por separado los ajustes del navegador y las herramientas de gestión de cookies del cliente, incluida la posibilidad de que rechazarlas afecte a la funcionalidad del servicio.
Esa distinción es relevante cuando un visitante ve un aviso de cookies en la aplicación del cliente. Una preferencia sobre tecnologías opcionales del sitio no documenta por sí sola el comportamiento de almacenamiento del servicio de seguridad ni impide que las solicitudes del edge lleguen al proveedor. En un despliegue propio, verifica conjuntamente la clasificación real de las cookies, el comportamiento de la aplicación y el aviso aplicable. No hacen falta nombres de cookies, contenido de tokens ni ajustes destinados a cambiar una evaluación remota para explicar esa responsabilidad.
Preguntas frecuentes
¿Bot Manager también clasifica bots conocidos?
La lista de funciones describe actualizaciones continuas de un directorio de bots conocidos, además de otros métodos de evaluación. Una categoría conocida es distinta de una medición del navegador o de un juicio sobre una persona. La declaración no revela la pertenencia al directorio de una solicitud concreta ni establece que todos los clientes automatizados tengan el mismo efecto operativo.
¿Borrar una cookie elimina la información recopilada?
Borrar el estado local cambia los datos almacenados en el navegador. No retira solicitudes que el edge ya recibió ni elimina los registros conservados por una aplicación. Que las solicitudes posteriores se relacionen con actividad anterior depende de las observaciones restantes y del tratamiento del servicio. Una acción sobre el almacenamiento local no es una solicitud de eliminación al servidor.
¿Puede el tráfico de un rastreador útil afectar al rendimiento?
Sí. Los casos de uso de bots útiles y rendimiento de Akamai distinguen la actividad deseable de su impacto sobre los recursos. Un rastreador útil puede añadir carga en un momento inadecuado, y la página describe la programación o una entrega de contenido diferente como opciones de gestión. Es una finalidad de disponibilidad, no una prueba de intención maliciosa ni un motivo para recopilar un historial ilimitado del dispositivo.
¿La cobertura móvil implica una recopilación idéntica de JavaScript?
No. Las funciones del producto amplían la cobertura a aplicaciones móviles, pero esa declaración no especifica API de navegador ni contextos de ejecución idénticos. Una aplicación nativa y un documento web necesitan inventarios de recopilación separados. Una traza de una plataforma no establece el acceso, los permisos ni la configuración de tratamiento de la otra.
Fuentes
- Descripción del producto Akamai Bot Manager, declaración pública consultada.
- Declaración de privacidad de Akamai, actualizada el 18 de agosto de 2026; alcance como responsable, registros de servicio y secciones de datos de sitios propios.
- W3C: Mitigación de las huellas del navegador en las especificaciones web.
- Documentación de huellas de BotBrowser.
Conclusión práctica
Akamai declara análisis del comportamiento mediante scripts de página, identificación por huella del navegador y evaluación de solicitudes en el edge. La exposición de la privacidad abarca esos límites; un inventario concreto de API, una afirmación de transmisión o una regla de conservación necesitan su propia evidencia. En un despliegue propio, primero hay que identificar la finalidad y el rol de tratamiento, y después verificar la mínima observación pertinente del navegador. Utiliza los controles del motor del navegador para las superficies que controlan sin tratarlos como control sobre la política del servicio o la identidad.
Este artículo forma parte de la guía: ¿Qué es la huella digital del navegador?
Artículos Relacionados
Kasada: señales de desafíos y privacidad
Huella digitalPerimeterX: grupos de señales y privacidad
Huella digitalQué es DataDome: señales y exposición de privacidad
Huella digitalPrivacidad de reCAPTCHA: señales y límites de evidencia
Huella digitalPrivacidad de hCaptcha: señales y límites de la evidencia
Huella digitalFunCaptcha: señales, sesiones y privacidad
Ejecuta la misma comprobación en BotBrowser
Carga un perfil, mantén dentro del navegador las señales que acabas de leer y confirma el resultado en tu propia máquina antes del despliegue.