Web scraping con JavaScript: render, paginar y scroll
Web scraping de un sitio JavaScript sin datos: decide si es un fallo de selector, un XHR que puedes llamar directo o una página que exige renderizado, y luego pagina y desplázate.
BotBrowser Team
Quieres la documentación estructurada de Primeros pasos?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
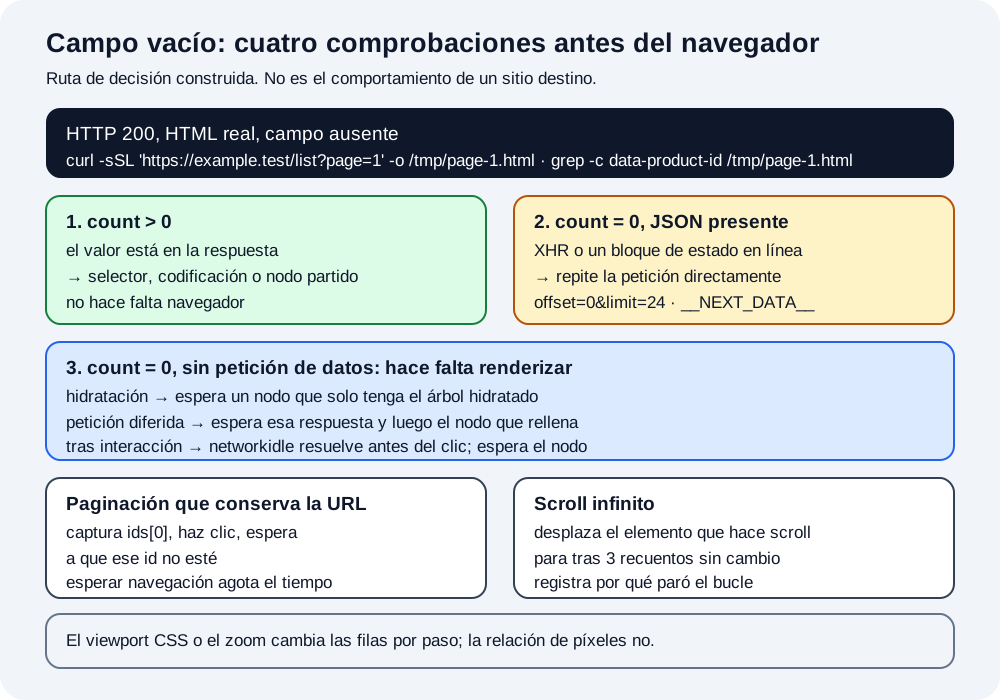
El web scraping de una página renderizada con JavaScript suele empezar con los mismos tres segundos de confusión: la petición devolvió HTTP 200, el HTML es real y el campo no está en él. El siguiente paso útil no es instalar un navegador headless, porque buena parte de estos casos se resuelven con una petición que puedes enviar tú mismo, y un navegador convierte un trabajo rápido y estable en uno lento. El diagnóstico tiene un orden, y ese orden es lo que importa aquí. BotBrowser proporciona un entorno de renderizado declarado para los casos que de verdad necesitan un navegador, de modo que el layout que calcula la página coincide con el que el destino espera; no garantiza que un sitio de terceros devuelva datos distintos.
TL;DR
- Lee la respuesta cruda antes de recurrir a un navegador. Si
curlya contiene el valor, el problema es tu selector, no el renderizado. - Si el valor no está, busca en el registro de red una petición JSON o HTML que lo lleve; llamar a esa petición directamente suele ser más rápido, más barato y más estable que renderizar.
- Solo el tercer caso necesita un navegador, y se divide en tres formas: datos que aparecen tras la hidratación, datos que pide una petición que la página lanza después de cargar, y datos que solo aparecen tras una interacción. Un objeto de estado serializado en el HTML inicial no es una de ellas, porque se puede leer sin navegador.
- La paginación y el scroll infinito son el mismo problema con dos formas: el disparador no es un cambio de URL, así que un bucle que espera navegación vuelve a leer la primera página sin avisar.
- Detente con una señal que produce la página, no con un recuento que supusiste. «No hay botón siguiente» y «el contenedor dejó de crecer» son señales distintas y cada una puede fallar.
Contenido
- Lee primero la respuesta cruda
- Encuentra la petición que lleva los datos
- Cuándo hace falta renderizar de verdad
- Paginación que no cambia la URL
- Scroll infinito y su regla de parada
- Conclusión práctica
Lee primero la respuesta cruda
La primera medición cuesta un comando y zanja la mayor parte de la discusión. Trae la página con la misma URL y las mismas cabeceras que enviaría el navegador, y busca en los bytes el valor que esperabas.
curl -sSL -H 'accept-language: en-US,en;q=0.9' 'https://example.test/list?page=1' -o /tmp/page-1.html
grep -c 'data-product-id' /tmp/page-1.html
Tres resultados, tres trabajos distintos. Un recuento distinto de cero significa que el valor está en la respuesta y el fallo es del parser, lo que es un error de selector o de codificación y no tiene nada que ver con el renderizado. Cero significa que el servidor envió un armazón, y el siguiente paso es averiguar qué lo rellena. Un estado HTTP distinto de 200 significa ninguna de las dos cosas, y el cuerpo de la respuesta suele nombrar el motivo.
La misma comprobación sirve al revés para un campo que parece presente pero se parsea mal. Un valor que llega escapado, envuelto en una cadena JSON o partido entre dos nodos adyacentes pasa una prueba ingenua de subcadena y falla un selector estricto, y por eso el recuento importa más que el ojo.
Encuentra la petición que lleva los datos
Cuando el armazón está vacío, el valor suele llegar por una de dos vías: una petición de red que la página hace después de cargar, o un objeto de estado serializado dentro del HTML inicial. Ambas se pueden leer sin navegador.
Para el caso de red, abre la página una vez en un navegador normal, filtra el panel de red por XHR o fetch y busca una respuesta cuyo cuerpo contenga el campo. Copia esa petición como curl y compárala con la petición de la página. Las diferencias suelen ser una cabecera, una cookie o un parámetro de consulta que la página calcula en tiempo de ejecución, y cada diferencia se puede probar.
import requests

session = requests.Session()
session.headers.update({"accept": "application/json", "accept-language": "en-US,en;q=0.9"})
listing = session.get("https://example.test/api/list?offset=0&limit=24", timeout=30)
listing.raise_for_status()
rows = listing.json()["items"]
print(len(rows), rows[0]["id"])
Para el caso de estado, busca en el HTML crudo una etiqueta script que lleve un bloque JSON, a menudo con un identificador como __NEXT_DATA__, __NUXT__ o un window.__STATE__ en línea. Si el campo está dentro de ese bloque, la página ya te dio los datos y un parser puede leerlos directamente.
Dos pruebas deciden si vale la pena conservar la petición directa. Repítela dos veces y compara el número de bytes, y luego repítela desde otra ubicación de red si la carga de trabajo lo requiere. Una respuesta que cambia de forma entre dos peticiones idénticas no es una fuente estable, y una página renderizada tampoco lo arreglaría; solo escondería la inestabilidad detrás de un pipeline más lento.
Un cuarto resultado merece una frase porque parece un valor ausente y no lo es. Algunas páginas responden distinto según quién pregunta: la misma URL devuelve un documento completo a un navegador que presenta un cliente plausible y un esbozo a una petición que no presenta ninguno. Eso no es un problema de renderizado ni de selector; es una decisión del servidor, y la diferencia observable es que el cuerpo de la respuesta cambia de forma en lugar de rellenarse después. Registrar el tamaño de la respuesta y un hash corto del cuerpo en varias peticiones basta para distinguir ese caso de un armazón que se habría hidratado.
La distinción importa tanto para el coste como para la corrección. Un trabajo que repite una petición JSON por página puede recorrer cientos de páginas por minuto en una máquina pequeña; el mismo trabajo a través de un navegador pasa la mayor parte del tiempo en arranque, navegación y pintado. Elegir la vía del navegador para un caso que la petición directa habría resuelto es el error más caro de todo el flujo, y es invisible porque la versión lenta también funciona.
Cuándo hace falta renderizar de verdad
El tercer caso es real, y es aquel para el que existe un navegador. También se divide en tres formas que necesitan estrategias de espera distintas, y elegir la equivocada produce el clásico informe de «funciona en local, falla en CI».
| Forma | Dónde aparecen los datos | Qué esperar |
|---|---|---|
| Hidratación | Después de que el framework arranca y reemplaza el armazón | Un nodo que solo contiene el árbol hidratado |
| Petición diferida | Después de una petición que la página lanza tras cargar | La respuesta de esa petición y luego el nodo que rellena |
| Tras interacción | Después de un clic, un cambio de pestaña o de filtro | El nodo que la interacción debe producir |
Esperar networkidle no distingue las formas en absoluto. Playwright lo define como la ausencia de conexiones de red durante al menos medio segundo, así que se resuelve en cualquier página tranquila: una página que depende de una interacción está tranquila hasta que alguien interactúa, y una petición diferida programada para dispararse más tarde también está tranquila cuando empieza la espera. En un fixture que programa su petición tras un breve retardo, la espera se resolvió antes de que existiera la petición y la extracción leyó cero filas. Esperar un retardo fijo cubre las tres en una máquina rápida y ninguna bajo carga, y por eso un retardo fijo es la causa más común de un scraper que pasa la revisión y falla en producción.
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    browser = p.chromium.launch(executable_path="/path/to/botbrowser/chrome")
    context = browser.new_context(locale="en-US", timezone_id="America/New_York")
    page = context.new_page()
    page.goto("https://example.test/list", wait_until="domcontentloaded")
    page.wait_for_selector("[data-product-id]", state="attached", timeout=30_000)
    rows = page.eval_on_selector_all(
        "[data-product-id]",
        "nodes => nodes.map(n => n.getAttribute('data-product-id'))",
    )
    print(len(rows), rows[:3])
    browser.close()
El selector de wait_for_selector debe ser el mismo que usa la extracción. Una espera sobre un contenedor genérico pasa en cuanto existe el armazón, y la extracción lee cero filas; una espera sobre el atributo que lleva el valor falla de forma ruidosa, que es el resultado que quieres.
Una página renderizada también exige decidir qué conservar. El DOM tras la hidratación es mayor que el HTML que lo produjo, y guardar page.content() en cada paso convierte una ejecución de 40 páginas en gigabytes de marcado casi duplicado. Conservar las filas extraídas más un registro pequeño de procedencia (URL, petición que produjo los datos, marca de tiempo, modo del renderizador) basta para volver a comprobar un resultado y es lo bastante barato para guardarlo en cada página.
Ese registro de procedencia es también lo que hace diagnosticable una regresión. Cuando un campo desaparece el mes que viene, la pregunta es si cambió la página, cambió el renderizador o cambió la petición, y solo un registro que nombre las tres puede responderla. Una ejecución que guarda solo las filas extraídas no distingue las tres, y la respuesta habitual es volver a renderizar todo y confiar en la suerte.
Paginación que no cambia la URL
El caso del parámetro en la URL es el fácil: incrementa el parámetro, pide otra vez y detente cuando la respuesta se repita o la lista de elementos esté vacía. Los dos casos difíciles son un cursor de API y un botón que muta el DOM en el sitio.
Con un cursor, la siguiente petición necesita un valor de la respuesta anterior, así que el bucle tiene que llevar estado en lugar de contar páginas. Un bucle que incrementa page=2 contra un endpoint de cursor devolverá la primera página otra vez o un error, y en ambos casos parece un fallo de parseo y no de paginación.
Con un botón, el fallo es el contrario. La URL no cambia, así que un bucle que espera un evento de navegación espera para siempre o agota el tiempo, y un bucle que hace clic y lee de inmediato obtiene la página anterior. El patrón fiable es capturar un valor de la página actual, hacer clic y esperar hasta que ese valor ya no esté.
from playwright.sync_api import TimeoutError as PlaywrightTimeoutError

def read_ids(page):
    return page.eval_on_selector_all(
        "[data-product-id]",
        "n => n.map(x => x.getAttribute('data-product-id'))",
    )

def click_and_classify(page, previous_ids, timeout_ms=15_000, poll_ms=100, end_confirm_ms=3_000):
    """Click next, then return "changed" or "end-marker", or raise.

    "end-marker" is returned only when the page's own control reports the end and
    keeps reporting it for end_confirm_ms. A control that is disabled while the
    next page loads is not an end, and an unchanged list is not proof of an end,
    so anything else raises instead of returning a completion the page never gave.
    """
    button = page.query_selector("[data-testid=next-page]")
    if button is None or button.is_disabled():
        return "end-marker"
    button.click()
    budget = timeout_ms
    marker_for = 0
    while budget > 0:
        page.wait_for_timeout(poll_ms)
        budget -= poll_ms
        if read_ids(page) != previous_ids:
            return "changed"
        button = page.query_selector("[data-testid=next-page]")
        if button is None or button.is_disabled():
            marker_for += poll_ms
            if marker_for >= end_confirm_ms:
                return "end-marker"
        else:
            # Re-enabled without repainting: the next page is still loading.
            marker_for = 0
    raise PlaywrightTimeoutError(
        f"no list change and no end marker for {end_confirm_ms} ms within {timeout_ms} ms"
    )

seen = set()
reason = "loop guard"
for _ in range(200):
    ids = read_ids(page)
    new_ids = [i for i in ids if i not in seen]
    if not new_ids:
        reason = "no new ids"
        break
    seen.update(new_ids)
    if click_and_classify(page, ids) == "end-marker":
        reason = "end marker held"
        break
print(len(seen), reason)
La regla de parada es la parte que falla en silencio. «No hay botón siguiente» no es lo mismo que «no hay más resultados»: un botón deshabilitado y un botón ausente aparecen ambos como query_selector devolviendo None o como is_disabled() devolviendo verdadero, y los dos se ven idénticos salvo que se registre el motivo. Un contenedor de scroll infinito que conserva un botón siguiente oculto repetirá para siempre, y por eso el bucle necesita un límite duro además de una señal blanda.
La clasificación es la parte que es fácil equivocar, y la trampa es que la inactividad se ve igual en tres situaciones distintas: la lista terminó, la página siguiente aún se está cargando y el clic no se registró en absoluto. Una última página suele deshabilitar su propio botón en lugar de renderizar un conjunto nuevo, y por eso un control deshabilitado se trata como marcador de fin y no como ausencia de cambio; pero una página que deshabilita su control mientras busca la página siguiente produce el mismo estado durante todo lo que tarde la petición. La ventana de confirmación es lo que las separa, y tiene que ser más larga que el repintado más lento que haya mostrado el trabajo, no más larga que el más rápido. Esa ventana también es el límite del método y no un detalle: una carga más lenta que la ventana todavía se lee como un final, y la corrección es medir el repintado más lento en el destino antes de elegir el número, en lugar de tomar un valor por defecto de la página de otra persona. Cuando no aparece ni un repintado ni un marcador sostenido, la llamada lanza una excepción, porque una lista sin cambios no es evidencia de que la lista terminó, y una ejecución que informa finalización con esa evidencia se equivoca en la dirección que nadie nota: parece terminada.
Aparece a menudo otra forma de paginar que conviene nombrar: una lista que pagina mediante el envío de un formulario en lugar de un enlace. La URL puede cambiar, pero la página se repinta a partir de una respuesta POST, así que un bucle que sigue enlaces no encuentra nada que seguir. La corrección es el mismo principio del caso del botón: envía, espera a que desaparezca un valor del conjunto anterior y registra la petición que produjo el nuevo.
La ordenación interactúa con todo esto. Una lista ordenada por un campo que cambia mientras el trabajo corre, como el precio o la antigüedad, puede reordenarse entre páginas, lo que produce duplicados y huecos incluso cuando la lógica de paginación es correcta. Registrar un identificador estable por fila y deduplicar por él es lo que convierte una ejecución reordenada en un conjunto correcto en lugar de uno que parece plausible pero tiene agujeros.
Scroll infinito y su regla de parada
El scroll infinito sustituye el botón por un centinela. Dos mecanismos lo mueven y fallan distinto: un listener de scroll que compara scrollTop con scrollHeight, y un IntersectionObserver que se dispara cuando un centinela entra en el viewport. La versión con observador siempre entrega una devolución de llamada inicial, así que un centinela fuera de pantalla informa una entrada no intersectante con ratio 0 y luego permanece en silencio hasta que el centinela entra en el root. Por eso un script que desplaza la ventana un número fijo de píxeles puede no cargar nada en un layout donde el contenedor es el que hace scroll y no la ventana: el observador sigue informando que el centinela nunca entró.
El bucle fiable desplaza el elemento que de verdad controla el scroll, espera a que cambie el número de elementos y se detiene cuando el recuento no cambia durante varias rondas consecutivas.
stable_rounds = 0
last_count = page.eval_on_selector_all("[data-product-id]", "n => n.length")
while stable_rounds < 3:
    count = page.eval_on_selector_all("[data-product-id]", "n => n.length")
    if count == last_count:
        stable_rounds += 1
    else:
        stable_rounds = 0
        last_count = count
    page.eval_on_selector("[data-scroll-root]", "el => el.scrollBy(0, el.clientHeight * 2)")
    page.wait_for_timeout(600)
print("rows:", last_count, "stopped after", stable_rounds, "unchanged rounds")
Tres rondas consecutivas sin cambio son una heurística, no una prueba, y el registro debe decirlo. Un backend lento puede producir tres rondas sin cambio cuando una cuarta habría cargado más, así que el recuento va en la salida junto al motivo de parada.
La memoria es el segundo límite. Una lista que crece por encima de unos miles de filas hace más lento cada eval_on_selector_all posterior, y la página puede empezar a descartar nodos fuera de pantalla, lo que significa que una lectura posterior devuelve menos filas de las que la página tiene. Escribir cada lote en disco a medida que llega mantiene la ejecución acotada y hace inspeccionable un resultado parcial.
El entorno de renderizado cambia qué contenido está en el viewport, y eso importa para exactamente una de las formas anteriores. Una lista de carga diferida dispara su observador cuando un centinela entra en el viewport, así que un viewport más pequeño de lo que el destino espera carga menos por desplazamiento, y uno más grande carga más. El layout se calcula en píxeles CSS, así que device pixel ratio por sí solo no cambia cuántas filas caben en un viewport fijo; lo que cambia el ajuste es el tamaño del viewport CSS, un nivel de zoom o una escala de emulación de dispositivo que altera el viewport de layout en lugar de solo la densidad de rasterizado. BotBrowser documenta y proporciona las dimensiones de pantalla y el device pixel ratio que aporta un perfil entre los valores que este lleva, y eso es lo que hace que esas entradas sean declarables y no accidentales; no decide si una página necesita renderizado ni hace que un destino devuelva datos que retiene.
Este es el único punto donde «el scraper está roto» y «el entorno de renderizado es distinto» se ven idénticos desde fuera. Una ejecución que para antes en una máquina y termina en otra, con el mismo código y el mismo destino, suele ser una diferencia en el viewport CSS, el nivel de zoom o el viewport de layout, y no una respuesta de detección, y la forma de saberlo es registrar el viewport y el recuento de filas juntos. Cuando el viewport es idéntico y los recuentos siguen difiriendo, la explicación restante es que el destino se comporta distinto en esa sesión, lo que es otra investigación.
Dos hábitos operativos mantienen honesto un trabajo renderizado con el tiempo. El primero es fallar ante una extracción de cero filas en lugar de escribir un archivo vacío: una ejecución que produce un archivo con cabeceras y sin filas parece exitosa en un panel, mientras que una que lanza un error parece un fallo. El segundo es conservar una página registrada por ejecución, guardada con el cuerpo de su respuesta y sus filas extraídas, para que un lector posterior pueda reproducir la diferencia entre lo que envió el servidor y lo que produjo la extracción sin repetir todo el trabajo.
Ninguno de los dos hábitos necesita un navegador. Ambos ganan valor cuando hay un navegador en el camino, porque la brecha entre la respuesta y el DOM es la parte que cambia sin ningún cambio de código por tu lado. Un equipo que registra la respuesta cruda, el modo del renderizador y el recuento de filas de cada página puede responder «¿cambió la página o cambiamos nosotros?» con una consulta, y un equipo que solo registra las filas no puede responderlo en absoluto.
Conclusión práctica
Diagnostica antes de renderizar: lee la respuesta cruda, luego el registro de red y solo entonces abre un navegador. Cuando el renderizado es necesario, espera al nodo que lleva el valor en lugar del armazón o de un reloj. Para la paginación y el scroll, captura un valor de la página actual y espera a que cambie o desaparezca, y registra el motivo por el que paró el bucle para que una ejecución truncada se vea como truncada. Los criterios de selección de navegador cubren cómo comparar candidatos en estas cargas de trabajo, y la guía de planificación de rendimiento para SERP cubre qué cambia cuando el mismo bucle corre a escala.
Una última nota sobre concurrencia, porque cambia la lógica de paginación más de lo que se espera. Dos trabajadores que paginan la misma lista verán cada uno una ventana en movimiento, y un endpoint de cursor les entregará porciones solapadas o saltadas según cómo esté implementado. Paginar es un recorrido con estado sobre una secuencia que puede cambiar debajo del recorrido, así que las formas seguras son un recorrido por secuencia o una consulta particionada que haga que cada trabajador tenga una porción disjunta. Registrar qué trabajador produjo qué página convierte un solapamiento en una observación en lugar de un misterio.
Fuentes
Este artículo forma parte de la guía: Primeros pasos con automatización de navegador: mapa inicial
Artículos Relacionados
Scraping con navegador headless: qué cambia
DespliegueScraping de bolsas de empleo: límites del navegador
Primeros pasosScraping con Playwright: navegador y perfil
DespliegueScraping de Indeed: campos, páginas y duplicados
Primeros pasosPrimeros pasos con automatización de navegador: mapa inicial
Primeros pasosMejor navegador para web scraping: seis criterios
Ejecuta la misma comprobación en BotBrowser
Carga un perfil, mantén dentro del navegador las señales que acabas de leer y confirma el resultado en tu propia máquina antes del despliegue.