Scraping con Playwright: navegador y perfil
Configura una extracción autorizada de lista y detalles con Playwright. Separa perfiles, cookies y errores de extracción, y guarda un resultado JSON verificable.
BotBrowser Team
Quieres la documentación estructurada de Primeros pasos?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
El scraping con Playwright exige dos comprobaciones diferentes: abrir el entorno de navegador previsto y obtener los registros correctos. Que chromium.launch() termine bien no demuestra el significado de un precio ni concede permiso para recopilarlo. BotBrowser permite configurar un Chromium con perfil mediante executablePath y args de Playwright; no proporciona selectores del sitio, no autoriza el acceso y no garantiza que el servidor entregue una página. En una aplicación propia o autorizada, una extracción acotada de lista y detalles permite diagnosticar por separado la configuración y los datos.
TL;DR
- Define
executablePathy pasa--bot-profilecomo un solo argumento. El perfil de BotBrowser es distinto de las cookies y del almacenamiento local. - Conserva lista y detalles en un
BrowserContextcuando pertenecen a la misma sesión autorizada. Otro contexto aísla el almacenamiento, pero no crea una identidad de red nueva. - Comprueba estado de navegación, origen final y selectores obligatorios. Un HTTP 200 también puede contener una pantalla de inicio de sesión.
- Separa registros y diagnósticos. El estado de autenticación guardado es una credencial, no un adjunto de depuración.
Contenido
- Configurar el navegador antes de extraer
- Extraer una lista y sus detalles
- Elegir qué persiste entre ejecuciones
- Separar datos y fallos en el resultado
- Diagnosticar la capa que falló
- Conclusión práctica
Para extraer un catálogo propio verificando estado HTTP y esquema de filas, la comparación de opciones de scraping con Puppeteer separa entradas de lanzamiento y observaciones, con almacenamiento explícito del contexto aislado.
Configurar el navegador antes de extraer
La referencia BrowserType de Playwright documenta executablePath para ejecutar un navegador diferente del incluido. También advierte que no garantiza la compatibilidad de ese ejecutable con la versión instalada de Playwright. Fija playwright-core mediante el archivo de bloqueo, registra la versión real del navegador y revisa la compatibilidad cuando cambie cualquiera de los dos componentes. Descargar Chromium desde Playwright no actualiza el ejecutable personalizado de la configuración.
Usa rutas absolutas para el binario y el perfil. En un contenedor deben existir dentro del contenedor, no solo en el equipo que preparó el trabajo. Comprueba permiso de ejecución del binario y de lectura del perfil antes de abrir el navegador. Una variable ausente debe producir un error de configuración, en lugar de iniciar valores predeterminados imprevistos. La integración directa con Playwright cubre la instalación; una extracción necesita además conservar la configuración suficiente para explicar posteriormente un resultado incorrecto.
La referencia de perfiles de BotBrowser exige que paquete y binario compartan versión principal. Las opciones CLI sobrescriben la configuración del perfil; no crean identidades independientes adicionales. No añadas un userAgent, zona horaria, lista de idiomas o descriptor de dispositivo ajeno porque aparezca en un ejemplo genérico. Si la aplicación requiere un viewport concreto, registra la sobrescritura. viewport: null desactiva la emulación de viewport fijo de Playwright, pero no afirma un tamaño de pantalla ni hace idénticas todas las disposiciones.
La autorización, un entorno de ejecución compatible y un esquema de extracción siguen siendo requisitos separados. El ejemplo usa un catálogo propio, no un mercado público: una página de lista y como máximo dos detalles. Esa cota permite revisar el contrato de selectores sin crear un rastreador ilimitado. No implica compatibilidad con un servicio de protección externo.
Instala playwright-core en un proyecto de ejemplo separado y guarda el programa como collect.mjs. Define BOTBROWSER_EXEC_PATH, BOT_PROFILE_PATH y OWNED_CATALOG_ORIGIN en el trabajo. El origen debe ser HTTP o HTTPS y corresponder al entorno de ejemplo controlado. Es una implementación ilustrativa basada en APIs documentadas, no un registro de ejecución de BotBrowser.
El entorno de ejemplo conserva la instrumentación de automatización predeterminada de Playwright. No prueba ni afirma ningún resultado sobre señales de automatización.
Extraer una lista y sus detalles
El entorno de ejemplo sirve en /catalog enlaces con data-testid="item-link". Cada detalle contiene exactamente un elemento data-testid="item-name" y otro data-testid="item-price", este último con data-currency. Por ejemplo, un enlace puede apuntar a /items/a1 y el precio ser <span data-testid="item-price" data-currency="USD">12.50</span>. Son entradas del entorno de ejemplo, no resultados observados. Otro marcado necesita otro contrato de selectores.
import { chromium } from 'playwright-core';
import { access, writeFile } from 'node:fs/promises';
import { constants } from 'node:fs';
import { isAbsolute } from 'node:path';

const executablePath = process.env.BOTBROWSER_EXEC_PATH;
const profilePath = process.env.BOT_PROFILE_PATH;
const origin = new URL(process.env.OWNED_CATALOG_ORIGIN);
if (!['http:', 'https:'].includes(origin.protocol)) {
  throw new Error('Fixture origin must use HTTP or HTTPS');
}
if (origin.username || origin.password || origin.search || origin.hash || origin.pathname !== '/') {
  throw new Error('Supply an origin without credentials, path, query or fragment');
}
const safeUrl = value => {
  const url = new URL(value);
  return url.origin + url.pathname;
};
for (const value of [executablePath, profilePath]) {
  if (!value || !isAbsolute(value)) throw new Error('Absolute paths required');
}
await access(executablePath, constants.X_OK);
await access(profilePath, constants.R_OK);

const browser = await chromium.launch({
  executablePath,
  headless: true,
  args: [`--bot-profile=${profilePath}`],
});
const records = [];
const diagnostics = [];
try {
  const context = await browser.newContext({ viewport: null });
  context.setDefaultTimeout(10000);
  const page = await context.newPage();
  async function open(url) {
    const response = await page.goto(url, {
      waitUntil: 'domcontentloaded',
      timeout: 30000,
    });
    const status = response?.status() ?? null;
    const finalUrl = new URL(page.url());
    diagnostics.push({ url: safeUrl(url), finalUrl: safeUrl(finalUrl), status });
    if (status === null || status < 200 || status >= 300) {
      throw new Error(`Unaccepted navigation status: ${status}`);
    }
    if (finalUrl.origin !== origin.origin) {
      throw new Error('Navigation left the fixture origin');
    }
  }
  await open(new URL('/catalog', origin).href);
  const links = page.getByTestId('item-link');
  await page.waitForFunction(() => document.querySelectorAll('[data-testid="item-link"]').length === 2);
  const hrefs = await links.evaluateAll(nodes => nodes.map(node => node.getAttribute('href')));
  const urls = [...new Set(hrefs.filter(Boolean).map(href => new URL(href, page.url()).href))].filter(
    url => new URL(url).origin === origin.origin
  );
  if (urls.length !== 2) throw new Error('Fixture requires two same-origin detail links');
  for (const url of urls) {
    await open(url);
    const name = page.getByTestId('item-name');
    const price = page.getByTestId('item-price');
    await name.waitFor({ state: 'visible' });
    await price.waitFor({ state: 'visible' });
    if ((await name.count()) !== 1 || (await price.count()) !== 1) {
      throw new Error('Detail selector is not unique');
    }
    const label = (await name.innerText()).trim();
    const amount = (await price.innerText()).trim();
    const currency = await price.getAttribute('data-currency');
    if (!label || !/^\d+\.\d{2}$/.test(amount) || !/^[A-Z]{3}$/.test(currency ?? '')) {
      throw new Error('Detail record does not match the fixture schema');
    }
    if (new URL(page.url()).origin !== origin.origin) {
      throw new Error('Detail origin changed during extraction');
    }
    records.push({ url: safeUrl(page.url()), name: label, amount, currency });
  }
  await writeFile(
    'catalog-result.json',
    JSON.stringify(
      {
        browserVersion: browser.version(),
        collectedAt: new Date().toISOString(),
        records,
        diagnostics,
      },
      null,
      2
    ),
    { flag: 'wx', mode: 0o600 }
  );
  await context.close();
} finally {
  await browser.close();
}
La documentación de locators distingue un localizador de un elemento DOM guardado. El localizador resuelve el elemento al utilizarse, algo útil cuando la aplicación reemplaza nodos. No sabe qué registro comercial es correcto. Por eso el programa espera los elementos, exige unicidad, valida el formato y solo entonces añade el registro. domcontentloaded marca una fase de navegación, no la finalización de un catálogo asíncrono.
El entorno de ejemplo espera exactamente dos enlaces; el programa espera ese número y exige dos URL distintas de detalles del mismo origen. Una aplicación con resultados incrementales debe ofrecer un marcador controlado de finalización o una respuesta API estable definida por su equipo. evaluateAll() no espera un número final de coincidencias. Sin esa condición, puede capturarse un registro válido de una lista que terminará conteniendo veinte, sin que un tiempo de espera revele la omisión.
El filtro de mismo origen limita los enlaces elegidos. El control tras navegar rechaza redirecciones y el control antes de aceptar rechaza cambios de origen durante la lectura; esas solicitudes ya ocurrieron. No es un cortafuegos: las páginas pueden cargar imágenes, scripts y frames externos. Las restricciones estrictas de salida deben imponerse también en infraestructura; el código no puede impedir retroactivamente una solicitud enviada.
El importe permanece como cadena porque el entorno de ejemplo define texto decimal. Un precio real puede incluir coma decimal, separadores de miles, impuestos, periodos de suscripción o símbolos compartidos por varias monedas. parseFloat() no sustituye ese esquema. Define el formato permitido por fuente y rechaza datos ambiguos en vez de convertir silenciosamente el primer prefijo numérico.
Elegir qué persiste entre ejecuciones
Perfil, almacenamiento y resultado resuelven problemas diferentes. El ciclo de vida y almacenamiento de contextos explica que los contextos aíslan cookies y otros estados dentro de un proceso. No asignan otra IP pública, otra cuenta ni prueban que el servidor no pueda relacionar solicitudes. Dos contextos pueden mostrar la misma configuración de perfil y tener cookies separadas.
| Componente | Qué conserva | Qué no demuestra |
|---|---|---|
--bot-profile | Configuración del navegador suministrada por el paquete | Una sesión autenticada |
BrowserContext | Estado aislado durante su vida | Otra dirección proxy o permiso de recogida |
storageState | Cookies y almacenamiento de origen compatibles | Todo el estado transitorio de una pestaña |
userDataDir | Directorio persistente de datos del navegador | Seguridad para varios procesos escritores simultáneos |
| JSON de resultado | Registros y diagnósticos seleccionados | Credenciales para repetir una sesión |
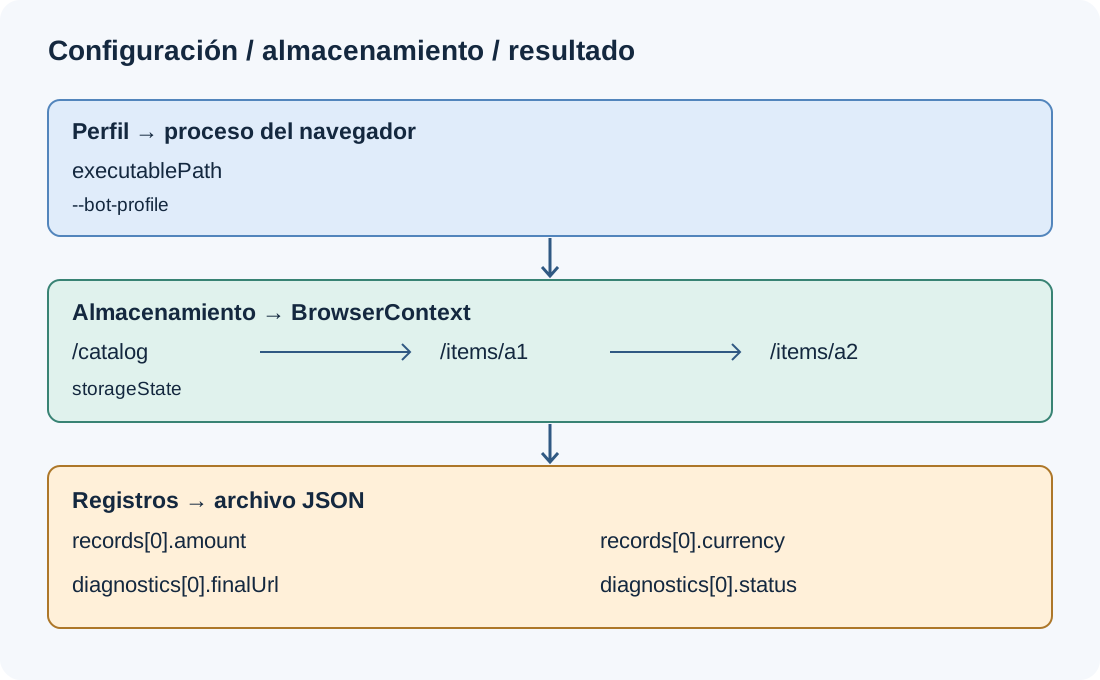
Para una lista y sus detalles, reutiliza contexto y página: las cookies del contexto sobreviven a las navegaciones y el alcance resulta fácil de revisar. Crear un contexto por detalle puede perder una sesión legítima iniciada desde la lista. Compartir contexto entre cuentas autorizadas distintas puede mezclar estados. Define la frontera de cuenta y sesión antes de decidir cuántas páginas abrir.
Entre ejecuciones, un contexto no persistente ofrece almacenamiento limpio; cerrarlo descarta sus datos. Playwright permite guardar y cargar storageState para retomar un acceso autorizado. Su documentación de autenticación advierte que puede contener credenciales utilizables para suplantar la cuenta. Excluye esos archivos del control de versiones y de exportaciones ordinarias; restringe acceso, retención y asociación a la cuenta.
No todo el almacenamiento se incluye automáticamente. La documentación actual permite capturar IndexedDB con indexedDB: true; comprueba que la versión fijada lo admita. El almacenamiento de sesión requiere tratamiento específico de la aplicación. Una cookie restaurada puede estar caducada o invalidada por el servidor: cargar un archivo demuestra que se pudo interpretar, no que la sesión siga siendo válida.
Un contexto persistente sirve cuando el directorio completo forma parte deliberada del trabajo. launchPersistentContext() devuelve un contexto y usa userDataDir, distinto del archivo .enc de --bot-profile. No apuntes varios navegadores a un mismo directorio escribible. Asigna uno por propietario en ejecución y respeta los bloqueos normales; un error de bloqueo no justifica forzar otro proceso a usarlo.
Separar datos y fallos en el resultado
El programa escribe el resultado solo cuando todos los detalles seleccionados pasan la validación. Un fallo tras el primero no se presenta como una extracción completa de dos elementos. flag: 'wx' impide sobrescribir un archivo existente. En un planificador real, utiliza directorios e identificadores únicos y distingue éxitos, resultados parciales e intentos fallidos en el manifiesto.
La fecha registrada es la recogida, no la última modificación del producto. browserVersion devuelve la versión del navegador conectado, no autentica la identidad del archivo ejecutable. El JavaScript de la página puede mostrar valores administrados por el perfil; navigator.userAgent no prueba qué binario inició el host. Conserva ruta resuelta, revisión del lockfile y digest del perfil en metadatos restringidos, separados del catálogo público.
Registra URL solicitada y final: una redirección explica a veces el fallo del esquema. Un enlace de producto puede terminar en consentimiento, login o producto retirado con HTTP 200. Por eso selectores y registros son condiciones de aceptación, no solo precauciones. El éxito HTTP y el dato comercial válido necesitan estados separados para decidir reintentos.
La capa de navegador para web scraping describe el entorno observable, que no determina si un selector sigue identificando un precio. Un rediseño, falta de autorización y error de arranque pueden dejar datos vacíos; cambiar perfiles no arregla los dos primeros. Separa el error de extracción de las evidencias de entorno.
No incluyas por defecto cabeceras completas, cookies ni URLs autenticadas sin redactar en material compartido. El programa rechaza credenciales en el origen y elimina cadenas de consulta y fragmentos de las URL guardadas. Las rutas también pueden contener secretos: usa el entorno de ejemplo solo con rutas públicas del catálogo y revisa campos antes de compartir. Redacta la copia compartida conservando evidencia restringida aprobada suficiente para identificar el trabajo autorizado.
Diagnosticar la capa que falló
| Observación | Primera comprobación | Respuesta adecuada |
|---|---|---|
| No arranca el navegador | Ruta absoluta, permisos, dependencias | Reparar instalación o montaje |
| Falla la creación del contexto | Compatibilidad entre versiones fijadas | Reproducir con combinación documentada |
| HTTP 401 o 403 | Autorización y respuesta del servidor | Parar y resolver acceso con el propietario |
| HTTP 429 | Límites y Retry-After, si existe | Pausar según la política del servicio |
| HTTP 200 sin elementos | URL final, login, finalización del entorno de ejemplo | Clasificar la página antes de tocar selectores |
| Precio inválido | Esquema y formato regional | Rechazar sin adivinar conversiones |
| Siguiente ejecución sin sesión | Política de contextos y caducidad | Restaurar estado aprobado o autenticar normalmente |
La tabla solo ayuda si se conserva la observación que distingue causas. Para navegación, guarda categoría de URL, estado disponible y tipo de excepción. Para selectores, registra el campo inválido y si se alcanzó la ruta esperada. Un catch que escribe un array vacío hace indistinguibles una petición rechazada y un catálogo realmente vacío.
No reintentes ciegamente todo el programa. Superar el tiempo de espera puede indicar lentitud, pero una denegación necesita otra decisión. Un importe decimal mal formado no se corrige con diez navegaciones idénticas. Separa fallos de transporte reintentables, decisiones de acceso y errores deterministas del esquema; respeta límites publicados y el acuerdo de recogida. BotBrowser no decide si corresponde reintentar.
El ejemplo no incluye rotación de proxy, rastreo paralelo ni gestión de desafíos. Cambiarían los contratos de sesión y tráfico y no hacen falta para comprobar la extracción del catálogo propio. Antes de ampliar, define propiedad de cuentas, volumen permitido, integridad y recuperación. Dos registros correctos verifican el esquema, no prueban seguridad o fiabilidad a gran escala.
Preguntas frecuentes
¿Basta instalar playwright-core para seleccionar BotBrowser?
Solo si el arranque indica el executablePath previsto. El paquete aporta la API, pero no descubre BotBrowser ni selecciona el archivo .enc. Pasar ese argumento a otro navegador tampoco lo convierte en BotBrowser. Rechaza rutas ausentes y conserva la versión del paquete para investigar compatibilidad.
¿Un contexto nuevo hace que dos ejecuciones no estén relacionadas?
No. Separa almacenamiento; el servidor sigue observando endpoint, cuenta, patrón de solicitudes y propiedades del navegador. Es aislamiento de aplicación, no anonimato. Úsalo para evitar mezclas de estado, no como permiso para superar límites del sitio.
¿Conviene esperar networkidle en vez de un selector?
La ausencia de tráfico no es la condición comercial. Una página puede tener los datos mientras sigue enviando analítica o puede quedar quieta mostrando un error. Usa la señal de finalización de la aplicación y valida campos. Este entorno de ejemplo exige enlaces adjuntos y elementos de detalle visibles y únicos; otra aplicación necesita su propio contrato.
Fuentes
- Playwright: BrowserType
- Playwright: contextos
- Playwright: locators
- Playwright: autenticación y estado
- BotBrowser: integración con Playwright
- BotBrowser: configuración de perfiles
Conclusión práctica
Para scraping con Playwright, elige ejecutable y perfil compatible y conserva la sesión autorizada en un contexto entre lista y detalles. Acepta resultados solo después de comprobar navegación, origen y esquema. Cookies, perfil y registros exportados son decisiones distintas de seguridad y retención.
Empieza por un catálogo propio con dos enlaces de detalle y el esquema documentado. Adapta selectores antes de aumentar tráfico y conserva fallos explícitos en lugar de devolver un conjunto vacío aparentemente correcto.
Este artículo forma parte de la guía: Primeros pasos con automatización de navegador: mapa inicial
Artículos Relacionados
Scraping con Puppeteer: opciones y valores observables
Primeros pasosPuppeteer + BotBrowser: errores de lanzamiento y de perfil
Primeros pasosScraping con Selenium: capacidades y registros
DesplieguePlaywright MCP con un build propio de Chromium
Primeros pasosCiclo de vida y almacenamiento de BrowserContext en Playwright
Primeros pasosPlaywright con perfiles de identidad coherentes
Ejecuta la misma comprobación en BotBrowser
Carga un perfil, mantén dentro del navegador las señales que acabas de leer y confirma el resultado en tu propia máquina antes del despliegue.