Huella del navegador en Scrapy: qué no puede configurar
Distingue las huellas de petición de Scrapy de las señales del navegador, las respuestas HTTP de las páginas ejecutadas y las descargas de las integraciones con navegador.
BotBrowser Team
Quieres la documentación estructurada de Primeros pasos?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
El descargador HTTP predeterminado de Scrapy no tiene un entorno de ejecución de JavaScript para páginas. Su huella de petición, utilizada para filtrar duplicados y almacenar respuestas en caché, es distinta de una huella del navegador formada a partir de observaciones del navegador. BotBrowser documenta el control de superficies del motor del navegador mediante perfiles, pero no puede añadir un renderizador al descargador HTTP predeterminado, modificar la identidad que utiliza el planificador de Scrapy, configurar motores remotos arbitrarios ni garantizar el acceso. Para resolver una pregunta sobre «Scrapy browser fingerprint», primero hay que identificar si el problema corresponde a la identidad local de las peticiones, la entrega por red, el análisis de respuestas o un entorno de ejecución de navegador seleccionado explícitamente.
Resumen
- Una huella de petición es un identificador local. Sus entradas predeterminadas corresponden al método, la URL y el cuerpo de la petición, con un tratamiento de los metadatos adicionales que depende de la versión.
- Las cabeceras se omiten de la identidad de petición predeterminada. Incluir determinadas cabeceras cambia la comparación local, no el comportamiento de las API del navegador.
- El HTML descargado y el DOM de un navegador después de la ejecución pueden contener datos distintos. Analizar datos JavaScript incrustados no ejecuta la página.
- Un gestor de descargas basado en un navegador cambia la ruta de ejecución. El trabajo directo con un navegador dentro de una función de retorno puede dejar fuera componentes de Scrapy.
- Diagnostica un entorno de prueba autorizado en el límite de responsabilidad correspondiente antes de cambiar otro componente. Ni un hash ni una cabecera demuestran que se haya ejecutado un navegador.
Contenido
- Las huellas de petición definen la equivalencia local
- El descargador forma parte de un flujo de trabajo más amplio
- Las cabeceras HTTP no crean instancias de las API del navegador
- El código de la respuesta y el DOM ejecutado son artefactos distintos
- La integración con un navegador cambia la responsabilidad de ejecución
- Clasifica cuatro fallos del entorno de prueba según sus evidencias
- Conclusión práctica
Las huellas de petición definen la equivalencia local
La documentación sobre huellas de petición de Scrapy presenta este identificador para el filtrado de duplicados y el almacenamiento de respuestas en caché. Los componentes necesitan una forma compacta de comparar peticiones según las reglas de equivalencia previstas por el proyecto. Se trata de una decisión de gestión interna. La huella no es automáticamente una cabecera, un identificador generado por el navegador ni una observación comunicada por el servidor. Que dos peticiones reciban el mismo identificador local no demuestra que sus intercambios de red o los documentos devueltos sean idénticos.
La implementación del proyecto original revisada tiene en cuenta el método de la petición, una URL canonicalizada y el cuerpo de la petición. La canonicalización puede hacer que las URL con parámetros de consulta ordenados de forma distinta sean equivalentes para este fin. Las cabeceras de petición se ignoran de forma predeterminada y los fragmentos de URL suelen omitirse. El argumento include_headers permite incluir determinadas cabeceras en el cálculo; keep_fragments cambia el tratamiento de los fragmentos. Ninguna de estas opciones crea un renderizador. Incluir un fragmento en una clave local no ejecuta el código de la aplicación que interpreta ese fragmento.
La entrada correspondiente al cuerpo es el cuerpo sin procesar de la petición, representado como bytes hexadecimales en los datos de la huella de la implementación. No se analiza ni se normaliza como JSON. Por tanto, dos documentos JSON que describen el mismo objeto pero difieren en los espacios en blanco o en el orden de las propiedades pueden producir huellas de petición distintas. A la inversa, la canonicalización de URL puede unificar diferencias que el responsable de la aplicación considera significativas. La identidad de petición debe ajustarse a los requisitos de la carga de trabajo, en lugar de asumir que todas las representaciones de datos de negocio equivalentes reciben un único identificador.
La revisión proporcionada utiliza la instantánea del proyecto original e63a574c767d7a9438c21db158f605f1c44c6e6a, no una versión instalada ni probada en ejecución. En esa implementación, verbatim_url conserva la URL de la petición en vez de canonicalizarla, por lo que keep_fragments deja de ser relevante. Un valor de download_handler distinto del esquema de la URL también forma parte de la identidad; si coincide con el esquema, se omite. El código señala la participación del gestor como un cambio de 2.20.0. Estos detalles dependen de la versión y de la configuración; no afirman que todas las instalaciones de Scrapy desplegadas se comporten así.
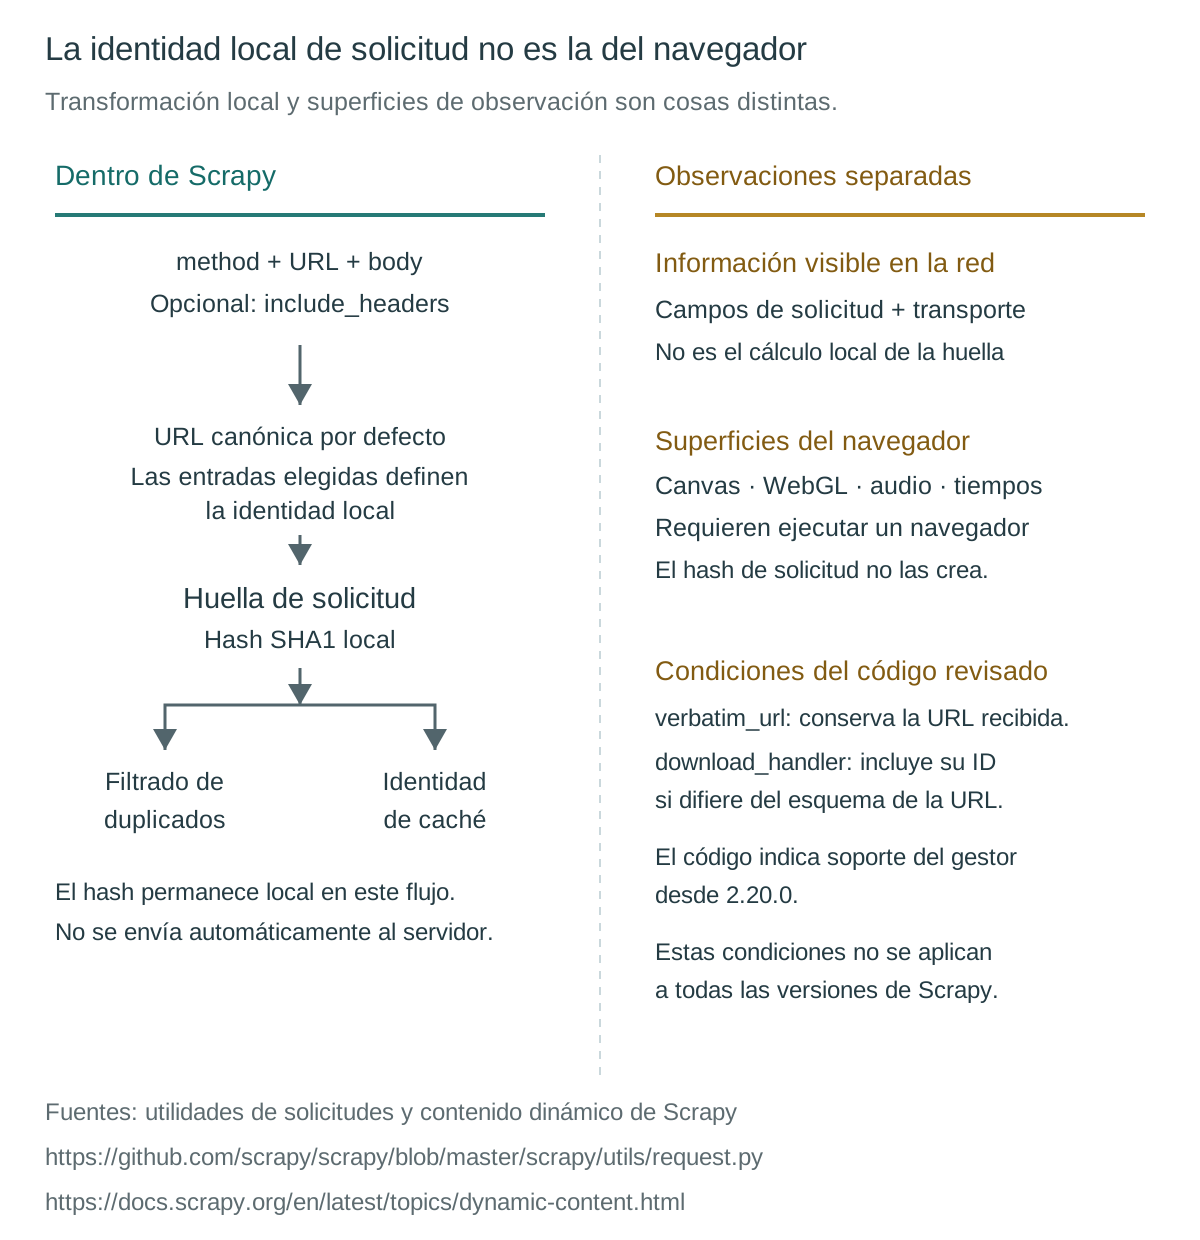
La igualdad tampoco garantiza la identidad semántica de las respuestas. Un catálogo propio puede variar su respuesta según el idioma o el estado autorizado de la aplicación, aunque coincidan el método, la URL y el cuerpo. Ignorar las cabeceras puede ser adecuado para un rastreo e incorrecto para otro. Scrapy ofrece REQUEST_FINGERPRINTER_CLASS porque no existe una regla de comparación universal. La decisión consiste en determinar qué peticiones pretende distinguir el proyecto, no qué hash se parece más al de un navegador. Las respuestas cuyo contenido depende de la autenticación también requieren una política de caché adecuada a su ámbito; una clave de petición compartida no basta para establecer que su reutilización sea segura.
El descargador forma parte de un flujo de trabajo más amplio
La descripción de la arquitectura de Scrapy asigna responsabilidades distintas al planificador, al descargador, al rastreador y a la cadena de procesamiento de elementos. El motor obtiene peticiones del rastreador y las pasa por la planificación. El descargador obtiene respuestas, con la participación del software intermedio de descarga alrededor de ese límite. Las funciones de retorno del rastreador procesan las respuestas y devuelven elementos o nuevas peticiones. Después, las cadenas de procesamiento de elementos se encargan de tareas como la limpieza, la validación y la persistencia. Una salida vacía puede tener su origen en varias etapas anteriores o posteriores a una petición de red.
Este orden explica por qué cambiar una cabecera de petición puede no afectar a una decisión del filtro de duplicados. Una petición excluida durante la planificación quizá nunca llegue al descargador cuyos campos de salida pretendía ajustar el desarrollador. Del mismo modo, una respuesta descargada puede llegar correctamente a una función de retorno, pero producir un elemento que la validación rechaza. «No se guardó nada» no identifica ni un fallo de descarga ni un problema del navegador. La evidencia útil señala la última etapa completada y la entrada que esperaba la siguiente.
La ruta HTTP predeterminada recupera el contenido de la respuesta sin ejecutar los scripts de la página. La guía de contenido dinámico de Scrapy distingue expresamente entre inspeccionar el código descargado y acceder al DOM activo de un navegador. Ese límite no impide la ejecución de un navegador mediante otro gestor o integración. Scrapy es un entorno de trabajo con componentes configurables; «el descargador predeterminado no tiene renderizador» es más preciso que «Scrapy nunca puede ejecutar JavaScript». La ruta de ejecución seleccionada determina qué proceso puede producir un documento renderizado.
La atribución del transporte también exige conocer la configuración efectiva. La documentación de arquitectura describe las comunicaciones de red de Scrapy basadas en eventos y su relación con Twisted, pero los gestores personalizados y los cambios de versión importan. No es seguro atribuir todas las posibles peticiones realizadas desde un proyecto Scrapy a una única implementación de transporte. Registra la versión instalada y el gestor seleccionado antes de analizar el comportamiento de la conexión. El comportamiento de TLS corresponde a la implementación de red y a la configuración de ese gestor, no a un nombre de navegador escrito en una cabecera HTTP.
El límite de la cadena de procesamiento sigue siendo útil aunque un navegador proporcione la respuesta. La ejecución del navegador puede hacer que un campo esté disponible, pero no demuestra que la función de retorno haya seleccionado el registro correcto ni que la cadena lo haya aceptado. Especifica el artefacto esperado en cada transición: petición planificada, respuesta recibida, elemento analizado y salida persistida. Esto permite localizar un fallo sobre el que actuar sin recopilar todos los documentos ni confundir el inicio correcto del navegador con la validación correcta de los datos.
Las cabeceras HTTP no crean instancias de las API del navegador
El ajuste DEFAULT_REQUEST_HEADERS de Scrapy proporciona campos HTTP mediante DefaultHeadersMiddleware. Esos campos describen una petición saliente. Un valor de Accept-Language puede influir en la respuesta de un servidor propio y un campo de agente de usuario puede contener una cadena seleccionada, pero ninguno crea window.navigator. La referencia de Navigator de MDN describe un objeto expuesto por un entorno de navegador, que incluye userAgent y hardwareConcurrency. Su existencia y sus valores corresponden a ese entorno de ejecución, no a un diccionario de petición de Python.
El mismo límite se aplica a los gráficos. MDN describe HTMLCanvasElement.toDataURL() como un método que devuelve una representación codificada de una imagen de lienzo. No es un hash integrado de identidad del dispositivo. Quien llama al método puede procesar después esa salida, pero esa es otra operación. El resultado depende del mapa de bits y de la codificación solicitada, y una imagen cuyo mapa de bits no cumpla la condición de origen limpio puede provocar SecurityError. Una cabecera no dibuja ese mapa de bits ni proporciona las condiciones de seguridad del navegador necesarias para leerlo.
WebGLRenderingContext.getParameter() devuelve el valor asociado al nombre de parámetro solicitado. El tipo y el significado de lo que devuelve dependen de ese parámetro. Llamarlo «la huella WebGL» oculta qué observación se solicitó realmente y si existía el contexto pertinente. Un entorno de prueba de navegador útil identifica la API y el parámetro revisados. No supone que todos los entornos de ejecución expongan las mismas capacidades ni que un único valor devuelto identifique de forma unívoca un dispositivo físico.
El audio necesita una descripción igual de precisa. El OfflineAudioContext de MDN representa un grafo de procesamiento de audio que genera el resultado en un AudioBuffer, en lugar de enviarlo directamente al hardware de audio del dispositivo. Por tanto, el procesamiento sin conexión no requiere afirmar que un altavoz haya emitido sonido. El grafo, los cambios programados y el entorno de ejecución producen la salida. Ningún campo HTTP sustituye ese cálculo y la ausencia de un entorno de ejecución de página significa que el descargador predeterminado no tiene una observación de ese tipo, generada por la página, que devolver.
La temporización es otra superficie independiente. performance.now() informa de los milisegundos transcurridos respecto a performance.timeOrigin mediante un reloj monótono. MDN también documenta la reducción de precisión, incluidas distintas condiciones de resolución para los contextos con aislamiento entre orígenes. La duración de una petición medida por el descargador corresponde a un intervalo diferente, con otro reloj y otro ámbito. Hacer coincidir una duración de descarga con una marca de tiempo de la página no demuestra un comportamiento temporal equivalente del navegador, y una respuesta lenta no demuestra por sí sola un problema del temporizador de JavaScript.
Estas API son ejemplos de observaciones del navegador, no una promesa de disponibilidad universal ni de identificación unívoca. La compatibilidad del navegador, las condiciones del documento y la política del entorno de ejecución pueden limitarlas. Mientras tanto, un servidor puede seguir observando la actividad HTTP y de conexión sin ejecutar el JavaScript de la página. El análisis de la protección de la huella del navegador explica las superficies de privacidad del navegador; su ámbito no convierte la clave local de petición de Scrapy en esas superficies. Ni la ausencia de ejecución de JavaScript ni el cambio de un campo de petición establecen anonimato o permiso para recopilar datos.
El código de la respuesta y el DOM ejecutado son artefactos distintos
La documentación de contenido dinámico de Scrapy describe un desajuste habitual: los datos aparecen en un navegador, pero no están presentes para los selectores que operan sobre la respuesta descargada. El navegador puede haber ejecutado scripts, realizado peticiones adicionales y actualizado su documento. Los selectores de respuesta de Scrapy operan sobre el contenido que reciben. Antes de cambiar los selectores, comprueba si el campo necesario existe en esa entrada. Un selector no puede recuperar un nodo que la respuesta seleccionada nunca contuvo.
Una página propia también puede incluir los datos deseados dentro de un elemento de script sin colocarlos en el HTML visible. Extraer un objeto serializado o analizar el código JavaScript como datos no es lo mismo que ejecutar la página. Scrapy documenta el análisis de valores incrustados por separado de la navegación sin interfaz gráfica. Esta distinción importa para la procedencia: un valor obtenido del texto del código no demuestra que se hayan producido la inicialización del navegador, el procesamiento de eventos o el renderizado. Solo establece que el texto seleccionado contenía un valor que el analizador comprendió.
Una respuesta JSON externa es otro artefacto posible. Si una aplicación propia expone el registro necesario mediante un punto de acceso autorizado, esa representación puede satisfacer la tarea sin ejecutar un navegador. También puede omitir un estado de presentación que la tarea realmente necesita. La comparación entre página renderizada y punto de acceso JSON explica esa elección en función de la salida requerida. Un punto de acceso de registros y una captura de pantalla responden a preguntas distintas, aunque ambos procedan de la misma aplicación.
A la inversa, una API HTTP puede devolver un documento renderizado por un navegador en otro lugar. Recibir HTML mediante HTTP no demuestra que el productor haya evitado ejecutar JavaScript. El consumidor debe distinguir el transporte de la producción: ¿qué atravesó la conexión y qué sistema lo generó? El contrato de respuesta de un servicio de renderizado puede proporcionar un artefacto resultante de la ejecución, mientras que una respuesta ordinaria del servidor de origen puede proporcionar código HTML. Ni el tipo de medio ni el uso de un cliente HTTP resuelven por sí solos esa distinción.
Para la aceptación, identifica la representación necesaria antes de seleccionar una ruta de ejecución. «Contiene el identificador del elemento del entorno de prueba en el código devuelto», «contiene un nodo de elemento después de ejecutar la página» y «devuelve un registro JSON válido» son condiciones distintas. Cada una necesita su propio productor y punto de validación. Sustituir una por otra puede cambiar la tarea sin advertirlo, especialmente cuando la presentación depende de la interacción o del estado de la aplicación. Una descarga correcta establece la entrega de un artefacto, no el cumplimiento de todos los posibles requisitos de renderizado.
La integración con un navegador cambia la responsabilidad de ejecución
El README de scrapy-playwright describe un gestor de descargas de Scrapy que realiza peticiones mediante Playwright para Python y conserva el flujo de trabajo habitual de Scrapy, incluidas la planificación de peticiones y el procesamiento de elementos. Se trata de una integración explícita basada en un navegador. Difiere de añadir cabeceras con aspecto de navegador al descargador HTTP predeterminado porque ahora otro entorno de ejecución realiza el trabajo del navegador. El entorno de trabajo sigue teniendo responsabilidades de planificación y salida; la integración cambia quién produce la respuesta en lugar de sustituir todos los componentes.
La guía sobre navegación sin interfaz gráfica de Scrapy también distingue la integración del uso directo de Playwright dentro de una función de retorno. Advierte que ese uso directo deja fuera la mayoría de los componentes de Scrapy, incluidos el software intermedio y el filtrado de duplicados, y recomienda scrapy-playwright para mejorar la integración. Es una distinción del flujo de control. No debe suponerse que una acción de red iniciada directamente por código del navegador herede las decisiones del planificador o el comportamiento del software intermedio de una petición entregada a Scrapy.
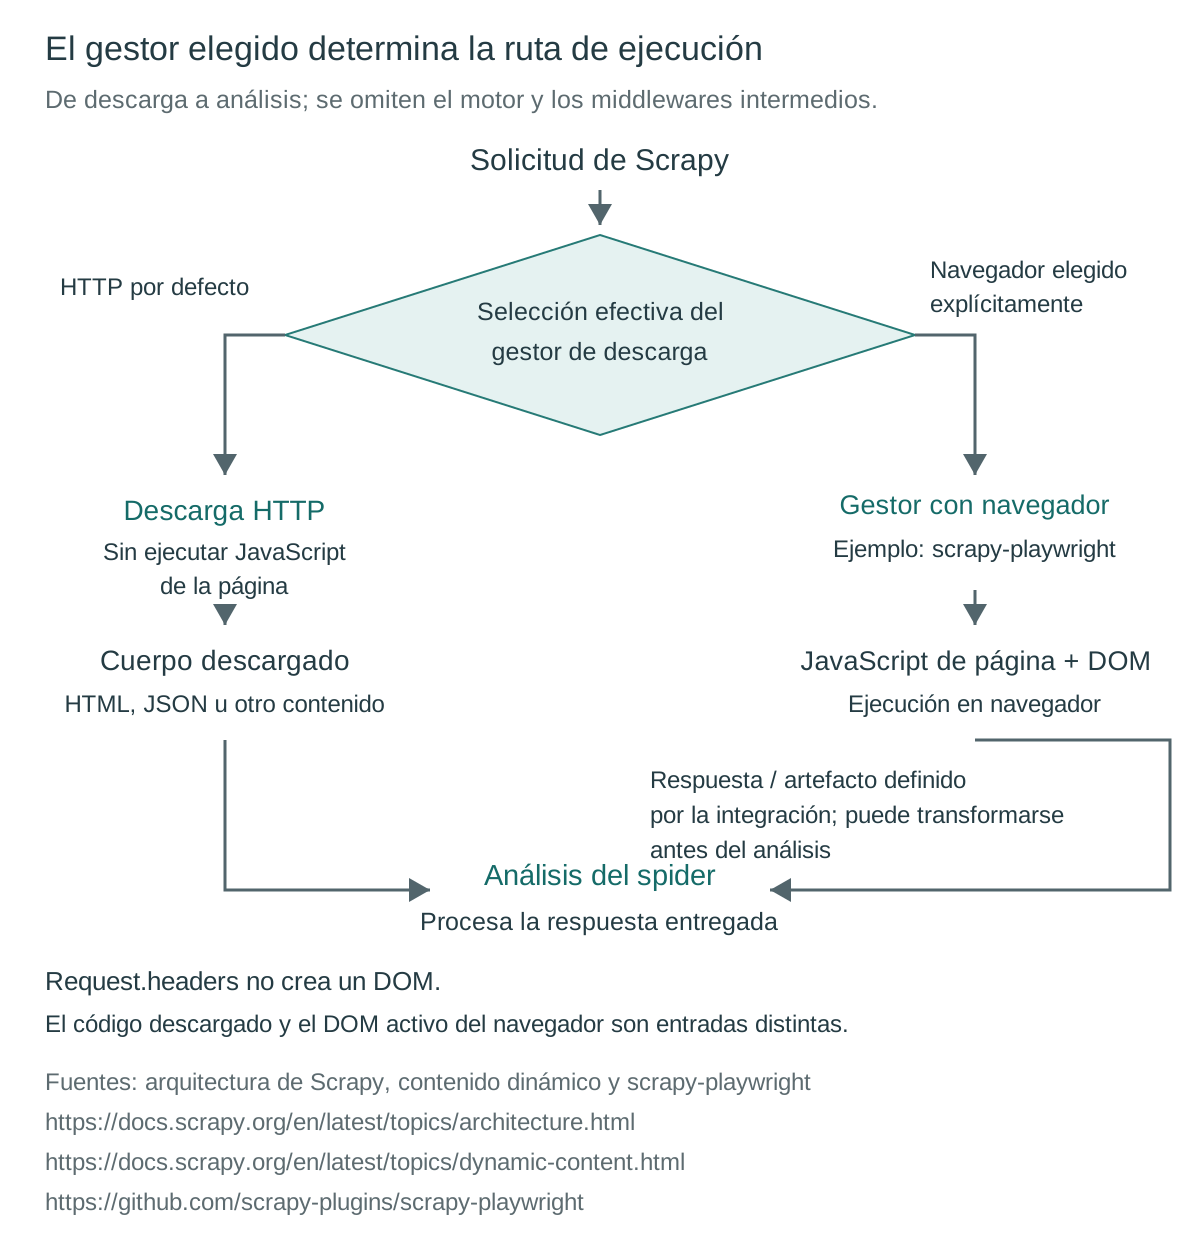
Esa procedencia afecta a lo que los ajustes pueden controlar razonablemente. Un ajuste de petición de Scrapy, una opción del gestor y un ajuste del motor del navegador tienen consumidores distintos. Algunas acciones del navegador pueden originarse dentro de la página o mediante automatización directa, en vez de como peticiones de Scrapy planificadas de forma independiente. Identifica al responsable de la acción antes de esperar que un punto de intervención del entorno de trabajo la observe o modifique. La misma cautela se aplica a un navegador remoto: su ejecutable y la política del proveedor siguen sujetos al contrato real de configuración de su entorno de ejecución.
La descripción del navegador de BotBrowser documenta el control mediante perfiles de las superficies del motor del navegador, incluidas Navigator, los gráficos, el audio y la temporización. Esa capacidad corresponde a un entorno de ejecución de BotBrowser seleccionado de forma compatible; no puede configurar automáticamente todas las integraciones, sustituir un motor remoto arbitrario ni cambiar la política de huellas de petición de Scrapy. No se informa aquí de ninguna prueba de compatibilidad del complemento. La selección del entorno de ejecución requiere el ejecutable o el mecanismo de conexión admitidos por la integración, en lugar de deducir que todas las herramientas de automatización de navegadores aceptan motores intercambiables.
La comparación del modo sin interfaz gráfica trata los modos de ejecución una vez que existe una ruta de navegador. No demuestra que un descargador HTTP haya adquirido un navegador simplemente porque no haya ninguna ventana visible. Determina primero quién controla el navegador y cuál es el artefacto necesario; después considera el modo y la configuración documentados del entorno de ejecución seleccionado. La autorización de la aplicación y la validación de la salida siguen siendo requisitos independientes durante toda esa elección.
Clasifica cuatro fallos del entorno de prueba según sus evidencias
Considera un entorno hipotético de prueba de un catálogo propio con dos variantes de idioma, un documento de origen y una página que añade un campo de visualización inocuo después de la ejecución. La siguiente matriz describe clasificaciones esperadas, no resultados observados durante la ejecución. Su propósito es asignar cada pregunta a un componente capaz de responderla. Las referencias de Scrapy sobre identidad de petición, arquitectura y contenido dinámico establecen esos límites.
| Caso hipotético | Clasificación esperada | Componente responsable | Evidencia mínima útil |
|---|---|---|---|
| Las URL de consulta equivalentes producen una sola descarga planificada | Equivalencia local de peticiones y filtrado de duplicados | Generador de huellas efectivo y filtro de duplicados del planificador | Método, comparación de URL sin datos sensibles, política de huellas y resultado de planificación |
| Dos peticiones solo difieren en una cabecera de configuración regional, pero necesitan registros separados | Identidad de petición sensible a cabeceras frente a variación de la respuesta del servidor | Política de huellas, cabeceras del descargador y validación de registros | Nombre de la cabecera seleccionada, valor inocuo de configuración regional e idioma esperado |
| La respuesta sin procesar carece de un nodo presente después de la ejecución del navegador | Procedencia del artefacto y requisito de renderizado | Analizador de respuestas o gestor de navegador seleccionado explícitamente | Si el campo existe en el código de origen, en el DOM ejecutado o en una respuesta de datos autorizada |
| La latencia de petición se confunde con una medición del temporizador del navegador | Desajuste del ámbito de medición | Instrumentación del descargador frente a la API Performance del navegador | Fuente del reloj, intervalo medido y ruta de ejecución |
En el caso de las URL duplicadas, la pregunta de aceptación es si el proyecto trata intencionadamente las dos peticiones como una sola unidad. En el caso de la configuración regional, es si ambos registros de idioma siguen siendo distinguibles según la política efectiva de identidad y validación. Son preguntas distintas, aunque ambas se manifiesten como un elemento ausente. El mero hecho de ver dos objetos de petición en el código de la aplicación no demuestra que ambos superaran la planificación ni que el servidor recibiera dos peticiones distintas.
En el caso del nodo ausente, la aceptación exige que el campo esté en el artefacto declarado. Una tarea limitada al código de origen no debe convertirse silenciosamente en una tarea de navegador interactivo, y una tarea que requiere estado ejecutado no debe evaluarse solo por el código de origen. Para la latencia, la aceptación exige un intervalo correctamente identificado. Una medición del descargador puede ser útil sin representar la precisión de performance.now(), el tiempo de ejecución de la página ni ningún resultado de una API del navegador. Una clasificación correcta evita introducir un entorno de ejecución que no pueda responder a la pregunta original.
Conserva únicamente las evidencias necesarias para la decisión: versión efectiva de Scrapy, identidad del gestor, opciones de huella pertinentes, características de petición sin datos sensibles, tipo de artefacto y resultado de validación. No recopiles secretos, cookies sin procesar ni contenidos de página ajenos para demostrar estos límites. Una futura prueba satisfactoria establecería el comportamiento de esa configuración y esa aplicación propia. No establecería una huella de negociación de conexión, la compatibilidad con todas las integraciones de navegador ni la autorización para repetir el trabajo en sitios no relacionados.
Preguntas frecuentes
¿Se envía la huella de petición de Scrapy como identidad del navegador?
No mediante el cálculo de huella predeterminado. Proporciona identidad local de petición para componentes como el filtrado de duplicados y la caché. Las observaciones de red y del navegador tienen productores distintos.
¿Configurar una cabecera de agente de usuario crea propiedades de Navigator?
No. Un campo de petición no crea instancias de window.navigator, Canvas, WebGL ni un grafo de audio. Eso requiere un entorno de ejecución real compatible y las condiciones de documento correspondientes.
¿Analizar datos dentro de un elemento de script ejecuta JavaScript?
No. Leer el texto del código y extraer valores incrustados es análisis de datos. La ejecución del navegador puede realizar cálculos adicionales y actualizaciones del documento que el análisis del código no realiza.
¿Puede Scrapy utilizar un navegador y conservar su flujo de trabajo normal?
El README de scrapy-playwright describe esa integración mediante un gestor de descargas. El trabajo directo con Playwright dentro de una función de retorno tiene otros límites de integración, por lo que debe establecerse la participación de los componentes para la ruta seleccionada.
Fuentes
- Scrapy: Descripción de la arquitectura
- Scrapy: Huellas de petición
- Scrapy: Selección de contenido cargado dinámicamente
- Scrapy: Ajustes
- Scrapy: Utilidades de petición en la instantánea revisada del proyecto original
- scrapy-playwright: README del proyecto
- MDN: Navigator
- MDN: HTMLCanvasElement.toDataURL()
- MDN: WebGLRenderingContext.getParameter()
- MDN: OfflineAudioContext
- MDN: Performance.now()
- BotBrowser: Descripción de las huellas del navegador
Conclusión práctica
Clasifica un fallo de un entorno de prueba autorizado según corresponda a la identidad local de petición, la entrega de la descarga, el análisis de respuestas o la ejecución del navegador. Después elige el componente que produce la evidencia ausente. Verifica su versión y configuración efectivas antes de cambiar otra capa: un hash de petición, una cabecera HTTP y un entorno de ejecución de navegador controlan partes distintas del trabajo.
Este artículo forma parte de la guía: Primeros pasos con automatización de navegador: mapa inicial
Artículos Relacionados
Navegador para web scraping: ¿qué tipo necesitas?
Primeros pasosWeb scraping con Browserbase: ¿quién controla qué?
Primeros pasosScraping con navegador headless: qué cambia
Huella digitalAPI de scraping web: lo que oculta la respuesta
Primeros pasosQué es un rastreador web: cinco etapas del rastreo
Huella digitalClient Hints Fingerprinting: encabezados HTTP e identidad
Ejecuta la misma comprobación en BotBrowser
Carga un perfil, mantén dentro del navegador las señales que acabas de leer y confirma el resultado en tu propia máquina antes del despliegue.