Web crawler vs web scraper: resultados y fallos
Distingue el descubrimiento de URL de la extracción de campos y separa las páginas ausentes de los registros incompletos antes de elegir un navegador.
BotBrowser Team
Quieres la documentación estructurada de Primeros pasos?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
Web crawler vs web scraper distingue dos resultados: un conjunto delimitado de recuperaciones y los registros extraídos del contenido recuperado. Una página puede descargarse correctamente y carecer del campo de precio. BotBrowser proporciona un navegador Chromium para una fase de renderizado autorizada; no decide qué URL descubrir ni qué campos extraer, y no controla directamente la programación de la cola de rastreo.
TL;DR
- El rastreo decide qué URL visitar y gestiona su recuperación; la extracción obtiene información seleccionada del contenido.
- Un mismo programa puede realizar ambas tareas. El nombre del framework no identifica qué resultado falló.
- La frontera de rastreo contiene trabajo pendiente. Que esté vacía no demuestra que se hayan descubierto todas las páginas relevantes.
- El renderizado en un navegador es una decisión independiente; ninguna tarea exige siempre ejecutar JavaScript.
- Relaciona los resultados de recuperación y validación antes de dar por completa una recopilación.
Contenido
- Qué produce cada tarea
- Una canalización puede realizar ambas tareas
- Por qué las solicitudes no describen todo el coste
- Una entrega con dos criterios de aceptación
- Identidad de URL e identidad del registro
- Un registro necesita más que un selector coincidente
- Asigna el fallo antes de sustituir la herramienta
- Define por separado la finalización y el reprocesamiento
- Fija el límite antes de recuperar contenido
- Conclusión práctica
Qué produce cada tarea
Un rastreador selecciona URL, programa solicitudes y registra el resultado de cada recuperación. Las semillas pueden proceder de una lista explícita, un sitemap o enlaces encontrados en páginas recuperadas. Google define un crawler como un programa que descubre y examina sitios automáticamente. Un artefacto útil del rastreo es una tabla con source_url, origen del descubrimiento, estado de recuperación y fecha. Conservar los cuerpos es opcional: una comprobación de disponibilidad puede necesitar solo estados y enlaces. La traza de un rastreador paso a paso sigue una URL inicial por la descarga, el análisis, la resolución de enlaces y la planificación, y muestra por qué un enlace descubierto puede quedar sin descargar.
Un extractor selecciona información de una respuesta o un documento renderizado y la convierte en un registro. Su contrato podría exigir sku, price y currency. La entrada puede ser una página guardada o miles de documentos; seguir enlaces no es necesario para extraer campos. Una respuesta HTTP 200 todavía puede contener un precio vacío, un diseño inesperado o un valor que no supera la validación.
| Decisión | Responsabilidad del rastreo | Responsabilidad de la extracción |
|---|---|---|
| Entrada | Semillas autorizadas y alcance de URL | Contenido recuperado y esquema de campos |
| Estado de trabajo | URL pendientes y resultados de recuperación | Resultados de análisis y registros candidatos |
| Comprobación | Qué se visitó, omitió o quedó sin resolver | Qué campos obligatorios y claves son válidos |
| Defecto habitual | Una página permitida nunca entró en la cola | Una página recuperada no tiene un price válido |
La frontera es la cola de trabajo que queda por considerar, no un inventario completo del sitio. Puede agotarse después de pasar por alto un enlace de paginación. La cobertura necesita un alcance declarado y una regla de finalización independiente, como contrastar con una lista de URL facilitada por el propietario.
Una canalización puede realizar ambas tareas
La arquitectura de Scrapy contradice una separación rígida entre crawler y scraper. Una araña puede devolver elementos extraídos y nuevas solicitudes. El motor envía las solicitudes al planificador y los elementos a las canalizaciones de datos, donde pueden validarse y persistirse. Dos responsabilidades comparten un framework sin convertirse en la misma prueba de aceptación.
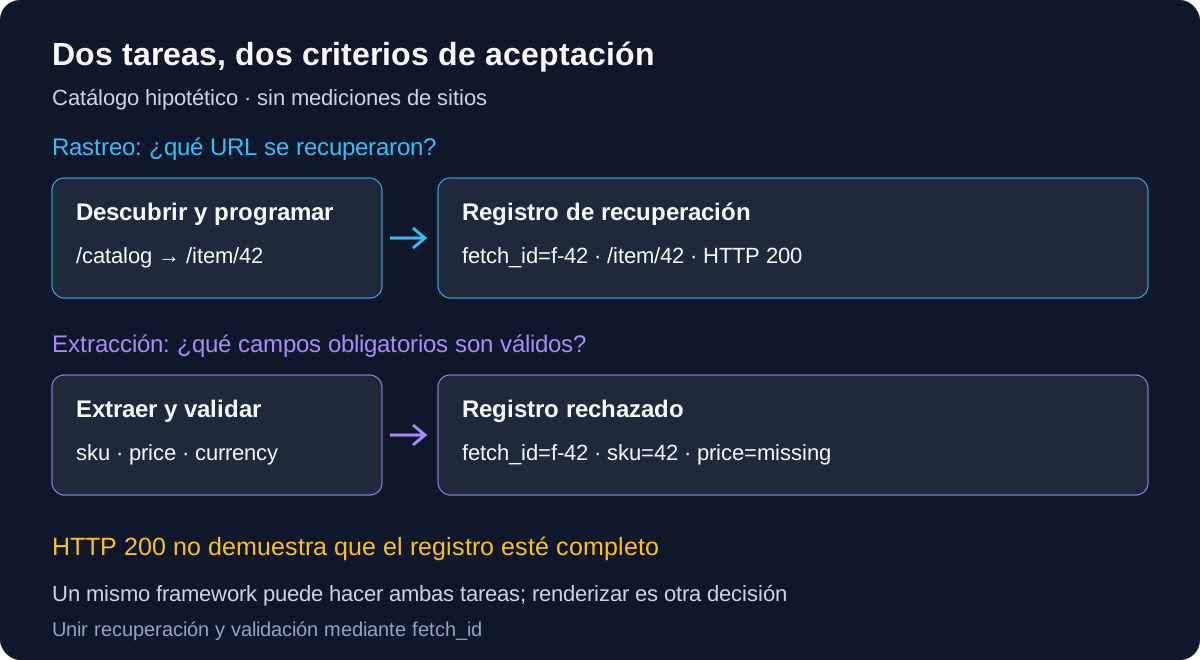
En un catálogo autorizado, un componente puede descubrir /item/42 desde /catalog, recuperar su documento y entregarlo al extractor. Este emite después un registro de precio. Si también emite la siguiente URL del catálogo, participa en el descubrimiento. Lo útil es identificar quién decide sobre las URL y quién decide sobre los campos.
El renderizado se sitúa entre recuperación e interpretación cuando el contenido requerido depende de JavaScript. Un rastreador puede renderizar para encontrar enlaces de navegación; un extractor, para obtener un precio. Ambos pueden trabajar también con HTML entregado por el servidor. BotBrowser puede aportar esa fase del navegador, pero la aplicación sigue siendo responsable de la frontera, las reglas de extracción y los registros almacenados. La configuración del navegador con Playwright explica cómo conectar esa fase cuando la entrada registrada la requiere.
Por qué las solicitudes no describen todo el coste
Un rastreo que explora navegación puede emitir solicitudes sin producir registros de negocio. Un extractor alimentado con documentos guardados puede producir registros sin volver a contactar con el origen. Si ambas fases recuperan /item/42 por separado, el sitio recibe trabajo duplicado aunque el equipo vea una sola fila final.
Cuenta por separado las solicitudes al origen, los intentos de extracción y el trabajo del navegador. Son útiles fetch_attempts, render_attempts, parse_attempts y las claves de registros aceptados. Atribuye cada reintento a la fase que lo realizó: corregir un analizador sobre un cuerpo conservado no debe provocar automáticamente otra solicitud. Conservar cuerpos exige su propia política de almacenamiento y tratamiento de datos; no es un requisito para llamar rastreador a un proceso.
El diagnóstico de tasa y concurrencia separa la frecuencia de solicitudes del trabajo simultáneo. Esa diferencia se mantiene en toda la canalización: dos módulos que contactan con el mismo origen contribuyen a su carga agregada. Un navegador añade renderizado y puede descargar subrecursos, por lo que «una página» no equivale necesariamente a una solicitud HTTP.
Una entrega con dos criterios de aceptación
Usa un identificador estable de recuperación para relacionar el registro de solicitudes y el resultado de extracción. Conserva la URL solicitada junto a la URL final tras las redirecciones; una redirección no debe cambiar silenciosamente lo que el equipo cree haber recopilado. Estas filas de catálogo son ejemplos hipotéticos de un contrato, no resultados de pruebas ni de un sitio real.
fetch_id | source_url | Recuperación | Extracción | Decisión |
|---|---|---|---|---|
f-41 | /item/41 | HTTP 200 | sku=41; price=12.90; currency=USD | Aceptar después de validar el esquema |
f-42 | /item/42 | HTTP 200 | sku=42; price=missing | Rechazar el registro; revisar la extracción |
f-43 | /item/43 | HTTP 503 | No intentada | Mantener la recuperación sin resolver |
Añade fetched_at, URL final, schema_version y estado de análisis a la tabla real. Si conservas cuerpos, un hash o una referencia identifica la entrada exacta que debe reprocesarse. Guarda la clave del registro aparte de la URL: un documento puede contener varios registros y varias URL pueden describir un mismo artículo. Cuenta registros únicos solo después de aplicar la clave y las reglas declaradas.
La primera prueba contrasta el alcance autorizado con entradas visitadas, omitidas deliberadamente y sin resolver. La segunda valida los campos obligatorios de las entradas que deberían producir registros. Recuperar 3 URL y aceptar 1 registro no demuestra ni «un tercio completo» ni «todo completo» sin ambos denominadores. Una página índice puede no producir registros de forma intencionada; una recuperación fallida puede ocultar varios.
Identidad de URL e identidad del registro
La deduplicación del rastreador decide si una recuperación ya está programada o es suficientemente reciente. La del extractor decide si una entidad u observación ya está representada. Las claves no tienen por qué coincidir. /item/41 y /offers/41 pueden describir el mismo artículo, mientras un documento /catalog puede contener varios. Deduplicar registros por URL conservaría duplicados en el primer caso y descartaría filas válidas en el segundo.
Define la identidad de las URL con el propietario, sin eliminar parámetros indiscriminadamente. page puede seleccionar otro segmento del catálogo. Un parámetro de idioma o variante puede cambiar valores necesarios para el consumidor. En cambio, un parámetro de seguimiento aprobado como irrelevante podría omitirse. Son decisiones de cada origen; ordenar toda consulta o eliminar todos sus parámetros no es una regla universal de equivalencia.
| Decisión de identidad | Consecuencia para recuperar | Consecuencia para los datos |
|---|---|---|
Conservar un page significativo | Siguen accesibles segmentos distintos | Puede haber solapamiento y hacen falta claves propias |
| Seguir una redirección autorizada | Conservar URL solicitada y final | Asociar los valores al documento real |
| Conservar momentos de observación distintos | La recuperación posterior es otra observación | Un histórico puede necesitar sku y fecha |
| Reprocesar un documento guardado | No requiere otra solicitud al origen | Otra schema_version puede cambiar la validación |
En una tabla de precios actuales, sku podría servir como clave dentro de un origen y variante declarados. En un histórico, sobrescribir cada fila con igual sku borraría observaciones. Incluye la clave del consumidor en el contrato y conserva fetch_id como procedencia, no como identificador de entidad. Así se distingue un duplicado accidental de una variante o una observación posterior deliberada.
Un registro necesita más que un selector coincidente
Encontrar .price solo demuestra que el selector coincidió con algún elemento de ese documento. El contrato necesita además una interpretación numérica, una unidad o moneda y una regla para valores ausentes. 0.00 y una cadena vacía no pueden reducirse al mismo falso genérico: cero puede ser un importe legítimo, mientras la ausencia puede indicar que falta un campo obligatorio.
Define casos de validación para el formato real del origen. El consumidor del catálogo hipotético podría exigir sku no vacío, price decimal y currency reconocida. Un mensaje promocional, un intervalo o un precio para socios no debe convertirse silenciosamente en el precio estándar por ocupar la misma caja visual. Decide qué admite el esquema y rechaza formas no admitidas con un estado de análisis inspeccionable.
| Valor candidato | Pregunta del extractor | Resultado que conservar |
|---|---|---|
price=0.00 | ¿Se permite cero? | Cero válido o fallo identificado |
price=missing | ¿Es obligatorio para este tipo de registro? | Ausencia, nunca un cero inventado |
price=12.90; currency=USD | ¿El formato admite esa interpretación? | Importe tipado y moneda con procedencia |
Varios elementos .price | ¿Cuál corresponde al artículo y tipo de precio? | Valor desambiguado o fallo de ambigüedad |
Son comprobaciones de extracción aunque los datos provengan de un navegador. Renderizar puede hacer disponible un elemento sin explicar su significado comercial. Conserva la versión del esquema y la referencia de entrada rechazada para evaluar un analizador corregido con el mismo documento. Si el campo no existe en esa entrada, cambiar el selector no puede crearlo: la investigación vuelve al contrato de entrada, no a la afirmación de que renderizar siempre resuelve la extracción.
Asigna el fallo antes de sustituir la herramienta
Si /item/42 nunca entró en la frontera, revisa semillas, descubrimiento de enlaces y alcance. Cambiar el selector del precio no recuperará una página no descubierta. Si estaba en cola pero devolvió HTTP 503, investiga la recuperación y los reintentos permitidos por el origen antes de contarlo como un fallo de extracción.
Si la tabla contiene la página prevista con HTTP 200 pero falta el precio, inspecciona el contenido entregado al extractor. Puede ser otro documento, una página que requiere renderizado o un diseño que el analizador ya no reconoce. Navegar correctamente no demuestra un registro válido. Mantén alertas distintas: fetch_failed y required_field_missing necesitan pruebas y, a menudo, responsables diferentes.
También pueden aparecer duplicados válidos. Volver a descargar todo o añadir un navegador no corrige una clave errónea. Compara primero la clave normalizada, URL de origen e identificador de recuperación; después decide si el defecto corresponde a la deduplicación de descubrimiento o de registros.
Define por separado la finalización y el reprocesamiento
Una frontera vacía detiene el trabajo admitido, pero no certifica cobertura. Para una lista finita del propietario, asigna a cada URL esperada un resultado terminal: recuperada, excluida intencionadamente según el alcance aprobado o sin resolver con motivo. Mantén visibles esas categorías. Quitar una URL fallida de la cola sin registrarla aparentaría finalización eliminando pruebas de trabajo incompleto.
En un descubrimiento abierto puede no existir un denominador exhaustivo. Declara el límite real: orígenes y rutas permitidos, semillas y regla de descubrimiento. Un límite de profundidad, una ventana temporal o una exclusión deliberada cambia el significado de «terminado». No conviertas ese resultado acotado en «se extrajo todo el sitio». El propietario define el alcance y descubrir otro enlace no lo autoriza automáticamente.
Separa la aceptación de documentos que deberían producir artículos. Un índice puede servir solo para generar solicitudes; un documento de artículo puede producir varias ofertas. Si el consumidor necesita un precio por sku, debe contrastar las claves esperadas, no comparar filas con respuestas HTTP. Conserva HTTP 503 como recuperación pendiente, sin mezclarlo con páginas que legítimamente no generan registros.
Reprocesar es otro contrato. Si conservas el cuerpo y solo cambias el analizador, vuelve a extraer desde esa entrada identificada y registra la nueva schema_version; no presentes el resultado como una observación reciente del origen. Para obtener el valor actual hace falta otra recuperación autorizada con su fecha y fetch_id. La actualidad del analizador y la del origen son propiedades distintas.
Entrega ambas tablas y su resumen de conciliación. El responsable de rastreo acepta el alcance y las recuperaciones pendientes; el de datos acepta campos, claves y registros rechazados. Así un resultado parcial es utilizable sin presentarlo como completo: el consumidor decide si admite elementos pendientes y conserva pruebas para posteriores reintentos o correcciones.
Fija el límite antes de recuperar contenido
Evalúa las reglas robots aplicables antes de programar solicitudes automáticas. RFC 9309 dice expresamente que no autorizan el acceso; la distinción entre política robots.txt y permiso separa esa comprobación de la entrega técnica. Revisa los términos y la autorización, incluido el uso previsto de los datos, de forma independiente. Ninguna etiqueta de crawler o scraper cambia esa decisión.
Escribe orígenes y rutas permitidos, condiciones de parada y campos obligatorios antes de la primera recuperación. BotBrowser no concede derechos de recopilación ni eleva límites del sitio. Una cola completada describe el trabajo admitido por la política del equipo; no permite ampliarla ni garantiza cobertura exhaustiva.
Preguntas frecuentes
¿Todo rastreador es un extractor?
No. Una auditoría de enlaces o disponibilidad puede recuperar páginas sin extraer campos comerciales. Una canalización puede hacer ambas cosas, pero su tabla de recuperación y su esquema responden preguntas distintas.
¿Un extractor necesita un rastreador?
No si recibe una lista autorizada conocida o contenido guardado. Descubrir entradas es una necesidad adicional cuando hay que encontrarlas, no una propiedad inherente de extraer campos.
¿Alguna tarea exige un navegador sin interfaz?
Solo si el contenido o la interacción lo requieren. Comprueba si enlaces o valores ya están en la respuesta antes de añadir renderizado. Que haya JavaScript en alguna parte no basta para demostrarlo.
Fuentes
- Google: descripción de crawlers y fetchers
- Scrapy: arquitectura y flujo de datos, fuente del proyecto
- RFC 9309: Robots Exclusion Protocol
- BotBrowser: primeros pasos
- BotBrowser: uso responsable
Conclusión práctica
Declara por separado el alcance de URL y los campos exigidos. Relaciónalos mediante fetch_id, distingue recuperaciones pendientes y registros inválidos, y contrasta ambos antes de aceptar el trabajo. Añade un navegador solo si la entrada registrada demuestra que hace falta; mantén la política de descubrimiento y la validación bajo responsables de la aplicación.
Este artículo forma parte de la guía: Primeros pasos con automatización de navegador: mapa inicial
Artículos Relacionados
Qué es un rastreador web: cinco etapas del rastreo
Primeros pasosScraping con navegador headless: qué cambia
Primeros pasosRastreo web: presupuesto y cortesía básicos
Primeros pasosScraping con Playwright: navegador y perfil
RedScraper bloqueado: errores DNS, TLS, HTTP y de página
Primeros pasosWeb scraping con JavaScript: render, paginar y scroll
Ejecuta la misma comprobación en BotBrowser
Carga un perfil, mantén dentro del navegador las señales que acabas de leer y confirma el resultado en tu propia máquina antes del despliegue.