Qué es un rastreador web: cinco etapas del rastreo
Sigue un rastreador web desde sus URL iniciales hasta la siguiente petición: alcance, descarga, análisis, descubrimiento de enlaces y decisiones de cola.
BotBrowser Team
Quieres la documentación estructurada de Primeros pasos?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
Un rastreador web es un programa que descubre direcciones web y recupera páginas conforme a una política. Parte de URL conocidas, descarga las páginas admisibles, lee su contenido, encuentra otros enlaces y decide qué dirección visitar después. El bucle es sencillo; determinar qué URL deben entrar en él concentra buena parte del trabajo de ingeniería.
BotBrowser puede proporcionar un navegador Chromium para automatización autorizada cuando una página requiere renderizado. No sustituye la lista inicial de URL, la frontera de rastreo, las reglas de deduplicación ni el permiso para recopilar un sitio. Un rastreador puede utilizar un cliente HTTP ordinario, un navegador o ambos. El navegador es un componente de recuperación dentro de un proceso más amplio.
TL;DR
- Una URL inicial pone en marcha el descubrimiento; no describe todas las páginas que pertenecen a un sitio o proyecto.
- La descarga requiere una URL admisible, una decisión sobre la política del sitio y un turno de petición disponible. Descubrir una dirección no autoriza a solicitarla.
- Analizar una respuesta y extraer enlaces son operaciones distintas: un HTML válido puede no contener ninguna siguiente URL admisible.
- Resuelve cada referencia respecto de la base del documento antes de comprobar alcance y duplicados. Conserva la URL resuelta y el motivo de aceptación o rechazo.
- La frontera contiene trabajo pendiente. Que esté vacía solo demuestra que no queda trabajo admisible bajo las reglas registradas, no que se hayan encontrado todas las páginas posibles.
Contenido
- El bucle de cinco etapas
- Elegir las URL iniciales y definir el límite
- Descargar una URL admisible
- Analizar la representación recibida
- Resolver enlaces y rechazar duplicados
- Elegir la siguiente petición y explicar la parada
- Conclusión práctica
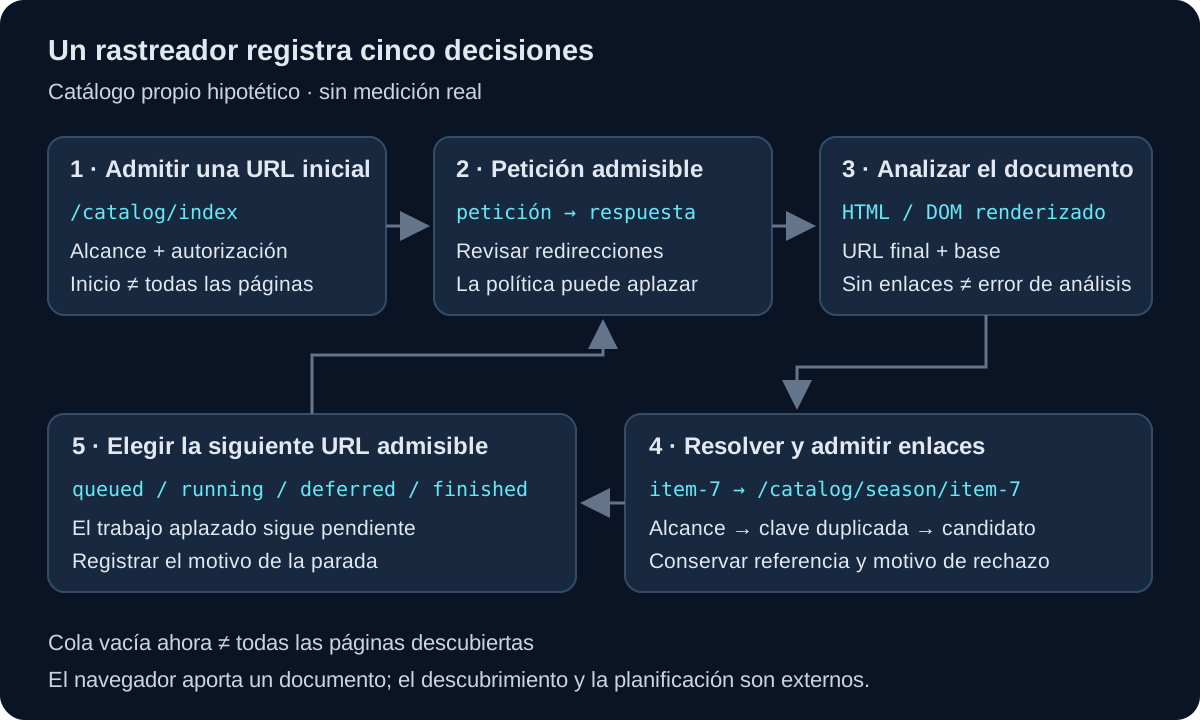
El bucle de cinco etapas
Considera un catálogo expresamente hipotético en https://catalog.example/. Su propietario quiere que un rastreador inspeccione páginas HTML públicas bajo /catalog/, empezando en /catalog/index. La ejecución excluye páginas de acceso, otros orígenes y archivos descargables. Son reglas elegidas para este proyecto, no una definición que deba seguir todo rastreador. Los ejemplos siguientes son una propuesta de traza, no la salida de un rastreo ejecutado.
| Etapa | Entrada | Decisión | Resultado registrado |
|---|---|---|---|
| Inicio | /catalog/index | ¿Pertenece este punto de partida al alcance declarado? | URL inicial admisible |
| Descarga | URL absoluta admisible | ¿Puede ejecutarse ahora una petición y seguirse su destino de redirección? | Respuesta o intento aplazado o fallido |
| Análisis | Cuerpo y metadatos de la respuesta | ¿Qué representación documental y analizador corresponden? | Documento analizado o fallo de análisis identificado |
| Descubrimiento | Enlaces del documento | ¿Qué URL absolutas significan las referencias y cuáles son nuevas y admisibles? | Candidatos aceptados y motivos de rechazo |
| Planificación | Candidatos y trabajo pendiente | ¿Qué elemento admisible se ejecuta después y qué trabajo queda? | Siguiente petición, elemento aplazado o parada registrada |
Es un modelo didáctico, no una arquitectura de software obligatoria. Un framework puede combinar operaciones o ejecutar varias peticiones a la vez. La documentación de arquitectura de Scrapy distingue planificador, descargador y spiders: la respuesta llega al spider y las nuevas peticiones que este genera vuelven al planificador. Separarlos permite preguntar qué componente perdió o rechazó una URL.
La descripción del funcionamiento de la Búsqueda de Google Search Central también diferencia descubrimiento, rastreo e indexación. Son etapas documentadas de la búsqueda de Google, no una promesa de que toda URL descubierta se descargue o indexe. Un rastreador que crea un inventario de su propio catálogo no tiene por qué construir un índice de búsqueda.
La comparación entre rastreador y scraper separa cobertura de recuperación y extracción de campos. Aquí el artefacto útil es una secuencia de decisiones sobre URL. Una página puede descargarse y analizarse correctamente aunque un extractor independiente rechace su ficha de producto por faltar el precio. A la inversa, el rastreador no puede declarar un fallo de extracción de registros para una página que nunca recuperó.
Elegir las URL iniciales y definir el límite
Una URL inicial es una dirección que se entrega al rastreador para arrancar. Puede proceder de un archivo de configuración, de una lista facilitada por el propietario o de un sitemap. La ejecución hipotética empieza con https://catalog.example/catalog/index. Esa elección indica dónde comienza el descubrimiento. No demuestra que desde allí pueda alcanzarse cada página permitida del catálogo.
Mantén separadas la lista de partida y la regla de alcance. Otra URL inicial, como /catalog/archive, puede exponer una parte desconectada del mismo catálogo autorizado. Una dirección inicial bajo /account/ incumple la restricción /catalog/ de esta ejecución aunque comparta host. El rastreador debe rechazarla antes de convertirla en una operación de red, con un motivo como outside_path_scope.
Define un límite evaluable en lugar de confiar en «quedarse dentro del sitio». En este ejemplo, las URL admisibles usan https:, tienen el origen exacto https://catalog.example y una ruta bajo /catalog/. El propietario excluye además /catalog/private/. Un origen incluye esquema, host y puerto; compartir marca o sufijo no incorpora otro origen al destino aprobado.
| Candidato | Decisión de alcance de este ejemplo | Motivo |
|---|---|---|
https://catalog.example/catalog/index | Aceptar | Página inicial del catálogo |
https://catalog.example/catalog/archive | Aceptar | Otro punto de entrada aprobado por el propietario |
https://catalog.example/account/ | Rechazar | Ruta fuera del catálogo declarado |
https://cdn.example/catalog/index | Rechazar | Origen diferente |
https://catalog.example/catalog/private/item | Rechazar | Exclusión explícita de una ruta privada |
Comprueba la ruta en una URL analizada, no mediante una subcadena sin interpretar. Buscar el texto catalog.example también puede encontrarlo en una ruta, un parámetro de consulta o un host distinto. Acuerda con el propietario cómo tratar las rutas codificadas y las redirecciones; decodificar o reescribir componentes indiscriminadamente puede alterar su significado. Un comparador de alcance no es un sistema de autorización para entradas arbitrarias.
El fallo que se evita aquí es una afirmación de cobertura inválida. Supón que el propietario proporciona por separado una lista finita de URL esperadas. Comparar las descargas con esa lista puede revelar páginas ausentes. Sin ese denominador independiente, «todas las páginas encontradas» solo significa todas las halladas mediante este método de descubrimiento. Ni un punto de partida amplio ni muchas peticiones aportan el denominador que falta.
Registra juntos el conjunto inicial, la versión del alcance y el identificador de ejecución. Si se añade /catalog/archive a mitad del trabajo, los descubrimientos posteriores parten de entradas diferentes. Hacer visible ese cambio permite explicar una URL recién encontrada sin atribuirla a una corrección del analizador o a un cambio de navegador.
Descargar una URL admisible
Descargar convierte una URL aceptada en un intento de petición. Antes de enviarlo, comprueba las reglas del sitio y el permiso del proyecto; después determina si puede ejecutarse en ese momento. Son decisiones distintas. Una URL puede estar dentro del catálogo y, aun así, quedar prohibida por la política robots aplicable, fuera del permiso del propietario o aplazada por un planificador por origen.
La explicación de la política robots.txt cubre el grupo de agente identificado y la interpretación de sus reglas. El RFC 9309 establece que estas reglas no constituyen autorización de acceso. Una admisión de robots no sustituye condiciones, consentimiento ni decisiones de control de acceso; que falte el archivo no convierte un recurso privado en un destino permitido.
Utiliza una política de peticiones que registre por qué se ejecutó la operación. Para la página hipotética /catalog/index, el intento puede contener request_url, requested_at, policy_version, attempt_number y un resultado de descarga. Son campos de aplicación propuestos. No son pruebas aportadas por el navegador de que exista permiso, y ningún valor de ejemplo representa una medición real de red.
Las redirecciones necesitan una nueva comprobación del límite. Una petición a /catalog/old puede conducir a /account/login o a otro origen. Validar solo la URL inicial y seguir automáticamente las redirecciones permite salir del alcance declarado. Inspecciona el siguiente destino antes de seguirlo, conserva la cadena para diagnosticarla y detente cuando el destino no sea admisible. Aplica también un límite finito de redirecciones.
Una respuesta descargada todavía debe clasificarse. Una página HTML del catálogo, un formulario de acceso con HTTP 200, una respuesta 404 y un error temporal del servicio significan cosas distintas. Guarda el estado, la URL final y el tipo de medio pertinente junto a la decisión sobre el cuerpo. No etiquetes cualquier HTTP 200 como página de catálogo correcta: la aplicación puede haber recibido una representación equivocada.
El planificador también necesita una política de peticiones por origen. La concurrencia controla el trabajo simultáneo; el espaciado limita cuándo comienza una petición nueva. Ninguna equivale a la otra. Si el origen señala sobrecarga, conserva un resultado aplazado y la política de reintento aplicable en lugar de crear un bucle inmediato. El dimensionamiento detallado pertenece a la capacidad; esta etapa necesita una regla más concreta: una página descubierta no siempre puede descargarse ahora. La hoja de capacidad de rastreo calcula cómo las pausas y la reserva para reintentos reducen un presupuesto finito de inicios de petición.
Separa resultados de intentos y resultados de URL. /catalog/item-7 puede sufrir un primer intento agotado por tiempo y obtener después una respuesta correcta. El registro debe conservar ambos hechos y asignar a la URL un único estado actual de planificación. Contar los dos intentos como dos páginas cubiertas infla la cobertura; borrar el primero elimina la prueba necesaria para comprender el reintento.
Analizar la representación recibida
El análisis interpreta la respuesta como documento. Primero hay que saber qué se está procesando. Un analizador HTML, uno JSON y un procesador PDF tienen funciones distintas. Si esta ejecución acepta páginas públicas HTML del catálogo, un tipo de medio inesperado debe producir un resultado identificado, no enviarse sin más al extractor de enlaces HTML.
La URL de respuesta importa porque las referencias posteriores necesitan una base. Si /catalog/index redirige a /catalog/season/, el documento recuperado corresponde a la ubicación final. Una referencia relativa como item-7 se resuelve de forma distinta desde ambas ubicaciones. Conserva la URL final de la descarga en vez de reconstruirla desde la dirección inicial.
Analizar HTML recibido y renderizar una página también son operaciones diferentes. Un cliente HTTP puede analizar enlaces ya presentes en la respuesta. Un navegador puede ejecutar scripts que creen otros nodos y enlaces DOM. Google documenta esas rutas en sus fundamentos de SEO para JavaScript. La documentación describe su propio proceso; no demuestra que cualquier rastreador ejecute JavaScript.
Elige la representación de forma deliberada. En una página de prueba propia, compara los enlaces de la respuesta con los que crea la aplicación al alcanzar su estado de disponibilidad documentado. Si los enlaces necesarios ya están en el HTML recibido, ese paso de descubrimiento no necesita renderizado. Si aparecen únicamente tras inicializarse la aplicación, se necesita una etapa de navegador correspondiente u otra fuente de URL aprobada por el propietario.
BotBrowser puede servir como esa etapa dentro de una automatización autorizada, según su documentación de inicio. No elige la condición de disponibilidad ni decide que el DOM esté completo. El contrato de la aplicación debe identificar el evento, estado o elemento que hace significativa la recopilación de enlaces. Una espera arbitraria puede terminar antes de que lleguen los datos o prolongarse sin fin si la página mantiene actividad de fondo.
Conserva los fallos de análisis como una rama propia. Si se recuperó la respuesta pero el analizador rechazó su contenido, la URL se descargó; lo que falló fue su interpretación. Si una página analizada no contiene anclas admisibles, el análisis puede haber sido correcto. Registra casos distintos, como parse_failed y parsed_no_candidates, con significados definidos por la aplicación.
Esta distinción evita una corrección costosa pero equivocada. Aumentar los recursos del navegador no convierte una respuesta de acceso en una página de catálogo autorizada. Repetir una descarga HTTP no revela enlaces creados por scripts si la representación no cambia. Diagnostica la clase de respuesta y el objetivo del análisis antes de sustituir el componente de recuperación.
Resolver enlaces y rechazar duplicados
El descubrimiento comienza con referencias, que no siempre son URL absolutas. Un ancla puede contener item-7, ../archive/ o #details. La referencia del constructor URL explica cómo resolver referencias relativas respecto de una base. En HTML analizado, la URI base del documento también puede depender de un elemento base aplicable.
La tabla siguiente supone una base registrada de https://catalog.example/catalog/season/. Presenta decisiones propuestas para esta política, no resultados de un rastreador en ejecución. Una base externa cambiaría la resolución; el destino resuelto sigue sujeto a la misma comprobación de origen.
| Referencia | URL resuelta | Decisión |
|---|---|---|
item-7 | https://catalog.example/catalog/season/item-7 | Nuevo candidato admisible |
./item-7 | https://catalog.example/catalog/season/item-7 | Candidato duplicado |
item-7#details | https://catalog.example/catalog/season/item-7#details | Misma clave de descarga según la política de fragmentos de esta ejecución |
../archive/ | https://catalog.example/catalog/archive/ | Candidato admisible |
/account/login | https://catalog.example/account/login | Fuera del alcance de rutas |
https://other.example/catalog/item-7 | https://other.example/catalog/item-7 | Fuera del alcance de orígenes |
Comprueba la admisibilidad después de resolver la referencia. Un enlace relativo aparentemente inocuo puede apuntar a un destino excluido al cambiar la base. Acepta solo esquemas adecuados al rastreador: una referencia mailto: o javascript: no es una petición HTTP al catálogo. Un servicio general que admita URL arbitrarias necesita controles adicionales de seguridad sobre los destinos de red, además de las reglas de este ejemplo.
La deduplicación necesita una clave explícita. Esta ejecución elimina el fragmento para identificar una descarga de red, por lo que las tres referencias al producto comparten clave. Es una política del catálogo, no una prueba de que los fragmentos nunca afecten a una aplicación. Una ruta renderizada en el cliente puede usarlos para seleccionar otra vista. Si esa vista forma parte del trabajo, la clave de navegación del navegador y la de descarga HTTP pueden diferir.
No elimines parámetros de consulta por parecer repetitivos. /catalog/search?page=1 y /catalog/search?page=2 pueden mostrar productos distintos. En cambio, un parámetro de seguimiento confirmado por el propietario podría omitirse en la clave de planificación. Registra qué transformación está permitida y por qué. Ordenar, pasar a minúsculas o decodificar una URL entera puede fusionar direcciones que el servidor distingue.
Guarda la referencia original y su página de origen junto al candidato resuelto. Un rechazo con source_url, raw_reference, resolved_url, candidate_key y decision_reason explica cómo se tomó la decisión. También revela un extractor que recorta direcciones o ignora la base. Conservar solo la lista final de visitas pierde esas pruebas del descubrimiento.
Las URL duplicadas y los documentos duplicados son cuestiones distintas. Dos direcciones pueden devolver cuerpos idénticos; una misma dirección puede cambiar de contenido con el tiempo. Un hash de contenido puede apoyar decisiones de almacenamiento o detección de cambios, pero no demuestra que ambas identidades URL deban fusionarse para cualquier finalidad. La frontera debe usar la regla de identidad declarada y registrar aparte la comparación de contenido si resulta necesaria.
Elegir la siguiente petición y explicar la parada
La frontera reúne las URL pendientes y el estado necesario para planificarlas. No tiene por qué ser una sola cola en memoria. Un script pequeño puede usar una cola y un conjunto; un servicio mayor puede persistir trabajo entre workers. Ambos deben distinguir lo descubierto, encolado, en ejecución, aplazado y terminado.
En el catálogo hipotético, /catalog/archive/ puede estar en cola mientras /catalog/season/item-7 espera un momento permitido. La siguiente petición se elige entre el trabajo pendiente admisible. Un recorrido por amplitud tiende a visitar antes enlaces cercanos a las URL iniciales; una política de prioridades puede favorecer una sección definida por el propietario. Ninguna garantiza cobertura completa si hay páginas inalcanzables o un espacio de URL que sigue creciendo.
| Estado del elemento | Qué sabe la ejecución | Qué queda por hacer |
|---|---|---|
queued | El candidato superó las comprobaciones actuales de admisión | Asignarlo a una descarga admisible |
running | Un worker posee un intento | Completarlo o recuperarlo |
deferred | Queda trabajo que todavía no puede ejecutarse | Reevaluarlo en el momento o condición registrados |
finished | La URL alcanzó un resultado terminal declarado | Conservar respuesta y resultado de procesamiento |
rejected | Una política registrada excluyó el candidato | Conservar el motivo sin contarlo como descargado |
Son estados de registro sugeridos, no un estándar de frameworks. El fallo de un worker no debe transformar silenciosamente running en finished. Un planificador persistente puede usar una concesión temporal u otro mecanismo explícito de propiedad para recuperar trabajo interrumpido. La recuperación también necesita protección contra duplicados: reintentar una operación abandonada no debe crear dos propietarios simultáneos de la misma clave.
Evita un conjunto genérico de «visto equivale a terminado». Si se marca una URL como vista al descubrirla y falla su escritura en la cola, puede desaparecer de posteriores descubrimientos sin llegar a descargarse. La admisión debe dejar un resultado duradero pendiente o rechazado. Del mismo modo, una petición fallida no está completa porque ya se hubiera observado su URL. El registro debe distinguir descubrimiento duplicado y estado actual de trabajo.
Parar exige más que comprobar si la cola inmediata está vacía. Los elementos aplazados, intentos activos y respuestas sin procesar todavía pueden generar trabajo. Una ejecución acotada debe registrar si terminó porque todo el trabajo admitido alcanzó un estado terminal, se agotó un límite temporal o de páginas, lo pidió un operador o una política impidió continuar. Cada resultado justifica una afirmación de cobertura distinta.
Por ejemplo, si /catalog/archive/ está terminado pero item-7 sigue aplazado, puede afirmarse «ahora no hay ninguna petición admisible; queda una URL admitida pendiente». No «el catálogo está completo». Cuando todas las URL admitidas sean terminales, informa del alcance, los puntos iniciales y los recuentos por resultado terminal. Una lista independiente del propietario permite después comparar cobertura; la frontera no revela páginas que nunca descubrió.
Preguntas frecuentes
¿Todo rastreador web utiliza un navegador?
No. Un cliente HTTP y un analizador pueden descubrir enlaces presentes en el HTML recibido. El navegador resulta útil cuando el trabajo depende del documento renderizado, pero sigue necesitando una política externa de descubrimiento y planificación.
¿Termina un rastreador después de visitar la página principal?
Solo si esa única URL es el trabajo declarado. Para descubrir un catálogo, la respuesta inicial suele crear candidatos adicionales que necesitan resultados de admisión y estados terminales registrados.
¿Un enlace canonical ordena borrar otra URL?
Una declaración canonical no sustituye la regla de identidad de descarga del proyecto. Conserva la declaración observada y decide cómo afecta al trabajo. No la trates automáticamente como permiso, redirección HTTP ni prueba de que dos respuestas sean idénticas.
Fuentes
- Google Search Central: cómo funciona la Búsqueda
- Proyecto Scrapy: arquitectura
- RFC 9309: protocolo de exclusión de robots
- Google Search Central: fundamentos de SEO para JavaScript
- MDN: constructor URL()
- MDN: Node.baseURI
- BotBrowser: primeros pasos
- BotBrowser: uso responsable
Conclusión práctica
Define para un rastreo autorizado del catálogo una lista inicial, una regla de alcance y una condición finita de parada. Conserva para cada referencia su origen, URL resuelta y motivo de admisión; para cada URL admitida, los resultados de descarga, análisis y planificación. Estos registros convierten las cinco etapas en un bucle explicable, incluidas las URL rechazadas o aplazadas. El navegador puede aportar el documento renderizado cuando sea necesario; permiso, política de descubrimiento y finalización siguen siendo responsabilidad del operador.
Este artículo forma parte de la guía: Primeros pasos con automatización de navegador: mapa inicial
Artículos Relacionados
Web crawler vs web scraper: resultados y fallos
Primeros pasosRastreo web: presupuesto y cortesía básicos
DespliegueScraping con robots.txt: reglas, bloqueos y fallos de acceso
Primeros pasosScraping de Instagram: requisitos de la API
Primeros pasosHuella del navegador en Scrapy: qué no puede configurar
Primeros pasosConfigurar browser-use con un navegador controlado
Ejecuta la misma comprobación en BotBrowser
Carga un perfil, mantén dentro del navegador las señales que acabas de leer y confirma el resultado en tu propia máquina antes del despliegue.