Scraping con robots.txt: reglas, bloqueos y fallos de acceso
Comprueba las reglas de scraping de robots.txt antes de una tarea de navegador: selecciona el grupo del crawler, resuelve Allow y Disallow, y distingue la política del acceso HTTP.
BotBrowser Team
Quieres la documentación estructurada de Despliegue?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
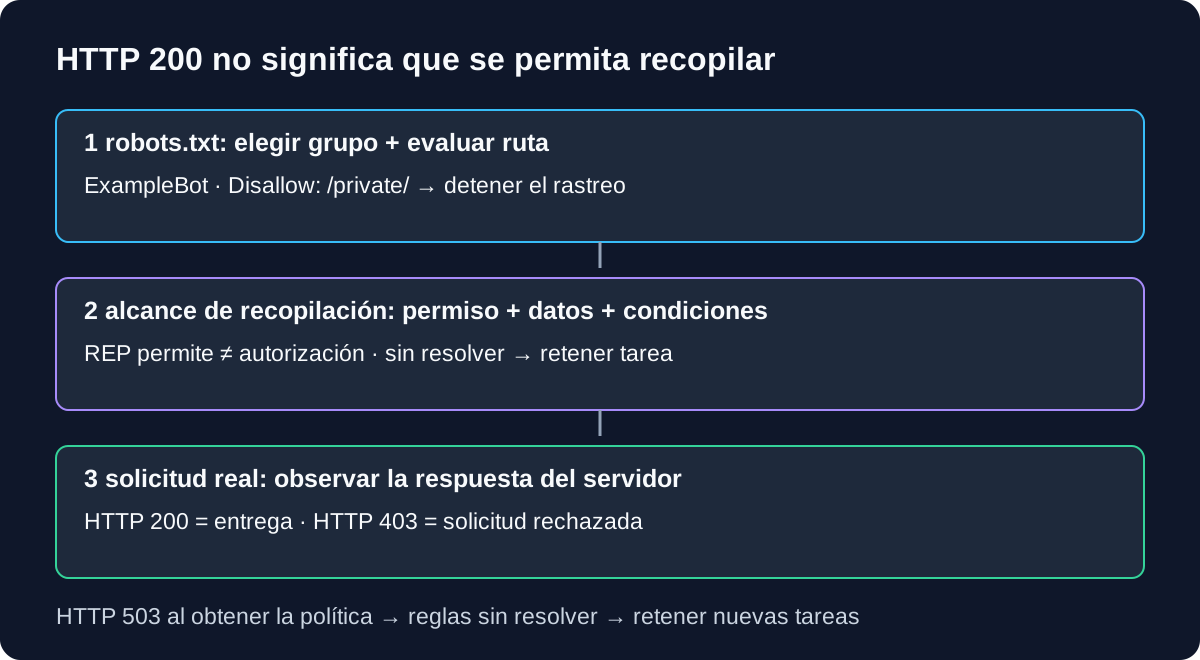
Que una página devuelva HTTP 200 no resuelve una decisión de scraping de robots.txt. El servidor puede entregar un documento que sus reglas publicadas para crawlers prohíben. BotBrowser admite integraciones de automatización del navegador, pero no sustituye al evaluador de robots.txt de la aplicación ni concede permiso para recopilar una página.
Resumen
- Evalúa las reglas para el token de producto declarado por el crawler antes de enviar la solicitud al destino.
- Combina los grupos con nombre que coincidan; usa
User-agent: *solo si no coincide ningún grupo con nombre. - Resuelve las rutas coincidentes por especificidad, no por la posición de la primera regla.
- Trata una regla de robots, el permiso para recopilar y la respuesta HTTP real como decisiones separadas.
- Detén los nuevos envíos cuando no se pueda resolver la descarga de la política; un error HTTP no invita a cambiar de identidad.
Contenido
- Separar política, permiso y entrega
- Elegir el grupo del crawler antes que la URL
- Ejecutar un ejemplo acotado de coincidencia
- Resolver la descarga de robots antes que la de la página
- Incorporar la decisión a la cola de solicitudes
- Conclusión práctica
Separar política, permiso y entrega
El Protocolo de Exclusión de Robots, RFC 9309, define una forma para que los propietarios de servicios publiquen reglas para crawlers. Es un mecanismo de coordinación: un crawler participante obtiene /robots.txt, selecciona las reglas aplicables y las usa al decidir qué solicitar. El servidor no tiene que consultar ese archivo cada vez que recibe una solicitud. Por tanto, un navegador puede recibir HTTP 200 para un documento no permitido. Eso es compatible con el diseño del protocolo, no una prueba de que la regla haya dejado de aplicarse.
En un registro de incidente deben constar tres preguntas distintas. Primero, ¿la regla de robots aplicable permite esta URL para este crawler declarado? Segundo, ¿el equipo ha establecido una base adecuada para recopilar estos datos, teniendo en cuenta las condiciones del servicio, la autorización, el alcance de los datos y las obligaciones aplicables? Tercero, ¿qué devolvió realmente el servidor? La evaluación de una regla no responde a la segunda pregunta, y una respuesta satisfactoria no responde a ninguna de las dos primeras.
| Observación | Qué establece | Qué no establece | Siguiente acción segura |
|---|---|---|---|
Disallow: /private/ coincidente | La regla REP aplicable prohíbe las rutas coincidentes | Que el servidor vaya a rechazar una solicitud manual | Excluir esas rutas de la cola de rastreo |
| Ninguna regla de ruta coincidente | REP no prohíbe esa URL para el grupo seleccionado | Permiso, licencia de recopilación o límite de frecuencia | Aplicar la política de recopilación aprobada por separado |
| HTTP 200 del destino | El destino devolvió una respuesta HTTP satisfactoria | Cumplimiento de robots, integridad de los datos o permiso legal | Mantener separadas la política y la validación del contenido |
| HTTP 403 del destino | El servidor rechazó esa solicitud | Qué regla de robots, señal de identidad o producto de seguridad causó el rechazo | Detenerse y diagnosticar con pruebas autorizadas |
La última fila corresponde al diagnóstico por capas de un scraper bloqueado: distingue un fallo de DNS o conexión de una respuesta HTTP y de un problema con los datos de la página. La evaluación de robots sucede antes de esa solicitud; el diagnóstico del incidente explica un resultado posterior. Mezclar esas etapas lleva a afirmaciones engañosas como «robots bloqueó el navegador» cuando las pruebas solo muestran HTTP 403.
El RFC 9309 también advierte que enumerar rutas las hace visibles públicamente. El propietario del servicio debe proteger los recursos confidenciales con controles de acceso adecuados; Disallow no es autenticación. A la inversa, que una ruta sea visible no invita al crawler a obtenerla. Para un flujo autorizado de tienda, los límites de las colecciones de Shopify distinguen una página observada de los datos y el alcance de acceso que realmente requiere la recopilación. Ese alcance sigue siendo importante después de superar la comprobación de reglas.
Elegir el grupo del crawler antes que la URL
Un registro User-agent identifica el token de producto de un crawler, no una huella completa ni automáticamente toda la cabecera User-Agent del navegador. El RFC 9309 exige que la coincidencia del token de producto no distinga mayúsculas de minúsculas. El token debe aparecer en la cadena de identificación del crawler, que debería describir su propósito. Elige un token honesto y estable para la aplicación de recopilación; no cambies al grupo de un buscador conocido porque sus reglas sean distintas.
Considera este archivo sintético en un servicio de ejemplo propio:
User-agent: *
Disallow: /catalog/

User-agent: ExampleBot
Disallow: /catalog/private/
Allow: /catalog/private/help/

User-agent: examplebot
Disallow: /exports/
Allow: /exports/public/
Para ExampleBot, coinciden los dos grupos con nombre sin importar las mayúsculas, por lo que sus reglas se combinan. El grupo comodín no se añade a esos grupos con nombre. Para otro crawler sin grupo con nombre coincidente, User-agent: * proporciona las reglas aplicables. Si no corresponde ningún grupo con nombre ni comodín, no se aplica ninguna regla de grupo. Ninguno de estos resultados establece un permiso de recopilación más allá de REP.
La distinción cambia /catalog/item: el grupo comodín lo prohíbe, mientras que las reglas combinadas de ExampleBot no coinciden con esa ruta. Para ese mismo crawler con nombre, /catalog/private/item coincide con una regla de prohibición y /catalog/private/help/start coincide tanto con una prohibición como con una regla Allow más larga. Un parser que simplemente combinase todos los grupos produciría otra decisión para /catalog/item. Uno que se detuviese tras el primer grupo con nombre coincidente pasaría por alto /exports/.
No equipares el token de producto con la cadena de navegador que una herramienta de pruebas envíe por casualidad. Un proceso de navegador puede cargar una URL sin actuar como planificador completo de crawlers. La aplicación responsable del descubrimiento de URL, las descargas de políticas, la interpretación de reglas y el envío debe mantener explícitas esas responsabilidades. La referencia de automatización de BotBrowser documenta la capa de integración del navegador; no demuestra que una biblioteca haya implementado REP por ti.
Coincidir con un servicio, no con una organización entera
El archivo de reglas es /robots.txt en la ruta superior del servicio. Registra el esquema y la autoridad junto con su URL: https://example.test/robots.txt no es una descarga de política para todos los nombres de host, puertos y protocolos asociados con esa organización. No copies una decisión Allow de un origen a una cola de otro. La navegación relativa, los subdominios y las redirecciones pueden cambiar el contexto del servicio aunque la marca visible sea la misma.
El RFC 9309 indica que los crawlers deberían seguir al menos cinco redirecciones consecutivas de robots, incluso entre autoridades. Cuando el archivo se alcanza dentro de esa cadena, sus reglas se aplican en el contexto de la autoridad inicial. Registra tanto la URL de política solicitada como la URL final de respuesta. De lo contrario, una caché indexada solo por el alojamiento final podría asociar accidentalmente las reglas de un sitio a la cola de destinos de otro.
Ejecutar un ejemplo acotado de coincidencia
La coincidencia de rutas empieza al comienzo de la ruta de destino. El RFC 9309 usa la regla coincidente más específica, medida en octetos; la coincidencia de rutas distingue mayúsculas y minúsculas. Cuando las reglas Allow y Disallow equivalentes empatan, debería usarse Allow. Por tanto, el orden de las líneas no es un procedimiento fiable para decidir. El protocolo también define *, el $ terminal, los comentarios y el comportamiento de la codificación porcentual, aspectos que una implementación de producción debe manejar.
El siguiente ejemplo de Node.js aísla únicamente la selección de grupo y la coincidencia literal de prefijos ASCII. Los grupos ya son registros analizados del archivo sintético anterior. El programa rechaza deliberadamente rutas con comodines, marcador terminal, codificación y caracteres no ASCII en lugar de fingir que implementa el resto del RFC 9309. No realiza solicitudes de red ni prueba la política de ningún sitio activo. Pégalo en un archivo .mjs local y ejecútalo con node.
import assert from 'node:assert/strict';

const groups = [
  { agent: '*', rules: [['disallow', '/catalog/']] },
  {
    agent: 'ExampleBot',
    rules: [
      ['disallow', '/catalog/private/'],
      ['allow', '/catalog/private/help/'],
    ],
  },
  {
    agent: 'examplebot',
    rules: [
      ['disallow', '/exports/'],
      ['allow', '/exports/public/'],
    ],
  },
];

function literalDecision(agent, path) {
  const named = groups.filter(g => g.agent.toLowerCase() === agent.toLowerCase());
  const selected = named.length ? named : groups.filter(g => g.agent === '*');
  const rules = selected.flatMap(g => g.rules);
  for (const value of [path, ...rules.map(r => r[1])]) {
    if (!value.startsWith('/') || /[^\x20-\x7e]|[%*$?#]/.test(value)) {
      throw new Error('literal ASCII paths only');
    }
  }
  const matches = rules.filter(([, prefix]) => path.startsWith(prefix));
  matches.sort((a, b) => b[1].length - a[1].length || Number(b[0] === 'allow') - Number(a[0] === 'allow'));
  return !matches.length || matches[0][0] === 'allow';
}

const cases = [
  ['ExampleBot', '/catalog/item', true],
  ['OtherBot', '/catalog/item', false],
  ['ExampleBot', '/catalog/private/item', false],
  ['ExampleBot', '/catalog/private/help/start', true],
  ['ExampleBot', '/exports/file', false],
  ['EXAMPLEBOT', '/exports/public/file', true],
  ['ExampleBot', '/Catalog/private/item', true],
];
for (const [agent, path, allowed] of cases) {
  const actual = literalDecision(agent, path);
  assert.equal(actual, allowed, `${agent} ${path}`);
  console.log(`${agent} ${path} repAllowed=${actual}`);
}
La salida usa el nombre repAllowed para impedir que la etiqueta se convierta silenciosamente en «autorizado». Los dos primeros casos muestran la selección entre un grupo con nombre y el comodín. Los dos casos del catálogo privado muestran la selección del prefijo más largo. Los casos de exports muestran la combinación de grupos y la comparación del token sin distinguir mayúsculas. El último caso cambia las mayúsculas de la ruta URL, no las del token del crawler. Una normalización de URL que convierta todas las rutas a minúsculas borraría esa distinción y podría cambiar los recursos solicitados.
Este ejemplo acotado no analiza un archivo de texto descargado, no combina varios registros de tokens de producto dentro de un grupo, no normaliza octetos URI, no sigue redirecciones, no valida tipos MIME, no administra la duración de la caché ni elige una política de reintentos de red. Solo ayuda a razonar sobre las entradas mostradas. En producción, selecciona una implementación REP mantenida, revisa la sintaxis que admite y prueba estos casos junto con casos de codificación porcentual y de */$. Superar siete casos ASCII no demuestra conformidad con el protocolo.
Un valor Disallow vacío es otro caso que debe manejar un parser de producción, no una prohibición general de /. Según RFC 9309, el campo del patrón de ruta puede estar vacío; eso no crea un prefijo prohibido que abarque el sitio. No conviertas una línea vacía en / al normalizar la configuración. Del mismo modo, una directiva desconocida no debe terminar un grupo válido ni borrar los registros Allow/Disallow analizables que la rodean.
Resolver la descarga de robots antes que la de la página
Una solicitud al destino y una solicitud a robots son eventos distintos. Registra policyStatus y targetStatus en campos separados. Si /robots.txt devuelve HTTP 503, el crawler tiene una descarga de política sin resolver aunque la página de destino devolviera HTTP 200 ayer. Un panel que solo almacene el último código HTTP por host puede ocultar la diferencia y reanudar el trabajo por el motivo equivocado.
| Resultado de la descarga de política | Referencia de RFC 9309 | Decisión de la aplicación de recopilación |
|---|---|---|
| Descarga de robots satisfactoria | Seguir las reglas analizables | Evaluar el token declarado y la URL de destino |
| HTTP 404, archivo no disponible | REP puede permitir el acceso a los recursos | Aplicar por separado las comprobaciones de permiso y política de recopilación |
| HTTP 401 o 403, también dentro del rango 4xx | La categoría de no disponible del RFC no equivale a autorización | Pausar y esperar una decisión explícita de política; no inferir consentimiento |
| HTTP 429 | No suponer que todos los crawlers lo tratan como un archivo simplemente ausente | Detener los envíos y respetar las indicaciones de limitación del servicio |
| HTTP 5xx o fallo de red | Suponer una prohibición completa mientras no se pueda acceder | Retener nuevos trabajos y aplicar una política de recuperación acotada |
| Algunos registros mal formados en un archivo que sigue siendo utilizable | Usar las reglas analizables | Conservar los diagnósticos del parser en vez de descartar todo el archivo |
La categoría de no disponible del RFC abarca HTTP 400-499, mientras que la de inaccesible incluye HTTP 500-599 y los errores de red. Esa distinción describe el comportamiento del protocolo para crawlers. Las decisiones más estrictas de la columna derecha para HTTP 401, 403 y 429 son política de la aplicación, no requisitos inventados del RFC. La documentación de Google sobre el tratamiento de robots también distingue HTTP 429 de la mayoría de las demás respuestas 4xx. El comportamiento de Googlebot es documentación útil del proveedor, pero no un algoritmo universal de reintentos para tu recolector.
La caché también requiere registrar el tiempo. RFC 9309 indica que un crawler no debería usar una copia almacenada durante más de 24 horas, salvo que el archivo sea inaccesible. Sus directrices sobre inaccesibilidad permiten otras opciones tras un periodo razonablemente largo y citan 30 días como ejemplo. Esas salvedades no justifican un indicador indefinido de «última autorización conocida» sin la hora de descarga, el historial de respuestas o una decisión de revisión. Si un lote se reanuda tras una interrupción de política, vuelve a evaluar las URL restantes conforme a las reglas actuales antes de reabrir los envíos.
Crawl-delay no es una de las reglas Allow/Disallow definidas por RFC 9309. Algunas implementaciones interpretan registros adicionales y otras no. La ausencia de una directiva de demora compatible no proporciona un presupuesto de solicitudes. Mantén separadas las decisiones de concurrencia y frecuencia de la aplicación del comparador de rutas, y reduce o detén los envíos cuando el servicio indique limitación. Una regla de ruta permisiva no garantiza que la frecuencia de trabajo sea aceptable.
Incorporar la decisión a la cola de solicitudes
El punto de integración útil es el componente que puede impedir que una URL llegue al trabajo del navegador. Evaluar robots después de la navegación llega demasiado tarde para esa solicitud. Guarda la decisión junto con el origen, el token de producto del crawler, la hora de descarga de la política, el grupo seleccionado, la regla coincidente pertinente y el alcance de recopilación aprobado por separado. Cuando las reglas de retención lo permitan, conserva el texto de la política o una huella de su contenido para que una investigación posterior identifique la versión que produjo la decisión.
Un registro de envío pequeño puede usar origin, productToken, policyFetchedAt, policyStatus, matchedRule, repDecision y collectionDecision. Aunque repDecision=allow, la tarea sigue retenida si collectionDecision=unresolved. repDecision=disallow elimina la tarea del conjunto elegible aunque el navegador hubiera podido acceder antes. Un fallo de red produce repDecision=unresolved, no un archivo robots vacío inventado. Estos estados hacen explícita la condición de parada sin tratar todos los fallos de descarga como el mismo evento.
La aplicación de la cola también debe considerar las solicitudes que genera el navegador. Abrir un documento permitido puede cargar imágenes, scripts, marcos o solicitudes API en segundo plano. Comprobar la URL de nivel superior no demuestra por sí solo que todas las subsolicitudes automáticas cumplan la política de recopilación. Antes del envío, inventaría los orígenes de recursos necesarios y define el alcance autorizado; si el flujo no puede respetarlo, detente y elige una interfaz aprobada o una tarea de recopilación menor. No uses una página permitida como pretexto para solicitar endpoints de datos prohibidos.
En la recopilación con varios trabajadores, el planificador debe publicar una decisión de política por origen y token declarado, en vez de permitir que cada trabajador invente su propio resultado. Invalida las decisiones en cola cuando cambie la versión pertinente de la política. Si el archivo actual ahora prohíbe una ruta previamente encolada, elimina los trabajos no iniciados; no mantengas vigente la decisión de ayer solo porque la sesión del navegador siga abierta. Es un requisito de coherencia de la aplicación, no una propiedad de un perfil del navegador.
Las integraciones de automatización documentadas de BotBrowser proporcionan un navegador para una tarea autorizada. No convierten REP en un control de acceso, no eligen el nombre de crawler que debe declarar tu aplicación, no establecen permiso de recopilación ni garantizan que un destino acepte la solicitud. La política de uso responsable y el aviso legal siguen siendo límites relevantes. La configuración del navegador y un inicio satisfactorio no sustituyen una decisión de política pendiente aguas arriba.
Preguntas frecuentes
¿Una regla Allow de robots.txt significa que puedo recopilar datos personales?
No. Una regla Allow resuelve una decisión de ruta del protocolo para el crawler aplicable. La categoría de los datos, su finalidad, las condiciones de acceso, la retención y las obligaciones aplicables siguen siendo cuestiones independientes para el equipo responsable. REP no concede una licencia de uso de datos, y esta distinción técnica no es asesoramiento legal.
¿Disallow impide que una URL aparezca en los resultados de búsqueda?
No necesariamente. La introducción de Google a robots distingue el rastreo de la indexación: una URL cuyo rastreo se prohíbe aún puede descubrirse mediante enlaces. Mantener privado un documento confidencial requiere protección de acceso. Prohibir el rastreo no sustituye de forma fiable la autenticación ni es una instrucción universal para eliminar una URL del índice.
¿Se puede reutilizar la misma decisión de robots después de una redirección?
Registra por separado los contextos de origen y destino. Una redirección del archivo robots sigue la regla de autoridad inicial descrita por RFC 9309; una redirección de la página de destino puede introducir otro servicio cuya política y alcance de autorización aún deben evaluarse. No deduzcas que una redirección transfiere una decisión Allow o un permiso de recopilación a un host no relacionado.
¿Por qué puede un navegador normal abrir una ruta prohibida por Disallow?
REP lo implementan las aplicaciones crawler participantes; no impone automáticamente que se rechace cada navegación del navegador. El servidor HTTP aún puede servir la ruta. Esa respuesta demuestra que se entregó contenido a esa solicitud, mientras que la obligación del crawler de seguir sus reglas aplicables es una decisión distinta.
Fuentes
- RFC 9309: Robots Exclusion Protocol, en especial las secciones 2.2-2.5 y 3
- Google Search Central: introducción a robots.txt
- Google Search Central: interpretación de robots.txt y tratamiento HTTP
- Referencia de coherencia de automatización de BotBrowser
- Uso responsable de BotBrowser
- Aviso legal de BotBrowser
Conclusión práctica
Ante la próxima decisión de scraping con robots.txt, parte de un token de crawler declarado, un origen de servicio y una ruta de destino. Resuelve las reglas aplicables, mantén separado el permiso de recopilación y evita que el trabajo prohibido o sin resolver entre en la cola del navegador. Una respuesta HTTP satisfactoria indica que el servidor entregó un documento; no sustituye las decisiones anteriores.
Este artículo forma parte de la guía: Despliegue y versión del navegador: mapa operativo
Artículos Relacionados
Scraping de Shopify: ¿Storefront API, Ajax o navegador?
RedScraper bloqueado: errores DNS, TLS, HTTP y de página
DespliegueScraping de bolsas de empleo: límites del navegador
RedCabeceras Fetch Metadata: contexto CSRF y privacidad
DesplieguePrecios de competidores: diseño de la canalización
PlataformaSpeculation Rules: límites de prefetch y prerender
Ejecuta la misma comprobación en BotBrowser
Carga un perfil, mantén dentro del navegador las señales que acabas de leer y confirma el resultado en tu propia máquina antes del despliegue.