Scraper bloqueado: errores DNS, TLS, HTTP y de página
Localiza un scraper bloqueado por la última capa demostrada: DNS, TLS, HTTP o ejecución. Conserva la respuesta sin inventar una explicación antibot.
BotBrowser Team
Quieres la documentación estructurada de Red?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
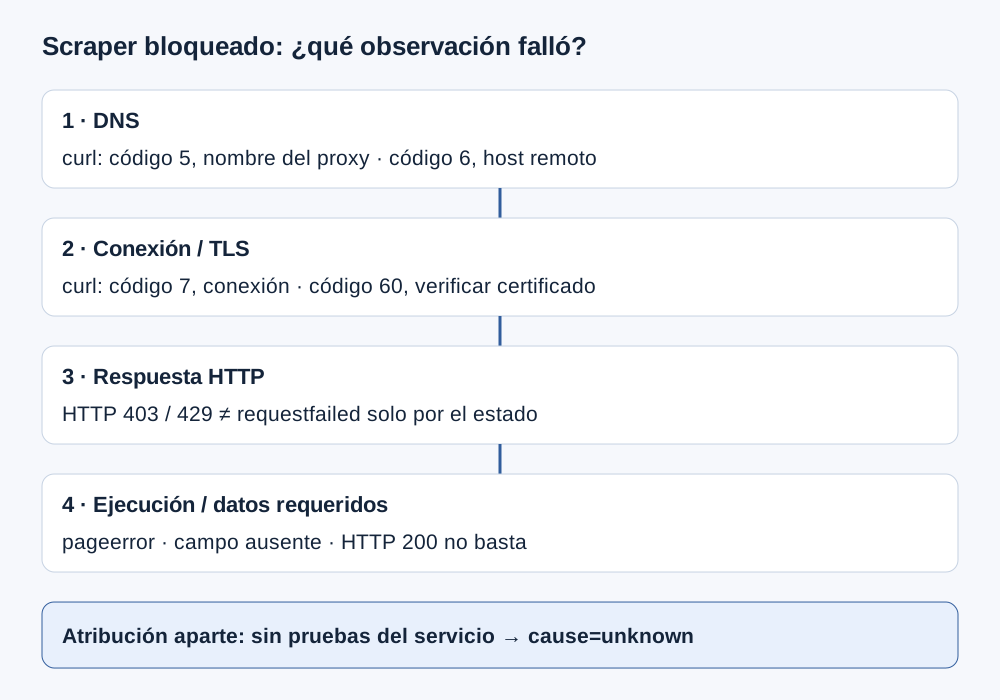
Un mensaje de scraper bloqueado etiqueta un incidente; no lo diagnostica. Un fallo de resolución, un error de certificado, un HTTP 403 y un panel vacío demuestran hechos distintos. BotBrowser documenta superficies del navegador basadas en perfiles y configuración de automatización, pero no garantiza acceso ni elimina las políticas del servidor. Antes de cambiar navegador, proxy o carga, identifica la última etapa respaldada por el registro de la solicitud fallida. El resultado útil puede ser un fallo localizado cuya causa del lado del servidor sigue desconocida. guía de continuidad entre ejecuciones distingue retención de cookies, cobertura de captura y aceptación del servidor tras un contexto o proceso nuevo. Ante una respuesta HTTP de estos proveedores, las señales de respuesta de Cloudflare y DataDome distinguen los marcadores documentados de las decisiones internas desconocidas.
Cuando los datos utilizables dan paso a un desafío durante el mismo trabajo, el diagnóstico de un CAPTCHA durante el scraping relaciona la última respuesta útil con el primer desafío sin convertir la secuencia en causa.
Resumen
- Identifica la solicitud fallida, no solo la página aparentemente bloqueada. El documento y su solicitud de datos pueden tener resultados diferentes.
- Distingue ausencia de respuesta HTTP y rechazo recibido. HTTP 403 o 429 sigue siendo una respuesta.
- Separa errores DNS, conexión/TLS y ejecución de página; ninguno identifica por sí solo un modelo antibot.
- Una solicitud de terminal observa otro cliente; no copia la sesión del navegador.
- Respeta el acceso documentado. Atribuye una regla solo con documentación del servicio o registros autorizados del servidor.
Contenido
- Identificar solicitud e intervalo de observación
- DNS: nombre y emisor HTTP son distintos
- Conexión y TLS: conservar el error real
- HTTP: un rechazo sigue siendo una respuesta
- Ejecución de página y aceptación de datos
- Cinco filas diagnósticas y el límite de atribución
- La configuración BotBrowser no es un veredicto del servidor
- Conclusión práctica
Identificar solicitud e intervalo de observación
Parte de un incidente autorizado: revisión de la integración, versiones de navegador y framework, función de la solicitud, hora y referencia anonimizada de ruta. Asigna un identificador opaco como requestId para vincular eventos del navegador con registros de tu servidor sin exponer credenciales. El documento principal, una solicitud de datos y una imagen no son pruebas intercambiables. Registra cuál falló y si se aceptaron los datos necesarios antes de asignar un resultado a toda la página. El modelo de seguimiento de posiciones separa ubicación, idioma o dispositivo configurados del contexto efectivo del buscador y mantiene el ordinal de la fuente aparte de la posición media de Search Console.
Por ejemplo, un documento HTTP 200 puede cargar la estructura de la aplicación mientras la solicitud de datos recibe 403. Una captura de esa estructura no identifica la solicitud rechazada. A la inversa, una imagen decorativa ausente no necesariamente invalida el registro de datos. Son ejemplos ilustrativos, no intercambios capturados. Define previamente el campo o resultado requerido y relaciónalo con la solicitud y respuesta concretas, sin juzgar la ejecución solo por su captura final.
Limita el intervalo de observación y conserva el primer fallo relevante. Los reintentos de una biblioteca no deben sustituir el evento original por un éxito posterior o un timeout genérico. Distingue solicitud no enviada, enviada sin respuesta, respuesta recibida y resultado de aplicación aceptado. Son estados propuestos para el incidente, no códigos HTTP adicionales. Un campo como lastEstablishedStage clasifica localmente; no expresa una explicación proporcionada por el servidor.
Registra los cambios entre observaciones. Si cambian a la vez proxy, versión, estado de aplicación y concurrencia, otro resultado no identifica la variable responsable. Empieza con la configuración autorizada existente, conserva el fallo e investiga una pregunta acotada. No aumentes reiteradamente el tráfico ni cambies cuentas para descubrir límites del servicio. La falta de pruebas exige mantener la causa sin resolver, no reemplazarla por una etiqueta más segura de sí misma.
DNS: nombre y emisor HTTP son distintos
El glosario DNS de MDN describe el sistema que asocia dominios con recursos como direcciones IP. El fallo de resolución precede al establecimiento de una respuesta HTTP de ese destino. Por sí solo no demuestra rechazo de la aplicación al navegador. Conserva nombre de host, contexto del resolvedor y categoría de error; una errata, un resolvedor inaccesible y una respuesta de política son posibilidades diferentes que necesitan pruebas propias.
La referencia de errores curl distingue el error 5, nombre de proxy no resuelto, del 6, host remoto no resuelto. Con proxy, un error de su extremo no demuestra que fallara el nombre del destino. Conserva el cliente y la configuración realmente usados. Una consulta correcta desde otra terminal no establece qué resolvedor usó el navegador o el proxy para la solicitud fallida.
Una dirección presente en caché tampoco equivale a observar una resolución nueva. Registra si el diagnóstico realizó una consulta, sin asumir que toda conexión correcta ejercitó DNS. Un único tiempo transcurrido no revela el estado interno del resolvedor. En un servicio propio, correlaciona registros de resolución o pasarela dentro del mismo intervalo; en uno externo, conserva el error visible y evita afirmar decisiones de infraestructura que no observaste.
El siguiente paso acotado es comprobar el nombre configurado y la ruta de resolución dentro del entorno autorizado. Conserva la entrada original antes de corregir una errata evidente. Si el problema no se reproduce fuera del navegador, describe esa diferencia sin declarar responsable a su huella. Un incidente DNS todavía no aporta pruebas sobre contenido, estado o política de una respuesta HTTP.
Conexión y TLS: conservar el error real
Resolver un nombre y establecer una conexión son observaciones distintas. Una dirección resuelta no demuestra conexión correcta con destino o proxy. El error curl 7 indica fallo de conexión y el 28 timeout de operación; este último no localiza por sí solo la etapa del protocolo. Conserva la categoría del cliente y cualquier registro específico, en lugar de llamar bloqueo del sitio a todo fallo de conexión.
El glosario TLS de MDN describe la protección de comunicaciones. Un error de validación de certificado demuestra un problema de confianza observado por ese cliente, no una respuesta HTTP de autorización. Curl distingue el error TLS 35 del error de verificación del certificado del par 60. El análisis de confianza de conexión del navegador detalla certificados y confianza; esa distinción evita presentar todo error TLS como detección de huellas.
Para un extremo diagnóstico propio o expresamente autorizado, este comando registra una observación de otro cliente. Configura primero DIAGNOSTIC_URL con la URL permitida. Hace un GET, descarta el cuerpo, mantiene la validación de certificados, limita el tiempo y no sigue redirecciones ni reintenta automáticamente. La salida es un formato propuesto, no un ejemplo de ejecución correcta:
code=0
curl --disable --silent --show-error --max-time 20 --output /dev/null \
  --write-out 'http_code=%{http_code}\ntime_namelookup=%{time_namelookup}\ntime_connect=%{time_connect}\ntime_appconnect=%{time_appconnect}\n' \
  "${DIAGNOSTIC_URL:?Set an owned or authorized diagnostic URL}" || code=$?
printf 'curl_exit=%s\n' "$code"
Los tiempos ayudan al diagnóstico; no prueban que cada etapa nombrada se ejecutara de nuevo. La reutilización de conexiones y la ruta elegida afectan su interpretación. Cookies, resolvedor, proxy y comportamiento TLS de la terminal pueden diferir del navegador. Coincidir puede corroborar un síntoma y discrepar orientar la investigación, pero ninguna cosa reproduce la sesión del navegador. Usa el mismo intervalo declarado y conserva la identidad del cliente en el registro.
No añadas una opción de certificado inseguro para aparentar éxito. En infraestructura propia, investiga validez, nombres esperados y confianza configurada con el operador responsable. Para terceros, conserva el fallo y utiliza la integración admitida. Completar TLS tampoco implica que se autorice la siguiente solicitud HTTP ni que la aplicación acepte sus datos.
HTTP: un rechazo sigue siendo una respuesta
La referencia de estados HTTP de MDN distingue clases de respuesta, incluidos errores de cliente y servidor. Un HTTP 403 observado establece que un emisor rechazó esa solicitud; no identifica detector, desajuste de huella o regla de cuenta sin más pruebas. Un 429 indica limitación de frecuencia y necesita su propia categoría. El registro de decisiones de limitación explica Retry-After opcional y planificación con presupuesto finito sin inferir la clave de recuento.
La documentación de requestfailed de Playwright distingue fallos de red y respuestas HTTP de error. Un 404 o 503 recibido es una respuesta, por lo que su estado solo no dispara requestfailed. Esto evita perder un 403 en una categoría engañosa de error de red. Instala los listeners antes de la acción autorizada y conserva por separado estado de respuesta y fallo de solicitud.
Este registrador se conecta a un Page de Playwright proporcionado. No lanza navegador, navega, reintenta ni modifica ajustes. El llamador controla emit y debe eliminar información sensible de los errores antes de conservarlos. La referencia pageerror define el evento independiente de excepción no capturada:
export function attachDiagnosticListeners(page, emit) {
  page.on('response', response =>
    emit({
      event: 'response',
      status: response.status(),
      role: response.request().resourceType(),
    })
  );
  page.on('requestfailed', request =>
    emit({
      event: 'requestfailed',
      role: request.resourceType(),
      error: request.failure()?.errorText ?? null,
    })
  );
  page.on('pageerror', error =>
    emit({
      event: 'pageerror',
      name: error.name,
    })
  );
}
Los eventos omiten deliberadamente URL y credenciales. El arnés necesita además una asociación anonimizada de solicitud y una hora para enlazarlos al incidente; el tipo de recurso no distingue varias llamadas de datos. El orden de eventos de solicitudes independientes no constituye una cadena causal. Una respuesta demuestra su llegada, no la finalización de todo el contenido ni su aceptación por la aplicación. Conserva esos resultados posteriores aparte.
Ejecución de página y aceptación de datos
La respuesta del documento no decide si la página se ejecutó correctamente. Una excepción no capturada, un recurso fallido y un campo ausente son observaciones distintas. Localiza las pruebas con pageerror, requestfailed y respuestas, y comprueba la condición de datos declarada. Una excepción puede interrumpir una operación relevante o ser ajena al resultado; su presencia no demuestra que un script antibot detuviera la recopilación.
En una fixture propia, define previamente una condición estable de disponibilidad y un registro pequeño esperado. En integraciones externas, usa el contrato de resultados documentado, no un título visible como éxito inventado. Un documento HTTP 200 puede contener inicio de sesión, error del servicio u otro estado. Conserva la clasificación del contenido junto al estado HTTP, sin reescribirlo para expresar el resultado de la aplicación.
Retén contexto suficiente para relacionar el campo ausente con su solicitud o etapa de script. La solicitud de datos pudo no enviarse, recibir rechazo o devolver datos que la página no aplicó. Cada caso requiere otra investigación. Un timeout de selector no demuestra rechazo del servidor: solo que la condición no se cumplió en el intervalo configurado. Registra la espera acotada y la condición real que se esperaba.
La comparación requiere igual revisión de aplicación, estado inicial y secuencia permitida. Si una observación comienza autenticada y otra no, la diferencia no prueba detección de navegador. Comprueba sesión u operación autorizada necesaria antes de atribuir un panel vacío a una señal del dispositivo. Excluye material privado de cuentas de los registros públicos; una referencia opaca puede enlazar el incidente con registros operativos restringidos.
Cinco filas diagnósticas y el límite de atribución
Las primeras cuatro filas describen etapas observables por el cliente. La quinta atribuye una política del servicio, incluida una supuesta regla de comportamiento; no es un quinto intercambio de protocolo visible en toda solicitud. Solo documentación del servicio, soporte autorizado o una decisión de tu servidor pueden establecer la regla de ese incidente. Una página de desafío desconocida o un resultado cambiado no sustituyen esas pruebas.
| Fila diagnóstica | Conservar | Siguiente decisión acotada |
|---|---|---|
| DNS | Cliente, nombre configurado, contexto del resolvedor y error | Comprobar la consulta; aún sin causa HTTP |
| Conexión/TLS | Referencia de ruta, error de conexión o confianza | Investigar la etapa sin desactivar la confianza |
| HTTP | Solicitud respondida, estado y cabeceras seleccionadas | Aplicar política documentada; no nombrar un detector |
| Script/datos | Excepción, resultado del recurso y campo requerido | Localizar la condición incumplida sin renombrar la respuesta |
| Política del servicio | Regla documentada o cause=unknown | Consultar al operador; parar si falta permiso |
Separa observaciones e interpretaciones en campos distintos. httpStatus=403 es observado; cause=unknown puede seguir siendo correcto aun con la respuesta localizada. «Probablemente puntuación de comportamiento» es una hipótesis sin confirmar, no un hecho. Si después aparecen pruebas de servidor sobre una regla de acceso, añade referencia y hora sin alterar el registro original del navegador.
El registro de tu servidor también debe corresponder al incidente. Correlaciona identificadores, intervalo, recurso y componente que respondió; pasarela y aplicación pueden rechazar por decisiones diferentes. La documentación general explica políticas posibles; un registro asociado explica esa respuesta particular. En terceros sin ese registro, limita la conclusión y usa acceso o soporte admitidos, sin sondear decisiones invisibles.
La configuración BotBrowser no es un veredicto del servidor
La documentación de coherencia de automatización de BotBrowser describe ajustes basados en perfiles y configuración del framework. La introducción a huellas describe superficies del motor controladas por perfiles. Son capacidades de configuración, no la explicación del servidor para un rechazo. Conserva binario, referencia de perfil y ajustes del framework sin confundir intención configurada con resultado remoto verificado.
Cambiar una superficie del navegador no demuestra por sí solo reparación DNS, confianza del certificado ni permiso de cuota para otra solicitud. Cambiar proxy altera la ruta declarada; un resultado diferente no revela la causa del rechazo original. Conserva la observación y busca pruebas en la capa localizada. Configurar un navegador no otorga autorización ni promete datos aceptados.
Preguntas frecuentes
¿Un 403 demuestra detección de huellas?
No. Es un rechazo HTTP. Identificar la regla exige pruebas del servicio o una explicación documentada para esa solicitud, no adivinar un detector.
¿Un error HTTP es un fallo de solicitud en Playwright?
No solo por el estado. Playwright distingue respuestas recibidas y fallos al obtener respuesta. Conserva ambos eventos y su asociación con la solicitud.
¿El éxito de curl demuestra que el navegador debería funcionar?
No. Curl es otro cliente con estado y configuración propios. Puede corroborar una observación, pero no reproduce la sesión del navegador.
¿Un desafío visible identifica una regla de comportamiento?
No. Conserva estado visible, respuesta y secuencia. La causa de política sigue desconocida salvo pruebas del servicio responsable.
Fuentes
- MDN: estados de respuesta HTTP
- MDN: DNS
- MDN: TLS
- curl: códigos de error
- curl: opciones de línea de comandos
- Playwright: evento requestfailed
- Playwright: evento pageerror
- BotBrowser: coherencia de automatización
- BotBrowser: introducción a huellas
- Confianza de conexión del navegador
- Decisiones de limitación del scraping
Conclusión práctica
Localiza la solicitud fallida y conserva la última etapa respaldada por pruebas. Distingue fallos DNS o TLS, rechazo HTTP y condición de datos incumplida antes de cambiar ajustes. Mantén desconocida la causa de política sin una fuente responsable que la establezca. Conserva respuesta o error e investiga esa etapa dentro de la integración autorizada, sin convertir un mensaje vago de bloqueo en un veredicto inventado de detector.
Este artículo forma parte de la guía: Panorama de configuración de proxy: mapa de decisiones de red
Artículos Relacionados
CAPTCHA durante el scraping: diagnosticar el cambio
RedCloudflare y DataDome: señales durante el scraping
RedLímites de scraping: 429, Retry-After y concurrencia
RedRotación de proxies: límites de sesión en scraping
RedDNS sobre TLS: privacidad del resolutor, despliegue y límites de fallo
RedCertificados TLS y confianza de la conexión del navegador
Ejecuta la misma comprobación en BotBrowser
Carga un perfil, mantén dentro del navegador las señales que acabas de leer y confirma el resultado en tu propia máquina antes del despliegue.