Rastreo web: presupuesto y cortesía básicos
Dimensiona un rastreo autorizado con intervalos, concurrencia, pausas y reintentos. Calcula un presupuesto finito y explica sus resultados parciales.
BotBrowser Team
Quieres la documentación estructurada de Primeros pasos?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
La capacidad de rastreo web es la cantidad de trabajo autorizado que un rastreador puede intentar dentro de una ventana definida. El tráfico que permite el sitio y los recursos sostenibles del rastreador limitan juntos esa cantidad. Añadir trabajadores no amplía el permiso concedido por el propietario, y una petición iniciada no equivale necesariamente a una página recopilada correctamente.
BotBrowser documenta contextos de navegador compartidos, límites de páginas simultáneas y supervisión de memoria para automatización autorizada. No concede el presupuesto de rastreo de un sitio, no identifica límites de peticiones no publicados ni convierte resultados parciales en completos. Sus opciones de despliegue ayudan a gestionar el navegador; el operador sigue siendo responsable del permiso, la contabilidad de peticiones y la decisión de detenerse.
TL;DR
- Acuerda el origen permitido, la ventana temporal, la unidad de cómputo y el techo de tráfico antes de dimensionar el trabajo. Una regla permisiva de robots no es autorización ni cuota numérica.
- La concurrencia mide el trabajo simultáneo; el espaciado determina cuándo pueden comenzar las peticiones. Ambas restricciones deben cumplirse entre todos los trabajadores que comparten el presupuesto aprobado.
- La aritmética de capacidad establece un límite de admisión. La variación de latencia, los fallos y la espera de la aplicación pueden reducir los resultados útiles.
- Las pausas y los reintentos consumen tiempo o asignaciones de peticiones. Conserva las URL pendientes en lugar de describir un presupuesto agotado como trabajo completo.
- Incluye las peticiones secundarias del navegador en el ámbito de tráfico que defina el propietario. Una navegación puede generar varias peticiones.
Contenido
- Dos significados del presupuesto de rastreo
- Calcular un presupuesto finito de peticiones
- Contabilizar pausas, reintentos y peticiones del navegador
- Explicar un rastreo parcial
- Dimensionar y registrar una primera ejecución autorizada
- Conclusión práctica
Dos significados del presupuesto de rastreo
Google utiliza presupuesto de rastreo para describir cuánto puede y quiere rastrear Googlebot. Su orientación para sitios grandes distingue el límite de capacidad de rastreo de la demanda de rastreo. Es una explicación de la Búsqueda de Google, incluidas sus propias decisiones sobre recursos y planificación. No es una cuota estándar que cada sitio asigne a cualquier rastreador ni una promesa de que una página rastreada se indexará.
Para un rastreador operado por el lector, parte de dos entradas distintas: qué tráfico permite el propietario y qué tráfico puede sostener el sistema de recopilación. La primera puede incluir rutas aprobadas, horarios, intervalos entre peticiones, concurrencia, límites de transferencia y operaciones prohibidas. La segunda depende del tiempo de ocupación de los trabajadores, CPU, memoria, ancho de banda y procesamiento posterior. Ambas pueden cambiar durante la ejecución; ninguna debería esconderse en una constante indocumentada llamada «velocidad segura».
El permiso debe describir el ámbito del cómputo. Una asignación podría cubrir un origen entre todos los trabajadores del proyecto, una cuenta autenticada o un recurso concreto de API. RFC 6585, sección 4 no define deliberadamente cómo identifica un servidor al usuario o cuenta las peticiones para una respuesta 429. El cliente no puede deducir un ámbito universal a partir del código. Pregunta al propietario qué tráfico comparte la asignación aprobada.
Las reglas de robots son otra entrada, no un sustituto de ese acuerdo. RFC 9309 dice expresamente que no son una forma de autorización de acceso. Una ruta permitida no implica por sí sola una petición por segundo, diez páginas simultáneas o recopilación nocturna. La ausencia de respuestas 429 tampoco demuestra que la frecuencia actual esté autorizada o sea sostenible.
La cortesía tiene así un significado operativo: respetar el ámbito acordado y la política de robots aplicable, compartir la asignación entre trabajadores y reaccionar de forma conservadora ante sobrecarga o retirada del permiso. Repartir silenciosamente el mismo trabajo entre más identidades cambia el origen del tráfico, no amplía la autorización. Si el propietario retira el acceso, detén el trabajo afectado en lugar de buscar otra vía para continuarlo.
Calcular un presupuesto finito de peticiones
Considera un catálogo hipotético propiedad del lector con una lista conocida de 900 URL HTML únicas. El propietario autoriza expresamente como máximo 1 inicio de petición por segundo entre todo el trabajo, con no más de 2 peticiones simultáneas. Supón una ventana de recopilación de 900 segundos y una ocupación local de cada plaza de petición de 0.5 segundos. Son entradas del ejemplo, no rendimiento medido ni límites deducidos de un servidor real.
En una aproximación sencilla de trabajo estable, el rendimiento local no puede superar las plazas disponibles divididas por la ocupación de una plaza. Con 2 plazas y 0.5 segundos por plaza, la aproximación da 4 inicios por segundo. La regla del propietario de 1 por segundo es más restrictiva. Tener más trabajadores de navegador preparados no permite iniciar peticiones con mayor frecuencia de la acordada.
| Entrada o cálculo | Valor hipotético | Significado |
|---|---|---|
| Conjunto de destino conocido | 900 URL únicas | Denominador de cobertura facilitado por el propietario |
| Intervalo aprobado | 1 petición/s | Techo compartido de inicios en este ejemplo |
| Techo de peticiones simultáneas | 2 peticiones | Máximo autorizado en curso |
| Ocupación local de plaza | 0.5 s | Supuesto, no prueba de rendimiento |
| Aproximación local | 2 / 0.5 = 4 peticiones/s | Techo de recursos bajo esos supuestos |
| Frecuencia limitante | min(1, 4) = 1 petición/s | Deben respetarse ambas restricciones |
La aproximación identifica la restricción limitante; no predice la hora de finalización. Supone trabajo continuamente disponible y ocupación estable. Una distribución real de latencias incluye respuestas lentas, tiempos de espera agotados y sobrecarga de conexión. Las tareas de navegador también pueden ocupar una plaza mientras esperan un estado de la aplicación. Usa observaciones de una pequeña ejecución autorizada para planificar trabajos posteriores y separa esa observación del techo permitido.
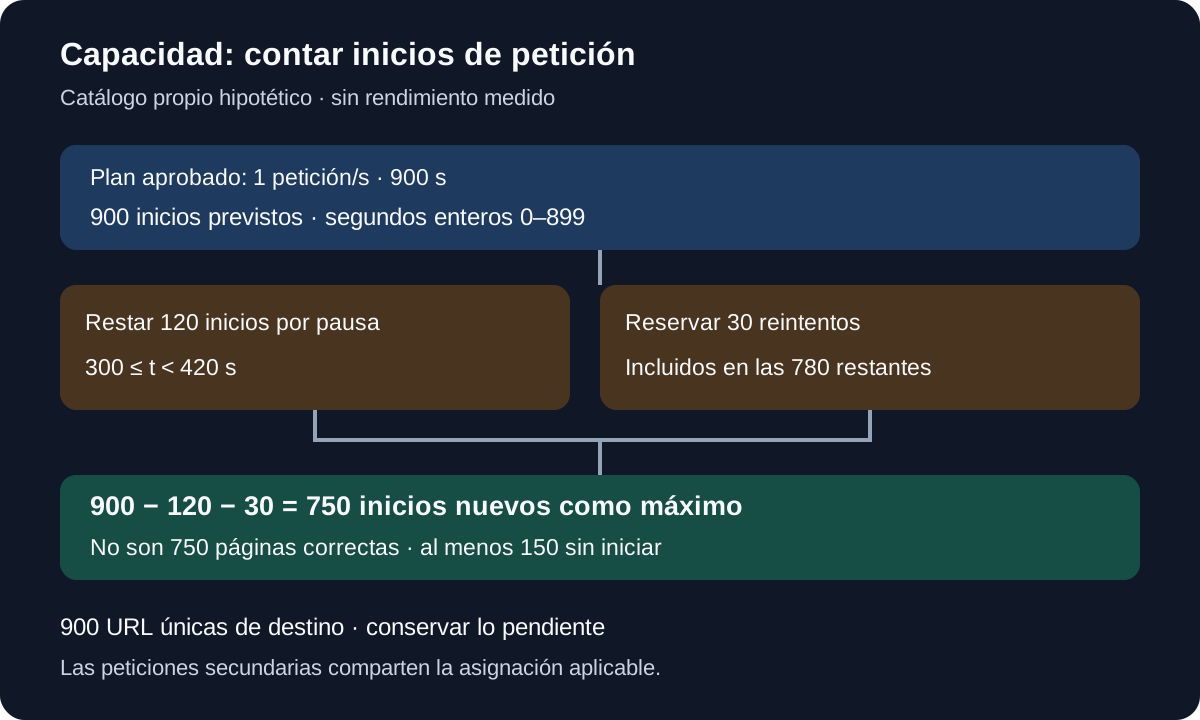
Define con precisión la programación del ejemplo: un inicio previsto en cada segundo entero desde 0 hasta 899, dentro de la ventana semiabierta que incluye 0 y excluye 900. Produce 900 oportunidades de inicio. No se permiten ráfagas; una oportunidad sin usar caduca y no se convierte en crédito acumulado. Esta convención hace reproducible el recuento; otras convenciones aprobadas requieren sus propios cálculos.
Incluso sin interrupciones, 900 oportunidades no garantizan 900 páginas terminadas antes del límite. La última petición puede terminar después de su ventana de inicio y algunas respuestas pueden fallar. Especifica si el límite prohíbe nuevos inicios, exige que cese todo el tráfico o permite que finalicen las peticiones en curso. Si se exige silencio completo al final, reserva tiempo para detener o cancelar trabajo en curso en vez de iniciar otra petición justo antes del límite.
La diferencia entre frecuencia y concurrencia importa cuando las respuestas se ralentizan. Con 1 inicio por segundo y ocupación de 0.5 segundos, el techo de 2 peticiones no limita. Si cada petición ocupa una plaza durante 3 segundos, 2 plazas no sostienen esa programación. La aproximación local pasa a 2 / 3 peticiones por segundo antes de otros costes. El planificador debe omitir o aplazar inicios sin plaza disponible; no puede ignorar la concurrencia para conservar el plan inicial.
Contabilizar pausas, reintentos y peticiones del navegador
Supón ahora que la misma ejecución hipotética pausa todos los inicios desde el segundo 300 inclusive hasta el 420 exclusivo. El intervalo elimina 120 oportunidades del plan original. El techo restante es 900 menos 120, es decir, 780 intentos. Si el operador reserva además 30 de esas oportunidades para reintentos, quedan como máximo 750 para primeros intentos de URL nuevas. Son asignaciones, no resultados comunicados por un rastreador ejecutado.
| Paso del cálculo | Oportunidades restantes | Lo que no demuestra |
|---|---|---|
| Programación original en segundos enteros | 900 | Respuestas terminadas antes del límite |
| Eliminar 120 inicios durante la pausa | 780 | Páginas de catálogo correctas |
| Reservar 30 inicios para reintentos | 750 para URL nuevas | Cobertura correcta de 750 URL únicas |
| Comparar con 900 URL de destino | Al menos 150 sin primer intento bajo esta asignación | Tasa final de éxito o resultado real |
Las 30 oportunidades de reintento están dentro del total de 780, no se suman a él. Si finalmente solo hacen falta 10, las otras 20 pueden liberarse para trabajo nuevo únicamente mientras quede tiempo admisible y lo permita la política de planificación. Una reserva rígida mantiene el techo de 750. Declara la política aplicada; no alternes silenciosamente entre presupuesto reservado y consumo real de reintentos al comparar ejecuciones.
HTTP 429 significa que el servidor considera que el cliente ha enviado demasiadas peticiones en un tiempo determinado. La referencia de estado de MDN indica que la respuesta puede incluir Retry-After. Su presencia no está garantizada. La referencia del encabezado describe un entero no negativo de segundos o una fecha HTTP. Conserva el valor recibido y la hora utilizada para interpretarlo.
Si una respuesta aplicable solicita un reintento posterior, el trabajo no debe programar las operaciones afectadas antes de ese momento. La política local puede esperar más o detener la ejecución. Un encabezado ausente o inválido no justifica un reintento inmediato; sigue el acuerdo del propietario y una recuperación conservadora y acotada. Probar repetidamente a mayor velocidad para descubrir un techo invisible no es planificación de capacidad. El análisis de frecuencia y concurrencia cubre el diagnóstico detallado; este cálculo solo necesita saber que la pausa elimina oportunidades de admisión.
El tráfico del navegador requiere otra decisión de cómputo. Una navegación puede pedir HTML, scripts, estilos, imágenes y datos de aplicación; las redirecciones y los reintentos añaden peticiones. Un límite de trabajadores por página no impone directamente un techo de inicios por origen. Si la asignación del propietario cubre todas las peticiones a ese origen, las peticiones secundarias aplicables la comparten. La automatización no debe afirmar cumplimiento solo porque espacia las navegaciones principales.
En un segundo cálculo hipotético, supón que cada página necesita exactamente 5 peticiones dentro del ámbito aprobado. Una asignación de 750 peticiones permite entonces como máximo 150 cargas antes de fallos o reintentos. No es una conversión general: la caché, los recursos variables y el sondeo en segundo plano cambian el recuento. Otro origen necesita su propia decisión de autorización y cómputo. Si el flujo no puede controlar o acotar fiablemente las peticiones relevantes, acuerda otro plan aprobado en vez de afirmar que basta un limitador de navegaciones.
Explicar un rastreo parcial
Un rastreo limitado por capacidad puede ser útil sin ser completo. Necesita un denominador honesto y conservar lo pendiente. Para el catálogo de 900 URL, registra el estado actual y el historial de intentos de cada destino. El recorrido por las etapas del rastreador distingue trabajo en cola, en curso, aplazado y terminal. Agotar la ventana es un motivo de parada, no un éxito terminal para cada URL que sigue en cola.
Separa el registro de peticiones del registro de URL. Un intento registra un envío y un resultado; una URL puede tener varios intentos. Un reintento correcto no cuenta como una segunda URL cubierta. Un intento fallido no borra que la URL continúa sin resolver. Si una redirección consume otra petición según el acuerdo, contabiliza ese tráfico sin fingir que descubrió otro elemento del catálogo correctamente recopilado.
| Estado propuesto de URL | Significado al detenerse | Consecuencia para el informe |
|---|---|---|
| Sin iniciar | No se admitió ningún primer intento | Sin cubrir dentro del conjunto conocido |
| Aplazada | Espera una hora o condición permitida | Pendiente, no una página correcta |
| En curso | Un intento no tiene resultado registrado | Finalización desconocida |
| Fallo terminal | La recuperación terminó sin contenido útil | Cobertura fallida bajo esa política |
| Resultado útil | La respuesta cumple el requisito de contenido | URL cubierta según el requisito declarado |
Son estados de aplicación sugeridos, no terminología HTTP. Define antes de ejecutar qué hace útil un resultado. HTTP 200 puede ser una pantalla de acceso, un envoltorio de error o una página sin contenido del catálogo. Una descarga puede fallar al analizarse; una página analizada puede carecer de campos necesarios para un extractor posterior. El informe debe identificar su criterio de éxito sin intercambiar estas etapas.
La cifra de 750 es un máximo de inicios de URL nuevas bajo los supuestos declarados. No aporta un numerador observado de páginas correctas. Una afirmación de planificación defendible es «al menos 150 de las 900 URL conocidas no pueden recibir un primer intento con esta asignación fija». No equivale a «se recopiló el 83 por ciento». La cobertura real requiere resultados útiles registrados, y los límites temporales o de recursos pueden dejar más de 150 URL sin iniciar.
Los rastreos por descubrimiento tienen otra limitación: el conjunto completo de URL puede ser desconocido. Informa entonces de la cobertura del conjunto admitido o facilitado por el propietario y explica cómo se obtuvo. Una cola inmediata vacía no demuestra que no existan páginas sin descubrir. Un número elevado de peticiones tampoco aporta ese denominador ausente. Conserva semillas, ámbito, exclusiones y límites de descubrimiento para explicar diferencias en ejecuciones posteriores.
Dimensionar y registrar una primera ejecución autorizada
Comienza con un subconjunto acotado y aprobado que incluya los tipos de página pertinentes. Separa la asignación de peticiones del ajuste local de trabajadores. Registra ocupación de respuestas, peticiones derivadas y memoria sin presentar una muestra pequeña como capacidad permanente del sitio. Una ventana tranquila con una página en caché puede diferir mucho de otra ejecución con datos de aplicación sin almacenar.
La documentación de rendimiento de BotBrowser describe BrowserContexts que comparten navegador, cierre de páginas sin uso, límites de páginas simultáneas y supervisión de memoria. Son opciones relevantes cuando la recopilación aprobada necesita navegador. No implementan el acuerdo de peticiones del sitio para el rastreador. Los contextos independientes siguen pudiendo compartir una asignación por origen, y aumentar su número puede presionarla más.
Usa la observación resultante para elegir una estimación conservadora de ocupación local y una porción finita de trabajo. Si los recursos no sostienen la frecuencia aprobada, reduce las admisiones previstas o amplía la ventana con aprobación. Si limita más la asignación del sitio, deja recursos locales inactivos. Ambos resultados son normales. Optimizar utilización es secundario frente al permiso y la conservación de resultados correctos.
| Registro | Motivo |
|---|---|
| Referencia del permiso, origen y rutas aprobadas | Establece el destino autorizado real |
| Ámbito de cómputo, espaciado y techo simultáneo | Define el tráfico que comparte presupuesto |
| Convención de ventana y comportamiento al terminar | Explicita supuestos de inicio y finalización |
| Pausas y política de reserva de reintentos | Explica deducciones del plan original |
| Intentos, URL útiles y URL pendientes | Separa consumo de tráfico y cobertura |
| Motivo de parada y próxima condición admisible | Hace deliberada la continuación |
Una reanudación exige comprobar de nuevo la admisibilidad. Llevar una cola aplazada a mañana no conserva automáticamente el permiso, la salud del sitio o la ventana de ayer. Verifica el acuerdo actual, conserva el historial y evita recopilar otra vez URL ya útiles salvo que actualizar sea parte del trabajo aprobado. Los trabajadores deben recibir admisión de un presupuesto común en vez de aplicar cada uno la asignación completa.
Preguntas frecuentes
¿Aumentar la concurrencia aumenta el presupuesto?
Puede elevar el techo de recursos local cuando la ocupación limita. No amplía la asignación del propietario, no elimina el espaciado ni garantiza respuestas útiles. Usa la menor restricción aplicable y contabiliza todos los trabajadores juntos.
¿Puede robots.txt fijar la frecuencia para cualquier rastreador?
RFC 9309 no define una asignación universal de frecuencia ni concede autorización. Algunas herramientas admiten convenciones adicionales, pero una directiva no compatible o una ruta permitida no autorizan una frecuencia supuesta.
¿Un rastreo pausado ha fallado?
No necesariamente. Una pausa prevista o solicitada por el servidor puede ser el comportamiento correcto. Informa de resultados útiles reales y del resto aplazado. Reinicia solo cuando lo permitan el permiso, los tiempos y los recursos aplicables.
Fuentes
- Google Search Central: presupuesto de rastreo de sitios grandes
- MDN: 429 Too Many Requests
- MDN: Retry-After
- RFC 6585: códigos de estado HTTP adicionales
- RFC 9309: protocolo de exclusión de robots
- BotBrowser: optimización del rendimiento
- BotBrowser: uso responsable
Conclusión práctica
Para un rastreo finito autorizado, registra el acuerdo de peticiones, elige la convención temporal y calcula el techo de admisión antes de seleccionar trabajadores. Descuenta pausas y reservas de reintentos; informa por separado de URL correctas, intentos y trabajo pendiente. El plan hipotético de 900 inicios deja como máximo 750 inicios nuevos tras sus deducciones; nunca demuestra 750 páginas útiles. Un rastreo menor y explicable que conserva lo pendiente permite planificar la siguiente ejecución autorizada.
Este artículo forma parte de la guía: Primeros pasos con automatización de navegador: mapa inicial
Artículos Relacionados
Qué es un rastreador web: cinco etapas del rastreo
Primeros pasosWeb crawler vs web scraper: resultados y fallos
RedLímites de scraping: 429, Retry-After y concurrencia
DespliegueScraping con robots.txt: reglas, bloqueos y fallos de acceso
Primeros pasosMejor navegador para web scraping: seis criterios
RedGestión de un pool de proxies según la carga
Ejecuta la misma comprobación en BotBrowser
Carga un perfil, mantén dentro del navegador las señales que acabas de leer y confirma el resultado en tu propia máquina antes del despliegue.