Límites de scraping: 429, Retry-After y concurrencia
Diagnostica un límite de scraping con HTTP 429 y Retry-After, distingue frecuencia de concurrencia y detén una carga autorizada antes de multiplicar los reintentos.
BotBrowser Team
Quieres la documentación estructurada de Red?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
Un límite de frecuencia de scraping es una decisión del servidor, no un ajuste de capacidad del navegador. Una respuesta HTTP 429 informa de demasiadas solicitudes durante un periodo; no identifica la clave de recuento ni autoriza otra ruta. BotBrowser documenta la configuración de proxy por navegador y por contexto, pero no modifica la cuota de un servicio ni garantiza acceso. El diagnóstico parte de la respuesta, la carga permitida y su registro de envíos, y distingue frecuencia, operaciones pendientes y tráfico de reintentos.
Cuando los datos utilizables dan paso a un desafío durante el mismo trabajo, el diagnóstico de un CAPTCHA durante el scraping relaciona la última respuesta útil con el primer desafío sin convertir la secuencia en causa.
Resumen
- Conserva HTTP 429, la hora de recepción y cualquier valor de
Retry-Afterantes de cambiar la configuración. - Considera desconocida la clave del limitador salvo que la documentación del servicio o los registros de un servidor propio la establezcan.
- La concurrencia cuenta trabajo sin terminar; la frecuencia cuenta envíos por intervalo. Una navegación puede generar varias solicitudes.
- En una instalación propia, deja de aumentar la carga al primer 429. No sondees un servicio ajeno para averiguar su límite operativo.
- Respeta tanto el límite temporal como el presupuesto de reintentos. Una solicitud aplazada puede caducar sin volver a enviarse.
Contenido
- Qué establece una respuesta 429
- Encontrar el ámbito del recuento en pruebas del servidor
- Medir frecuencia y concurrencia por separado
- Interpretar las dos formas de Retry-After
- Mantener una cola compartida y un presupuesto finito
- Conservar un registro que explique la parada
- Configuración de BotBrowser y política del servidor
- Conclusión práctica
Qué establece una respuesta 429
RFC 6585, sección 4 define 429 como respuesta de limitación de frecuencia. Puede incluir Retry-After; su ausencia no permite tráfico ilimitado. El cuerpo puede explicar la condición, pero el estado por sí solo no establece un bloqueo de cuenta, un veredicto sobre reputación IP ni una detección de huella del navegador. Separa el estado observado de esas posibles explicaciones hasta contar con pruebas de alguna. Para fallos anteriores a cualquier respuesta 429, el diagnóstico por capas del scraper bloqueado separa pruebas DNS, TLS, HTTP y datos de página.
Identifica qué solicitud recibió la respuesta. El documento principal, un endpoint de datos del mismo origen y una solicitud de recurso son registros distintos. Una navegación correcta no demuestra que la solicitud de datos funcionara; una aplicación puede mostrar una carcasa desactualizada tras limitarse sus datos. Relaciona la respuesta con el campo o registro fallido en vez de clasificar la página por su aspecto. Los requisitos de cargas SERP distinguen navegación terminada de datos aceptados, distinción útil también aquí.
Conserva la URL final sin secretos innecesarios en sus parámetros, estado, hora de recepción, cabeceras seleccionadas y función de la solicitud. Si hubo redirecciones, guarda sus estados por separado en vez de atribuir el 429 final a cada salto. Un tiempo de espera agotado sin respuesta no es un 429 observado. Una página de desafío con otro estado necesita otra categoría; llamar límites de frecuencia a ambos casos distorsiona las comparaciones posteriores.
La fuente establece un significado HTTP, no una promesa de recuperación. Alcanzar la hora sugerida no reserva capacidad ni garantiza el éxito del siguiente intento. El planificador sigue necesitando permiso para reanudar, presupuesto disponible y una operación que se pueda repetir. Conserva el registro original aunque una solicitud posterior funcione, para que un contador final de éxitos no borre el incidente.
Encontrar el ámbito del recuento en pruebas del servidor
RFC 6585 deja deliberadamente al servidor la identificación del usuario y el recuento de solicitudes. Un limitador puede aplicarse a un recurso, un servicio más amplio o una cuenta autenticada. Un solo 429 no distingue una regla por IP de una por cuenta o sesión. La referencia MDN de 429 describe un estado, no la política concreta del servidor que respondió.
En un servicio propio, examina la configuración del limitador y relaciona su registro de decisiones con el identificador de solicitud. Registra identificador de regla, grupo de recursos, ventana de medición y categoría documentada de la clave. Guarda una referencia redactada, no cookies, credenciales ni identificadores de cuenta en bruto. Si la pasarela y la aplicación limitan tráfico, identifica cuál respondió antes de atribuir su política a la otra capa.
Para una integración ajena, utiliza sus cuotas publicadas o una respuesta de soporte autorizada. Si ninguna identifica el ámbito, escribe scope=unknown. Cambiar IP, cookie o cuenta hasta obtener otra respuesta modifica varias entradas y no establece la regla original. También puede contravenir la política del servicio. Un ámbito desconocido es un resultado válido; una identidad supuesta no mejora el diagnóstico.
Separa intención de configuración y observación. Un despliegue puede pretender aislar tareas por contexto mientras el servidor las cuenta contra una cuota de cuenta compartida. La ruta proxy puede ser distinta y la sesión de aplicación seguir compartida. Registra estos hechos por separado. Ni los límites de almacenamiento del navegador ni las rutas de red certifican por sí solos la partición de cuotas o el modelo de permisos del servidor.
Medir frecuencia y concurrencia por separado
La frecuencia cuenta envíos por intervalo, por ejemplo solicitudes por segundo. La concurrencia cuenta operaciones aún pendientes. Ninguna equivale al número de pestañas abiertas. Cuenta la capa pertinente a la política: tareas de navegador, navegaciones y solicitudes HTTP pueden tener totales distintos. Una página puede pedir scripts, imágenes y datos además del documento; tareas por minuto no es un registro completo de frecuencia HTTP.
Como ilustración, 2 envíos por segundo con duración media de 3 segundos pueden mantener unas 6 solicitudes pendientes en una carga estable. Es una aproximación de planificación, no un resultado medido ni una recomendación de cuota. Ráfagas, duraciones variables y solicitudes derivadas pueden invalidarla. Conserva marcas temporales reales y recuentos de operaciones pendientes al evaluar una instalación propia, en lugar de deducirlos del número configurado de trabajadores.
inflight ≈ dispatches_per_second * mean_request_seconds
Configura por separado frecuencia de envío y techo de operaciones simultáneas. Una concurrencia de 4 no impone una frecuencia concreta: las terminaciones rápidas permiten muchos envíos en poco tiempo. A la inversa, una frecuencia baja puede acumular operaciones si las respuestas se ralentizan. Conserva antigüedad de cola, duración de respuestas, trabajo activo, reintentos enviados y registros aceptados para distinguir una cola creciente del rendimiento útil.
Escalones acotados en una instalación propia
Antes de comprobar carga, acuerda con su responsable frecuencia permitida, concurrencia máxima, duración de ventana, límites de recursos y condiciones de parada. Empieza en la base de carga baja declarada y aumenta solo por niveles previamente autorizados. Al primer HTTP 429, detén nuevos envíos, cancela trabajo no iniciado y registra la respuesta. No avances para averiguar cuánto tráfico adicional tolera el limitador. Las operaciones en curso necesitan una política explícita de cancelación o terminación porque pueden haber llegado al servidor.
El último nivel sin 429 solo es una observación de esa muestra. No es un límite estable ni permiso para operar indefinidamente a esa frecuencia. El limitador puede usar una ventana más larga o compartir cuota con otros clientes autorizados. Repite solo dentro del plan acordado y utiliza registros del servidor para interpretar el resultado. La tabla de selección de navegador trata la concurrencia sostenible como evidencia limitada a una carga, no como capacidad universal de una marca.
Interpretar las dos formas de Retry-After
HTTP Semantics, sección 10.2.3 define Retry-After como fecha HTTP o entero no negativo de segundos. La referencia MDN de Retry-After ilustra ambas formas. Analiza la cabecera antes de programar y conserva su texto original junto con la interpretación. Así no se confunde un intervalo con milisegundos ni una fecha con duración.
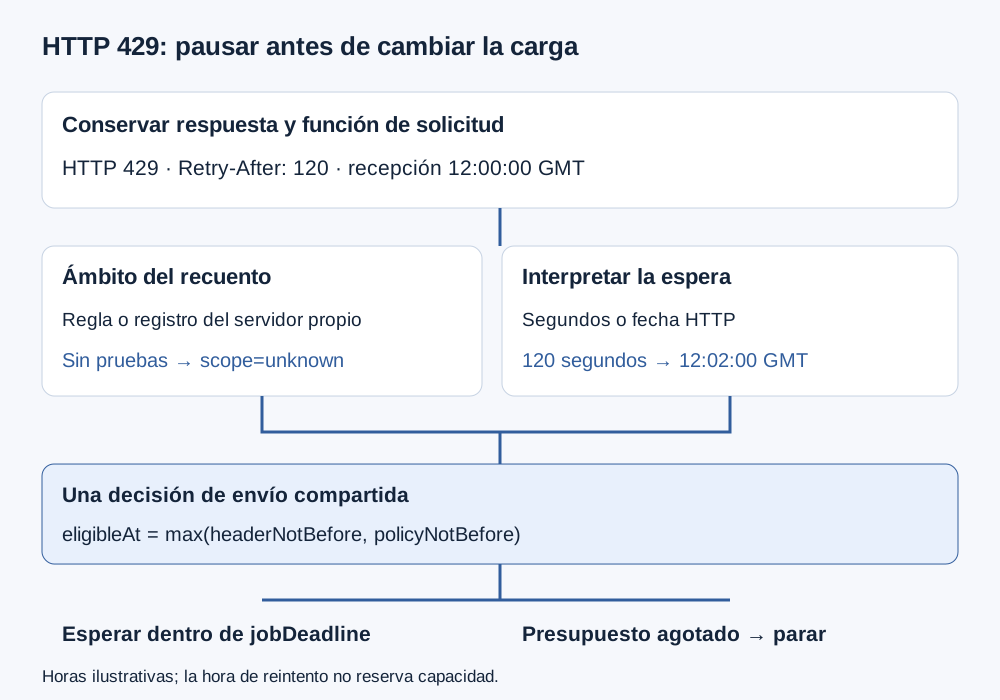
Con Retry-After: 120, el límite propuesto son 120 segundos tras recibir esa respuesta. Si la recepción es 12:00:00 GMT, el límite aritmético es 12:02:00 GMT. Son entradas ilustrativas, no un intercambio capturado. Mide desde la recepción, no desde la creación de tarea, el arranque del navegador o la lectura tardía de un trabajador. Un consumidor de registros retrasado no debería reiniciar un intervalo ya transcurrido sin indicarlo.
Retry-After: Mon, 09 Nov 2026 12:02:00 GMT indica una fecha, no una duración. La precisión del reloj importa al compararla con la hora local. Conserva la hora de recepción y Date del servidor, si existe, como entradas diagnósticas; la presencia de Date no prueba la precisión de ningún reloj. Una fecha pasada no crea una espera futura, pero tampoco autoriza un bucle de reintentos inmediato.
Utiliza una sola unidad temporal en el cálculo. Los siguientes campos son propuestas para el registro del incidente, no una API ni un algoritmo obligatorio de cabeceras. headerNotBefore es el límite interpretado; policyNotBefore, una demora más estricta de la política documentada. El plazo de tarea determina si esperar sigue siendo útil:
eligibleAt = max(headerNotBefore, policyNotBefore)
if eligibleAt > jobDeadline: stop
Si la cabecera falta, está mal formada o supera el rango numérico o de fechas admitido, conserva ese estado en vez de convertirlo silenciosamente en cero. Aplica una política establecida si existe; de lo contrario, detente para decidirla. Retry-After: 0 difiere de un valor ausente o inválido, pero ninguno justifica intentos inmediatos ilimitados. Un analizador conservador debe señalar formas no admitidas en vez de aceptar cualquier cadena parecida a una fecha mediante un analizador permisivo.
Mantener una cola compartida y un presupuesto finito
La espera independiente de cada trabajador puede sincronizar el reinicio al terminar la demora. Utiliza un despachador que controle el estado temporal del ámbito de cuota conocido, en vez de dejar que cada navegador reanude a la vez. Si el ámbito es desconocido, pausa los envíos de la integración afectada; no inventes cuotas por contexto. Es una política operativa propuesta para contener carga, no una afirmación sobre la agrupación interna del servidor.
Mantén al menos tres presupuestos independientes: plazo de tarea, intentos máximos y trabajo autorizado restante. Una solicitud puede cumplir la condición temporal y seguir siendo inadmisible por plazo vencido o intentos agotados. La cola debe producir un resultado terminal, no devolverla al principio. Conserva attemptsUsed, eligibleAt y jobDeadline en el mismo registro propuesto para poder inspeccionar la decisión.
La espera progresiva y la variación aleatoria son controles distintos. Una política documentada puede aumentar la demora tras fallos repetidos; una variación no negativa puede repartir más tarde las reanudaciones permitidas. Ninguna debe acortar una espera válida del servidor. No reduzcas 120 segundos a 10 porque el trabajador tenga menos tiempo: detén o aplaza la tarea fuera de ese trabajador. El presupuesto justifica no reintentar, no hacerlo antes.
La seguridad del reintento depende también de la operación. Una lectura y una compra no tienen las mismas consecuencias al repetirse. HTTP 429 no determina si una operación comercial anterior cambió estado. Excluye operaciones modificadoras de una cola genérica de scraping y sigue las reglas documentadas contra duplicados. Evita reintentos anidados en planificador y biblioteca sin presupuesto conjunto: una tarea visible puede generar varias solicitudes no contabilizadas.
Conservar un registro que explique la parada
El registro debe conectar respuesta HTTP y decisión de planificación. Usa un identificador opaco de ejecución, revisión de instalación o integración, versiones de navegador y paquete y referencia redactada de ruta. Registra hora, estado, función de solicitud, Retry-After original, estado de análisis, frecuencia, concurrencia y antigüedad de cola. Son campos propuestos para un diagnóstico acotado, no datos que todo navegador exponga automáticamente.
| Observación | Valor conservado | Decisión respaldada |
|---|---|---|
| Respuesta | Estado, identificador y recepción | Una solicitud concreta recibió 429 |
| Cabecera | Valor original y estado de análisis | Espera interpretada o desconocida |
| Ámbito | Regla documentada o unknown | Qué cola se pausa y por qué |
| Carga | Envíos, pendientes y reintentos | Frecuencia distinta de trabajadores |
| Presupuesto | Intentos, plazo y eligibleAt | Esperar, caducar o parar |
| Resultado | Registro aceptado o motivo terminal | Navegación no equivale a aceptación |
Separa observaciones y política. pauseReason=429 registra un evento; resumePolicy=documented-window, una regla elegida. “Probablemente IP bloqueada” pertenece, si se conserva, a hipótesis no confirmadas y no a hechos del servidor. Esa separación permite revisar después el diagnóstico sin reescribir lo que contenía la respuesta.
Mantén un historial de solicitudes para la ventana acotada. Incluye intentos fallidos en los totales aunque no produzcan registros aceptados. Cuenta por separado cancelaciones anteriores y posteriores al envío. En páginas con varios recursos, guarda su función para no confundir cambios de imágenes con cambios de extracción. Limita el contenido de respuesta conservado a lo necesario, redacta secretos y respeta la política de retención.
Tras el incidente, compara configuración efectiva y registrada antes de reanudar trabajo autorizado. Comprueba si otro proceso comparte cuota documentada, si hay una capa de reintentos duplicada y si la espera supera el tiempo restante de tarea. Son cuestiones concretas de configuración. Un navegador, ruta o contexto nuevo no merece considerarse solución solo porque después llegue una respuesta diferente.
Configuración de BotBrowser y política del servidor
La documentación de proxy de BotBrowser describe --proxy-server y configuración de rutas admitida. La documentación de proxy dinámico describe cambiar el proxy de un BrowserContext mediante una sesión CDP a nivel de navegador. Son capacidades de configuración. Ninguna establece la clave de recuento, ventana de reinicio ni frecuencia permitida de un servicio externo.
Mantén estable la ruta declarada durante el diagnóstico para que cambios ajenos no oculten la secuencia de respuestas. Registra referencias redactadas de contexto y ruta cuando la integración necesite distinguirlas. BotBrowser no garantiza que otro contexto tenga otra cuota, que cambiar ruta elimine un 429 ni que configurar el navegador conceda autorización. Un límite impuesto por el servidor sigue delimitando la carga.
Preguntas frecuentes
¿Menos trabajadores siempre implica menos solicitudes?
No. Terminaciones rápidas, recursos derivados y reintentos anidados pueden aumentar envíos incluso con menos trabajadores. Mide el recuento y el intervalo pertinentes a la política documentada.
¿Todo 429 incluye Retry-After?
No. RFC 6585 lo hace opcional. Registra la falta de instrucciones y aplica la política establecida de integración o una decisión de parada.
¿Cambiar proxy demuestra un límite por IP?
No. Un cambio de resultado no identifica la regla original. Utiliza documentación del servicio o decisiones de un servidor propio y no cambies rutas para eludir cuotas.
¿Una hora de reintento pasada garantiza éxito?
No. Es un límite temporal, no capacidad reservada ni promesa de acceso. Siguen importando permiso, seguridad de la operación y presupuesto restante.
Fuentes
- RFC 6585, sección 4: 429 Too Many Requests
- RFC 9110, sección 10.2.3: Retry-After
- MDN: 429 Too Many Requests
- MDN: Retry-After
- BotBrowser: configuración de proxy
- BotBrowser: cambio dinámico de proxy
- Requisitos de navegador para scraping SERP
- Criterios de selección de navegador
Conclusión práctica
Empieza el diagnóstico con la respuesta 429 concreta y el registro de envíos. Establece el ámbito mediante pruebas del servidor, separa concurrencia y frecuencia, y deja que el límite temporal interpretado y el presupuesto finito gobiernen cualquier reanudación autorizada. Conserva lo desconocido sin sustituirlo por conjeturas de identidad. La acción inmediata es pausar nuevos envíos y retener la respuesta antes de cambiar la carga.
Este artículo forma parte de la guía: Panorama de configuración de proxy: mapa de decisiones de red
Artículos Relacionados
CAPTCHA durante el scraping: diagnosticar el cambio
RedScraper bloqueado: errores DNS, TLS, HTTP y de página
RedRotación de proxies: límites de sesión en scraping
RedCloudflare y DataDome: señales durante el scraping
RedConmutación de proxy y continuidad visible para el usuario
DespliegueRendimiento del navegador: optimización a escala
Ejecuta la misma comprobación en BotBrowser
Carga un perfil, mantén dentro del navegador las señales que acabas de leer y confirma el resultado en tu propia máquina antes del despliegue.