Datos financieros: requisitos del navegador
Cuatro requisitos que una recolección regulada añade a un scrapeo general: sesión vinculada, verificación como cambio de estado, canal TLS registrado y auditoría.
BotBrowser Team
Quieres la documentación estructurada de Identidad?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
Recolectar datos financieros no es una versión más difícil de un scrapeo de páginas corriente; es un problema distinto, porque la fuente suele tener una cuenta, una sesión, una solicitud de verificación adicional y un acuerdo de datos detrás. BotBrowser documenta paquetes de huella por contexto y valores de navegador respaldados por perfil, de modo que una sesión de recolección puede mantenerse vinculada a una identidad declarada, pero no puede autenticarse ante una entidad financiera, no guarda credenciales, no resuelve una verificación multifactor ni sustituye a un feed con licencia. Confirme una vía autorizada antes de diseñar el trabajo.
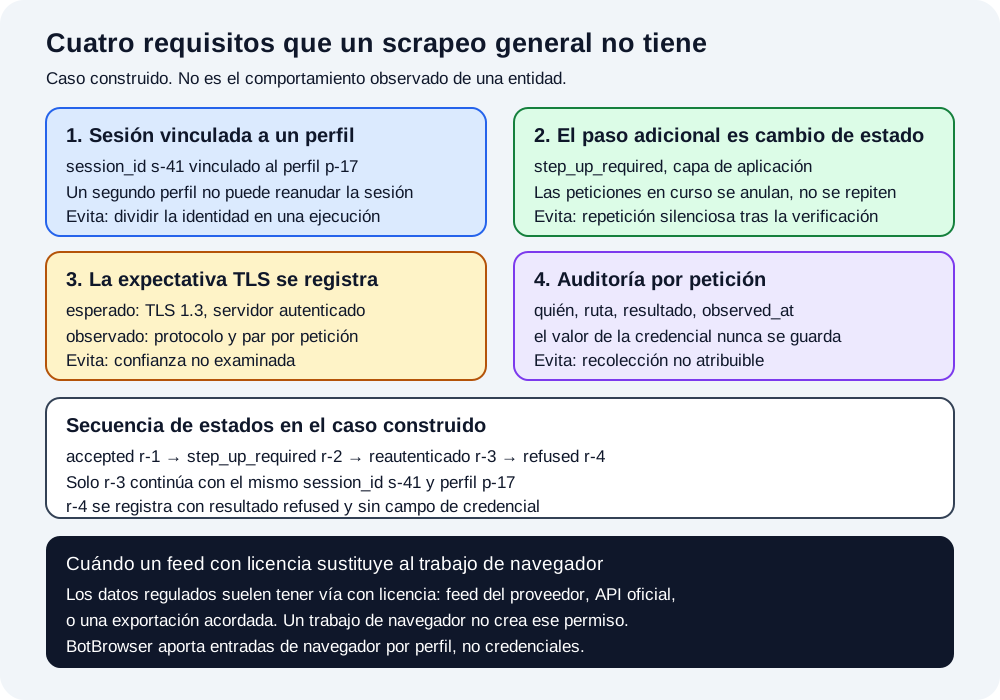
Resumen
- Los datos financieros regulados suelen tener una vía con licencia. Identifique primero el feed del proveedor, la API oficial o la exportación acordada, y trate el trabajo de navegador como respaldo que necesita su propia justificación.
- Vincule una sesión autenticada a un perfil. Una ejecución que reanuda la misma sesión bajo un segundo perfil ya perdió la capacidad de decir quién era.
- Una verificación adicional es una transición de estado. Las peticiones en curso anteriores a la verificación quedan anuladas, no son reintentables.
- Registre la expectativa TLS en la que se apoya y las propiedades del canal que realmente observó. «Se conectó» no es una afirmación de auditoría.
- Mantenga un registro de auditoría por petición que nombre la ruta, el resultado y la hora, y que nunca guarde el valor de la credencial.
Contenido
- Cuatro requisitos que un scrapeo general no tiene
- Vincular una sesión a un perfil
- Tratar la verificación adicional como cambio de estado
- Registrar la expectativa TLS y el canal observado
- Construir el registro de auditoría por petición
- Cuándo el feed con licencia es la respuesta
- Conclusión práctica
Cuatro requisitos que un scrapeo general no tiene
Un scrapeo de páginas corriente se describe con una URL, un analizador y una periodicidad. Un trabajo de datos regulados además tiene que responder quién era, qué se le permitía hacer y qué ocurrió cuando la fuente lo interrumpió. Esas preguntas no aparecen en una lista de comprobación genérica, y omitirlas produce un conjunto de datos que nadie puede defender después.
| Requisito | Falla que evita | Campo del registro |
|---|---|---|
| Sesión vinculada a un perfil | Una sesión reanudada en silencio bajo una segunda identidad | session_id, profile_id |
| Paso adicional como cambio de estado | Peticiones en curso repetidas tras exigir la fuente una verificación | auth_state, voided_at |
| Expectativa TLS registrada | La suposición no examinada de que el canal estaba autenticado | expected_channel, observed_channel |
| Auditoría por petición | Recolección no atribuible a una ejecución autorizada | request_id, outcome, observed_at |
Cada fila tiene detrás una falla concreta, no un principio general. La primera evita que una ejecución divida su identidad a mitad de camino. La segunda evita que un cliente trate una verificación como un error transitorio que merece reintento. La tercera evita que «la petición tuvo éxito» sustituya a «el canal era el que suponía». La cuarta evita un conjunto de datos cuya procedencia solo existe en la memoria de alguien sobre la ejecución.
Vincular una sesión a un perfil
MDN describe la cabecera Authorization como un modo de que un agente de usuario aporte credenciales que lo autentican ante un servidor, normalmente después de que el servidor respondiera a una petición inicial con 401 Unauthorized y una cabecera WWW-Authenticate. Esa descripción trata de un intercambio de una petición y una respuesta. Una sesión de recolección es un objeto más largo: abarca muchas peticiones, puede estar ligada a una cookie o a un token, y el servidor decide si sigue siendo válida.
La consecuencia para un trabajo de navegador es que la sesión y la identidad del navegador tienen que quedar vinculadas y registradas juntas. Si una ejecución empieza bajo un perfil, encuentra un problema y se reanuda bajo otro, los datos resultantes provienen de una sesión cuya identidad declarada cambió a mitad de vuelo. Aunque cada petición individual tuviera éxito, la ejecución ya no puede responder quién era.
El análisis de continuidad de sesión separa la retención en el cliente de la aceptación en el servidor: conservar una cookie no es lo mismo que el servidor la respete. Esa distinción importa más aquí, porque una fuente financiera suele ligar la sesión a más que una cookie. Registre la vinculación de forma explícita, como un par, y rechace continuar cuando cambie cualquiera de las dos mitades.
La documentación de BotBrowser sobre contexto por huella describe la asignación de un paquete de huella a un BrowserContext, y cada contexto lleva su propio archivo de perfil, agente de usuario, zona horaria, configuración regional y proxy. Ese es el mecanismo con el que un trabajo de recolección puede mantener estable la identidad declarada de un contexto durante toda una sesión. Es una entrada del lado del navegador; no autoriza la sesión y no indica si el servidor todavía la considera válida.
Dos hábitos operativos hacen que la vinculación sobreviva a una ejecución real. El primero es asignar el identificador de sesión antes de crear el contexto y negarse a crear un segundo contexto para la misma sesión. Ese orden importa porque un contexto creado primero aceptará sin problema una sesión que ya existe en otro lugar, y el duplicado solo se descubre cuando la fuente invalida uno de los dos. Asignar primero convierte una invalidación tardía y confusa en un error inmediato y local.
Un registro de perfil con proxy rotativo cubre la misma disciplina de asignación para un cambio de ruta, y un recorrido de passkey muestra por qué la credencial y la sesión que abre deben seguir siendo objetos separados. El segundo hábito es registrar la vinculación en el momento en que se hace, en lugar de reconstruirla después desde los registros. Un asiento escrito al asignar puede incluir el identificador de ejecución, el del perfil y los argumentos de lanzamiento del contexto, que son exactamente los hechos que un revisor necesita y exactamente los más difíciles de recuperar. Reconstruirlos desde un registro significa cruzar marcas de tiempo entre dos sistemas, y ese cruce falla precisamente cuando ocurre el caso interesante.
La vinculación también tiene un lado de terminación. Cuando una ejecución acaba, el contexto debe cerrarse y la sesión marcarse como cerrada en el mismo registro. Una sesión que queda abierta en la contabilidad mientras su navegador ya no existe acabará siendo reanudada por una ejecución posterior que cree estar continuando algo, y los datos resultantes abarcarán dos identidades distintas sin decirlo. Cerrar ambas mitades juntas es una disciplina pequeña que elimina toda una clase de preguntas de procedencia.
Por último, distinga la vinculación de la credencial. La vinculación afirma qué perfil llevó una sesión. La credencial es el material que prueba la sesión. Un registro de ejecución puede llevar la primera sin riesgo y nunca debería llevar la segunda, porque la primera es un identificador y la segunda un secreto. Mantener esa línea explícita en el esquema evita que una función posterior, como una exportación de depuración, envíe credenciales a un conjunto de datos por accidente.
Tratar la verificación adicional como cambio de estado
Una verificación adicional es el punto en el que la fuente pide más pruebas de las que la sesión lleva en ese momento. Es habitual en interfaces financieras y con frecuencia se maneja mal en código de recolección, porque llega como una respuesta HTTP de aspecto corriente.
RFC 8446 describe el canal TLS y sus propiedades de autenticación, incluida la de que el lado servidor siempre se autentica mientras el cliente es opcional. Una verificación adicional está en otra capa: es una exigencia de aplicación de que el cliente vuelva a probar algo. Las dos se confunden con facilidad cuando ambas aparecen durante una misma petición fallida, y el error lleva a un código que reintenta la petición en lugar de cambiar el estado de la sesión.
El modelo de estados siguiente es construido, no observado en ninguna entidad. Existe para hacer explícita la transición y que un cliente no pueda continuar en silencio.
| Evento | Estado de la sesión tras el evento | Qué ocurre con el trabajo en curso |
|---|---|---|
| Petición aceptada | authenticated | Continúa |
| Se devuelve una verificación | step_up_required | Anulado; cada petición se reclasifica por separado |
| Se completa la reautenticación | authenticated de nuevo | Solo trabajo nuevo; lo anulado no se repite |
| Petición rechazada por política | refused | Se registra como resultado, no se reintenta |
La tercera fila es la que más se equivoca en código de recolección. Tras la reautenticación la sesión vuelve a ser utilizable, lo que tienta a repetir todo lo que falló durante la verificación. Esas peticiones se hicieron bajo un estado que la fuente ya había rechazado, así que repetirlas produce observaciones que no pueden atribuirse a la autorización actual. Anúlelas, registre la anulación y empiece trabajo nuevo.
La cuarta fila cubre el caso en que la fuente rechaza por motivos de política en lugar de pedir más pruebas. Eso no es una falla técnica y reintentar no lo cambiará. Registre el rechazo con su motivo, detenga la ejecución y vuelva a la pregunta de la vía autorizada en lugar de tratarlo como un error transitorio.
Una verificación también tiene una dimensión temporal que la tabla de estados no recoge. Las peticiones emitidas antes de la verificación pueden haber sido aceptadas por la fuente, y sus respuestas pueden seguir en vuelo cuando llega la verificación. Esas respuestas no son inválidas por llegar tarde; son inválidas como evidencia sobre el estado actual, porque el estado al que pertenecen ya no existe. El cliente debe clasificar cada una por el estado bajo el que se emitió, no por el que prevalece cuando termina.
Esa regla tiene una consecuencia práctica para el procesamiento por lotes. Un trabajo que despacha cien peticiones y luego procesa los resultados por orden de finalización mezclará observaciones de dos estados sin ninguna marca. Un trabajo que despacha en grupos acotados y comprueba el estado entre grupos mantiene visible la frontera. El tamaño del grupo es una decisión de rendimiento, pero la comprobación de la frontera es una decisión de corrección y no debería relajarse para ahorrar un viaje.
La política de reintentos pertenece al mismo modelo. Un tiempo de espera agotado bajo un estado authenticated puede reintentarse razonablemente una vez con un nuevo identificador de petición, porque el estado no cambió. Un tiempo agotado durante step_up_required no puede, porque el reintento llevaría una petición a un estado que la fuente ya rechazó. Escribir esa distinción en la función de reintento, y no en la prosa que la rodea, es lo que mantiene el modelo cierto después del siguiente refactor.
Registrar la expectativa TLS y el canal observado
Las expectativas TLS en un trabajo de datos regulados las suele enunciar la contraparte, no el cliente. La tarea del cliente es registrar en qué se apoyaba y qué vio realmente, para que un revisor posterior pueda decir si coincidieron.
El análisis de confianza en la conexión cubre la validación de certificados y las señales que el navegador expone sobre una conexión. Lo que un trabajo de recolección necesita por encima de eso es mucho menos: una expectativa declarada, un valor observado y una regla de decisión para cuando discrepen. La expectativa puede ser una versión de protocolo, la exigencia de que el servidor esté autenticado o una política concreta de la contraparte. El valor observado es lo que el cliente pueda leer realmente para esa petición.
Dos modos de fallo merecen nombrarse porque ambos parecen éxito. El primero es una degradación silenciosa: la conexión se completa, los datos llegan y nadie comprueba si el canal negociado era el que el acuerdo suponía. El segundo es un error de alcance: un operador verifica el canal una vez al inicio y luego supone que se mantuvo en cada petición posterior. Registre por petición, o como mínimo por conexión con una frontera explícita, y declare cuál de las dos hizo.
// Constructed fixture: four requests in one run, one channel expectation.
const EXPECTED_CHANNEL = { protocol: 'TLSv1.3', serverAuthenticated: true };
const RUN = { runId: 'run-7', sessionId: 's-41', profileId: 'p-17' };
const requests = [
  {
    requestId: 'r-1',
    route: 'positions',
    protocol: 'TLSv1.3',
    serverAuthenticated: true,
    outcome: 'accepted',
    observedAt: '2026-11-10T09:00:00Z',
  },
  {
    requestId: 'r-2',
    route: 'balances',
    protocol: 'TLSv1.3',
    serverAuthenticated: true,
    outcome: 'step_up_required',
    observedAt: '2026-11-10T09:00:04Z',
  },
  {
    requestId: 'r-3',
    route: 'balances',
    protocol: 'TLSv1.3',
    serverAuthenticated: true,
    outcome: 'accepted',
    observedAt: '2026-11-10T09:03:10Z',
  },
  {
    requestId: 'r-4',
    route: 'statements',
    protocol: 'TLSv1.2',
    serverAuthenticated: true,
    outcome: 'refused',
    observedAt: '2026-11-10T09:03:12Z',
  },
];

const rows = requests.map(r => ({
  request_id: r.requestId,
  run_id: RUN.runId,
  session_id: RUN.sessionId,
  profile_id: RUN.profileId,
  route: r.route,
  outcome: r.outcome,
  observed_at: r.observedAt,
  channel_matches:
    r.protocol === EXPECTED_CHANNEL.protocol && r.serverAuthenticated === EXPECTED_CHANNEL.serverAuthenticated,
}));

const lines = rows.map(
  r =>
    `request_id=${r.request_id} run_id=${r.run_id} session_id=${r.session_id} profile_id=${r.profile_id} ` +
    `route=${r.route} outcome=${r.outcome} channel_matches=${r.channel_matches} observed_at=${r.observed_at}`
);
console.log(lines.join('\n'));
La salida construida registra una petición aceptada, una transición de verificación, una continuación aceptada y una petición rechazada, y muestra que r-4 diverge en el canal:
request_id=r-1 run_id=run-7 session_id=s-41 profile_id=p-17 route=positions outcome=accepted channel_matches=true observed_at=2026-11-10T09:00:00Z
request_id=r-2 run_id=run-7 session_id=s-41 profile_id=p-17 route=balances outcome=step_up_required channel_matches=true observed_at=2026-11-10T09:00:04Z
request_id=r-3 run_id=run-7 session_id=s-41 profile_id=p-17 route=balances outcome=accepted channel_matches=true observed_at=2026-11-10T09:03:10Z
request_id=r-4 run_id=run-7 session_id=s-41 profile_id=p-17 route=statements outcome=refused channel_matches=false observed_at=2026-11-10T09:03:12Z
Esa fila es la razón de ser del registro. Una petición aceptada sobre un canal que el trabajo no esperaba no es una observación limpia, y el conjunto de datos debe poder mostrarlo sin que nadie relea registros.
Decidir qué hacer con una fila discrepante es una cuestión de política, y debería responderse antes de la primera ejecución y no durante un incidente. Hay tres opciones defendibles: rechazar la fila y detenerse, aceptarla marcándola para que el análisis posterior pueda excluirla, o aceptarla y registrar la discrepancia como aviso. La elección correcta depende de lo que diga el acuerdo con la contraparte, y por eso la decisión pertenece a la base escrita de la ejecución y no al código que notó la discrepancia.
El mecanismo de observación también necesita una limitación declarada. Un script a nivel de página no puede leer el protocolo negociado de su propia conexión; el valor tiene que venir de la instrumentación de red del navegador o del cliente que hizo la petición. Registrar un campo de canal rellenado por una suposición es peor que dejarlo vacío, porque un campo vacío provoca una pregunta mientras uno supuesto la cierra. Cuando el valor no está disponible de verdad, registre que no lo estaba y por qué.
La deriva de versiones es la última pieza. Una ejecución que dura semanas puede ver cómo la contraparte cambia sus protocolos admitidos, y una expectativa escrita al principio se volverá incorrecta poco a poco. Ate la expectativa a una fecha y vuelva a comprobarla cuando se amplíe la ejecución. Una expectativa sin fecha se lee como si siguiera vigente, y esa es la misma falla de degradación silenciosa en una forma más lenta.
Construir el registro de auditoría por petición
Un registro de auditoría responde cuatro preguntas por petición: qué ejecución la hizo, bajo qué identidad, qué devolvió la fuente y cuándo. Todo lo demás es detalle de apoyo. El registro siguiente es un artefacto de aplicación y deliberadamente no lleva ningún valor de credencial.
| Campo | Contenido | Por qué está en el registro |
|---|---|---|
request_id | Identificador opaco de esta petición | Une el registro con una línea de traza sin exponer contenido |
run_id | Identificador de la ejecución autorizada | Atribuye la petición a un permiso |
session_id | Identificador de sesión, nunca un token | Muestra la identidad que hizo la petición |
profile_id | Perfil con el que se lanzó el contexto | Muestra la identidad declarada del navegador |
route | Clase de punto final, no la cadena completa | Describe la petición sin guardar parámetros |
outcome | accepted, step_up_required, refused | Hace explícita la transición de estado |
observed_at | Hora en UTC | Ordena las peticiones y acota la ejecución |
channel | Protocolo y resultado de autenticación | Registra a qué se resolvió la expectativa TLS |
Dos campos merecen una nota. session_id no es el token. Guardar un token de portador en una tabla de auditoría convierte el rastro de auditoría en un almacén de credenciales, que es un problema peor que el que el registro quería resolver. Registre un identificador opaco y un hash si necesita comparar dos registros de la misma sesión. El mismo razonamiento se aplica a route: registre la clase de punto final en lugar de una URL completa con parámetros de consulta, porque esos parámetros suelen llevar identificadores de cuenta o de instrumento que la auditoría no necesita.
El ciclo de vida de sesión en estaciones compartidas aplica una regla relacionada a la reutilización entre usuarios: el registro de quién sostuvo una sesión importa tanto como la sesión. Un trabajo de recolección con un perfil por ejecución es más simple, pero sigue necesitando la misma atribución.
El registro también necesita una decisión de retención separada de la ejecución. Un rastro de auditoría que se borra con los datos de trabajo no puede responder una pregunta hecha un trimestre después, y uno que se guarda para siempre acumula datos personales que el trabajo nunca necesitó. Decida el periodo de retención a partir del acuerdo y de la pregunta que el registro debe responder, escríbalo y haga del borrado una acción programada explícita en lugar de un accidente de limpieza.
El acceso al registro de auditoría es una segunda decisión. Con frecuencia contiene identificadores de cuenta y clases de punto final que, juntos, describen la actividad de un cliente con más detalle que el propio conjunto de datos. Restríjalo a quienes necesitan responder preguntas de procedencia, y registre también las lecturas del rastro, no solo las escrituras. Un sistema de procedencia que no puede decir quién lo inspeccionó tiene la misma debilidad que quería eliminar. La verificabilidad no es autorización: un registro de auditoría muestra que una ejecución ocurrió y no se editó después, y no prueba que la ejecución estuviera permitida.
Por último, haga verificable el registro. Un registro con cadena de hashes, o con un resumen periódico escrito en algún lugar independiente del escritor, puede mostrar que no se editó después. Esa propiedad importa sobre todo en la situación para la que existe el registro: una disputa sobre lo que hizo una ejecución. Una tabla simple es mejor que nada, pero una tabla que el escritor puede reescribir en silencio es evidencia más débil de lo que su contenido sugiere.
Cuándo el feed con licencia es la respuesta
La mayoría de los datos financieros regulados tiene una vía que no implica un navegador. Un proveedor de datos de mercado, una API oficial, una exportación agregada o un feed contractual dan los mismos valores con un esquema definido, una cadencia de actualización declarada y una licencia que dice qué puede hacer con ellos. Cuando existe una de esas vías, un trabajo de navegador suele ser el instrumento equivocado: produce un conjunto menos estable, con más exposición legal, para una fuente que ya ofrecía un camino soportado.
La regla de decisión honesta no es por tanto «¿puede llegar un navegador?» sino «¿existe una vía autorizada y, si no, qué autoriza específicamente esta?». Si la respuesta a la segunda mitad es el recuerdo de alguien sobre un correo, eso no es una autorización. Escriba la vía y su base en el registro de la ejecución para que la siguiente persona herede la respuesta en lugar de la suposición.
El tipo FinancialProduct de schema.org ilustra bien la frontera. Define un vocabulario para describir un producto financiero, con propiedades como annualPercentageRate e interestRate, y señala que la tasa anual equivalente difiere del tipo de interés calculado. Ese vocabulario dice cómo nombrar campos; no dice si una fuente los publica, si un valor publicado está vigente ni si usted puede recolectarlo.
Preguntas frecuentes
¿Un inicio de sesión correcto significa que la recolección está autorizada?
No. La autenticación establece quién es la sesión, no qué puede hacer el operador con los datos. La autorización viene de los términos de la entidad o de un acuerdo aparte, y una sesión que funciona no sustituye a ninguno.
¿Puede continuar la misma sesión tras una verificación adicional?
Puede, una vez completada la reautenticación, pero el trabajo realizado durante la verificación no forma parte de esa continuación. Anule esas peticiones, registre la anulación y empiece trabajo nuevo bajo el nuevo estado.
¿Debe el registro de auditoría guardar el token de acceso?
No. Guarde un identificador de sesión opaco y, si hace falta, un hash. Un token en una tabla de auditoría convierte el rastro en un almacén de credenciales.
¿BotBrowser se autentica ante una entidad financiera?
No. Proporciona entradas de navegador documentadas respaldadas por perfil, incluidos paquetes de huella por contexto, para que una sesión se mantenga vinculada a una identidad declarada. Las credenciales, las verificaciones y las licencias de datos quedan fuera de su alcance.
Fuentes
- Cabecera Authorization en MDN
- RFC 8446 TLS 1.3
- schema.org FinancialProduct
- Huella por contexto en BotBrowser
- Panorama de huellas en BotBrowser
Conclusión práctica
Empiece por la vía autorizada. Si existe un feed con licencia o una API oficial, úselos y mantenga el trabajo de navegador fuera del diseño. Cuando el trabajo de navegador sea la vía soportada, vincule una sesión a un perfil, modele la verificación adicional como una transición que anula el trabajo en curso, registre la expectativa TLS junto al canal observado para cada petición y mantenga un registro de auditoría que nombre la ejecución, la identidad, el resultado y la hora sin guardar credenciales. Esos cuatro requisitos son lo que hace defendible un conjunto de datos regulados después de que la ejecución haya terminado.
Este artículo forma parte de la guía: Superficies de identidad del navegador: panorama de coherencia
Artículos Relacionados
CAPTCHA durante el scraping: diagnosticar el cambio
IdentidadPasskeys y WebAuthn: el recorrido de inicio de sesión en el navegador
RedCloudflare y DataDome: señales durante el scraping
RedRotación de proxies: límites de sesión en scraping
DespliegueScraping de Amazon: datos y límites del navegador
RedScraper bloqueado: errores DNS, TLS, HTTP y de página
Ejecuta la misma comprobación en BotBrowser
Carga un perfil, mantén dentro del navegador las señales que acabas de leer y confirma el resultado en tu propia máquina antes del despliegue.