curl-impersonate y curl_cffi: límites de paridad TLS
Tres clientes y un socket de escucha: qué iguala un cliente HTTP que suplanta TLS, por qué difiere en una extensión y qué capa de página nunca alcanza.
BotBrowser Team
Quieres la documentación estructurada de Huella digital?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
Un cliente HTTP puede configurarse para enviar un apretón de manos muy parecido al de un navegador, y el parecido termina en la primera superficie que necesita un documento. BotBrowser ofrece un perfil declarado que mantiene coherentes entre sí las superficies que una página puede leer, incluidas las visibles desde JavaScript, y no sustituye a un navegador cuando hace falta un documento. La medición reúne tres clientes contra un mismo socket de escucha local: el binario curl, un cliente Python que suplanta a Chrome y Chrome. La diferencia entre los dos últimos es la parte útil, porque es lo bastante pequeña para pasar inadvertida.
TL;DR
- Tres clientes enviaron tres apretones de manos distintos al mismo socket de escucha: curl
t13i4906h2, Nodet13i521000, Chromet13d1517h2. - Un cliente al que se pidió suplantar a Chrome produjo
t13d1516h2, que coincide con Chrome en el número de cifrados y difiere en una extensión. - La diferencia de extensión es lo interesante: una coincidencia casi exacta que omite una sola extensión sigue siendo un valor distinguible.
- La
ifrente a laden esos prefijos es el indicador de nombre de dominio; conectar por dirección y conectar por nombre son dos huellas distintas. - curl en esta máquina enlaza SecureTransport y no OpenSSL, así que sus conjuntos de cifrados y extensiones vienen de una biblioteca TLS distinta de la que suponen la mayoría de las guías.
- Un cliente HTTP no tiene DOM, ni canvas, ni WebGL, así que toda señal derivada de esas superficies simplemente falta en lugar de estar desalineada.
- Fijar una cabecera de user agent cambia lo que lee el servidor y no cambia lo que dice el apretón de manos.
- Igualar la capa de conexión e igualar la capa de página son dos trabajos separados con dos cajas de herramientas separadas.
Contenido
- Tres clientes en un mismo socket de escucha, y qué iguala la suplantación
- La biblioteca subyacente decide el valor
- La capa que un cliente HTTP no tiene
- Qué cuesta una coincidencia casi exacta, y la conclusión práctica
Tres clientes en un mismo socket de escucha, y qué iguala la suplantación
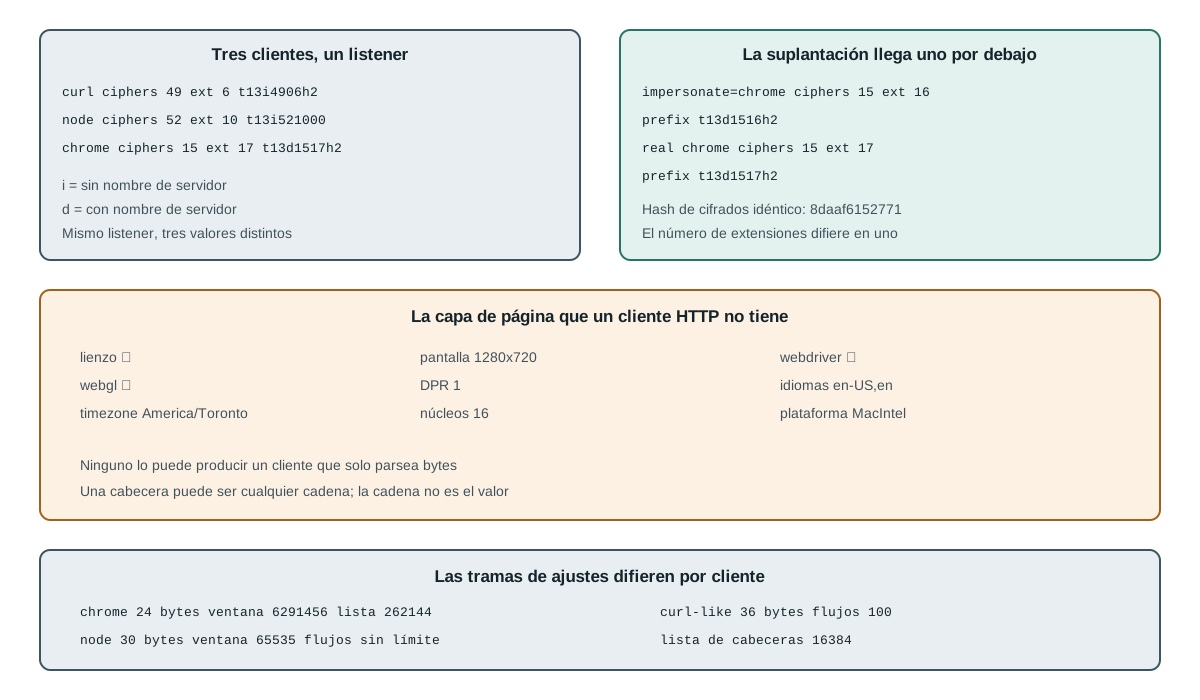
La medición es deliberadamente pequeña. Un socket de escucha TCP en la interfaz de loopback acepta una conexión, registra el primer registro y cierra; el apretón de manos nunca se completa, así que no interviene ningún certificado de servidor ni ninguna decisión de confianza. Cada cliente apunta a esa dirección por turno.
curl:   bytes=301  alpn=h2,http/1.1 ciphers=49 exts=6  versions=0x0304,0x0303,0x0302,0x0301
        ja4=t13i4906h2_0d8feac7bc37_7395dae3b2f3
node:   bytes=1566 alpn=(none)     ciphers=52 exts=10 versions=0x0304,0x0303
        ja4=t13i521000_b262b3658495_8e6e362c5eac
chrome: bytes=1917 alpn=h2,http/1.1 ciphers=15 exts=17 versions=0x0304,0x0303
        ja4=t13d1517h2_8daaf6152771_cb7bf5808d99
Leer los tres valores en paralelo muestra de inmediato la forma del problema. Difieren en tres posiciones independientes: el número de cifrados, el número de extensiones y la etiqueta de protocolo. Un cliente que solo corrige las dos primeras sigue anunciándose en la tercera, y uno que no corrige ninguna se separa sin esfuerzo.
La entrada de Node dice 521000 en sus recuentos, y los últimos cuatro caracteres son 1000 en lugar de una etiqueta de protocolo. Eso ocurre porque una conexión TLS de Node sin configuración adicional no ofrece ningún protocolo, así que la etiqueta cae a ceros mientras los recuentos continúan. Un cliente HTTP que nunca negocia HTTP/2 tiene por tanto una huella que lo declara, sin que intervenga ninguna lógica de detección.
La i de los dos primeros valores frente a la d de Chrome es el indicador de nombre de dominio. curl y Node apuntaban a una dirección sin nombre en esta ejecución y no enviaron server name; Chrome apuntaba a un nombre. Ese único carácter no es un juicio sutil sobre la intención, es una declaración sobre lo que el cliente puso en el mensaje. Apuntar curl y el cliente con suplantación a un nombre de host en lugar de a una dirección cambió sus marcas a d y subió en uno el recuento de extensiones, así que la marca y el recuento son dos lecturas de la misma decisión. Node no siguió el mismo camino: se quedó en t13i521000 con diez extensiones hasta que se pasó servername de forma explícita, y entonces pasó a t13d521100 con once. La biblioteca decide si el nombre viaja, y quien llama decide si se lo dice a la biblioteca.
curl-impersonate y curl_cffi funcionan reemplazando o reconfigurando la capa TLS y HTTP/2 para que los bytes se parezcan a los de un navegador elegido. La afirmación es limitada y conviene probarla en lugar de darla por supuesta, así que se usó el mismo socket de escucha con un cliente Python al que se pidió suplantar a Chrome:
default: bytes=517  ciphers=28 exts=12 alpn=h2,http/1.1
         ja4=t13d2812h2_257f3020b3a2_cbb9361b6bf9
chrome:  bytes=1815 ciphers=15 exts=16 alpn=h2,http/1.1
         ja4=t13d1516h2_8daaf6152771_d8a2da3f94cd
La segunda línea es el resultado que importa. Al pedirle que suplantara a Chrome, el cliente produjo quince cifrados y dieciséis extensiones, y su conjunto de cifrados con hash 8daaf6152771 es idéntico al del navegador real. En el eje de cifrados la suplantación es exacta.
El recuento de extensiones no lo es. Chrome envió diecisiete y el cliente que suplanta envió dieciséis, así que los prefijos dicen t13d1516h2 frente a t13d1517h2. Un dígito de diferencia, y ese dígito es justo el tipo de diferencia para el que se guarda un valor.
No es una crítica a ninguno de los dos proyectos. Un navegador incluye extensiones que una biblioteca cliente no tiene motivo para enviar, y reproducir la lista completa obligaría a seguir un objetivo móvil sin ganancia funcional. El punto es más concreto: una coincidencia casi exacta no es una coincidencia, y una comparación que solo revisa la primera parte del hash informará éxito donde el prefijo ya discrepa.
La biblioteca subyacente decide el valor
Los números de curl al inicio de la medición parecen inusuales por un motivo que no tiene nada que ver con la suplantación. La compilación local informa su motor TLS:
curl 8.7.1 (x86_64-apple-darwin24.0) libcurl/8.7.1 (SecureTransport) LibreSSL/3.3.6 zlib/1.2.12 nghttp2/1.64.0
curl_has_http2=true
SecureTransport, no OpenSSL. Un curl compilado contra SecureTransport toma su lista de cifrados y su conjunto de extensiones de esa biblioteca, así que su huella es una propiedad de la compilación y no del programa curl. Dos máquinas con la misma versión de curl y motores distintos producen valores distintos, y ninguno está mal.
Eso tiene una consecuencia práctica para quien compara huellas en un parque de equipos. Registrar "curl" como cliente no basta, porque no nombra la biblioteca TLS, y la biblioteca es lo que describe el valor. El mismo razonamiento vale para los clientes que suplantan: la versión de la biblioteca subyacente importa más que la versión del envoltorio.
Una segunda trama muestra la misma separación en la capa HTTP/2. La conexión se abre con una trama de ajustes, y las entradas de esa trama forman parte de lo que un par ve antes de que exista cualquier solicitud:
chrome_like: bytes=24 HEADER_TABLE_SIZE=65536 ENABLE_PUSH=0 INITIAL_WINDOW_SIZE=6291456 MAX_HEADER_LIST_SIZE=262144
node_like:   bytes=30 HEADER_TABLE_SIZE=4096 ENABLE_PUSH=0 INITIAL_WINDOW_SIZE=65535 MAX_FRAME_SIZE=16384 MAX_CONCURRENT_STREAMS=4294967295
curl_like:   bytes=36 HEADER_TABLE_SIZE=4096 ENABLE_PUSH=0 MAX_CONCURRENT_STREAMS=100 INITIAL_WINDOW_SIZE=65535 MAX_FRAME_SIZE=16384 MAX_HEADER_LIST_SIZE=16384
Tres clientes, tres longitudes de trama, y la diferencia no es decorativa. El navegador declara una ventana inicial grande y una lista de cabeceras grande; el cliente Node no declara límite de lista de cabeceras y deja la ventana en su valor por defecto; el cliente con forma de curl declara un tope de flujos concurrentes que los otros dos omiten. Un par que lee el trama sabe con cuál de tres arquitecturas habla antes de analizar la línea de solicitud.
La trama también muestra por qué "igualar al navegador" es más difícil que igualar una lista de cifrados. El orden de cifrados es una propiedad fija de una compilación de biblioteca; la trama de ajustes es un conjunto de decisiones de ajuste que un cliente toma para su propia carga de trabajo. Hacer que ambos se parezcan a un navegador implica adoptar también el ajuste del navegador, incluidas las partes que existen para servir a un motor de renderizado que este cliente no tiene.
Las bibliotecas de suplantación sí abordan esto, y la medición anterior muestra que se acercan. Lo que no pueden cambiar es que el ajuste exista: un cliente cuyo único trabajo es obtener bytes tiene ajustes naturales distintos de un cliente cuyo trabajo es renderizar una página, y el trama registra la diferencia incluso cuando el código se ha ajustado.
Un cliente que reutiliza una conexión lo hace visible en un segundo lugar. La reanudación de sesión y la reutilización de conexión ayudan al rendimiento, y ambas implican que la segunda solicitud no repite el apretón de manos. Un par que cuenta apretones de manos ve una huella para diez solicitudes en lugar de diez, mientras un cliente que abre una conexión nueva por solicitud muestra diez. Ninguno de los dos comportamientos es un engaño; son dos diseños normales, y los recuentos difieren porque los diseños difieren.
La capa que un cliente HTTP no tiene
Todo lo anterior trata de la conexión. La capa de página es otro conjunto de valores y un cliente HTTP no tiene ninguno, en el mismo sentido en que un editor de texto no tiene resolución de pantalla.
page_layer: ua=header-only  languages=en-US,en  platform=MacIntel
            hardwareConcurrency=16  deviceMemory=null
            canvas=true  webgl=true  timezone=America/Toronto
            screen=1280x720  dpr=1  webdriver=true
Esos valores salieron de evaluar un documento en un navegador. Ninguno puede producirlo un cliente que analiza bytes, porque cada uno lo calcula un motor de JavaScript o un sistema de renderizado que el cliente no ejecuta. Aquí no hay crédito parcial ni una solución ingeniosa: una cabecera puede fijarse a cualquier cadena, y la cadena no es el valor.
La última entrada merece separarse del resto. webdriver=true lo informa el navegador porque se lanzó bajo automatización, y un cliente HTTP no tiene un campo equivalente que informar. Una comparación que trata "campo ausente" como "campo limpio" lee la ausencia al revés, y por eso un informe de huellas debe decir qué superficies se evaluaron y no solo qué valores se encontraron.
Al juntar las dos capas, el costo de una coincidencia casi exacta se vuelve concreto. Un cliente que llega a t13d1516h2 ha invertido esfuerzo real en la capa de conexión y aún difiere del navegador que imita en una extensión. Tampoco ha ganado nada en la capa de página, donde sigue siendo un cliente sin documento.
Esa combinación es lo peor de ambas posiciones en un sentido concreto: invita a una comparación que no puede ganar. Un cliente simple que no intenta parecerse obviamente no es un navegador, y las herramientas lo tratan como tal. Un cliente que se parece mucho a un navegador en la capa de conexión crea una expectativa que la capa de página luego no cumple.
plain_client      -> clearly not a browser on both layers
impersonated      -> close on connection, absent on page
browser           -> both layers present and consistent
La pregunta útil no es "cuánto puede acercarse el apretón de manos" sino "qué capa necesita realmente este trabajo". Una solicitud de JSON detrás de una comprobación simple necesita la primera fila. Una solicitud de una lista renderizada detrás de un inicio de sesión necesita la tercera. Elegir la segunda fila es decidir pagar por un parecido que solo llega a medias.
Hay una tercera razón por la que las dos capas siguen separadas en la práctica, y tiene que ver con la forma en que puede enunciarse una comparación. Una afirmación sobre la capa de conexión tiene la forma "este apretón de manos ofreció estos parámetros", que un solo mensaje registrado puede sostener. Una afirmación sobre la capa de página tiene la forma "este entorno informó estos valores", que necesita una evaluación dentro de un documento y un registro de a qué pudo llegar esa evaluación. Las dos afirmaciones exigen pruebas distintas, así que un informe que las fusiona en una puntuación tiene que descartar el campo que dice cuál de las dos está haciendo.
Eso importa sobre todo cuando aparece una discrepancia. Si un cliente coincide en la capa de conexión y la capa de página está ausente, el informe debería decir "capa de página no evaluada" y no "capa de página limpia". La primera afirmación es verdadera y accionable; la segunda es una afirmación sobre una medición que nadie hizo. La misma disciplina vale al revés: una sesión de navegador cuyo apretón de manos nunca se capturó no puede responder una pregunta sobre la conexión, por minucioso que sea su informe de la página.
El costo sigue la misma división. Una coincidencia en la capa de conexión se paga una vez, en tiempo de compilación, eligiendo una biblioteca y una versión y manteniéndolas fijadas. Una coincidencia en la capa de página se paga de forma continua, porque los valores que informa un documento dependen del renderizador, las fuentes, la pantalla y el perfil en uso, y cualquiera de ellos puede cambiar entre ejecuciones. Los equipos suelen presupuestar la primera y se sorprenden con la segunda, y por eso una biblioteca TLS fijada parece terminada mientras un entorno de página coherente nunca termina de estarlo.
Una última nota operativa pertenece aquí y no a un tutorial, porque es la parte que falla en silencio. Cuando se actualiza una biblioteca cliente, la lista de cifrados y el conjunto de extensiones se mueven con ella, y la huella registrada deja de coincidir por un motivo que no tiene nada que ver con la configuración. Cuando se actualiza un navegador bajo una instalación de automatización fijada, los valores de la capa de página pueden moverse igual. Ambos son eventos de versión, ambos se ven en un diff si el valor se guarda junto a la versión, y ambos son invisibles si el valor se guarda solo.
Qué cuesta una coincidencia casi exacta, y la conclusión práctica
Referencia de comparación: t13d1516h2 frente a t13d1517h2, con el mismo recuento de cifrados en ambos lados.
Medir antes de suponer paridad: capture el ClientHello de su propio cliente y compare el recuento de extensiones, no solo un hash. El cliente que suplanta medido aquí igualó exactamente el conjunto de cifrados de Chrome y difirió en una extensión, y el prefijo declara esa diferencia con claridad. Nombre también la biblioteca TLS, además del programa, porque las compilaciones SecureTransport y OpenSSL de la misma versión de curl producen valores distintos. Y mantenga las dos capas separadas en cualquier comparación: un cliente sin DOM puede aproximar la capa de conexión, y ninguno puede aproximar la capa de página. Para ver cómo se construye el valor de la capa de conexión, lea JA3, JA4 y la trama de ajustes de HTTP/2; para saber qué reglas de detección necesitan un valor de red, lea reglas de borde que un script de página no puede evaluar. Una página renderizada necesita un navegador, y la configuración de un navegador para scraping cubre ese camino.
El límite merece enunciarse sin adornos. Un perfil declarado puede mantener coherentes entre sí los valores que expone una página; no hace que un apretón de manos coincida con otro cliente, y no le da a un cliente HTTP un documento que renderizar. Igualar la conexión e igualar la página son resultados separados obtenidos con herramientas separadas, y un trabajo suele necesitar uno de los dos y no ambos.
Una nota breve sobre lo que estas mediciones no dicen, porque el lector puede preguntarlo con razón. No dicen que una coincidencia casi exacta no sirva: para un endpoint JSON detrás de una puntuación simple, la capa de conexión es casi todo lo que se examina, y un cliente que acierta los cifrados está en una posición distinta de uno que no. Tampoco dicen que se necesite un navegador para cada página renderizada, ya que una página que entrega sus datos en un objeto de estado inicial puede leerla un cliente sin renderizador.
Lo que sí dicen es que las dos capas no forman un degradado. No hay ajuste que mueva a un cliente a mitad de camino entre "sin DOM" y "renderiza una página", ni cabecera que mueva el apretón de manos de un navegador a otro valor. Un trabajo que necesita ambas capas necesita un navegador; un trabajo que necesita la capa de conexión a menudo puede resolverse con un cliente que nunca carga un documento. Decidir cuál de esos dos trabajos está delante y decirlo en el registro es toda la disciplina.
La instalación de la medición merece un párrafo, porque quien quiera comprobar estas cifras necesita las mismas condiciones. El socket de escucha tiene que aceptar la conexión y cerrar sin completar un apretón de manos; si presenta un certificado, el cliente puede enviar un segundo mensaje distinto y la comparación se mueve. La captura tiene que ocurrir del lado del cliente respecto de cualquier proxy, o los bytes registrados pertenecen a lo que terminó TLS y no al cliente estudiado. Y el análisis tiene que descartar los valores grease antes de contar, porque un cliente que sortea un marcador de posición nuevo en cada conexión parece crecer y encoger su lista de cifrados entre ejecuciones. Ninguno de esos pasos es difícil, y cada uno omitido produce una cifra que cambia por un motivo ajeno al cliente.
Fuentes
Este artículo forma parte de la guía: ¿Qué es la huella digital del navegador?
Artículos Relacionados
Huellas TLS: JA3, JA4 y la trama HTTP/2
Huella digitalReglas de capa de red que una página no puede evaluar
Huella digitalClient Hints Fingerprinting: encabezados HTTP e identidad
RedScraper bloqueado: errores DNS, TLS, HTTP y de página
Huella digitalQué prueban realmente las suites de detección públicas
Huella digitalFuente aleatoria de crypto-js: qué rama usa tu build
Ejecuta la misma comprobación en BotBrowser
Carga un perfil, mantén dentro del navegador las señales que acabas de leer y confirma el resultado en tu propia máquina antes del despliegue.