CAPTCHA durante el scraping: diagnosticar el cambio
Un CAPTCHA durante el scraping necesita una cronología de solicitudes, no una puntuación supuesta. Distingue cambios de ruta, sesión y carga antes de recuperar el trabajo.
BotBrowser Team
Quieres la documentación estructurada de Red?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
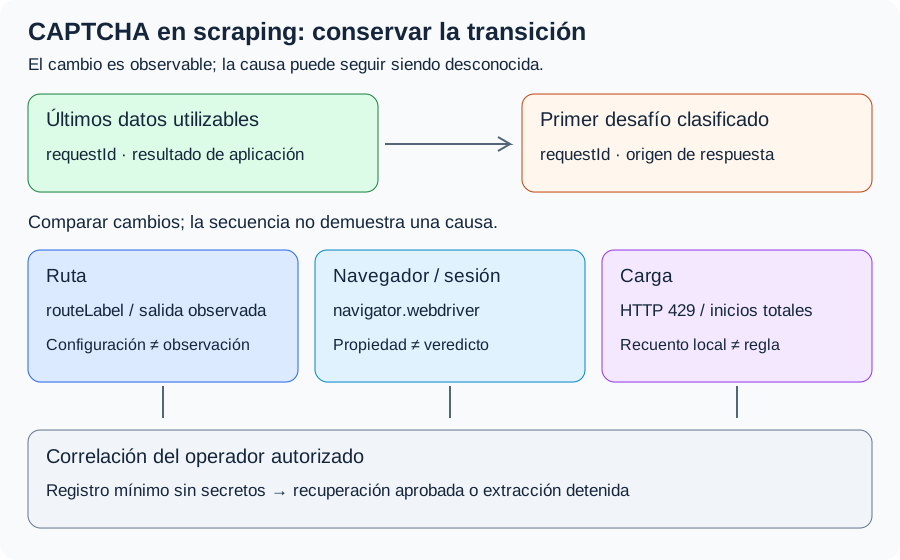
Un CAPTCHA a mitad del scraping cambia el resultado observable del trabajo; no identifica su causa. Una actualización de ruta, un contexto nuevo y otra carga pueden coincidir con el primer reto. BotBrowser documenta controles basados en perfiles y configuración de proxies, pero no concede acceso, no identifica reglas privadas y no garantiza una ejecución sin retos. En un trabajo autorizado, conserva la transición entre la última respuesta útil y el primer reto, detén la extracción dependiente y pide al operador que correlacione las solicitudes reales.
Resumen
- Un reto clasifica una respuesta; no demuestra un cambio en una señal concreta del navegador.
- Compara las solicitudes exactas de la transición; una página anterior correcta no autoriza todas las operaciones posteriores.
- Investiga ruta, sesión y carga como explicaciones posibles, no como lista exhaustiva de causas.
- HTTP
429expresa un rechazo relacionado con la tasa; un403genérico o un reto HTML no identifica su regla. - Conserva un incidente mínimo sin secretos, respeta el presupuesto existente y recupera solo por la vía aprobada del sitio.
Contenido
- Un reto es una transición, no una causa
- Tres vías de investigación y sus observables
- Reconstruir el intervalo entre datos y reto
- Interpretar la carga sin inventar una tasa segura
- Conservar un registro mínimo del incidente
- Configuración del navegador y condición de parada
- Conclusión práctica
Un reto es una transición, no una causa
Los conceptos del WAF de Cloudflare separan detección y mitigación. La detección aporta información; la mitigación configurada bloquea, presenta retos o limita solicitudes. La referencia también describe familias de reglas y su orden. El reto visible prueba una acción en el límite observado, no explica todas las entradas o políticas que la seleccionaron.
Clasifica primero el documento recibido. El análisis de respuestas de Cloudflare y DataDome distingue marcadores documentados y rechazos genéricos, así como decisiones de integración y respuestas al cliente. Un HTML inesperado puede ser un acceso de cuenta, un error de aplicación o un intermediario. Sin marcador específico ni registro del operador autorizado, conserva la clasificación desconocida.
Localiza la última respuesta que cumplió el contrato de datos de la aplicación y la primera que dejó de cumplirlo. HTTP 200 no es ese contrato: un formulario de acceso con estado correcto no contiene el catálogo esperado. Una excepción JSON es un fallo de procesamiento posterior, no prueba un cambio de esquema. Detén el analizador dependiente antes de publicar resultados vacíos o borrar registros anteriores.
El diagnóstico por capas del scraper bloqueado separa DNS, TLS, HTTP y ejecución de página. Conserva esas diferencias. Si la solicitud no obtuvo respuesta HTTP, una captura de un reto antiguo no explica el fallo de red actual. Asocia cada observación a su operación, no a un veredicto para toda la pestaña.
La respuesta útil anterior no es un certificado de acceso continuo. Autorización de cuenta, rutas y políticas pueden variar entre solicitudes. Un recurso aprobado no autoriza automáticamente un destino redirigido ni datos de otra cuenta. La clasificación dice qué recibió la canalización; el permiso sigue viniendo del método y alcance acordados con el sitio.
Tres vías de investigación y sus observables
Estas vías ordenan pruebas alrededor de la transición. Son explicaciones candidatas, no tres causas demostradas ni exhaustivas. Las reglas pueden cambiar sin cambios del cliente; una autorización de aplicación puede parecer una respuesta de protección. También pueden haber cambiado varias variables antes del primer reto observado.
| Vía | Observable que conservar | Explicación alternativa | Comprobación autorizada del operador |
|---|---|---|---|
| Ruta de red | Etiqueta sin secretos y cambio de salida verificado para la solicitud | Otra ruta de aplicación, registro antiguo o regla ajena | Correlacionar con registros permitidos del perímetro y origen |
| Navegador o sesión | Creación de contexto/proceso, perfil previsto y transición de sesión | Autorización caducada u otra solicitud en distinto contexto | Comparar contrato de arranque y registro de sesión |
| Carga | Solicitudes iniciadas y en curso en el intervalo contable del trabajo | Otros workers, cuentas o rutas comparten la clave del operador | Comparar regla aplicable y alcance real del contador |
Para la ruta, separa configuración y observación. La referencia de proxies de BotBrowser documenta --proxy-server y requiere un servicio suministrado. Un endpoint configurado no es la salida observada de cada solicitud. Cambios del proveedor y solicitudes en curso complican la atribución. Registra la información disponible para la transacción fallida; no uses una comprobación de salida actual como prueba de una solicitud anterior.
Para el navegador, MDN sobre navigator.webdriver describe una señal cooperativa de control por WebDriver, no un veredicto completo. Un valor cambiado puede servir para revisar configuración en una aplicación propia, pero no explica el reto de un sitio externo. Sin pruebas pertinentes del operador, una discrepancia no demuestra la causa del proveedor.
Para la carga, conserva contadores y límites de contabilización. Un contador local puede medir navegaciones y omitir imágenes, reintentos, redirecciones u otros workers. Una regla del servidor puede contar solo solicitudes que coincidan con una expresión. Ambos contadores pueden abarcar conjuntos diferentes. Un reto tras cierto número de páginas es una secuencia observada, no una cuota pública de páginas seguras.
Reconstruir el intervalo entre datos y reto
Empieza por identidad y hora de solicitud, no por el orden de llegada de los registros. En concurrencia, una respuesta posterior puede pertenecer a una solicitud anterior. Distingue comienzo de solicitud y observación de respuesta si están disponibles. Indica la base del reloj: la hora del cliente no es implícitamente la del servidor. Si no hay sincronización, conserva la incertidumbre en lugar de imponer un orden causal exacto.
Asocia contexto y tarea a la misma transacción. Un proceso o contexto nuevo, o una sesión restaurada, pueden coexistir con otro worker terminando trabajo anterior. Una etiqueta global de perfil no demuestra qué contexto envió la solicitud desafiada. Comprueba si esa solicitud cumplió su contrato de arranque y sesión, no si otra página parecía correcta.
Conserva los cambios aprobados del intervalo. Una actualización de ruta tiene comienzo y final; el acceso a la aplicación tiene su propio resultado; el planificador puede iniciar más tareas independientemente. Si coinciden cambios, regístralos y deja la causa sin resolver. Reconstruir el intervalo no permite repetir una denegación bajo identidades sucesivas para encontrar una aceptada.
Revisa la procedencia antes de correlacionar identificadores. Un reto HTML en caché puede seguir visible tras cambios del trabajo u operador. La captura solo prueba lo mostrado. Marca caché, obtención nueva o procedencia desconocida cuando la instrumentación lo permita. No asocies un identificador antiguo al reloj actual porque el navegador conserve el documento.
Trata igual las redirecciones. Conserva ruta solicitada, final e historial permitido sin parámetros firmados. Un HTTP 200 final puede describir un acceso tras redirección. Si el destino queda fuera del alcance autorizado, detente en vez de seguirlo para completar la traza. El registro debe describir sus límites de visibilidad, no ampliar permisos silenciosamente.
Mantén pequeña la muestra. Guarda estado, tipo de contenido, marcador documentado disponible y solo el fragmento permitido necesario. Un cuerpo 403 puede contener datos de cuenta o URLs firmadas. El objetivo es localizar un fallo autorizado y permitir correlación, no producir una sesión reutilizable ni la huella de un usuario ajeno.
Interpretar la carga sin inventar una tasa segura
La referencia HTTP de MDN define HTTP 429 como demasiadas solicitudes en un periodo. Eso respalda una clasificación relacionada con la tasa en ese límite, pero no revela la clave completa, la expresión ni la relación entre contador local y servidor. Un HTTP 403 genérico dice aún menos sobre una regla concreta.
La referencia de límites de Cloudflare describe expresiones que seleccionan solicitudes y acciones al alcanzar el límite configurado. Las características de conteo y funciones dependen del plan. El reto puede ser una acción configurada, pero no identifica por sí mismo la regla. Pide registros al operador autorizado en vez de inventar un número aceptable de solicitudes.
El análisis de tasa y concurrencia separa ritmo de inicio y trabajo en curso. Mantén el presupuesto asociado al mismo fin autorizado entre rutas y workers. Abrir otro navegador, cambiar dirección o repartir contextos no crea permiso ni reinicia la cuota acordada. Registra todo el trabajo programado, incluidos reintentos acotados, antes de diagnosticar presentación del navegador.
Si el operador confirma una decisión de carga, sigue su recuperación aprobada. Una pausa local reduce trabajo nuevo, pero no prueba que el servidor haya vaciado contadores ni autorice reintentar después. No dejes al pool enviar solicitudes dependientes porque el reto no sea JSON válido. Detén extracción nueva y separa datos ya obtenidos del resultado del incidente.
Un reto también puede coincidir con despliegues o cambios de integración. Si se conoce, compara periodo de política y versión de aplicación con el intervalo de solicitudes. La secuencia no distingue por sí sola entre regla nueva y tráfico cambiado. Sin pruebas del operador, registra causa no resuelta, no una fórmula de tasa inventada.
Conservar un registro mínimo del incidente
Define el registro por propósito de campo, fuente y límites de visibilidad. La tabla describe requisitos de diagnóstico autorizado, no un registro ficticio. Omite secretos y campos fuera del alcance; marca observaciones necesarias como no disponibles en lugar de adivinarlas. Lo que falta también indica qué no puede establecer la investigación.
| Campo | Qué establece | Límite que conservar |
|---|---|---|
requestId | La transacción de cada observación | El ID local necesita mapeo explícito al ID del operador |
startedAt y observedAt | Orden de inicio y observación | Base de reloj y límites de sincronización |
taskId y contextId | Tarea y contexto que enviaron la solicitud | Una etiqueta no es permiso de cuenta ni prueba de carga del perfil |
routeLabel | Ruta prevista sin credenciales | Configuración no demuestra salida observada |
| Estado HTTP y tipo | Clase de respuesta visible | Estado correcto no demuestra éxito de datos |
| Registro de cambios | Cambios aprobados en el intervalo | Un cambio previo no es automáticamente causa |
| Correlación del operador | Regla o decisión aportada | La prueba interna sigue indisponible hasta que la aporte el operador |
Separa configuración prevista y mediciones en el esquema. Por ejemplo, routeLabel es configuración salvo observación independiente de salida. El perfil previsto del contexto pertenece al contrato de arranque; otro valor del navegador no prueba la carga íntegra del perfil. Así el registro sigue siendo útil aunque haya comprobaciones nunca ejecutadas.
Guarda la última respuesta útil y el primer reto clasificado sin copiar todas las páginas anteriores. Su relación importa más que un volcado indiscriminado. Conserva el mínimo fragmento permitido y resultado de aplicación. Excluye cookies, autorización, credenciales de proxy, URLs firmadas y cuentas de diagnósticos compartidos. La correlación usa identificadores expurgados, no exige revelar configuración privada de detección.
La salida del trabajo debe indicar extracción completada, detenida o no resuelta. No publiques precios vacíos ni borres registros porque HTML sustituyó JSON. Es una decisión de integridad del consumidor, separada de la clasificación del proveedor. El incidente puede seguir sin resolver mientras los datos válidos anteriores se conservan bajo las reglas de la aplicación.
Configuración del navegador y condición de parada
La referencia de coherencia de automatización de BotBrowser documenta comportamiento dependiente del perfil y responsabilidades del harness. El control de navigator.webdriver requiere perfil cargado; enlaces creados por el framework y momento de su configuración son cuestiones aparte. Las rutas protegidas de consola y ejecución CDP tienen el límite ENT Tier1 documentado. Son controles de configuración, no reglas privadas ni exenciones de acceso.
Inspecciona la configuración prevista en una aplicación propia autorizada y separa sus observaciones de las respuestas protegidas. Una comprobación local detecta discrepancias del arranque; no mide puntuaciones privadas ni prueba la causa del reto posterior. Reparar configuración propia y establecer permiso para reiniciar son resultados distintos.
Aplica la misma separación a la red. --proxy-server requiere servicio válido y soporte del destino. La ruta no concede acceso en nombre del sitio. Los controles permiten inspeccionar configuración declarada, pero no eliminan todo cambio de red, sustituyen autorización de sesión ni garantizan otra decisión. Conserva como desconocidas las observaciones no disponibles de ruta y aplicación.
Define la parada antes de comenzar: reto clasificado, rechazo de autorización o respuesta no resuelta que incumpla el contrato detienen extracción dependiente. Conserva el registro mínimo y usa soporte o acceso aprobados por el propietario. No hace falta automatizar un puzle, repetir tokens o cambiar identidad para obtener un diagnóstico útil.
Preguntas frecuentes
¿Un CAPTCHA tras varias páginas prueba límites de tasa?
No. Establece cuándo se observó. La causa requiere regla correlacionada u otra prueba pertinente; HTTP 429 respalda clasificación de tasa sin revelar toda la política.
¿Una configuración estable descarta retos?
No. Autorización, carga y política cambian independientemente de propiedades. Una configuración estable es una observación, no una promesa de acceso.
¿Una aplicación propia identifica la puntuación privada?
No. Registra lo que observa del navegador y solicitudes. La puntuación o decisión privada requiere sus propias pruebas autorizadas pertinentes.
¿Cuándo debe reanudarse el trabajo?
Solo mediante recuperación aprobada tras resolver acceso o integración. Una espera o un contexto nuevo no proporcionan permiso por sí solos.
Fuentes
- Cloudflare: conceptos WAF
- MDN: estados HTTP
- BotBrowser: coherencia de automatización
- BotBrowser: configuración de proxies
- MDN: Navigator.webdriver
- Cloudflare: límites de tasa
Conclusión práctica
Trata el nuevo CAPTCHA como transición por solicitud. Clasifica el documento, compara solicitudes y revisa ruta, sesión y carga sin convertir correlación en causa. Evita secretos, conserva datos válidos y detén extracción dependiente. El siguiente paso es una decisión aprobada del operador, no una puntuación supuesta ni una promesa de que una opción del navegador eliminará el reto.
Este artículo forma parte de la guía: Panorama de configuración de proxy: mapa de decisiones de red
Artículos Relacionados
Límites de scraping: 429, Retry-After y concurrencia
RedScraper bloqueado: errores DNS, TLS, HTTP y de página
RedCloudflare y DataDome: señales durante el scraping
RedRotación de proxies: límites de sesión en scraping
DespliegueScraping de bolsas de empleo: límites del navegador
RedCookies de scraping: estado entre ejecuciones
Ejecuta la misma comprobación en BotBrowser
Carga un perfil, mantén dentro del navegador las señales que acabas de leer y confirma el resultado en tu propia máquina antes del despliegue.